Gleiches Model, gleicher offener Anzug, dritte Stadt bei Nacht
- Modell
- Seedance 2.0
- Aufgabe
- Referenz zu Video
- Auflösung
- 480p
- Dauer
- 4 s
- Seitenverhältnis
- 3:4
Ergebnis
Diese Vorschau ist unscharf
Diese Vorschau ist als sensibel markiert. Bestätigen Sie Ihr Alter, um sie zu sehen.
Eingabe
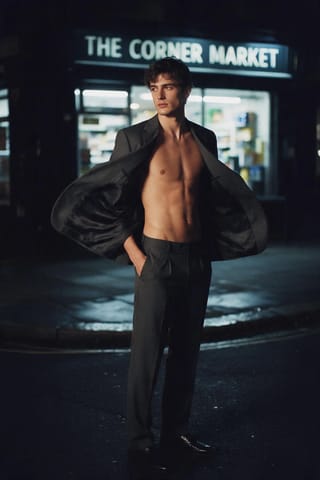
reference_image_urls 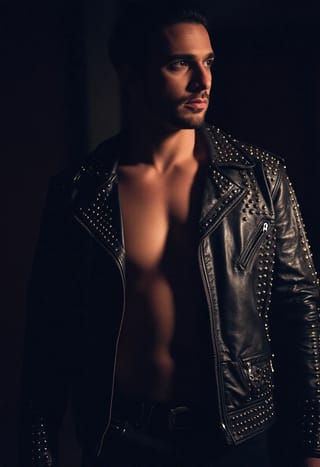
reference_image_urls 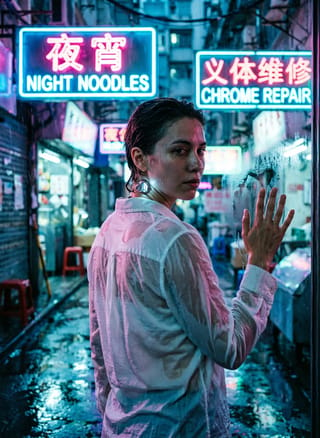
reference_image_urls
Beim Ausführen durch Ihr eigenes ersetzen.
PromptEN376 Zeichen
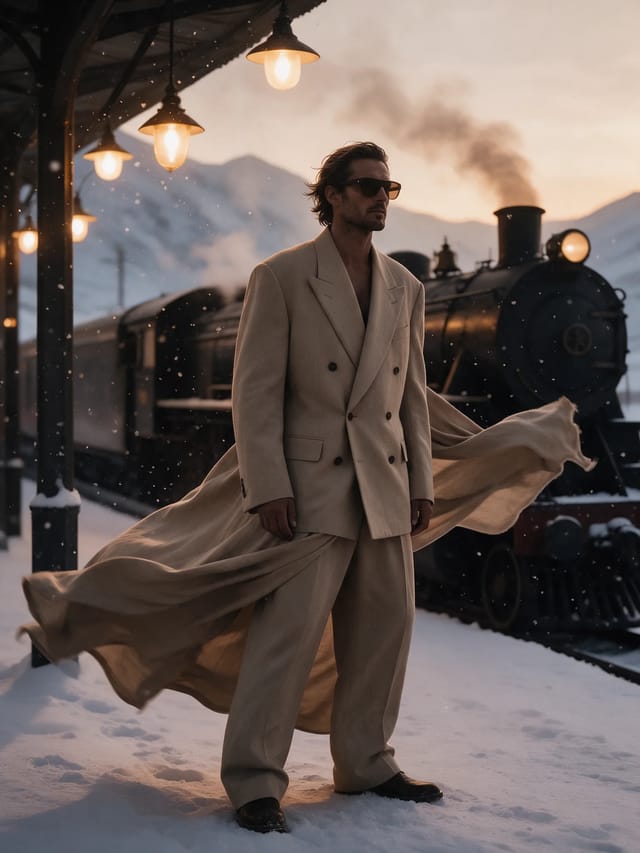
The camera stays on him as the wind takes the jacket fully open. The same model, the same unbuttoned suit, a third city corner at night: the wind takes the jacket open as he walks toward camera, traffic streaking behind. The wind takes the jacket fully open over a bare chest as he walks in; medium close. Cinematic, shallow depth of field, heavy film grain, cold street blue.Auf Englisch verfasst, genau so, wie wir ihn gesendet haben.
Dieses Beispiel ausführen
Preis wird geprüft …
Öffnet den Playground mit allen Einstellungen bereits ausgefüllt und zeigt vor dem Start den genauen Preis.
Gleiches Modell, ausgehend von diesem Prompt. Alle übrigen Einstellungen stehen auf Standard.
Warum dieser Prompt funktioniert
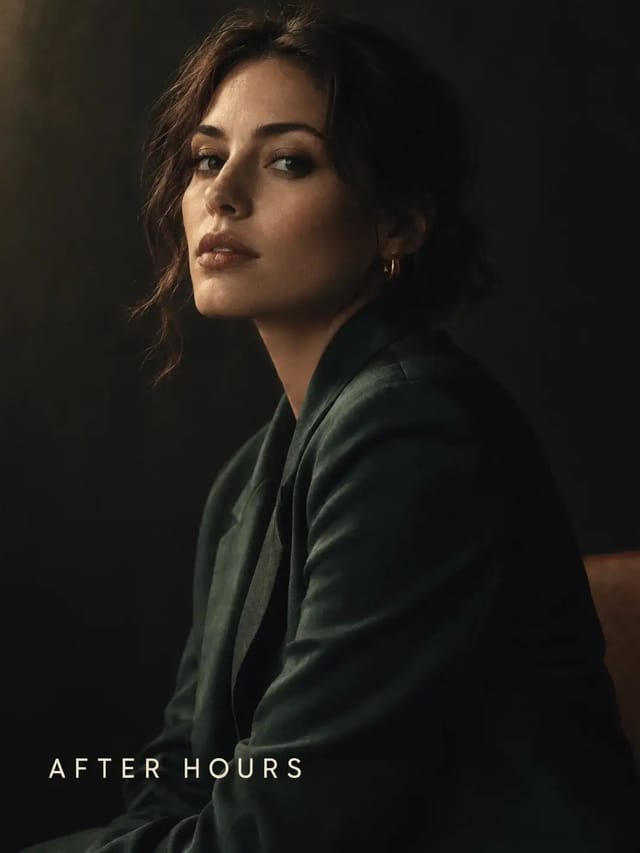
Die Garderobenkontinuität ist die schwierige Hälfte dieses Beispiels: dieselbe offene Jacke muss an einer dritten Straßenecke unter anderem Licht wie dasselbe Kleidungsstück wirken. Die Referenzen tragen Model und Anzug, der Prompt beschreibt nur noch, was der Wind tut und wohin er geht. Bis zu neun Standbilder, drei Clips und drei Tonspuren gehen gemeinsam hinein – die Besetzung reist als Daten zwischen den Einstellungen, nicht als Adjektive.
Verwendete Einstellungen
| Einstellung | Wert | Was sie bewirkt |
|---|---|---|
| resolution | 480p | 480p, 720p, 1080p oder 4k, Vorgabe 720p, und es geht direkt in die abgerechnete Menge ein. Es setzt nur die Ausgabestufe und schärft keine niedrig aufgelösten Referenzen. Testen Sie auf einer niedrigen Stufe, ob die Referenzen zusammenspielen, und heben Sie sie erst für die finale Einstellung an. Aufbereitungs- oder Upscaling-Stufen gibt es hier nicht. |
| aspect_ratio | 3:4 | Vorgabe ist `adaptive`: Das Modell findet einen Ausschnitt, der alle referenzierten Motive unterbringt – das zählt vor allem, wenn die Referenz-Assets keine gemeinsame Form haben. Legen Sie ein festes Verhältnis nur für eine harte Ausspielvorgabe fest, etwa `9:16` für einen vertikalen Feed, und prüfen Sie, dass keine referenzierte Person und kein Produkt angeschnitten wird. Ohne Einfluss auf die Abrechnung. |
| generate_audio | false | Standardmäßig an. Erzeugt eine eigene, zum Bild synchrone Tonspur. Auch mit gesetztem `reference_audio_urls` gilt: Abgeschaltet wird gar keine Tonspur gerendert. Referenz-Audio formt Tempo und Vortrag, es ist nicht die Ausgabespur. Schalten Sie es ab, wenn der Schnitt ohnehin nachvertont wird. |
| duration_seconds | 4 | 4 bis 15 Sekunden, Vorgabe 5; mit -1 wählt das Modell die Länge selbst (geschätzt wird das Maximum von 15 Sekunden, abgerechnet die gelieferte Länge). Fünfzehn Sekunden sind die Obergrenze dieser Generation; für eine längere Einstellung wechseln Sie zum 2.5-Endpunkt. Beachten Sie: Dieser Wert und die Länge Ihrer Referenzclips sind zwei unabhängige Beiträge zur abgerechneten Menge – beides gleichzeitig auszureizen ist der Punkt, an dem eine einzelne Anfrage teuer wird. |