Введение
OmniHuman 2.0 Talking avatar — аватар-модель от ByteDance, которая управляется аудио. Вы отправляете портрет (image_url) и аудиофайл с речью или пением (audio_url), а в ответ получаете видео в 720p, где этот человек исполняет аудио: лицо, губы, голова и верхняя часть тела двигаются вместе с ним, а не остаются неподвижным торсом. Клип равен длине аудио — от 4 до 300 секунд. Поля длительности, разрешения или соотношения сторон нет. Необязательный prompt длиной до 300 символов задаёт настроение, жесты, куда смотрят глаза и, по данным издателя, движение камеры.
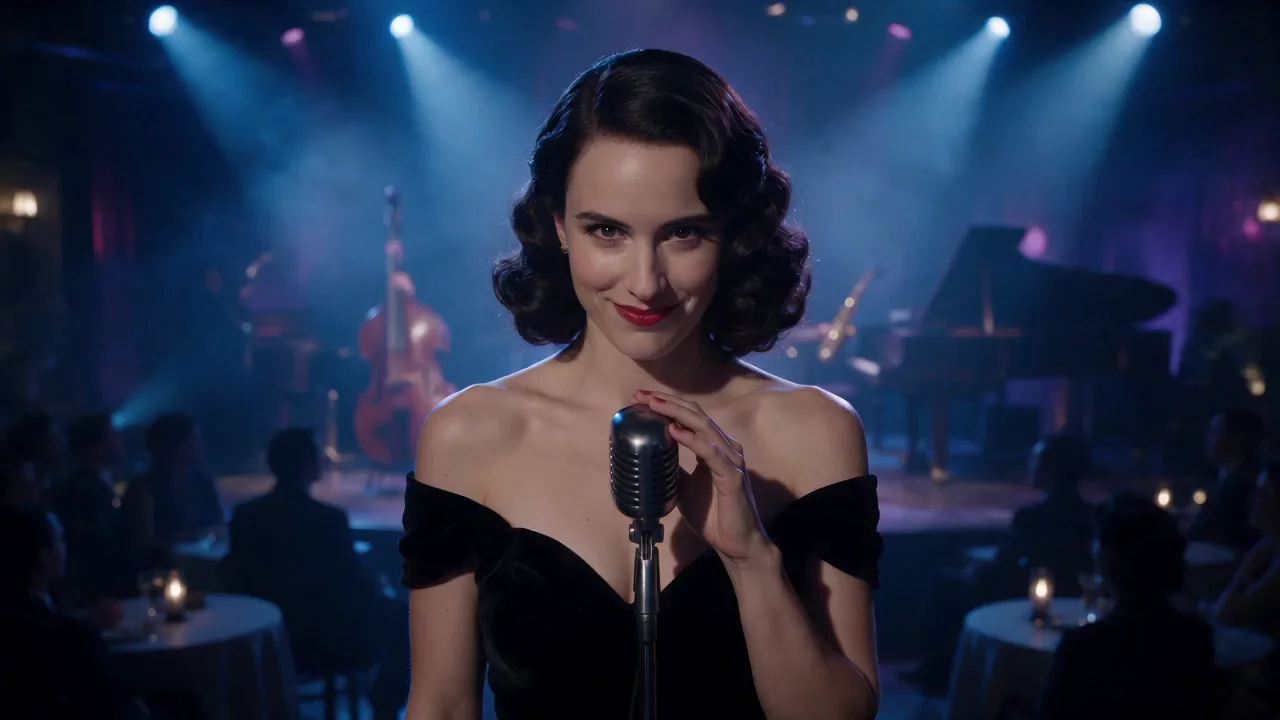
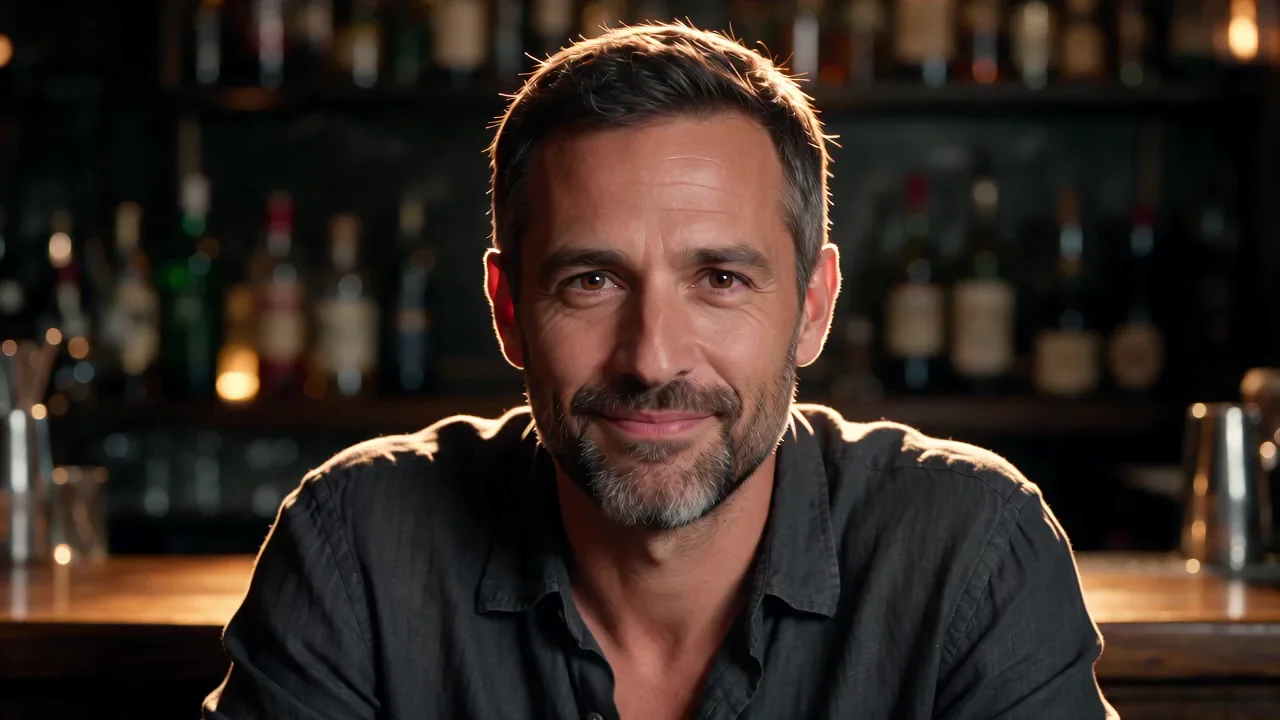
Три из четырёх примеров на этой странице (певица в ужинном клубе, барная стойка и ночное шоу) используют те же портреты и аудио, что и Kling Avatar 2.0, обрезанные примерно до пяти секунд, так что две страницы можно сравнить бок о бок.
Ключевые возможности и особенности
Аудио задаёт длину
Обрежьте аудио до нужной длины клипа перед отправкой. Аудио короче 4 секунд или длиннее 300 секунд отклоняется до любого списания. В наших запусках клип оказывался длиннее аудио на 0,2–1 секунду и выходил целым числом секунд: 4,55 секунды аудио дали клип 5 секунд, 5,2 секунды — клип 6 секунд. Оплата следует за длиной аудио, а не за готовым клипом.
Что мы измерили
Мы прогнали четыре портрета, у каждого своё аудио длиной от 4,55 до 5,2 секунды и свой однострочный промпт. Все четыре портрета были 16:9. Каждый клип пришёл в 1280×720 и 24 кадра в секунду с дорожкой звука, а обработка занимала около двух минут на клип — от 110 до 133 секунд от отправки до готового файла. При сравнении кадров с исходным портретом лицо во всех четырёх клипах оставалось узнаваемо тем же человеком.
Губы, мимика и жесты
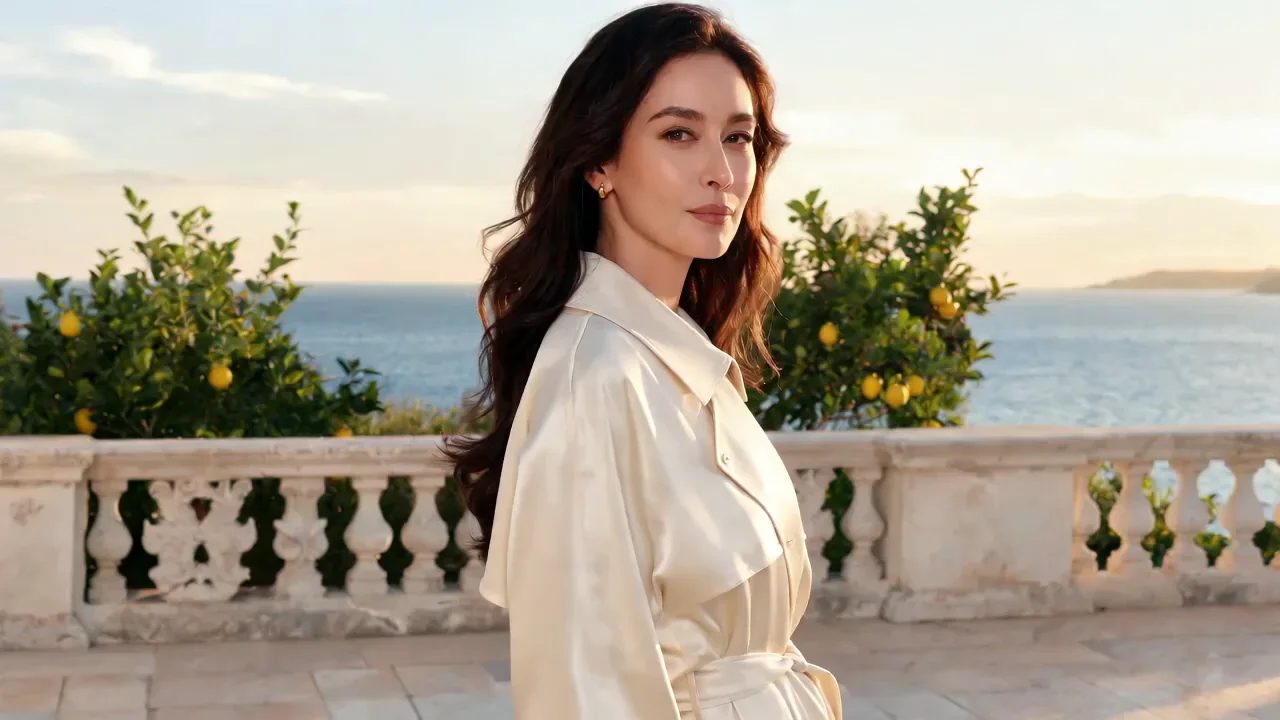
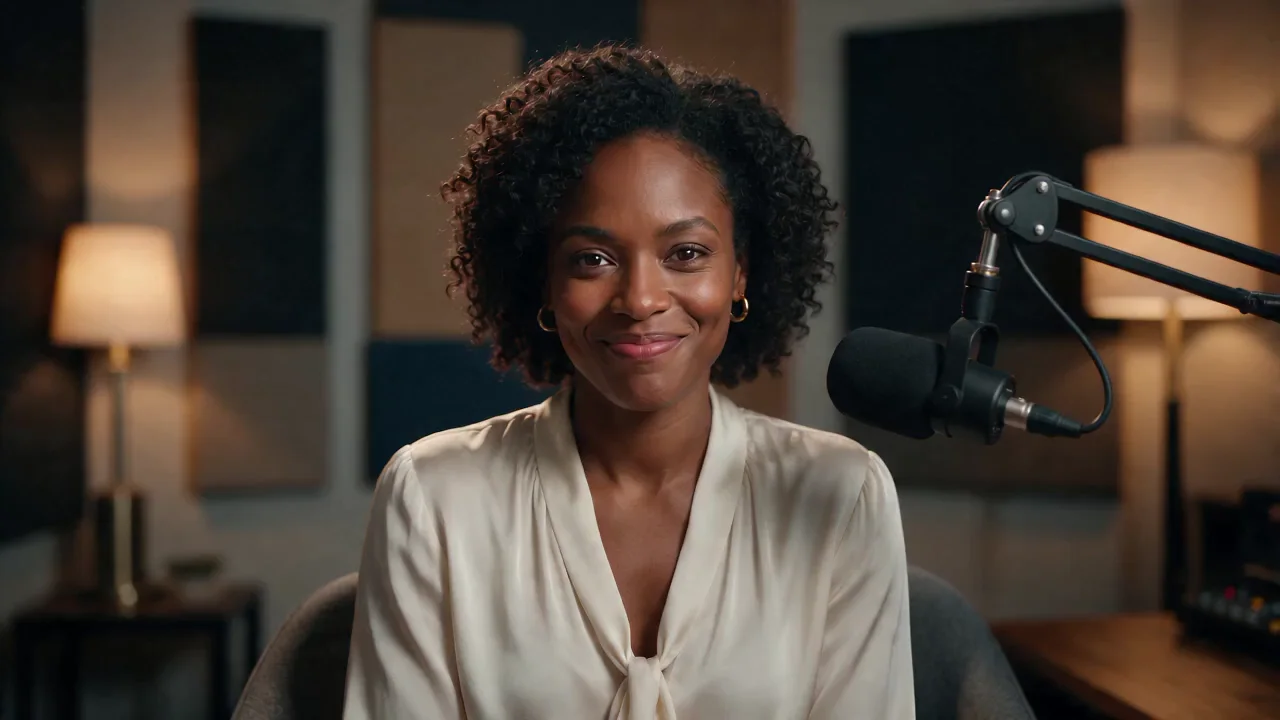
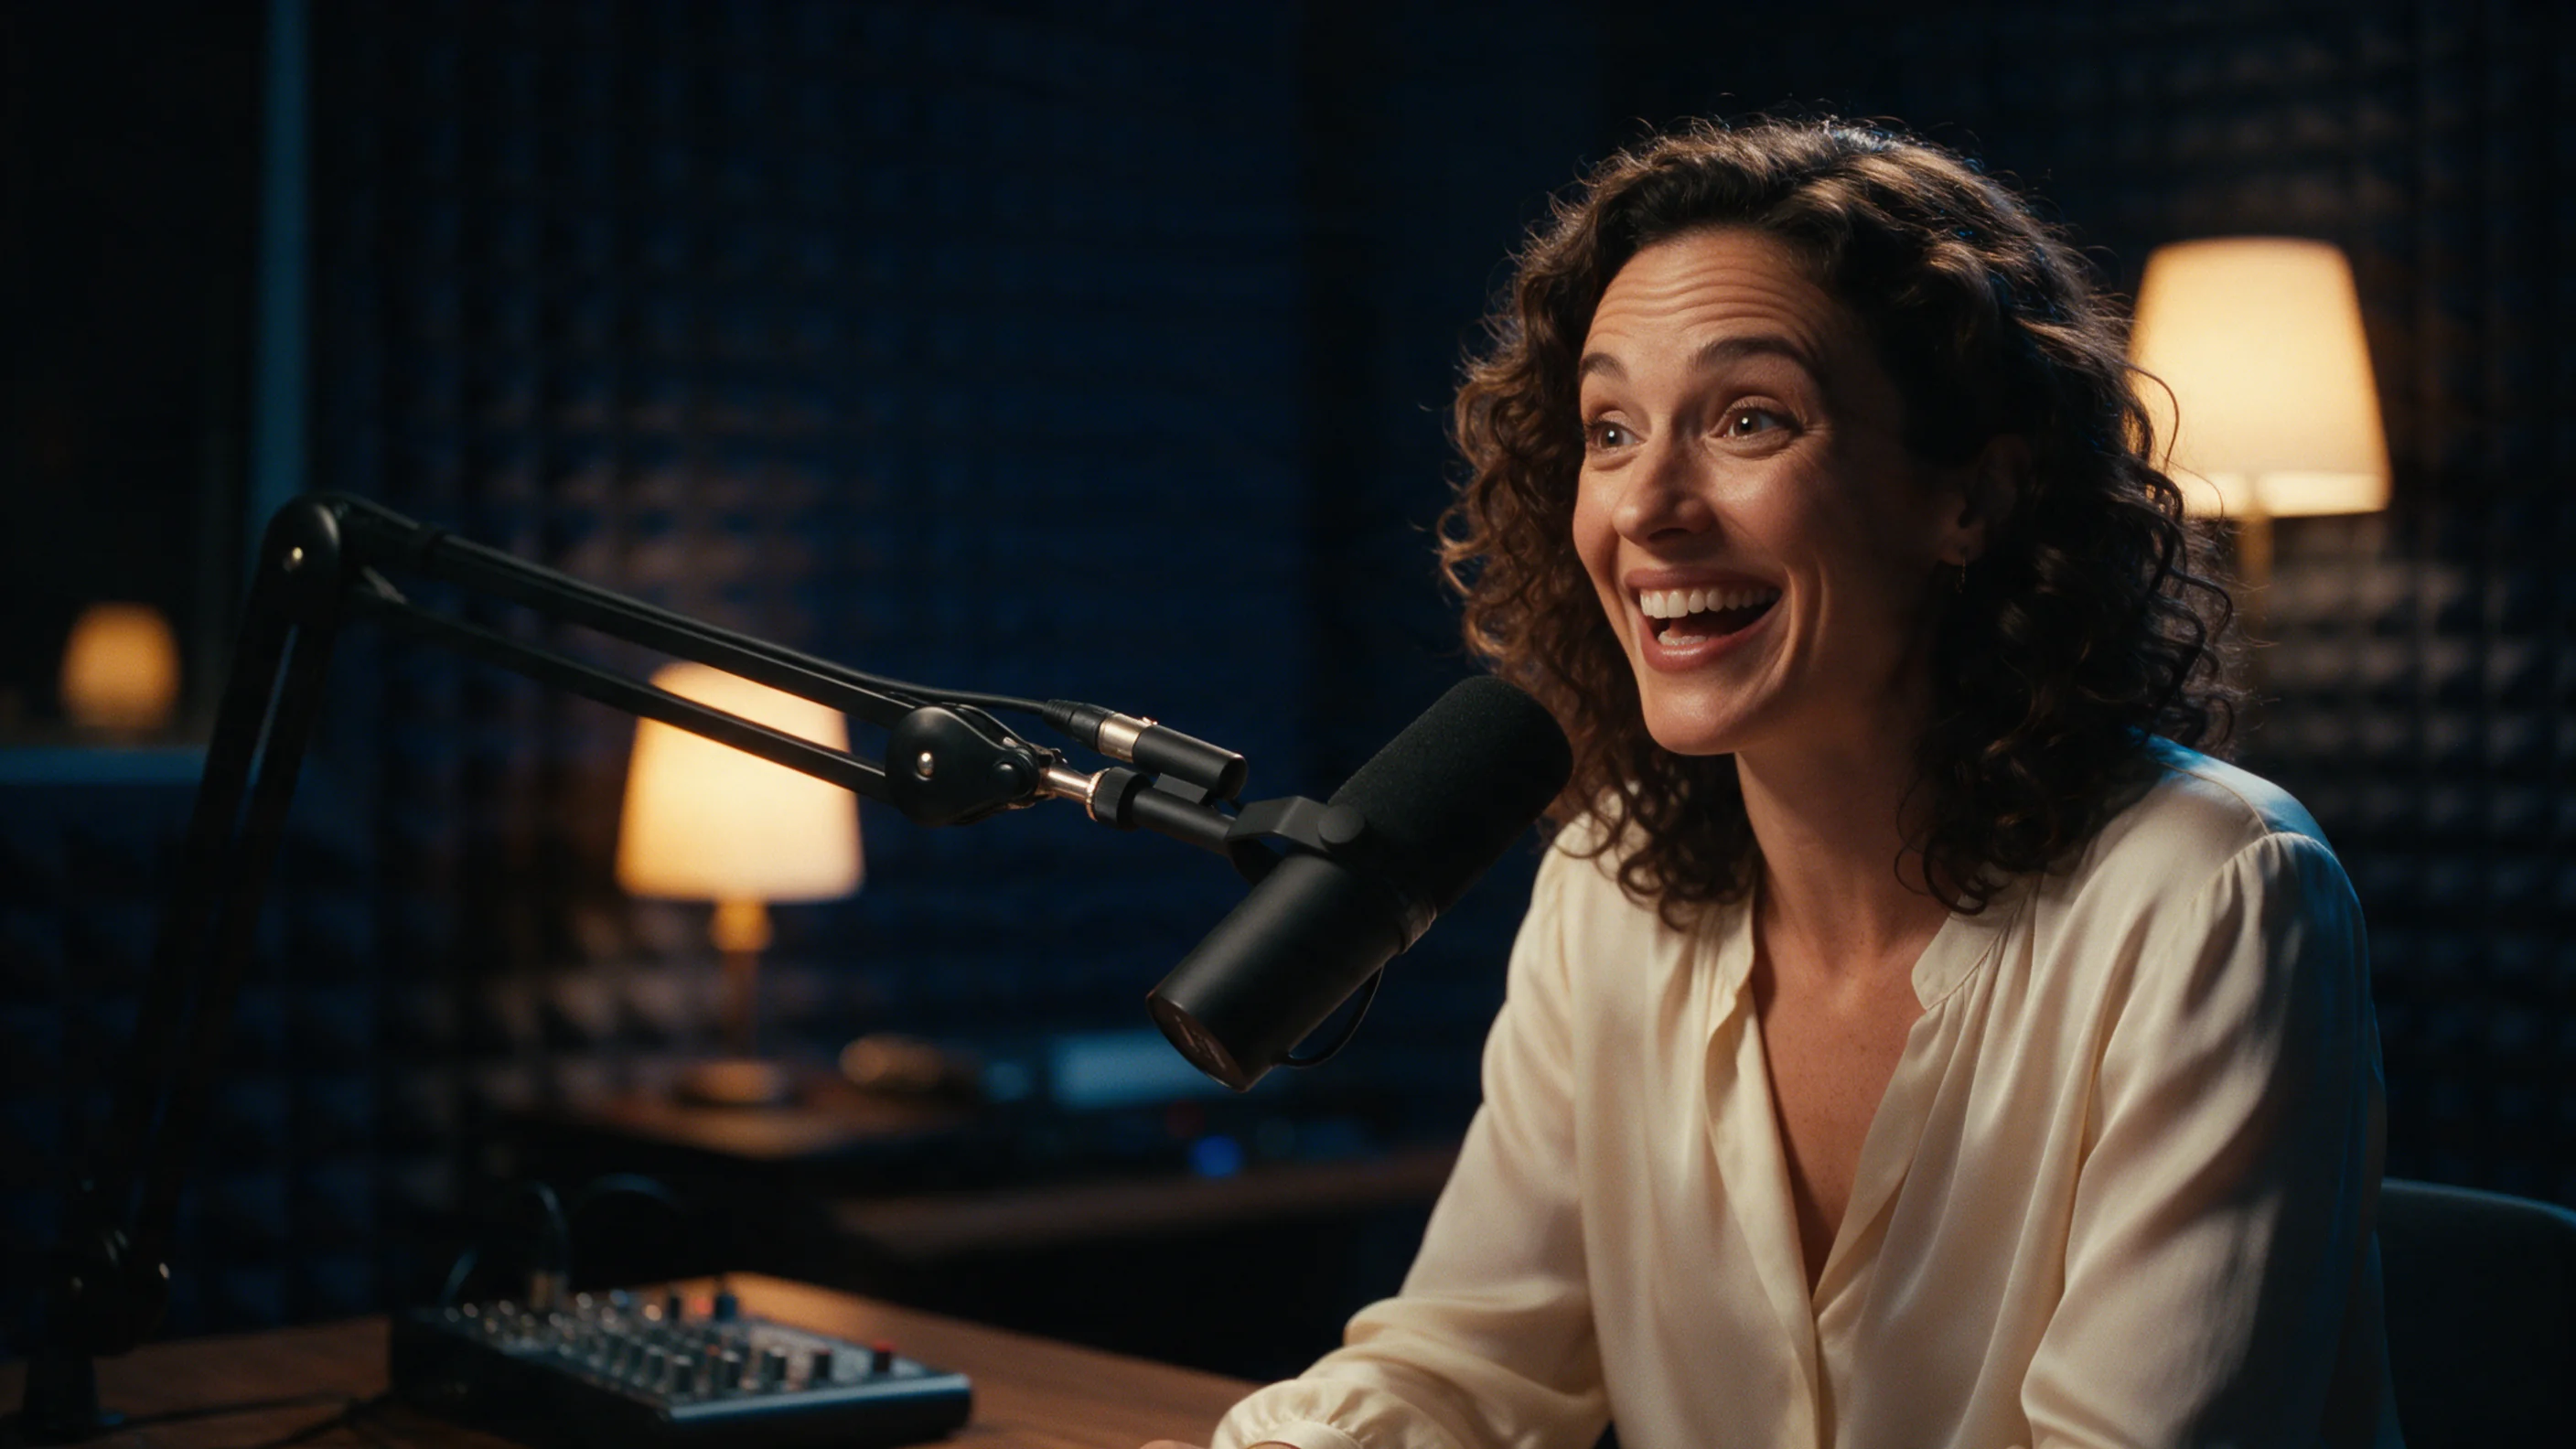
Во всех четырёх клипах губы следовали за аудио. Промпты просили небольших, конкретных акцентов, и большинство из них проявилось: улыбка и небольшой наклон головы на последнем слове при руке, остающейся на микрофоне; полуулыбка и приподнятая бровь при неподвижных бутылках за барной стойкой; поворот головы к морю на последней секунде; короткий смех с широкими бровями на последнем слове. Одна инструкция визуально не проявилась: наклон к микрофону в клипе с ночным шоу.
Промпт необязателен
Если оставить prompt пустым, модель следует только за аудио. Издатель указывает в качестве языков промпта китайский, английский, японский, корейский, испанский (мексиканский) и индонезийский. Все наши четыре промпта были на английском и задавали мимику, жесты и направление взгляда; инструкции про движение камеры мы не проверяли.
Что мы не тестировали
Издатель указывает сцены с несколькими людьми; мы их не тестировали. Все наши клипы были около пяти секунд аудио, поэтому длинный клип, близкий к максимуму 300 секунд, полную песню или портреты не в формате 16:9 мы не проверяли.
Проверка контента
Портреты, не прошедшие проверку контента ByteDance, отклоняются, и ничего не списывается. Один из наших тестовых портретов был отклонён именно так: без клипа и без списания. Закладывайте, что каждый запрос проходит эту проверку.
Параметры запроса
| Параметр | Обязательно | Описание |
|---|---|---|
prompt | Нет | Необязательно, до 300 символов. Задаёт настроение, жесты, куда смотрят глаза и движение камеры. Не более 300 символов |
image_url | Да | Портрет для анимации. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC или HEIF, до 30 МБ, от 300 до 6000 пикселей по каждой стороне, соотношение ширины к высоте от 0,4 до 2,5. |
audio_url | Да | Речь или песня, WAV или MP3, до 15 МБ, от 4 до 300 секунд. Клип равен длине этого аудио; аудио вне этого диапазона отклоняется до любого списания. |
Стоимость
$0.108 / секунда
Оплата за секунду входного аудио: минимум 4 секунды, максимум 300 секунд. Резерв следует за длиной аудио (или за максимумом 300 секунд, если её не удаётся прочитать), а разница освобождается при выдаче результата. Запросы, завершившиеся ошибкой или отклонённые, не списываются.
Сценарии использования
Дать записанной реплике лицо
Соедините записанную или сгенерированную реплику с портретом, чтобы получить клип, где этот человек её произносит, — закадровые вступления, отзывы или диалоги персонажа, чьё лицо вы уже утвердили.
Короткие вступления ведущего и зачины
Яркая, игривая вступительная фраза с промптом, который называет настроение и акцент на последнем слове, дала нам широкую мимику, живые брови и смех, как в примере про ночное шоу на этой странице.
Спетая строка по одной фотографии
Издатель указывает пение наряду с речью. Наш тест включал одну медленную спетую/проговорённую строку около пяти секунд у винтажного микрофона; полную песню мы не пробовали.
Фото с телефона без доработки
Портрет может быть JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC или HEIF, до 30 МБ, поэтому снимок прямо с телефона можно загрузить без предварительной конвертации.
Руководство по промптам и практические советы
Привязывайте мимику к моменту в реплике
«ленивая улыбка на последнем слове» и «взгляд в сторону в конце» обе сработали там, где мы их поставили: улыбка и наклон головы пришлись на конец клипа с певицей, а голова повернулась к морю на последней секунде клипа с террасой. Указание, в каком месте реплики должен случиться акцент, даёт модели ориентир для тайминга.
Держите несколько акцентов
Каждый наш промпт просил настроение, один-два акцента на мимике и иногда позу. Этого хватает, чтобы задать пятисекундный клип. В наших запусках акценты на мимике выполнялись надёжнее, чем движения тела.
Не рассчитывайте только на движение тела
«наклон к микрофону» из промпта ночного шоу визуально не произошло, тогда как смех и брови рядом — произошли. Это одно наблюдение из одного запуска, но если для вас важно движение тела, сгенерируйте один раз и проверьте, прежде чем строить на нём.
Выбирайте портрет с учётом ограничений
Ширина и высота должны быть от 300 до 6000 пикселей каждая, а соотношение ширины к высоте — от 0,4 до 2,5. Мы тестировали только портреты 16:9.
Обрежьте аудио под исполнение
Клип идёт ровно столько же, сколько аудио, и оплата следует за длиной аудио, поэтому обрежьте файл до речи или пения, которые вам действительно нужны. WAV или MP3, до 15 МБ.
Быстрый старт API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Аутентификация, полная схема, опрос статуса и обработка ошибок описаны в справочнике API.