Eine achtzehnsekündige durchgehende Einstellung, eine quadratische Produktanimation und eine Charakterszene aus mehreren Fotos sind alles Videoaufgaben. Es sind aber nicht dieselben Käufe. LTX 2.5 und MiniMax H3 überschneiden sich bei kurzem Text-zu-Video und der Animation eines Startbilds, doch Ausgabeoptionen, Referenzen und Preise können die Wahl entscheiden, noch bevor Sie die Bildqualität vergleichen.
Wählen Sie LTX 2.5 für eine gelistete 4K-Stufe, eine durchgehende Einstellung von mehr als fünfzehn Sekunden oder eine Iteration mit Seed-Kontrolle. Wählen Sie MiniMax H3 für niedrigere Generierungskosten, quadratische/breite Bildformate oder eine Einstellung, die aus mehreren Bildreferenzen komponiert wird. Für eine gemeinsame 2k-Anfrage über fünf Sekunden kostet LTX $0.95 und H3 $0.29. Die bisherigen Tests zeigen, dass beide Modelle Anfragen für Erwachsene akzeptieren; einen Sieger bei vergleichbarer Bewegung oder Tonqualität belegen sie nicht.
Die schnelle Entscheidungstabelle
| Ihre Anforderung | Beginnen mit | Warum | Was noch zu beurteilen bleibt |
|---|---|---|---|
| Eine ununterbrochene Einstellung von 18–20 Sekunden | LTX 2.5 | Die gehostete Dauer reicht bis zwanzig Sekunden; Basis-H3 endet bei fünfzehn | Ob Handlung und Identität die längere Einstellung überstehen |
| Gelistete 4K-Ausgabe | LTX 2.5 | Das gehostete Menü bietet 4K; Basis-H3 endet bei 2k | Tatsächliche Bildabmessungen und Detailgrad, nicht nur der Name der Stufe |
| Getrennte Referenzen für Person, Objekt und Umgebung | MiniMax H3 reference-to-video | Akzeptiert ein bis neun Bildreferenzen | Wie gut das Ergebnis ihre Rollen kombiniert |
| Quadratische oder 21:9-Komposition aus Text | MiniMax H3 | Sechs Bildformate gegenüber dem Quer-/Hochformat-Menü von LTX | Komposition und wichtige Details im gewählten Bildausschnitt |
| Mehrere günstige Entwürfe aus einem Startbild | MiniMax H3 image-to-video | Fünf Sekunden kosten ab $0.185 bei 768p | Ob die günstigere Ausgabe brauchbar ist, nicht nur fertiggestellt |
| Eine gemeinsame Startbild-Einstellung über fünf Sekunden in 2k | Beide | Beide akzeptieren Quelle und Dauer | Bewegung im ganzen Clip, Erhalt der Quelle und Ton |
| Wiederholbare Prompt-Iteration innerhalb eines Modells | LTX 2.5 | Ein Seed-Feld ist verfügbar | Ein Seed verbessert die Nachvollziehbarkeit; identische Frames garantiert er nicht |
Ein Startbild und eine Referenzsammlung lösen unterschiedliche Probleme. Wenn Sie Person, Pose und Komposition bereits freigegeben haben, schicken Sie dieses Standbild an image-to-video. Haben Sie getrennte Einzelbilder und wollen eine neue Komposition, ist H3s Referenzaufgabe der passende Zweig. Letzteres mit unkonditionierter LTX-Textgenerierung zu vergleichen hieße, Workflows mit unterschiedlichen Informationen gegenüberzustellen.
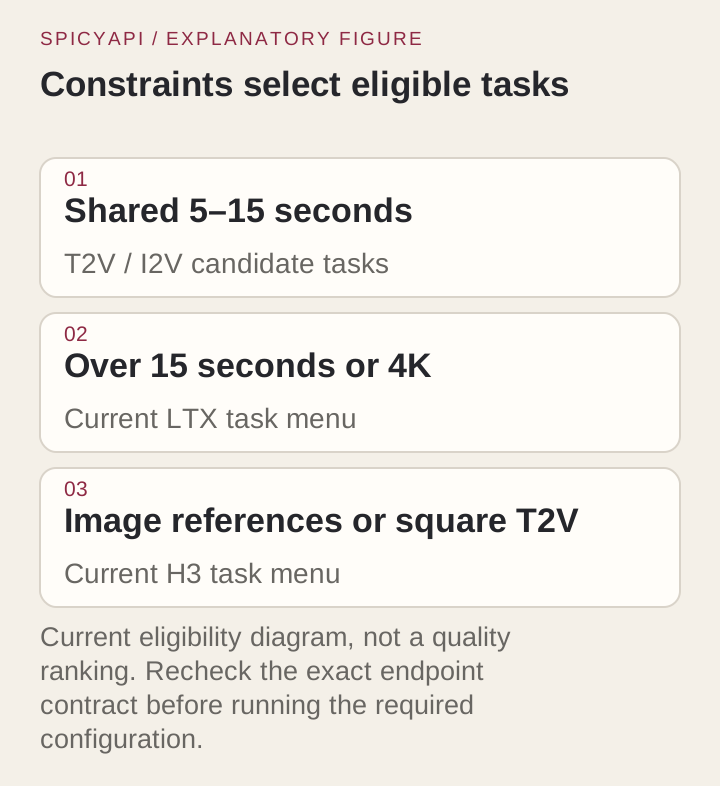
Aufgabeneignung: Legen Sie zuerst die benötigte Eingabe und Ausgabe fest und beurteilen Sie dann die generierte Einstellung.
Eingaben und Steuerung, die die Einstellung beeinflussen
Die LTX-2.5-Familie bietet gehostete Text- und Bildaufgaben. Die MiniMax-H3-Familie ergänzt die Generierung aus Bildreferenzen. Gemeint sind Basis-H3 und LTX 2.5, nicht H3 Max, ein Spicy-Geschwistermodell oder LTX 2.3.
| Steuerung | LTX 2.5 | MiniMax H3 Basis |
|---|---|---|
| Dauer bei Text-zu-Video | 5–20 ganze Sekunden | 5–15 ganze Sekunden |
| Dauer bei Bild-zu-Video | 5–20 ganze Sekunden | 4–15 ganze Sekunden |
| Optionales Endbild | Ja bei image-to-video | Ja bei image-to-video |
| Aufgabe mit Bildreferenzen | In dieser gehosteten Familie nicht verfügbar | 1–9 Bilder, 4–15 Sekunden |
| Auflösungsstufen | 720p, 1080p, 2k, 4k | 768p, 2k |
| Bildformat bei Text | 16:9 oder 9:16 | 16:9, 9:16, 1:1, 4:3, 3:4 oder 21:9 |
| Seed | Optional | Bei diesen Basisaufgaben nicht verfügbar |
| Prompt-Erweiterung | Kein Schalter | Kein Schalter (seit 9. Oktober 2026 entfernt) |
| Ton | Generierte Audio-Video-Ausgabe | Generierte Audio-Video-Ausgabe |
Bei image-to-video bestimmt das Quellbild die Startkomposition; einen separaten Regler für das Seitenverhältnis gibt es nicht. Ein Endbild sollte eine physikalisch plausible Fortsetzung darstellen: dieselbe Figur, dieselbe Kamerarichtung und derselbe Schauplatz, bei dem sich genau ein bedeutsamer Zustand ändert. Es ist ein beabsichtigtes Ziel, kein Beleg dafür, dass jedes Zwischenbild die Quelle bewahrt.
Bei einer Einstellung mit Händen und Objekt bringt die Vorbereitung der Quelle mehr als zusätzliche Adjektive. Halten Sie das ganze Objekt, die vorgesehene Kontaktfläche und genügend Platz für die Handlung sichtbar. Eine eng angeschnittene Hand neben einer nicht sichtbaren Tasse verlangt vom Videomodell, die fehlende Beziehung zu erfinden. Ein weiter gefasstes, freigegebenes Bild legt diese Beziehung fest, bevor die Bewegung beginnt.
Die native LTX-Modellkarte und das MiniMax-H3-Repository beschreiben umfassendere Werkzeuge und Referenz-Workflows. Diese gehostete H3-Referenzaufgabe akzeptiert Bilder, keine nativen Video-/Audio-Referenz-Arrays. Ebenso sollten lokale LoRA- und Laufzeitfunktionen nicht als erfundene API-Felder gesendet werden.
Preis: Der Unterschied ist groß genug, um die Iteration zu beeinflussen
Dies sind die SpicyAPI-Ausgabepreise für Text- und Startbild-Generierung.
| Ausgabe über fünf Sekunden | LTX 2.5 | MiniMax H3 |
|---|---|---|
| Niedrigste gelistete Stufe | 720p: $0.45 | 768p: $0.185 |
| Mittlere Stufe | 1080p: $0.65 | Nicht angeboten |
| Gemeinsames 2k-Label | $0.95 | $0.29 |
| Gelistete 4K-Stufe | $1.50 | Nicht verfügbar |
Die gemeinsamen 2k-Preise wurden mit kostenlosen Angeboten für exakt diese Anfrage bestätigt. H3s $0.29 liegen etwa 69 % unter LTX' $0.95 für dieselbe angefragte Dauer und dasselbe Stufen-Label. Das ist ein Preisunterschied beim Kauf, keine gemessene Verbesserung der Produktionseffizienz um 69 %. Vier H3-Kandidaten kosten $1.16; zwei LTX-Kandidaten kosten $1.90. Wenn die günstigeren Kandidaten die geforderte Bewegung wiederholt verfehlen, ergibt der Preisvorteil womöglich keine fertige Einstellung.
Eine brauchbare Kostenrechnung umfasst alle Generierungskosten, die zur akzeptierten Einstellung geführt haben, plus den nötigen Aufwand für die Nachbearbeitung. Zwei erfolgreiche, aber unbrauchbare H3-Entwürfe in 2k und ein dritter, der passt, kosten zusammen $0.87. Ein LTX-Treffer kostet $0.95. Eine fehlgeschlagene Aufgabe und ein abgeschlossener, aber kreativ verfehlter Versuch sind unterschiedliche Abrechnungsergebnisse; verwenden Sie für eine echte Gesamtrechnung die abgerechneten Aufgabendatensätze.
H3-Referenzen verursachen weitere Kosten. Ein kostenloses Angebot für fünf Sekunden in 768p mit einer Referenz ergab $0.1918 statt der $0.185 der Ausgabe ohne Referenz. Holen Sie ein Angebot für die tatsächliche Anzahl der Referenzen ein, statt sie als kostenlose Eingabe zu behandeln. Auch die Basisversion von H3 bietet keine Prompt-Erweiterung mehr an (seit 9. Oktober 2026 entfernt); es gibt also weder einen Erweiterungsschalter noch eine Erweiterungsgebühr einzukalkulieren. Kalkulieren Sie eine Option nicht allein deshalb ein, weil ihr Feld im Schema steht.
Der Vergleich der niedrigsten Stufen beantwortet eine andere Frage. LTX 720p und H3 768p liefern unterschiedliche Größen. Für einen kleinen Entwurf kann das eine sinnvolle Sparvariante sein; für eine Bewertung bei gleicher Auflösung ersetzt es die gemeinsame Stufe nicht.
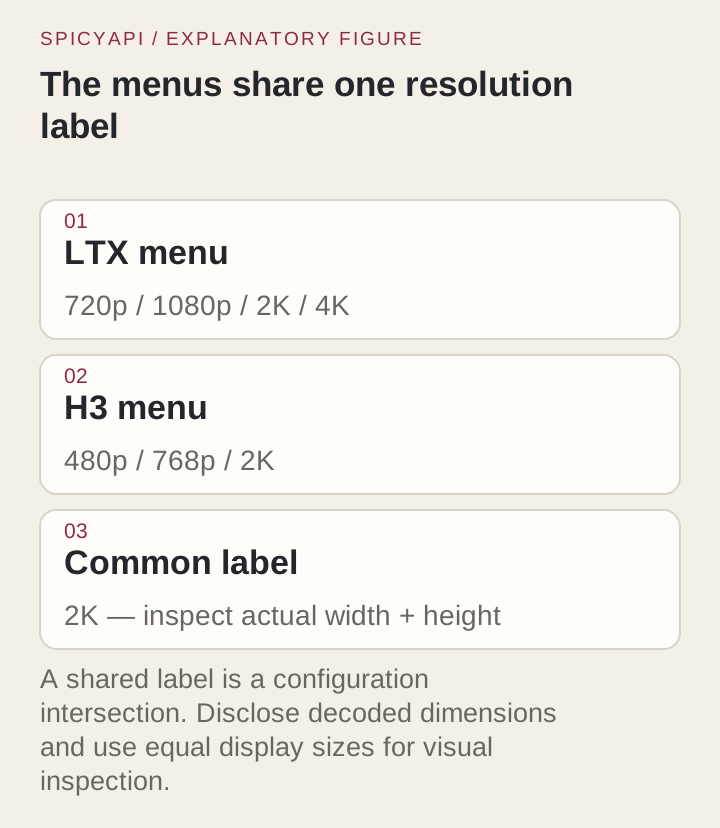
Das gemeinsame 2k-Label kennzeichnet eine Schnittmenge der Konfigurationen. Vergleichen Sie die tatsächlich dekodierten Maße und sehen Sie sich die vollständigen Dateien in einheitlicher Anzeigegröße an.
Was die bisherigen Tests zu NSFW und Ausgabequalität sagen
Nach unseren Tests vom September 2026 können beide Familien unzensierte Videos für Erwachsene erzeugen:
- LTX 2.5: Vierundzwanzig Anfragen mit Inhalten für Erwachsene über Text- und Bildaufgaben ergaben dreiundzwanzig inhaltliche Treffer und ein abgeschwächtes Textergebnis. Kategorien und Anzahlen unterscheiden sich; es sind nicht vierundzwanzig Tests derselben Szene.
- Basis-MiniMax-H3: Zwölf Anfragen mit Inhalten für Erwachsene passten in der archivierten Stichprobe aus Text-, Bild- und Referenzaufgaben. Zwei zusätzliche Gewalt-Tests sind von dieser Erwachsenen-Stichprobe getrennt.
- Keine der Stichproben ist ein paarweiser Wettbewerb. Unterschiedliche Prompts, Daten und Wiederholungen bedeuten, dass sich aus ihren Summen weder ableiten lässt, H3 sei allgemein zuverlässiger, noch LTX sei weniger leistungsfähig.
Der LTX-2.5-Test beschreibt gemischte visuelle Ergebnisse, darunter eine gute Clubszene und starke Artefakte bei manchen komplizierten Bewegungen. Der H3-Test dokumentiert seine eigenen früheren Befunde zu Inhalten und Aufgaben. Die Akzeptanz von Inhalten ist für einen Workflow mit Erwachsenen-Inhalten wichtig, bewertet aber weder Handgeometrie noch Kamerasteuerung oder Identität über eine Szene hinweg.
Eine konkrete Lieferprüfung liegt bereits vor: Das Fähigkeitsarchiv vom September verzeichnet für eine LTX-2.5-Anfrage in 2k über elf Sekunden eine Ausgabe mit 2560×1408 Pixeln, 11.04 Sekunden und einer aussagekräftigen Tonspur. Das belegt eine tatsächliche lange, hochauflösende Audio-Video-Ausgabe in dieser Konfiguration. Es belegt weder Lippensynchronität noch eine feste Renderzeit noch einen Vergleich mit einem H3-Clip.
Bereiten Sie für eine redaktionelle Einstellung mit Erwachsenen-Inhalten Figur und Garderobe im Startbild vor und inszenieren Sie dann genau eine sichtbare Bewegung. Beurteilen Sie sowohl den beabsichtigten Inhalt als auch das filmische Ergebnis. Ein Clip, der den richtigen Inhalt liefert, aber verrutschende Hände zeigt, ist unbrauchbar, wenn der Handkontakt für das Briefing zentral ist.
Eine praktische gemeinsame Einstellung: eine Tasse, eine Bewegung, ein Geräusch
Um die beiden Wege an etwas Beobachtbarem zu vergleichen, nutzen Sie eine fünfsekündige Töpferszene: Ein erwachsener Töpfer dreht eine blaue Tasse um eine Vierteldrehung, tippt einmal an ihren Rand und legt beide Hände neben sie. Die Kamera bleibt ruhig. Der sichtbare Kontakt und das Geräusch machen Fehler leicht beschreibbar.
Storyboard und Illustrationen zeigen die beabsichtigte Handlung, keine Ergebnisse eines der beiden Modelle.
Static medium-wide shot in a quiet ceramics studio. An adult potter in an indigo apron stands behind a wooden workbench. One small blue glazed cup with a single handle rests on the bench. The potter brings both hands to the cup, gently turns the cup a quarter-turn with both hands, taps its rim once with one finger, then rests both hands beside it. Keep the cup intact and continuously visible. No cuts or camera movement. Quiet room tone and one light ceramic tap, no dialogue or music.
Dieser Prompt gibt jeder Anweisung eine Aufgabe:
- Subjekt und Umgebung: legen fest, wer handelt und wo, statt ein langes Stilinventar aufzulisten.
- Objekt: Eine blaue Tasse mit einem Henkel macht Duplizierung oder Neugestaltung sichtbar.
- Reihenfolge der Handlung: Annähern, Drehen, Tippen, Ablegen gibt der Szene ein Ende statt offener Bewegung.
- Kamera: Eine statische Komposition erleichtert die Beurteilung der Bewegung.
- Ton: Ein kurzes Kontaktgeräusch erlaubt, das Timing zu prüfen; Dialog oder Gesang werden damit nicht getestet.
Verwenden Sie für einen Durchlauf mit Startbild auf beiden Wegen dieselbe freigegebene Datei. Ersetzen Sie die beschreibenden ersten Sätze durch: “Use the supplied image as the character, cup and studio design. Preserve their appearance and composition.” Behalten Sie die Anweisungen zu Handlung, Kamera und Ton bei. Zwei getrennt generierte Quellbilder würden einen zusätzlichen Unterschied einführen, noch bevor eine der beiden Videoaufgaben beginnt.
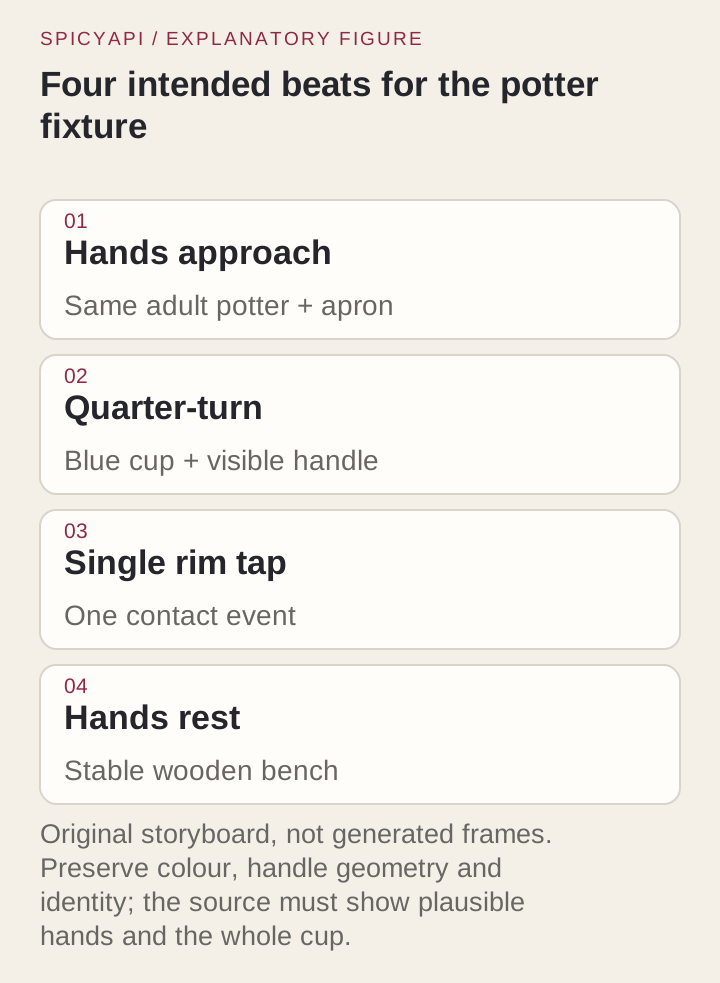
Vier Beats: Hände nähern sich, die Tasse dreht sich, ein Finger tippt an den Rand, dann ruhen die Hände.
API-Eingaben für Text-zu-Video
Speichern Sie eine dieser Anfragen als request.json und senden Sie sie mit dem SDK-Workflow aus dem Video-API-Leitfaden ab. Der Runner liest die gewählte Modell-ID und die Eingabe, holt standardmäßig nur ein Angebot ein, ohne die Aufgabe zu erstellen, und nutzt eine gespeicherte Task-ID zur Wiederaufnahme.
{
  "model": "lightricks/ltx-2.5/text-to-video",
  "input": {
    "prompt": "Static medium-wide shot in a quiet ceramics studio. An adult potter in an indigo apron brings both hands to the cup, gently turns one blue handled cup a quarter-turn on a wooden workbench, taps its rim once, then rests both hands beside it. Keep the cup intact and visible. No cuts or camera movement. Quiet room tone and one light ceramic tap, no dialogue or music.",
    "duration_seconds": 5,
    "resolution": "2k",
    "aspect_ratio": "16:9",
    "seed": 42017
  }
}
Behalten Sie für die entsprechende H3-Anfrage Prompt, Dauer, Stufe und Bildformat bei. Entfernen Sie seed, weil die Basis-H3-Aufgabe es nicht anbietet:
{
  "model": "minimax/h3/text-to-video",
  "input": {
    "prompt": "Static medium-wide shot in a quiet ceramics studio. An adult potter in an indigo apron brings both hands to the cup, gently turns one blue handled cup a quarter-turn on a wooden workbench, taps its rim once, then rests both hands beside it. Keep the cup intact and visible. No cuts or camera movement. Quiet room tone and one light ceramic tap, no dialogue or music.",
    "duration_seconds": 5,
    "resolution": "2k",
    "aspect_ratio": "16:9"
  }
}
Wählen Sie bei image-to-video die Bildaufgabe der jeweiligen Familie, übergeben Sie Ihre Quelle als image_url, lassen Sie aspect_ratio weg und behalten Sie den Bewegungs-Prompt bei. Lassen Sie das Endbild im ersten Versuch weg, es sei denn, das Erreichen genau dieses Bildes ist die Frage. Wenn die Steuerung des Endes wichtig ist, fügen Sie in einem getrennten Versuch bei beiden dasselbe kompatible Endbild hinzu.
Wann H3-Referenzen der bessere Workflow sind
Angenommen, Töpfer, Tasse und Studio liegen als drei getrennte, freigegebene Bilder vor. H3s Referenzaufgabe kann sie zu einer neuen Einstellung kombinieren. Erklären Sie ihre Rollen ausdrücklich: “Image 1 defines the potter and indigo apron; Image 2 defines the blue cup and handle; Image 3 defines the studio. Compose a medium-wide view of the potter at the workbench, then perform the turn, tap and rest sequence.”
Das ist auch ohne Vergleichssieger nützlich. Es erspart dem Modell, das Objekt allein aus Text zu erfinden, und es vermeidet, alle Zutaten in ein bereits freigegebenes erstes Bild zu zwängen. Prüfen Sie, ob jede Rolle tatsächlich erhalten bleibt. Wenn eine exakte Startkomposition unverzichtbar ist, komponieren Sie zuerst dieses Standbild und nutzen Sie stattdessen die Startbild-Generierung.
Das Ergebnis beurteilen, ohne jeden Versuch zum Laborprojekt zu machen
Sehen Sie sich den kompletten Clip in der vorgesehenen Geschwindigkeit an, bevor Sie einzelne Frames prüfen. Ein gutes erstes Bild zeigt nicht, ob der Henkel auf halbem Weg verschwindet oder ob die Handlung vor dem Tippen abbricht.
| Worauf Sie achten | Ein brauchbares Ergebnis | Ein Fehlschlag, den man festhalten sollte |
|---|---|---|
| Tasse und Henkel | Ein durchgehendes Objekt mit konsistenter Geometrie | Zusätzliche Tasse, wechselnder Henkel, schmelzender Rand |
| Handkontakt | Die Hände drehen die Tasse sichtbar; der Finger erreicht den Rand | Schwebende Finger, duplizierte Hand, Bewegung ohne Kontakt |
| Ablauf | Hände nähern sich, drehen, einmal tippen, dann ruhen | Vertauschte Handlungen, wiederholtes Tippen oder kein Ende |
| Figur | Gleiches Aussehen im Clip; Quelle bei Bildeingabe erhalten | Neugestaltung von Gesicht oder Garderobe durch die Bewegung |
| Kamera | Eine feste Ansicht | Ungewollte Kamerafahrt nach vorn, Schnitt oder Perspektivwechsel |
| Ton | Ein Tippen nahe am sichtbaren Kontakt, ruhige Atmosphäre | Zusätzliche Musik, fehlendes Tippen oder offensichtlicher Timing-Versatz |
Bei der Textgenerierung können die beiden Modelle unterschiedliche Gesichter erfinden. Das allein ist kein Fehlschlag. Beurteilen Sie die Kontinuität jeder erfundenen Figur. Vergleichen Sie bei Bildeingabe außerdem die zurückgegebene Figur mit der Quelle.
Prüfen Sie die tatsächlichen Maße, die Dauer und den Audiostream. Die angefragten fünf Sekunden entsprechen womöglich nicht exakt der kodierten Dauer. Bewahren Sie das Original auf, bevor Sie schneiden, skalieren oder den Ton ersetzen. Wenn ein visueller Treffer nur eine Tonbearbeitung braucht, vermerken Sie das als visuellen Erfolg mit Audio-Reparatur; geben Sie den ersetzten Ton nicht als native Ausgabe aus.
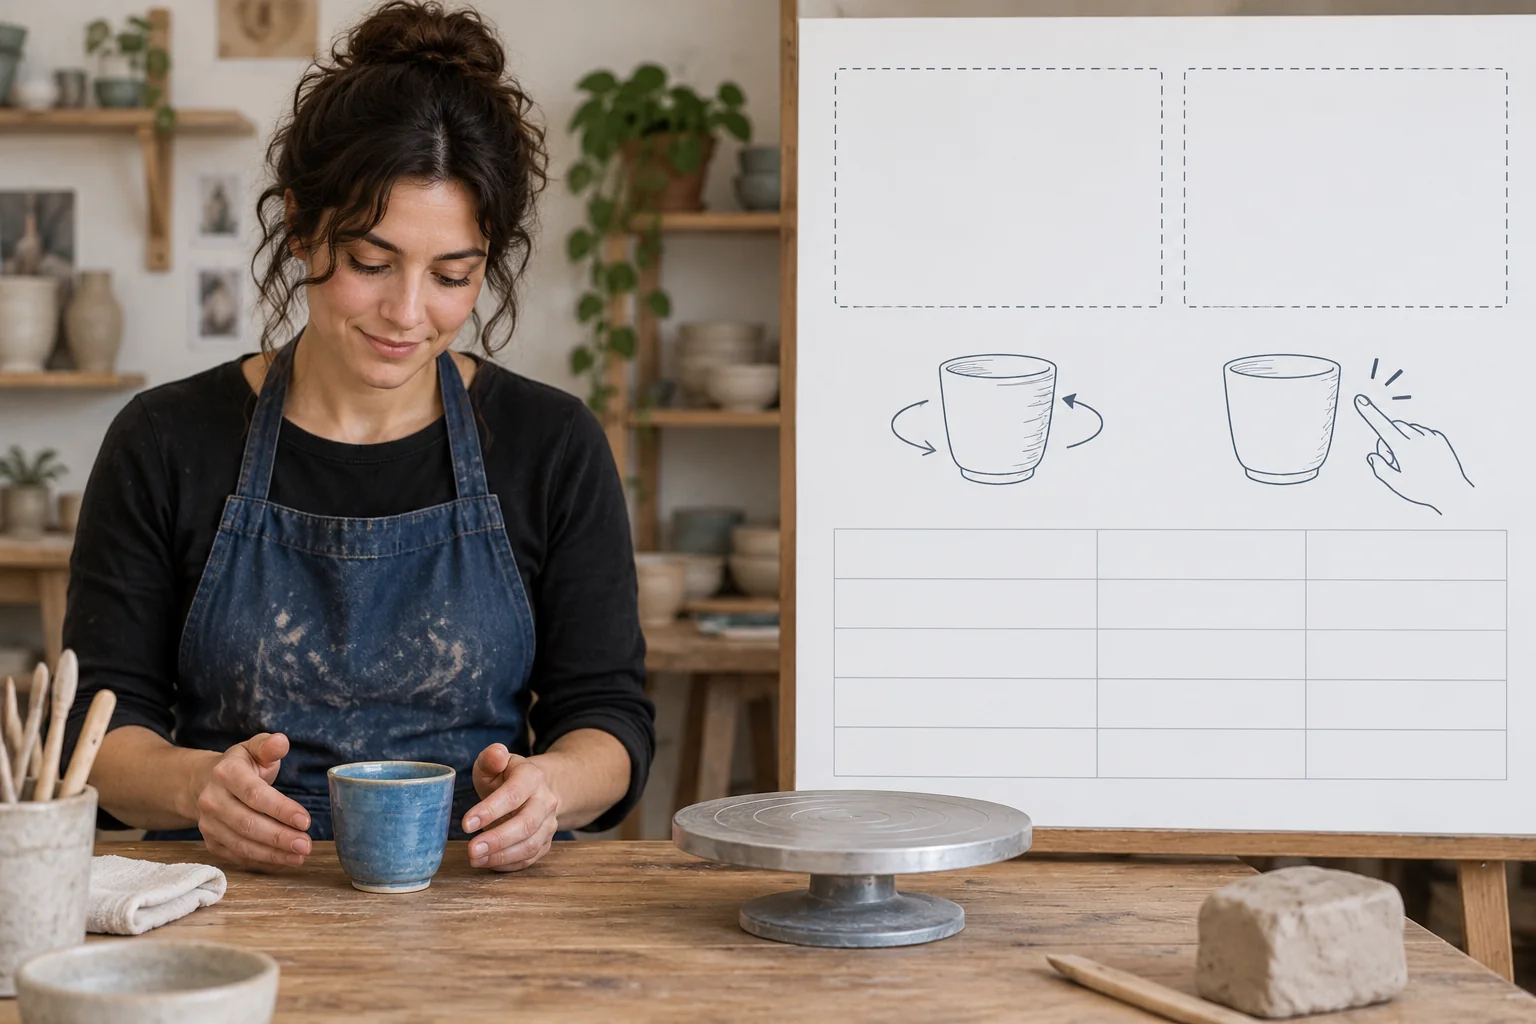
Ein Töpfer, eine blaue Tasse ohne Henkel und eine Tafel mit Skizzen von Drehen und Tippen. Die vom Prompt geforderte Tasse mit Henkel zeigt die letzte Illustration.
Den Fehler beheben, der für das Briefing zählt
Ändern Sie die Anweisung, die zum sichtbaren Problem gehört, statt nach jedem Versuch den ganzen Prompt umzuschreiben.
| Problem | Nächste Änderung | Warum |
|---|---|---|
| Form oder Henkel der Tasse driftet | Die Quellansicht verbessern und die Drehung vereinfachen | Legt das Objekt fest, bevor komplexe Bewegung verlangt wird |
| Hände greifen durch die Tasse | Mit Händen beginnen, die bereits nahe am vorgesehenen Kontakt sind; die Bewegung verringern | Entfernt den schwierigen Übergang aus Annäherung und Greifen |
| Das Tippen kommt vor der Drehung | Die Reihenfolge der Handlung in einem kurzen Satz halten | Macht die beabsichtigte Abfolge klarer |
| Mehrere Handlungen drängen sich in fünf Sekunden | Nur Drehen und Ablegen testen, dann das Tippen ergänzen | Trennt zu wenig Zeit von einem Fehler der Objektkontrolle |
| Die Kamera wechselt trotz Briefing | Ein komponiertes Startbild und eine Anweisung für eine durchgehende Einstellung nutzen | Gibt der Ansicht einen visuellen Anker |
| Visuell korrekte Einstellung, störender Ton | Die Einstellung behalten und ihre Tonspur bearbeiten, wenn das Projekt es erlaubt | Vermeidet, eine andere Darbietung nur zur Tonreparatur zu kaufen |
| Falsche Identität bei der Referenzkomposition | Die Bildrollen klarstellen oder ein kombiniertes Startbild vorbereiten | Trennt die Referenzauswahl von der Animation eines ersten Bildes |
Nehmen Sie bei kreativer Arbeit mit Erwachsenen-Inhalten Garderobe und beabsichtigten Endzustand in die freigegebene Quelle bzw. das Briefing auf. Wenn die Szene in der Intensität über das Angefragte hinausgeht, zählt das als Treueproblem und nicht als automatische Verbesserung. Die Akzeptanz des Inhalts ist nur eine Bedingung für eine brauchbare Einstellung.
Ein kleines Vergleichsbudget, das Sie tatsächlich nutzen können
Richten Sie den Versuch an der Entscheidung aus. Wenn eine durchgehende Einstellung von achtzehn Sekunden bereits für LTX spricht, finanzieren Sie keine unzusammenhängenden H3-Anfragen, um die Dauergrenze erneut zu belegen. Wenn Sie H3s Referenzsammlung brauchen, vergleichen Sie Referenzanordnungen innerhalb von H3. Wenn es um die gemeinsame Bewegung ab Startbild geht, beginnen Sie dort, statt für Text- und Bildzweig zu zahlen.
Bei fünf Sekunden und 2k:
- Ein Startbild-Paar: $0.95 + $0.29 = $1.24.
- Ein Paar für Text und eines für Bild: vier Clips, $2.48.
- Zwei Versuche pro Modell in jedem Modus: acht Clips, $4.96.
Diese Zwischensummen enthalten weder die Erstellung von Quellbildern noch Referenzen, weitere Überarbeitungen oder Nachbearbeitung. Ein Paar zeigt, was bei einer Einstellung geschah; es misst keine stabile Trefferquote. Wiederholen Sie nur, wenn das erste Ergebnis eine wichtige Entscheidung offen lässt.
Für eine strenge Baseline behalten Sie dieselbe Quelle und denselben Prompt bei und geben jedem Modell gleich viele Versuche. Wenn Sie die Formulierung für ein Modell anpassen, halten Sie diesen Zweig getrennt und geben dem anderen dieselbe Gelegenheit. Ein gleicher Seed bei verschiedenen Modellen würde ihre Zufälligkeit nicht angleichen, selbst wenn beide einen anböten; hier bietet nur LTX einen.
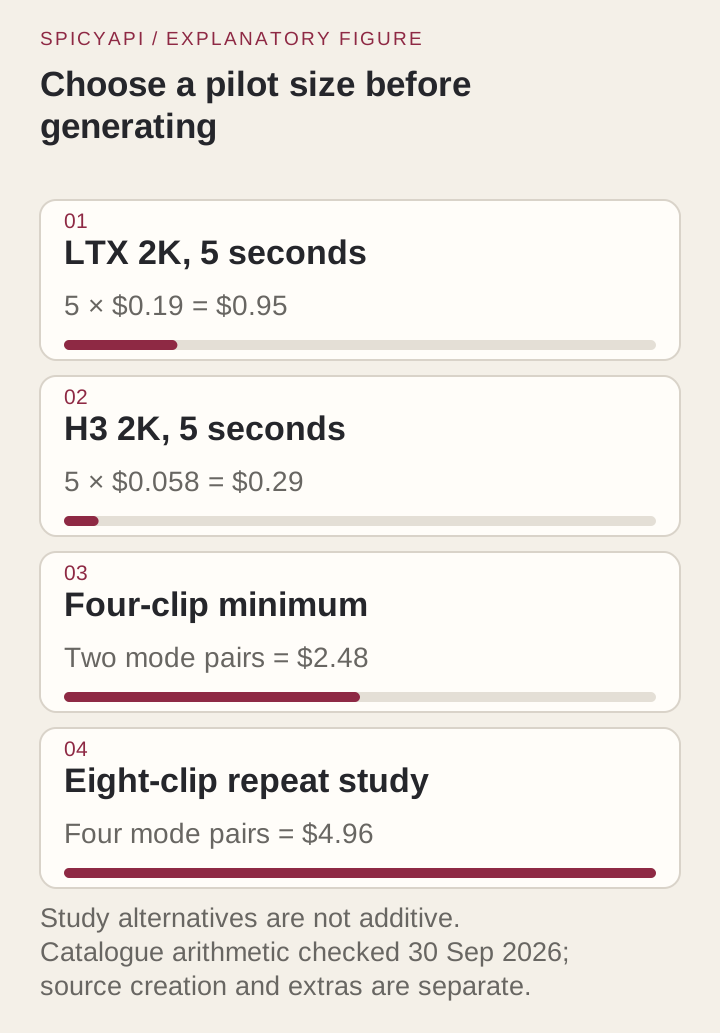
Das Minimum von vier Clips im Diagramm deckt Text- und Bildmodus ab. Für einen Startbild-Vergleich kosten zwei Clips $1.24; die Vorbereitung der Quelle kommt hinzu, und die Alternativen sind nicht additiv.
Lokaler Betrieb, Geschwindigkeitsangaben und Nutzungsbedingungen
Die Vergleichsseite von Lightricks vermischt native Fähigkeiten und unterschiedlich beschriebene Deployments. Eine lokale Generierungszeit und eine Abschlusszeit der gehosteten API sind nicht direkt vergleichbar. Die Community-Diskussion zu dieser Tabelle wirft genau dieses Problem des Geltungsbereichs auf; ihre Meinungen sind kein vergleichbarer SpicyAPI-Benchmark.
Für gehostete Arbeit spricht der aktuelle Schnappschuss der Abschlusszeiten über 30 Tage für H3 als schnellere Iteration:
| Kennzahl zur Abschlusszeit | LTX 2.5 | MiniMax H3 |
|---|---|---|
| Median | 85 Sekunden | 34 Sekunden |
| 90. Perzentil | 3.7 Minuten | 1.7 Minuten |
| Wartezeit pro Ausgabesekunde | 10.5 Sekunden | 3.8 Sekunden |
Diese gleitenden Werte umfassen gemischte Dauern, Auflösungen und interne Testaufträge; es sind keine vergleichbaren Fünf-Sekunden-Versuche. H3 ist der vielversprechendere Ausgangspunkt, wenn es auf die Durchlaufzeit ankommt, während die tatsächliche Anfrage auch außerhalb dieser typischen Zeiten enden kann.
Native Gewichte und ihre lizenzierte Nutzung unterliegen eigenen Bedingungen. Die H3-Community-Lizenz schließt die USA, die EU, das Vereinigte Königreich und Südkorea aus ihrem Standardgebiet aus und regelt ausdrücklich gehostete Dienste und Ausgaben. Die LTX-2.x-Lizenz hat andere kommerzielle Bedingungen. Die Verfügbarkeit im Katalog begründet für sich genommen keine Berechtigungen für ein bestimmtes Deployment oder eine bestimmte Nutzung; ziehen Sie neben den Modellbedingungen auch den geltenden Dienstvertrag zurate.
Häufig gestellte Fragen
Was ist besser für NSFW-Video, LTX 2.5 oder MiniMax H3?
Beide akzeptierten Anfragen für Erwachsene in den archivierten Stichproben der Basisaufgaben. LTX hatte ein abgeschwächtes Textergebnis; H3s kleinere Erwachsenen-Stichprobe passte durchgängig. Diese unterschiedlichen Stichproben beweisen keinen allgemeinen Sieger. Nutzen Sie H3 für günstige kurze Entwürfe oder mehrere Bildreferenzen und LTX für die längere Einstellung oder die 4K-Stufe; beurteilen Sie dabei Inhalt und Bewegung gemeinsam.
Ist MiniMax H3 bei gleicher Ausgabestufe günstiger?
Beim gemeinsamen 2k-Label kosten fünf Sekunden bei H3 $0.29 gegenüber $0.95 bei LTX. Referenzeingaben verursachen Gebühren, und die dekodierten Maße sollten geprüft werden, bevor man von einem Vergleich bei identischer Pixelzahl spricht. Die tatsächlichen Produktionskosten bestimmen die abgeschlossenen Versuche, die bis zur finalen Einstellung nötig waren.
Kann H3 bei diesen Aufgaben einen Clip von zwanzig Sekunden oder in 4K erzeugen?
Nein. Diese gehosteten Basis-H3-Aufgaben enden bei fünfzehn Sekunden und 2k. LTX 2.5 listet bis zu zwanzig Sekunden und eine 4K-Stufe. Mehrere H3-Clips in einem Editor zusammenzufügen ist möglich, ergibt aber eine Sequenz und keine garantiert ununterbrochene Generierung von zwanzig Sekunden.
Kann ich bei beiden dieselben Start- und Endbilder verwenden?
Ja, bei den beiden image-to-video-Aufgaben. Verwenden Sie identische Dateien und kompatible Kompositionen. Prüfen Sie neben den Endpunkten auch die Mitte der zurückgegebenen Clips: Ein ähnliches letztes Bild beweist nicht, dass Hände und Objekte während des Übergangs stimmig blieben.
Erzeugen beide Ton, und welches ist schneller?
Beide erzeugen Audio-Video. H3 hat im obigen Vergleich den kürzeren gehosteten Median: etwa eine halbe Minute gegenüber fast anderthalb Minuten bei LTX. Das spricht für H3 bei schnellen Entwürfen, doch Zeitwerte aus gemischter Last bewerten weder Dialogqualität noch Synchronität.
Die Entscheidung
Für eine kurze Szene ohne besondere Lieferanforderung ist H3 der kostengünstigere Ausgangspunkt. Für eine lange durchgehende Einstellung, eine gelistete 4K-Ausgabe oder eine Iteration mit Seed-Kontrolle bietet LTX die passenden Steuerungen. Wählen Sie H3-Referenzen, wenn getrennte Einzelbilder eine neue Komposition bestimmen sollen. Wählen Sie bei beiden die Startbild-Generierung, wenn die Komposition bereits freigegeben ist.
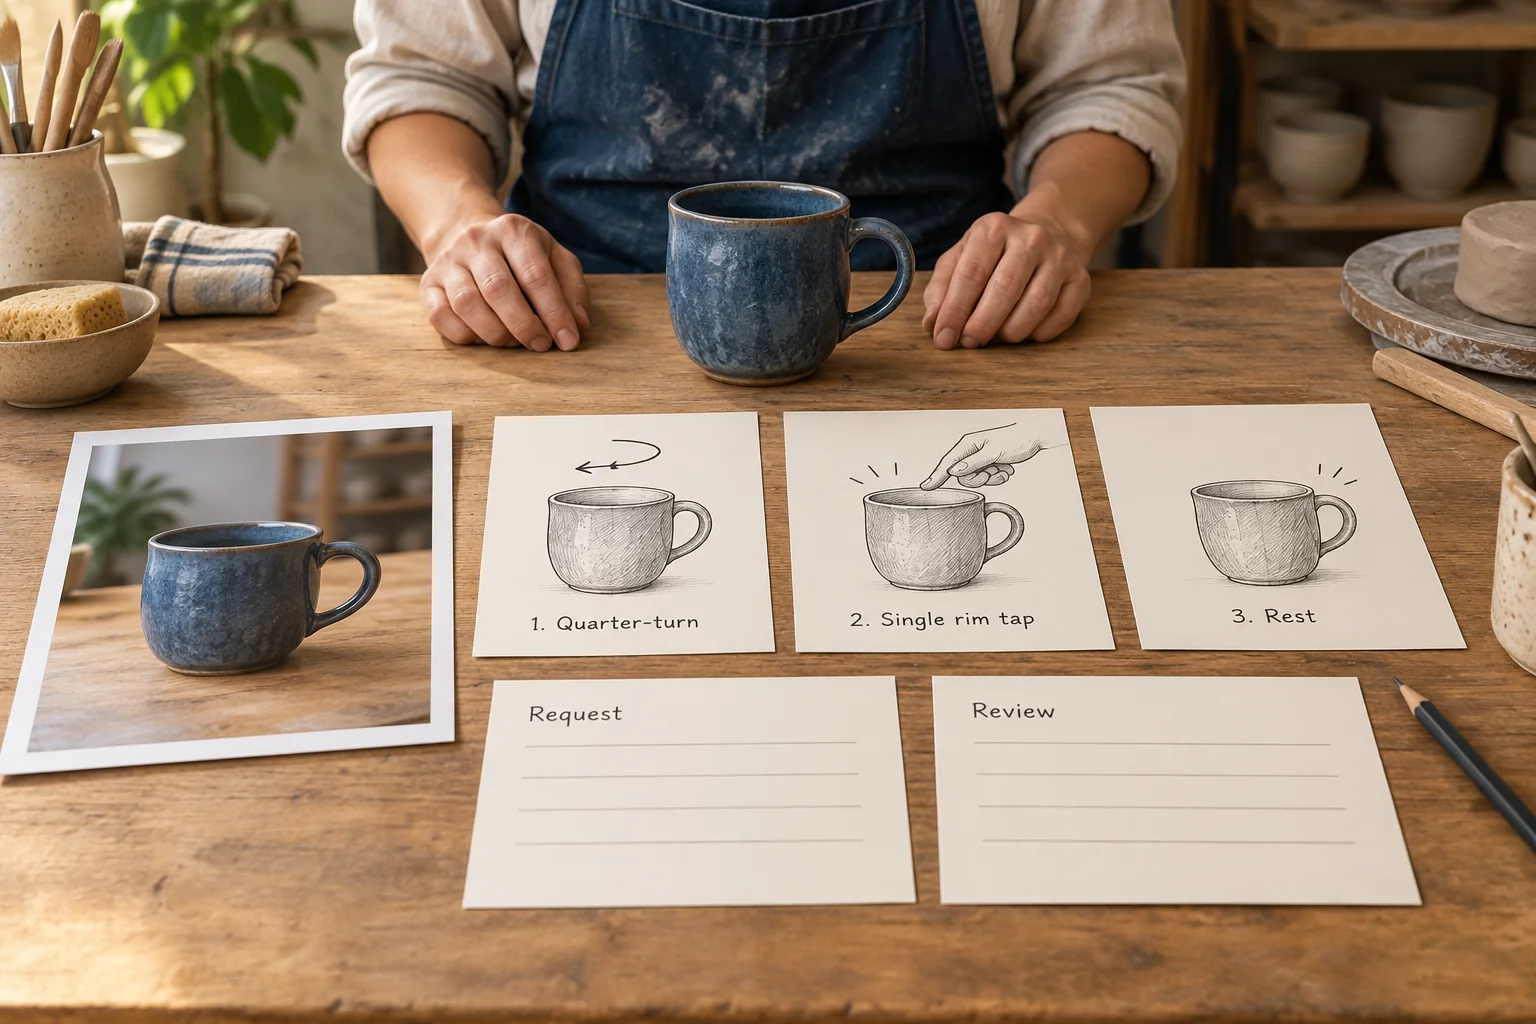
Die Tasse mit Henkel und die drei Handlungen nach der Annäherung der Hände: Vierteldrehung, einmaliges Tippen an den Rand und Ablegen.
Wenn beide Aufgaben passen, nutzen Sie das Paar aus fünf Sekunden in 2k für $1.24, um die tatsächliche Bewegungsfrage zu klären, statt standardmäßig einen breiten Benchmark zu kaufen. Beurteilen Sie Handlung, Erhalt der Quelle, Ton und Kosten gemeinsam und behalten Sie das Modell, das die Einstellung liefert, die Ihr Projekt braucht.