Sie hängen ein LoRA an und erhalten ein fertiges Porträt, das genauso aussieht wie das des Basismodells. Ein erfolgreicher Auftrag allein zeigt nicht, ob der Adapter das Bild beeinflusst hat. Führen Sie dazu denselben Prompt mit demselben Seed dreimal aus: zweimal ohne LoRA, einmal mit. Die drei Ausgaben kosten bei $0.012 pro Bild zusammen $0.036. Vergleichen Sie sie, um zu sehen, ob die gewünschte Stil- oder Identitätsänderung über die normale Streuung des Basismodells hinaus sichtbar wird.
Die zweite Frage ist bei Inhalten für Erwachsene die wichtigste. Das Basismodell setzt auch reife Briefings ohne Filter um, ein expliziteres Ergebnis mit angehängtem Adapter kann also vom Basismodell stammen. Nur die Kontrolle zeigt, was von was kommt.
Zuerst im Playground ausprobieren
Öffnen Sie den z-image-turbo-lora Playground in der Form view und setzen Sie für alle drei Durchläufe dieselben Werte:
- Tragen Sie unter Prompt einen einfachen Porträt-Prompt ein, setzen Sie Aspect ratio auf 1:1, Output format auf PNG und Seed auf 42. JPEG-Kompression erzeugt Rauschen, das den Pixelvergleich verfälscht.
- Leeren Sie unter Style LoRAs die Liste mit Remove item und starten Sie zweimal. Das sind Ihre beiden Kontrollen.
- Wählen Sie Add item, fügen Sie den direkten
.safetensors-Link bei LoRA file ein, lassen Sie Strength auf 1 und starten Sie einmal. (Der Playground nennt die LoRA-Skalierung „Strength“; das API-Feld heißtscaleund ist nicht der unten beschriebenestrength-Regler bei Bild-zu-Bild.) - Legen Sie die drei Ausgaben nebeneinander: Zeigt sich die gewünschte Stil- oder Identitätsänderung über den Unterschied zwischen den beiden Kontrollen hinaus?
Der Realism-Adapter kann ein ohnehin fotografisches Porträt nur dezent verändern. Wählen Sie für einen deutlicheren ersten Test ein Turbo-kompatibles LoRA mit Malstil oder Farbkorrektur und das Triggerwort seines Autors. Ein kleiner Unterschied bei Realism heißt nicht, dass das Laden fehlgeschlagen ist.
Den Drei-Aufträge-Test über die API ausführen
Um den Unterschied zu messen statt nur zu schätzen, führen Sie dieselben drei Aufträge aus Python aus. Installieren Sie spicyapi und pillow, setzen Sie SPICY_API_KEY und starten Sie:
import os
import uuid
import urllib.request
from io import BytesIO
from PIL import Image, ImageChops, ImageStat
from spicyapi import SpicyClient, output_assets

client = SpicyClient()
MODEL = "alibaba/z-image-turbo-lora/text-to-image"
inputs = {"prompt": "Realism, studio portrait of a woman in a burgundy blazer, soft window light, grey backdrop",
          "aspect_ratio": "1:1", "output_format": "png", "seed": 42,
          "loras": [{"path": "https://huggingface.co/suayptalha/Z-Image-Turbo-Realism-LoRA/resolve/8dc179cb56844d4ddc6e4527c30e98347eeae971/pytorch_lora_weights.safetensors", "scale": 1}]}

images = []
for name, loras in [("base-1", []), ("base-2", []), ("lora", inputs["loras"])]:
    body = {**inputs, "loras": loras}
    quote = client.quote_task(model=MODEL, input_data=body)
    if input(f"{name}: maximum ${quote['maxCharge']}. Create? [y/N] ") != "y":
        raise SystemExit("Stopped")
    task = client.create_task(model=MODEL, input_data=body, idempotency_key=str(uuid.uuid4()),
                              quote_id=quote["quoteId"], expected_cost=quote["estimatedCost"])
    final = client.wait_for_terminal(task["taskId"])
    url = output_assets(final)[0]["url"]
    request = urllib.request.Request(url, headers={"User-Agent": "Mozilla/5.0"})
    data = urllib.request.urlopen(request, timeout=120).read()
    open(name + ".png", "wb").write(data)
    images.append(Image.open(BytesIO(data)).convert("RGB"))

for label, other in [("control gap", images[1]), ("LoRA gap", images[2])]:
    diff = ImageStat.Stat(ImageChops.difference(images[0], other)).mean
    print(label, sum(diff) / 3 / 255 * 100)
Die Aufgabenverwaltung deckt das Python SDK ab. Verwenden Sie eine auf eine Version festgelegte, direkte LoRA-Datei und das Triggerwort des Autors; wer die Datei zwischen den Kontrollen wechselt, macht den Vergleich wertlos. Ein gleicher Seed kann trotzdem andere Pixel liefern, vergleichen Sie also zuerst die beiden Kontrollen, bevor Sie den Adapter-Wert deuten.
Das Ergebnis lesen
| Kontrolle vs. LoRA, verglichen mit Kontrolle vs. Kontrolle | Bedeutung | Was zu tun ist |
|---|---|---|
| Etwa auf Höhe des Rauschniveaus, die Bilder sehen ähnlich aus | In diesem Prompt kein sichtbarer Adaptereffekt | Prüfen Sie die Basis, für die er trainiert wurde, das Triggerwort und den Dateityp (siehe unten) und nutzen Sie dann die vom Autor empfohlene Skalierung; ist keine angegeben, vergleichen Sie 0.5, 1 und 1.5 |
| Deutlich über dem Kontrollabstand (auch bei Kontrollen ohne Abstand), Ziel-Look sichtbar, Motiv intakt | Hinweis auf den gewünschten Adaptereffekt; über weitere Seeds bestätigen | Behalten; mit zwei oder drei anderen Seeds wiederholen |
| Weit über dem Rauschniveau, aber Motiv, Gesicht oder Ausschnitt haben sich verändert | Große Änderung, aber noch kein brauchbares Ergebnis | Vergleichen Sie niedrigere Skalierungen wie 0.8 und 0.6 mit derselben Kontrolle |
| Die Kontrolle entspricht bereits Ihrem Briefing | Der Adapter fügt nichts hinzu, was Sie brauchen | Weglassen; ein LoRA ist ein Stil- oder Identitätsregler, keine Pflicht |
Die Zahlen sind ein Vorfilter, entscheiden tun Ihre Augen. Eine kleine Kameraverschiebung ändert viele Pixel, ein verändertes Gesicht nur wenige. Achten Sie daher auf Identität, Stil, Ausschnitt sowie Kostüme oder Requisiten, die Sie nicht verlangt haben, bevor Sie einem Prozentwert trauen. Die Prozentwerte sind keine Schwellen für andere Dateien oder Größen. Unterscheiden Sie bei Szenen für Erwachsene außerdem eine Ablehnung von einem fertigen, aber abgeschwächten Bild: Es wird berechnet und kann sauber aussehen, obwohl es das Briefing verfehlt.
Warum ein LoRA nichts bewirkt
Wenn der Auftrag abgeschlossen wurde, Sie aber keinen gewünschten Effekt sehen, gehen Sie diese Punkte der Reihe nach durch:
- Nicht dokumentierte Kompatibilität. Bevorzugen Sie eine Turbo-spezifische Datei oder eine auf Base trainierte Datei, deren Autor die Kompatibilität mit Turbo dokumentiert. Auf Base trainierte Adapter sind kein automatischer Ersatz. Folgen Sie den Turbo-Einstellungen des Autors und führen Sie die Kontrolle ohne LoRA durch, statt anzunehmen, dass eine größere Skalierung die Inkompatibilität behebt.
- Falscher Adaptertyp. Standard-LoRA ist das sichere Format. Ein ComfyUI-Bericht beschreibt, dass LoKR-Adapter für Z-Image Turbo als „lora key not loaded“ protokolliert und ignoriert wurden, während Standard-LoRAs funktionierten (ComfyUI issue 10973); das ist ein Bericht zum lokalen ComfyUI-Loader. Verwenden Sie hier ein Standard-Turbo-LoRA, statt anzunehmen, dass der Endpoint LoKR-Dateien unterstützt.
- Fehlendes Triggerwort. Stil- und Charakterdateien reagieren auf ihr Triggerwort. Beginnen Sie den Prompt damit.
- Skalierung zu niedrig oder dezente Datei. Testen Sie 0.5, 1 und 1.5 und halten Sie alles andere fest.
- Linkprobleme. Eine Seiten-URL oder eine private Datei schlägt bei der Einreichung oder danach fehl; verwenden Sie eine direkte, erreichbare Modelldatei.
Bild-zu-Bild hat zwei Regler
Die Bild-zu-Bild-Aufgabe ergänzt image_url, resolution und ein eigenes strength (0 bis 1, Standard 0.8), das steuert, wie weit sich das Ergebnis von Ihrer Vorlage entfernen darf: Niedrigere Werte bewahren mehr vom Original, Werte nahe 1 erlauben mehr Veränderung. Es gibt keine universelle Einstellung, die ein Gesicht erhält; Werte über 1 werden abgelehnt. Halten Sie strength zusammen mit dem Seed fest, während Sie scale testen, sonst wissen Sie nicht, welcher Regler das Bild bewegt hat.
Welcher Weg für Inhalte für Erwachsene
In unseren Tests im September 2026 ohne LoRA lieferte Text-zu-Bild alle 18 Anfragen, von anzüglich bis explizit. Bild-zu-Bild lieferte 15 von 18: Seine drei Bearbeitungen mit intimen Handlungen ließen die gewünschte Handlung aus, obwohl die extremeren Tests durchliefen. Das Ergebnis hängt von Aufgabe und Szene ab, nicht einfach von der Stufenbezeichnung. Beginnen Sie daher mit Text-zu-Bild, wenn Sie die Szene von Grund auf beschreiben können, und nutzen Sie Bild-zu-Bild, wenn ein vorhandenes Porträt oder eine vorhandene Komposition erhalten bleiben muss. Ein LoRA fügt dann bei beiden einen Look oder eine Figur hinzu; die Modellrezension enthält die Ergebnisse je Klasse.

Porträt im smaragdgrünen Kleid mit drei farbigen Spiegelungen; vergleichen Sie mit einer passenden Kontrolle ohne LoRA, wenn Sie beurteilen, was der Adapter beiträgt.
Eine Zeile Protokoll aufbewahren
Speichern Sie neben jedem Bild den Prompt, den Seed, das Seitenverhältnis, die Liste mit {path, scale}, strength (falls verwendet) und die Ausgabe-URL. Legen Sie jeden path auf eine Dateiversion fest, die sich nicht ändern kann: Eine Community-URL kann weiter auflösen, während der Autor die Gewichte ersetzt, und ein festgelegter Commit identifiziert die in jedem Durchlauf verwendete Adapterversion.
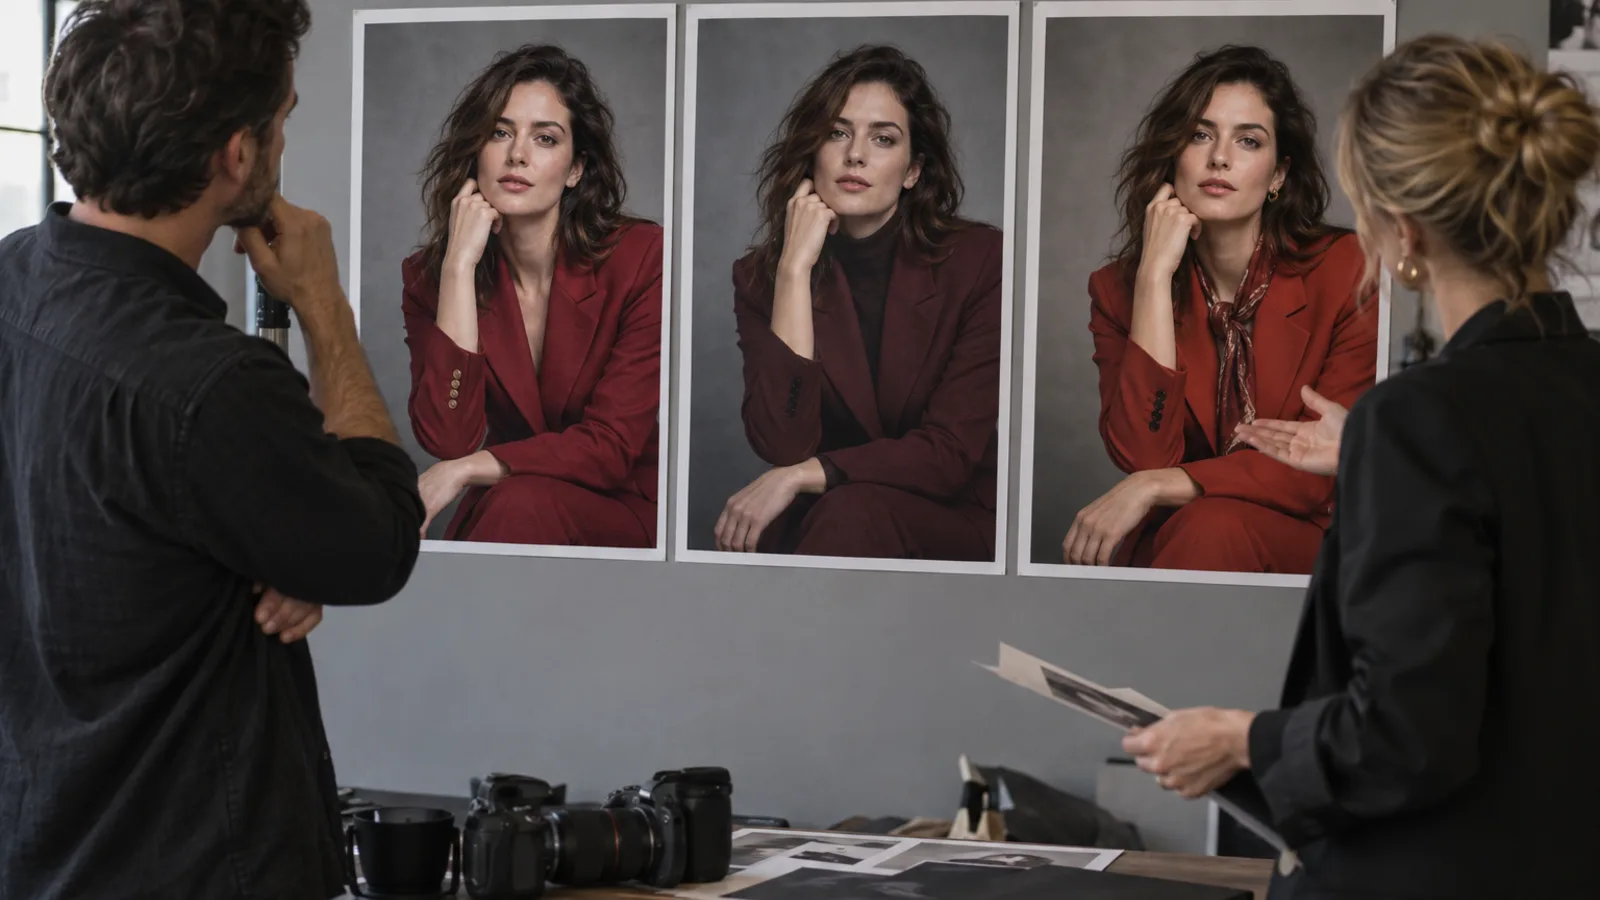
Eine redaktionelle Illustration des Prüfschritts: Dieselbe Person in drei Behandlungen macht die Stiländerung leicht beurteilbar.
FAQ
Liefert derselbe Seed ein pixelgleiches Bild?
Nicht zuverlässig. Wiederholen Sie den Auftrag ohne LoRA und messen Sie ihn am ersten, bevor Sie einem LoRA-Unterschied trauen.
Kann ich drei LoRAs gleichzeitig testen?
Sie können bis zu drei pro Anfrage laden, testen Sie aber zuerst nur eines. Bei mehreren Dateien lässt sich nicht sagen, welche die Abweichung verursacht hat. Fügen Sie das zweite mit etwa 0.5 Skalierung hinzu und erhöhen Sie sie, bis sein Look erscheint.
Schaltet ein angehängtes LoRA stärkere Inhalte frei?
Nicht von selbst: Schreiben Sie dem Adapter nur zu, was gegenüber der Kontrolle erscheint.
Unterstützt Z-Image Turbo LoRA?
Ja. Jede Anfrage nimmt bis zu drei LoRAs entgegen, jeweils ein direkter Link auf eine .safetensors-Datei, deren Kompatibilität mit Z-Image Turbo dokumentiert ist, mit scale von 0 bis 4 (Standard 1). Der Endpoint lädt Gewichte; er trainiert sie nicht. Trainieren Sie die Gewichte separat; der Leitfaden zur gehosteten LoRA-API erklärt, wie Sie die fertige Datei einbinden.
Was kostet das?
Das Laden des LoRA verursacht keine separate Adaptergebühr. Das Live-Angebot bestätigt vor jeder Aufgabe den Gesamtpreis.
Welche Skalierung sollte ich verwenden?
Nutzen Sie den vom Autor empfohlenen Bereich. Ist keiner angegeben, gilt 1 als Plattform-Standard; vergleichen Sie 0.5, 1 und 1.5 mit demselben Prompt und Seed. Driftet das Motiv, senken Sie die Skalierung. Sie zu erhöhen ist keine universelle Lösung für eine Datei, die auf einer anderen Basis trainiert wurde.
Wenn Sie bereits eine Z-Image Turbo-Datei haben, führen Sie den Drei-Aufträge-Test mit Text-zu-Bild aus, bevor ein Batch davon abhängt.
Einen Agent den Aufruf übernehmen lassen
Nutzen Sie einen Agent, wenn er die Eingaben vorbereiten und das Ergebnis zurückgeben soll, während Sie Preis und kreative Entscheidungen freigeben.
- CLI: Speichern Sie dasselbe Eingabeobjekt als
input.jsonund verwenden Sienpx @spicyapi/cli tasks create --model alibaba/z-image-turbo-lora/text-to-image --input-file input.json --wait. Die CLI bestätigt den Preis; bewahren Sie die zurückgegebene Task-ID für die Wiederherstellung auf. - MCP: Bitten Sie Ihren Assistenten,
spicyapi_task_createfüralibaba/z-image-turbo-lora/text-to-imagezu verwenden und danachspicyapi_task_wait. Der MCP server fordert vor dem Anlegen eine Preisbestätigung an. - Skill: Installieren Sie ihn mit
npx skills add spicyapi-ai/spicy-skillund fragen Sie dann „Use the spicyapi skill to run this three-job check and stop for my approval.“ Der Skill nutzt eine konfigurierte CLI- oder MCP-Verbindung.