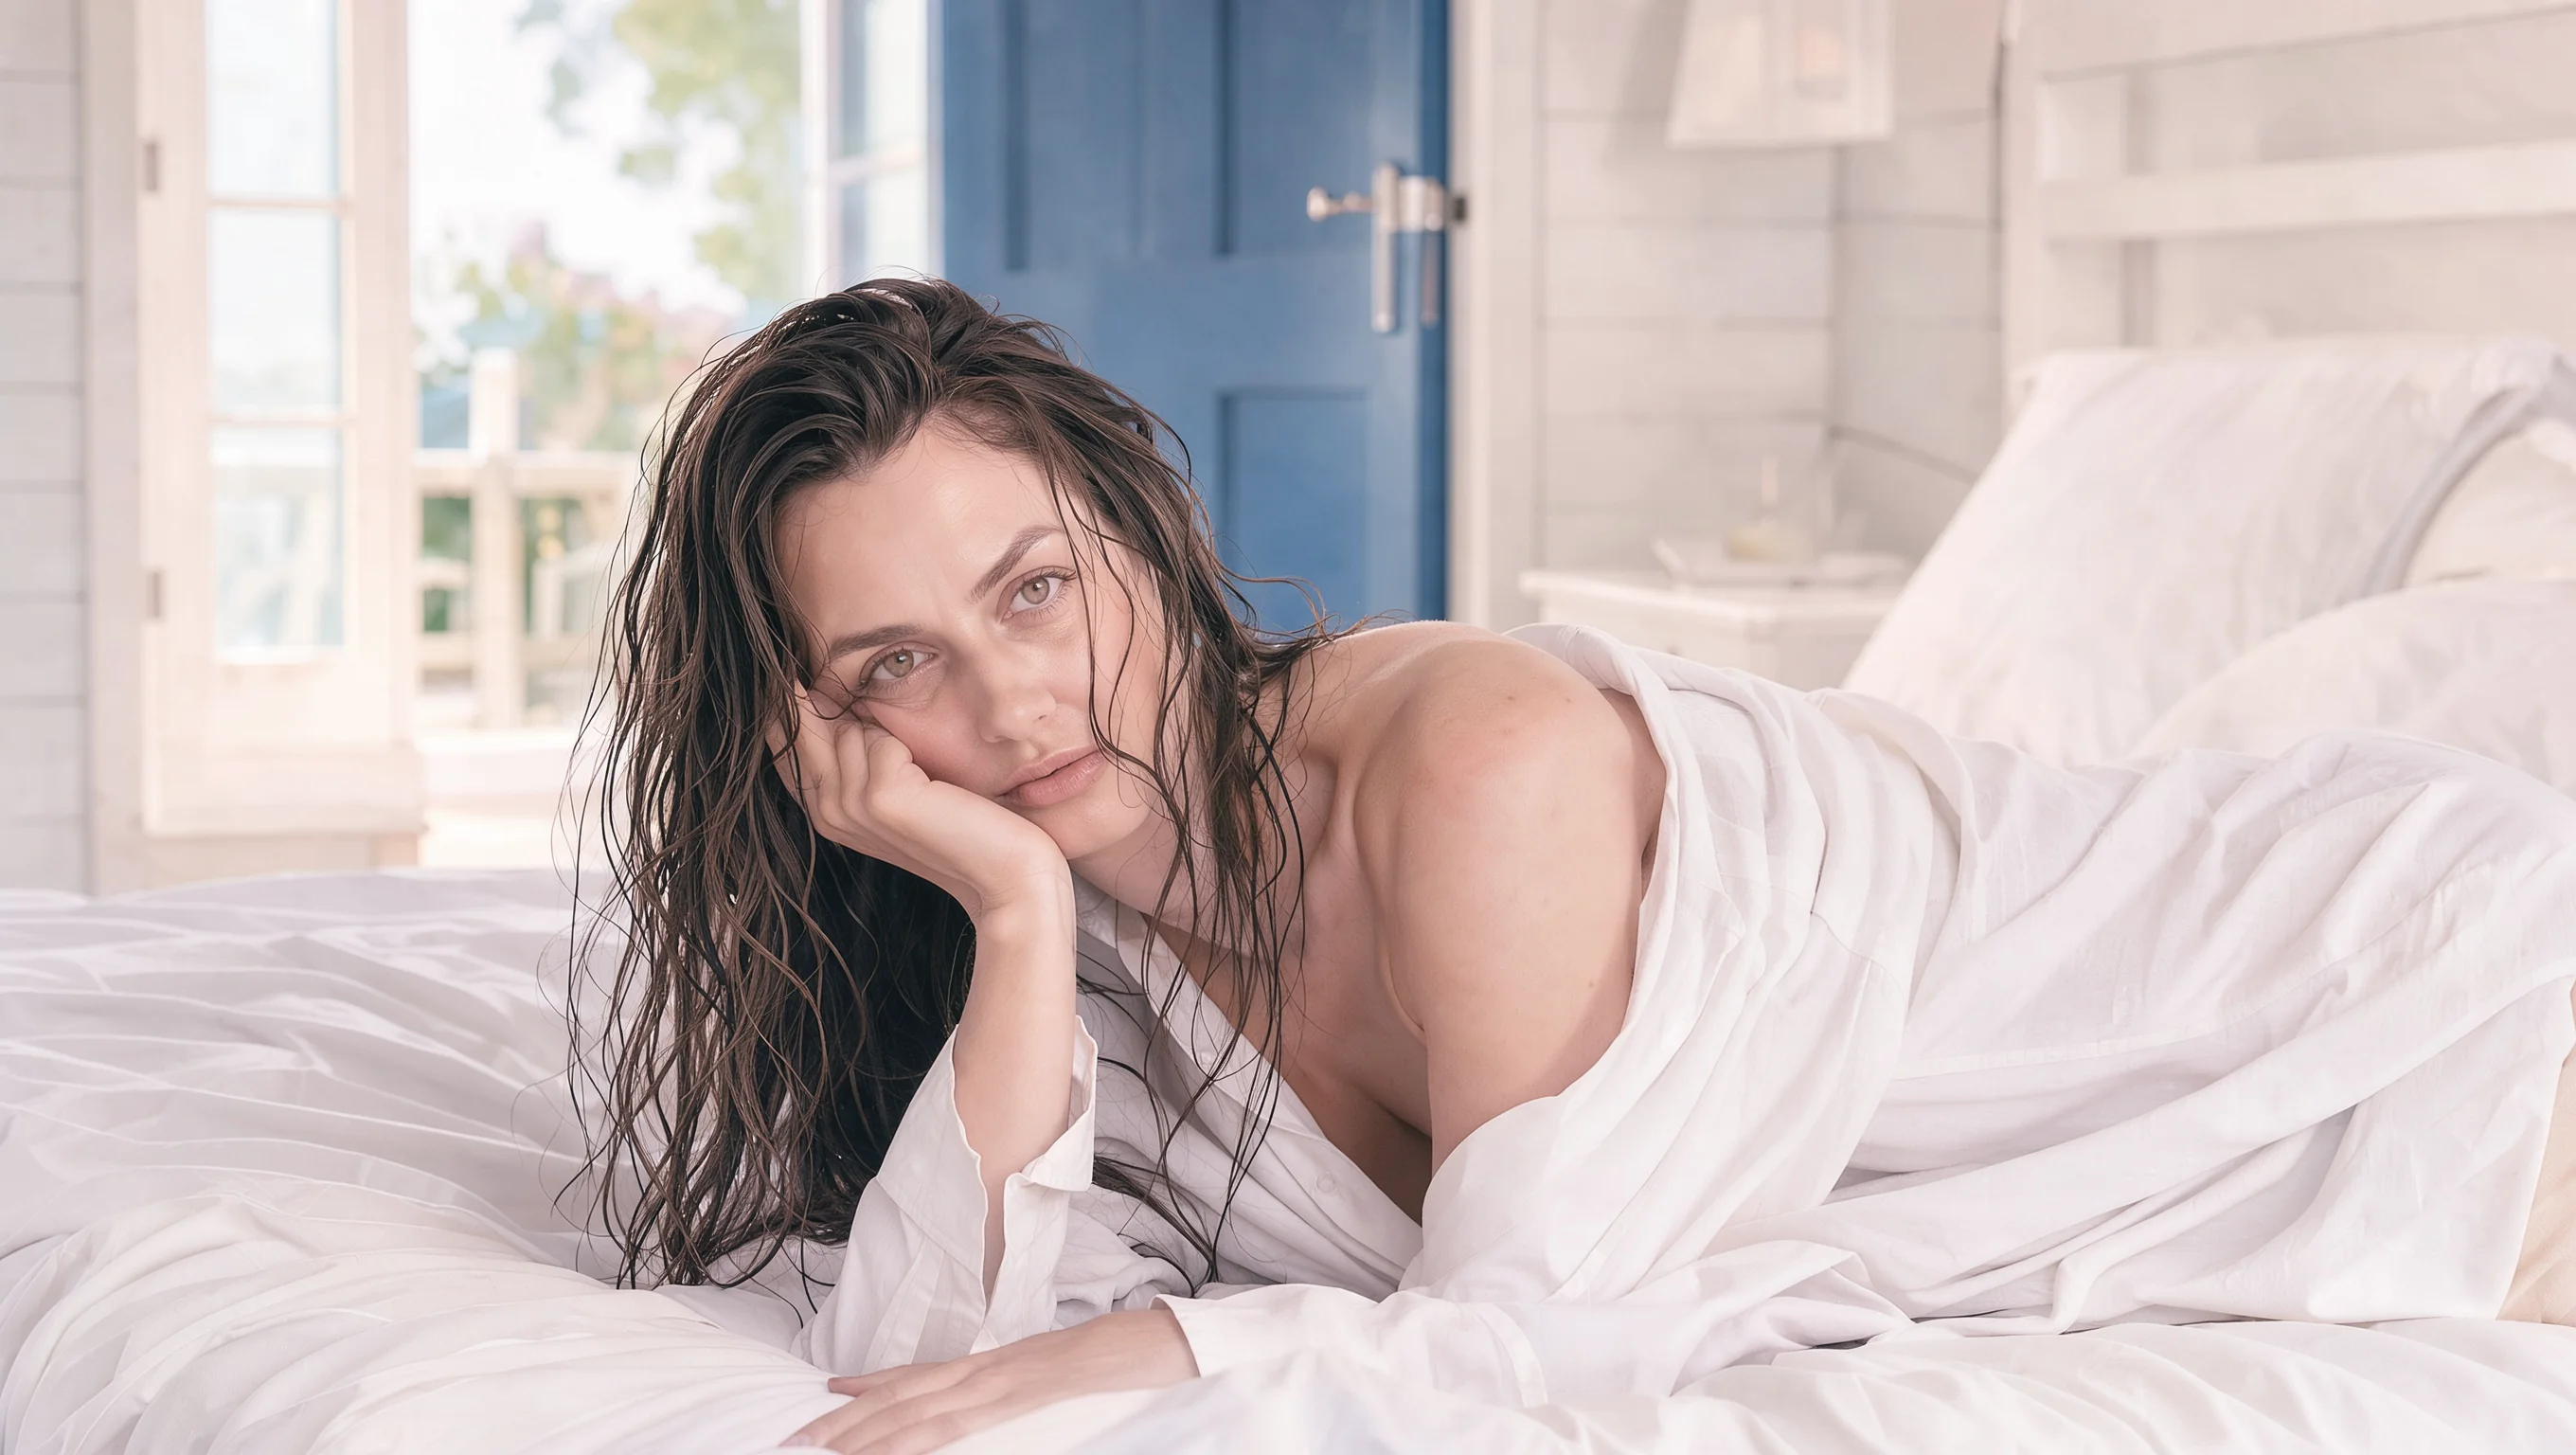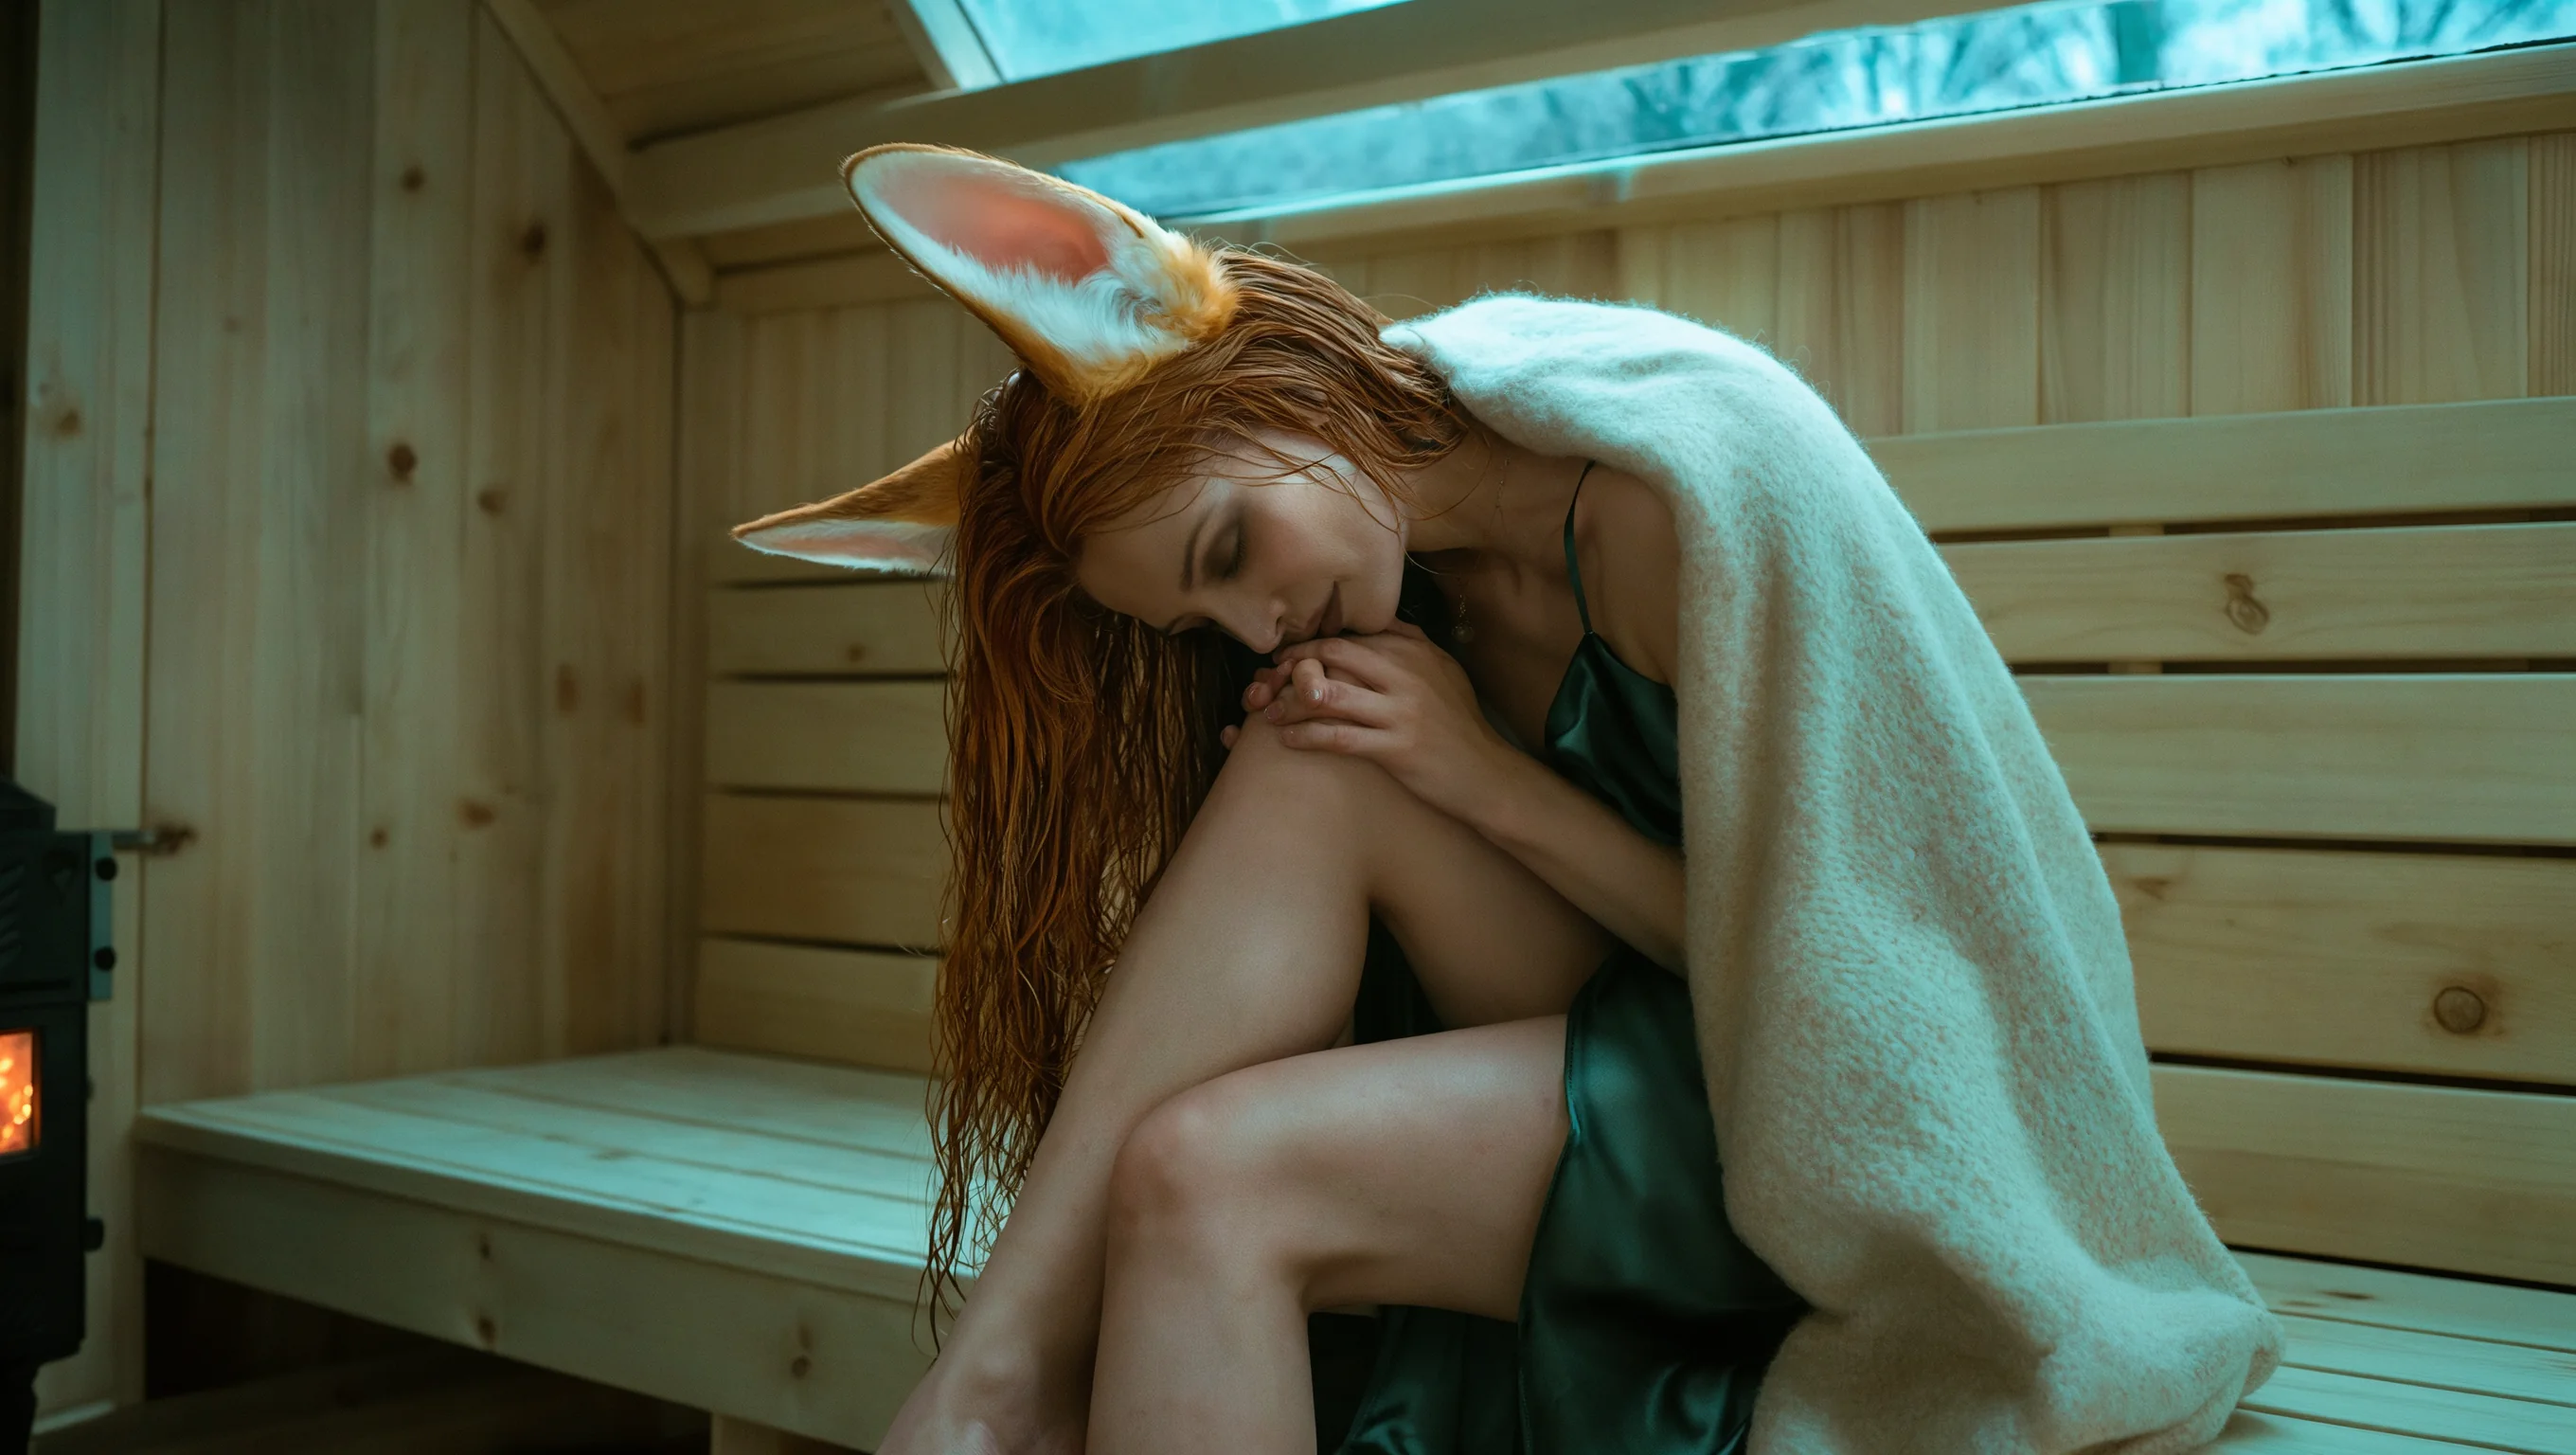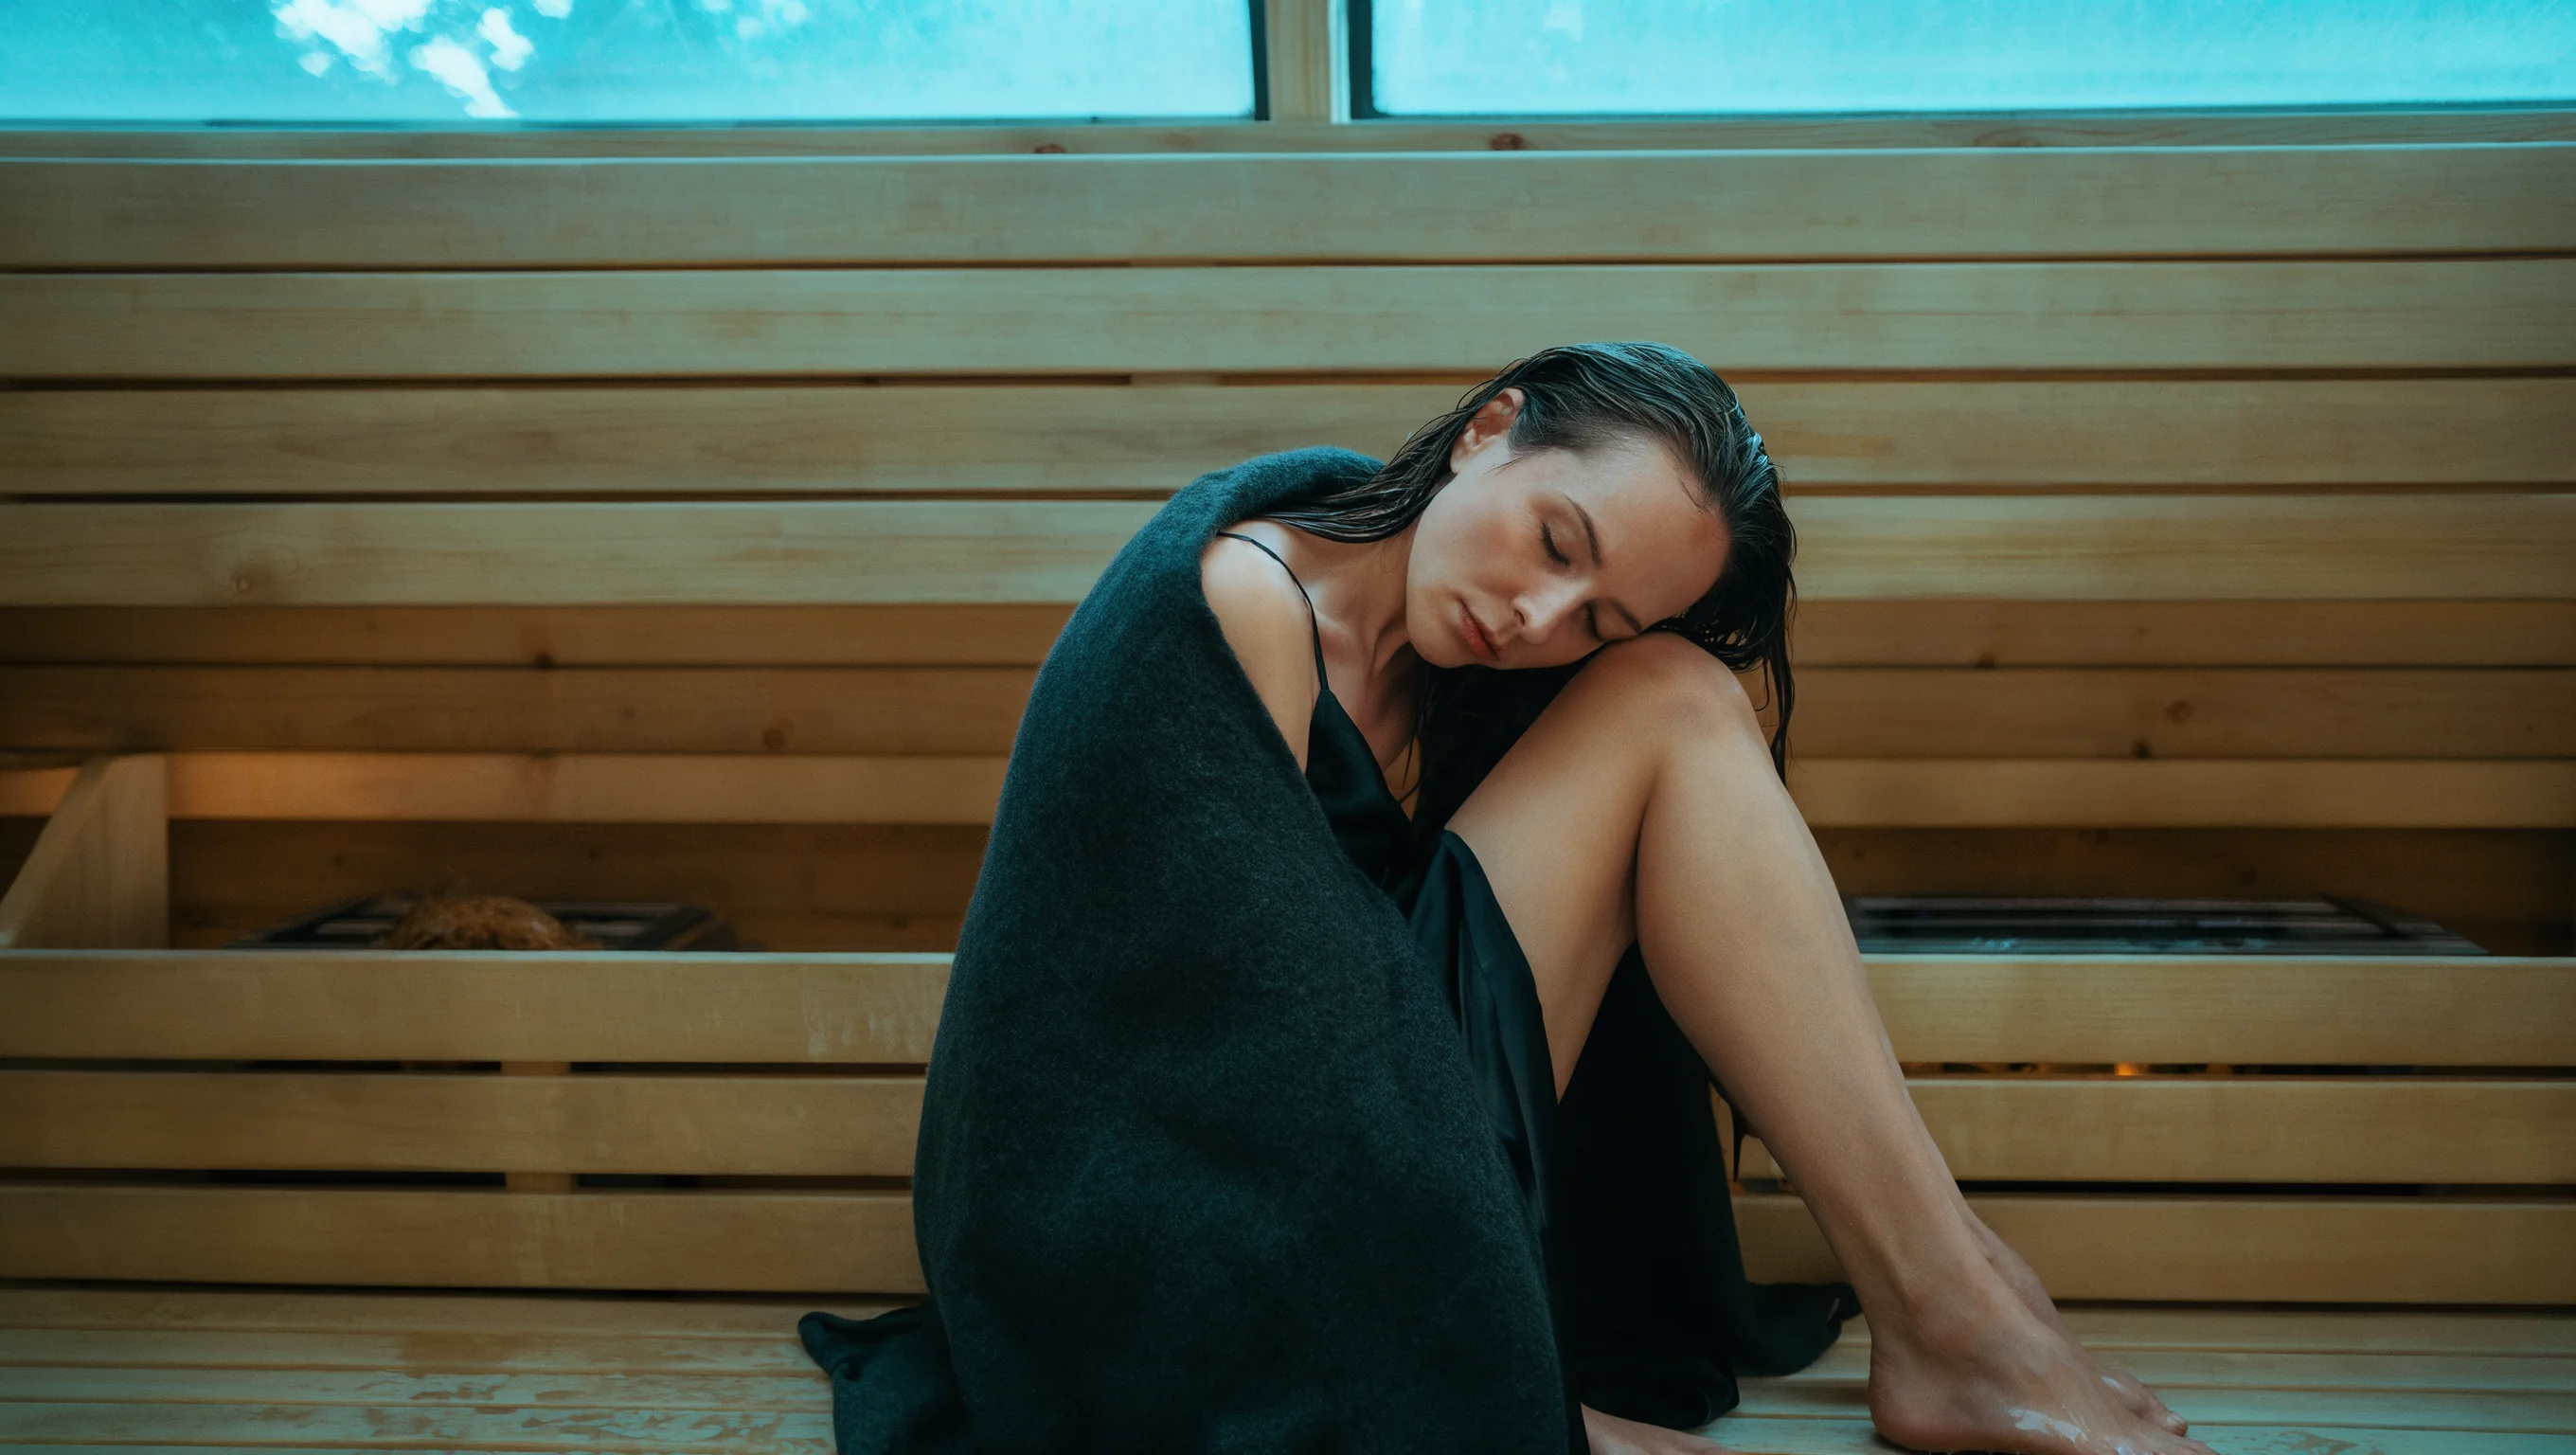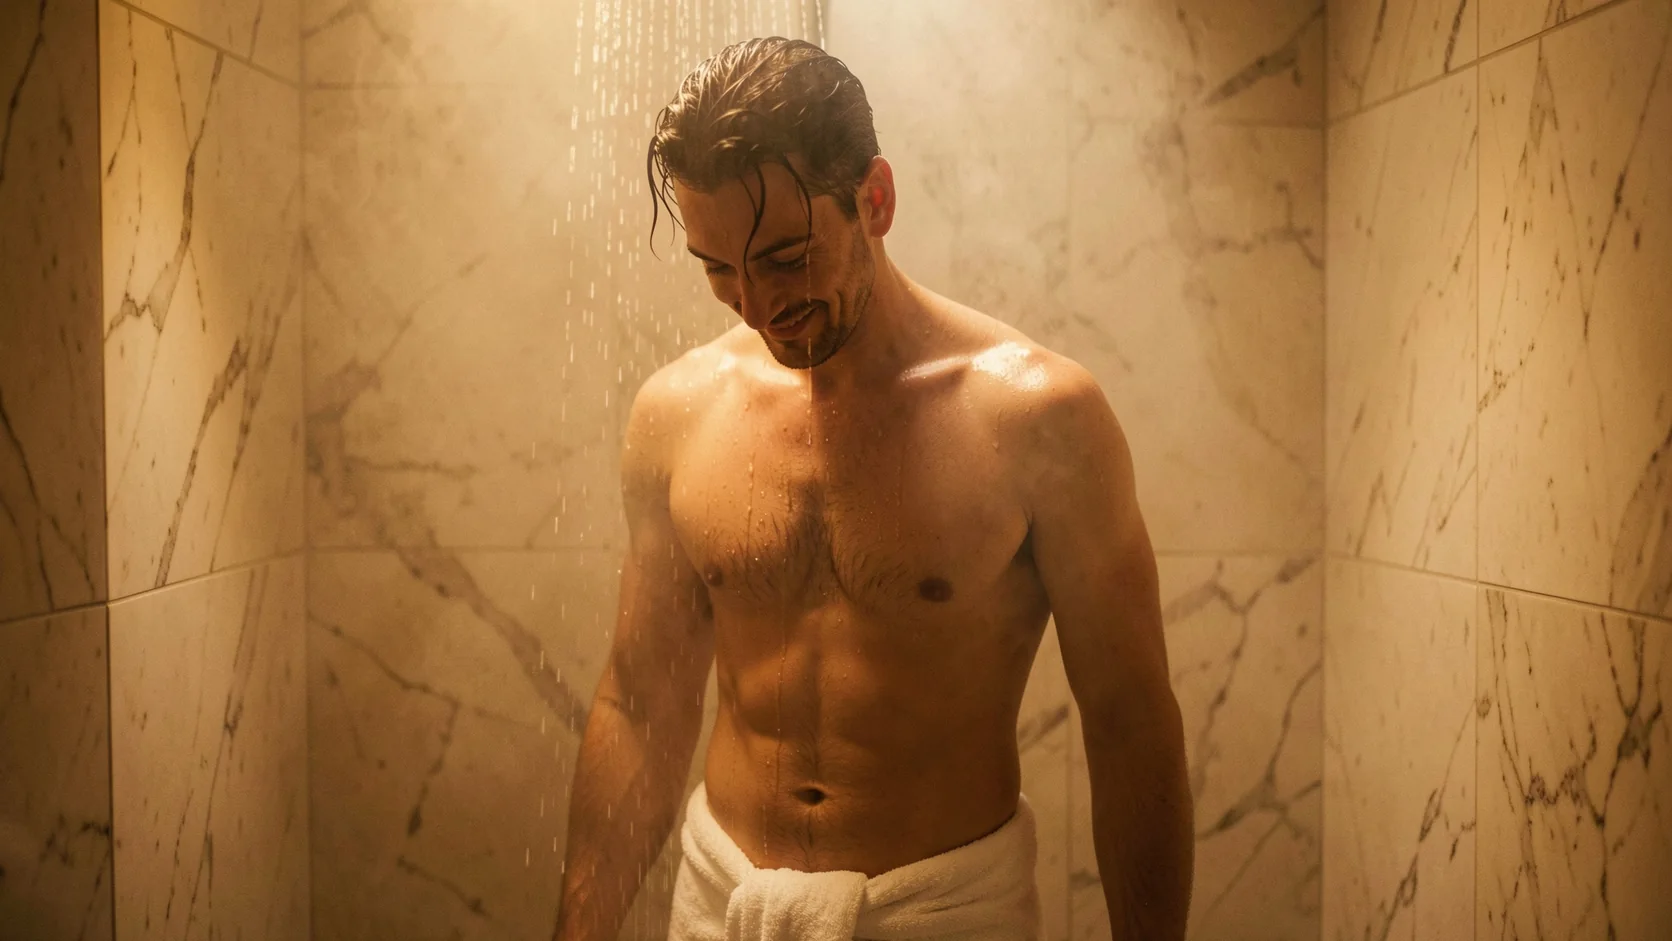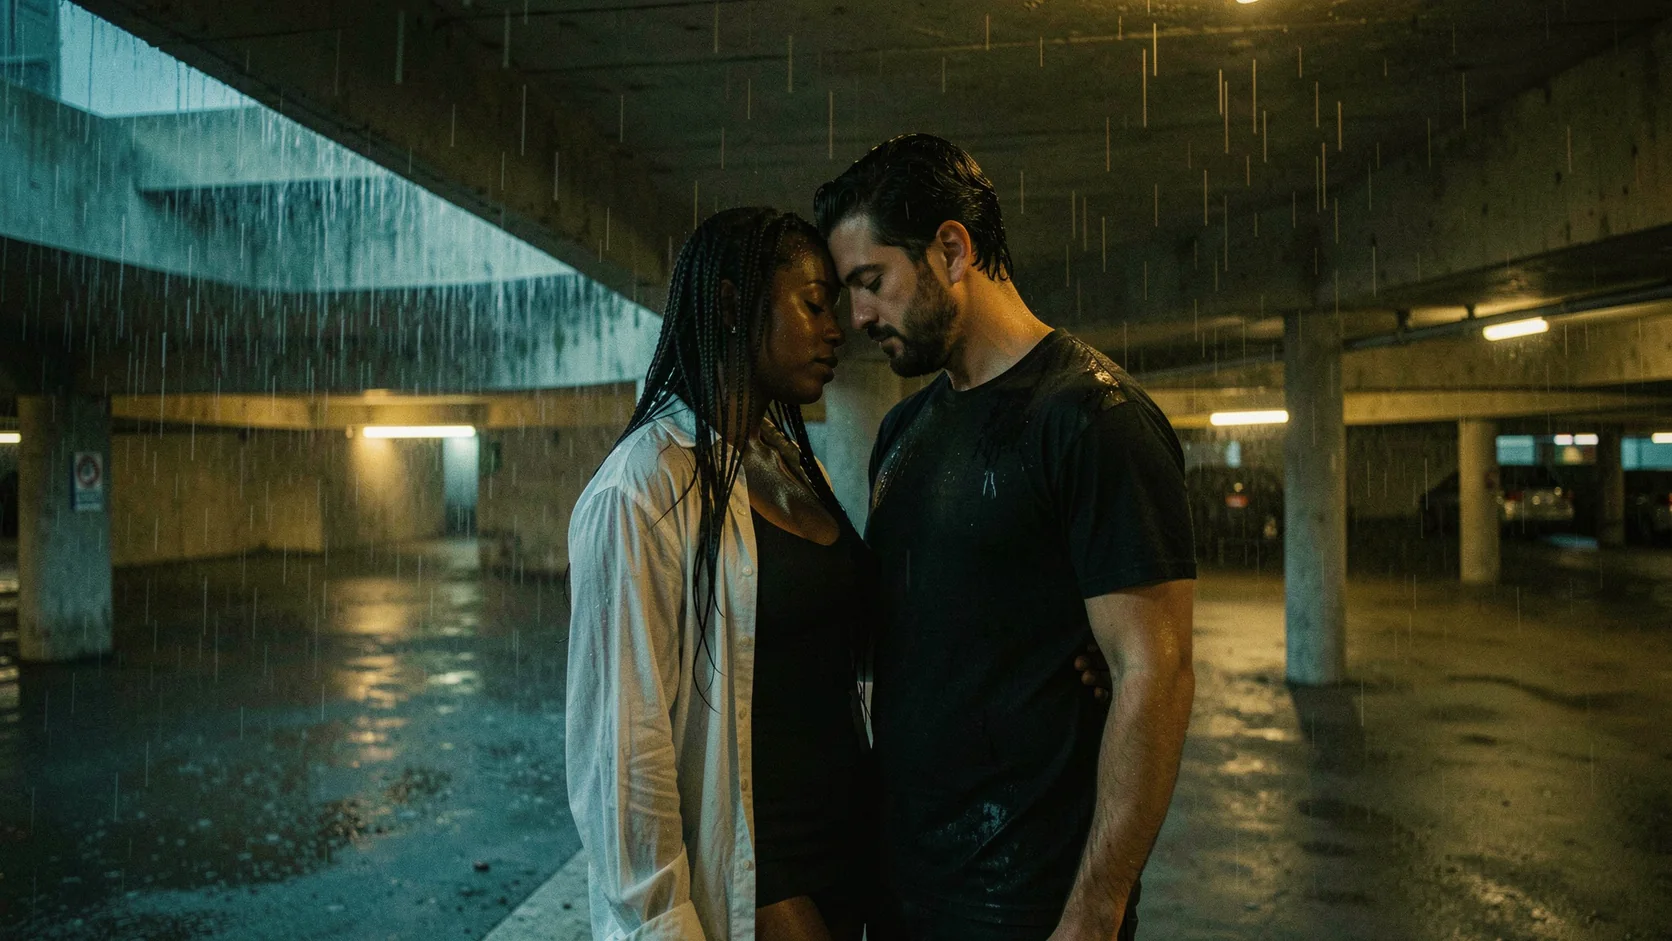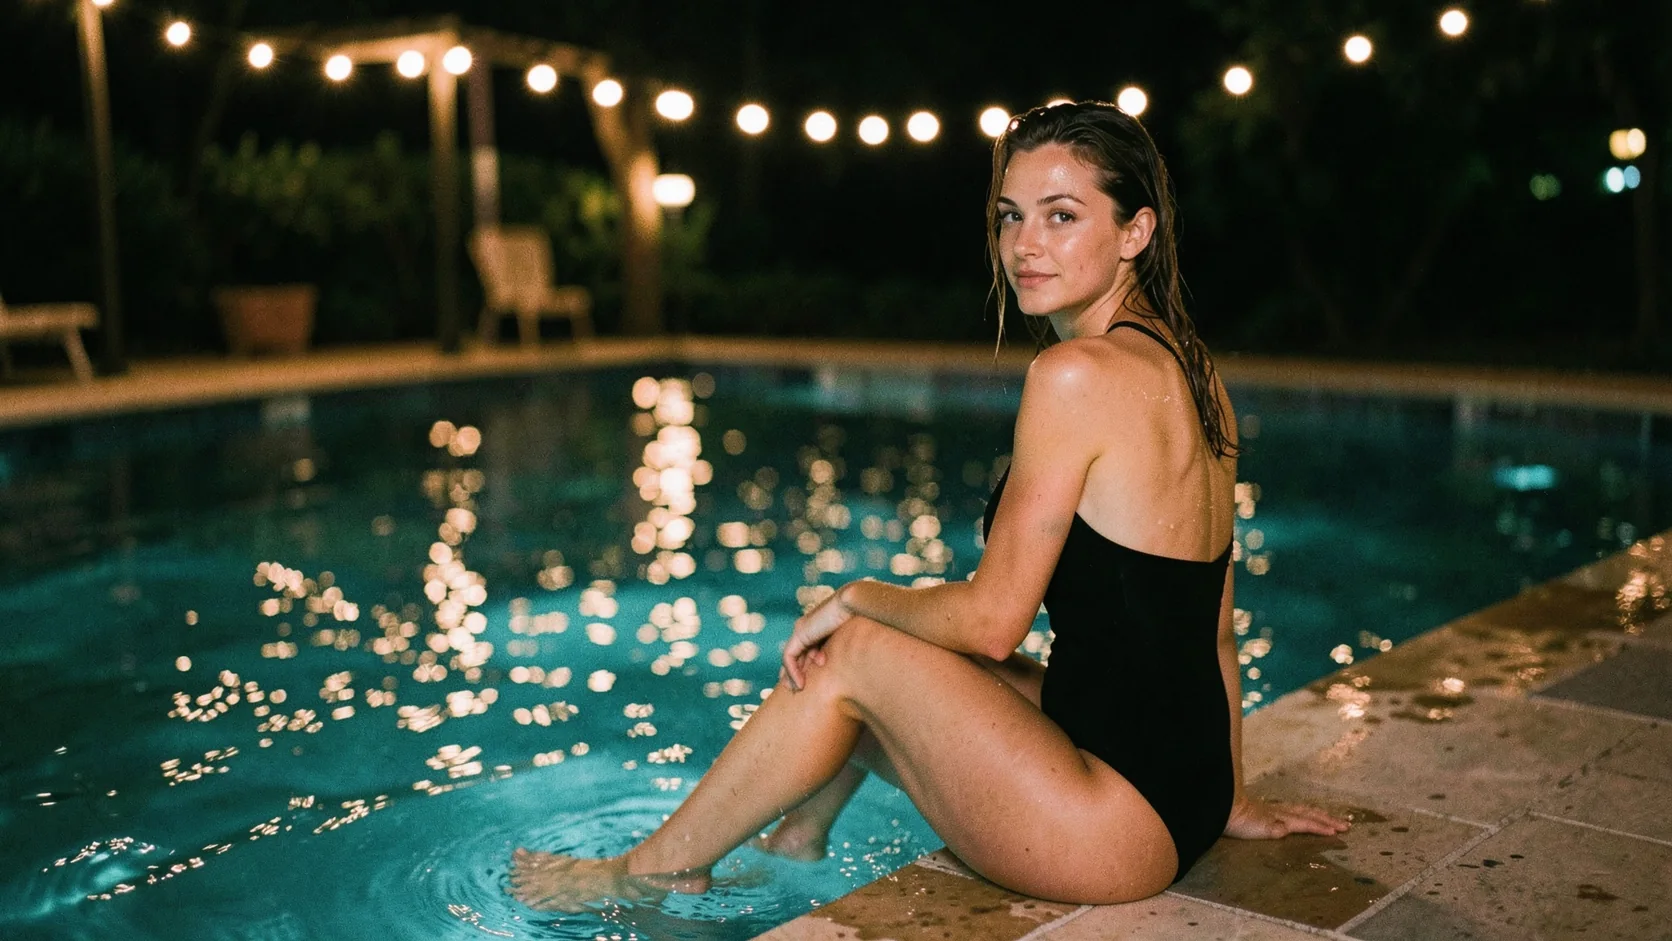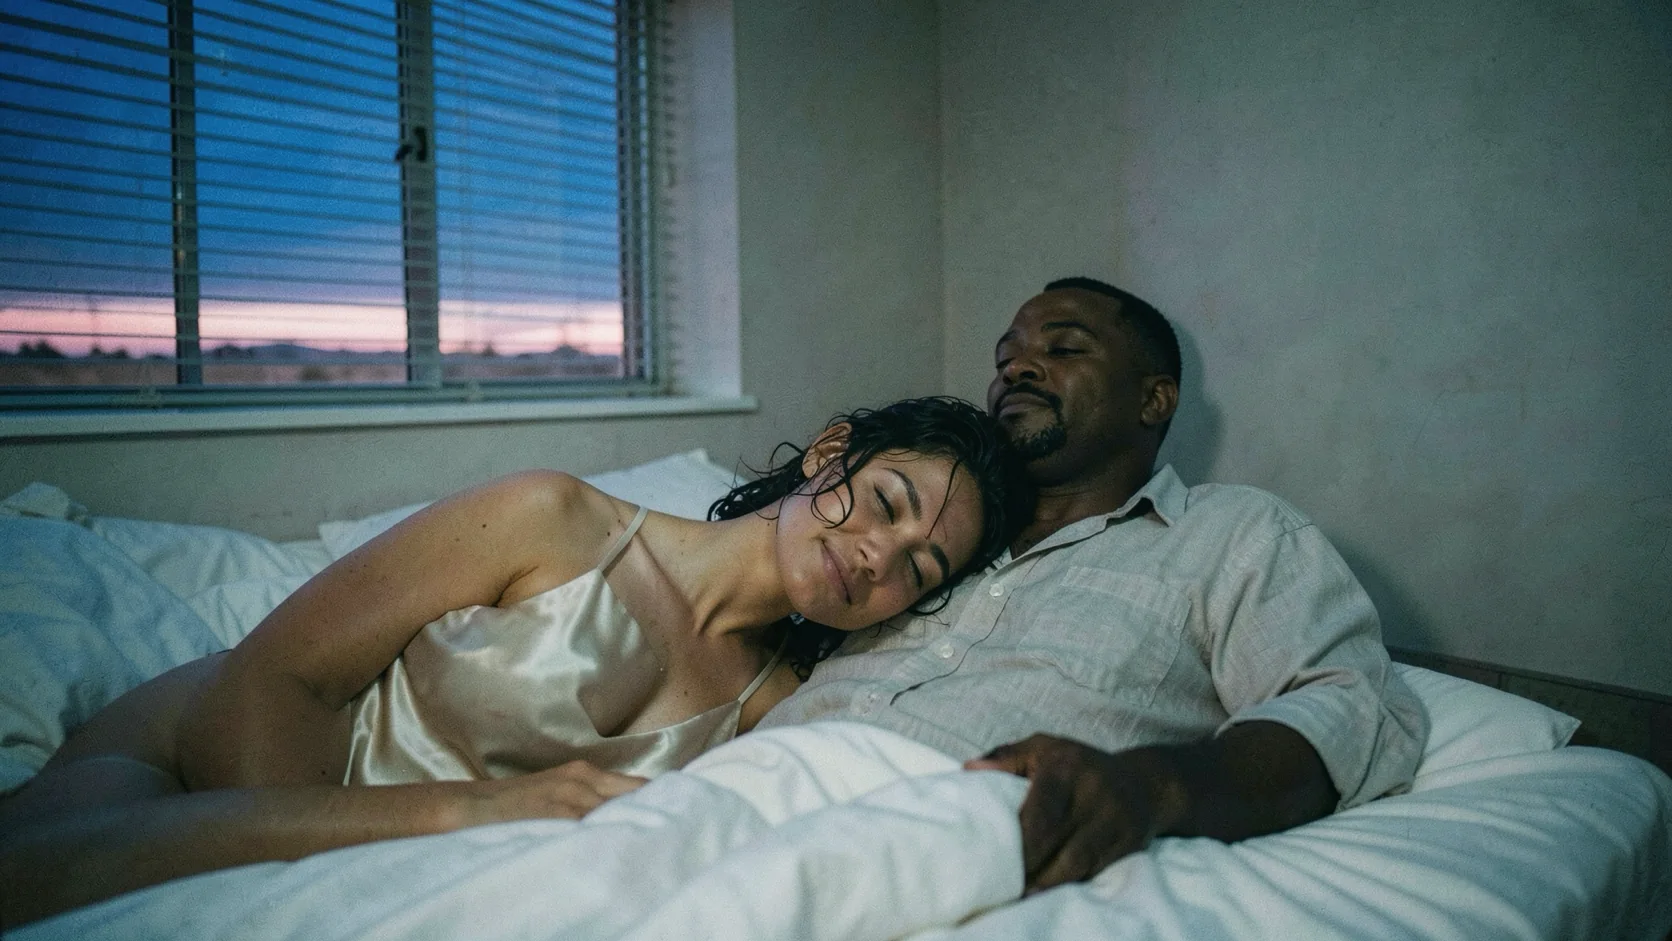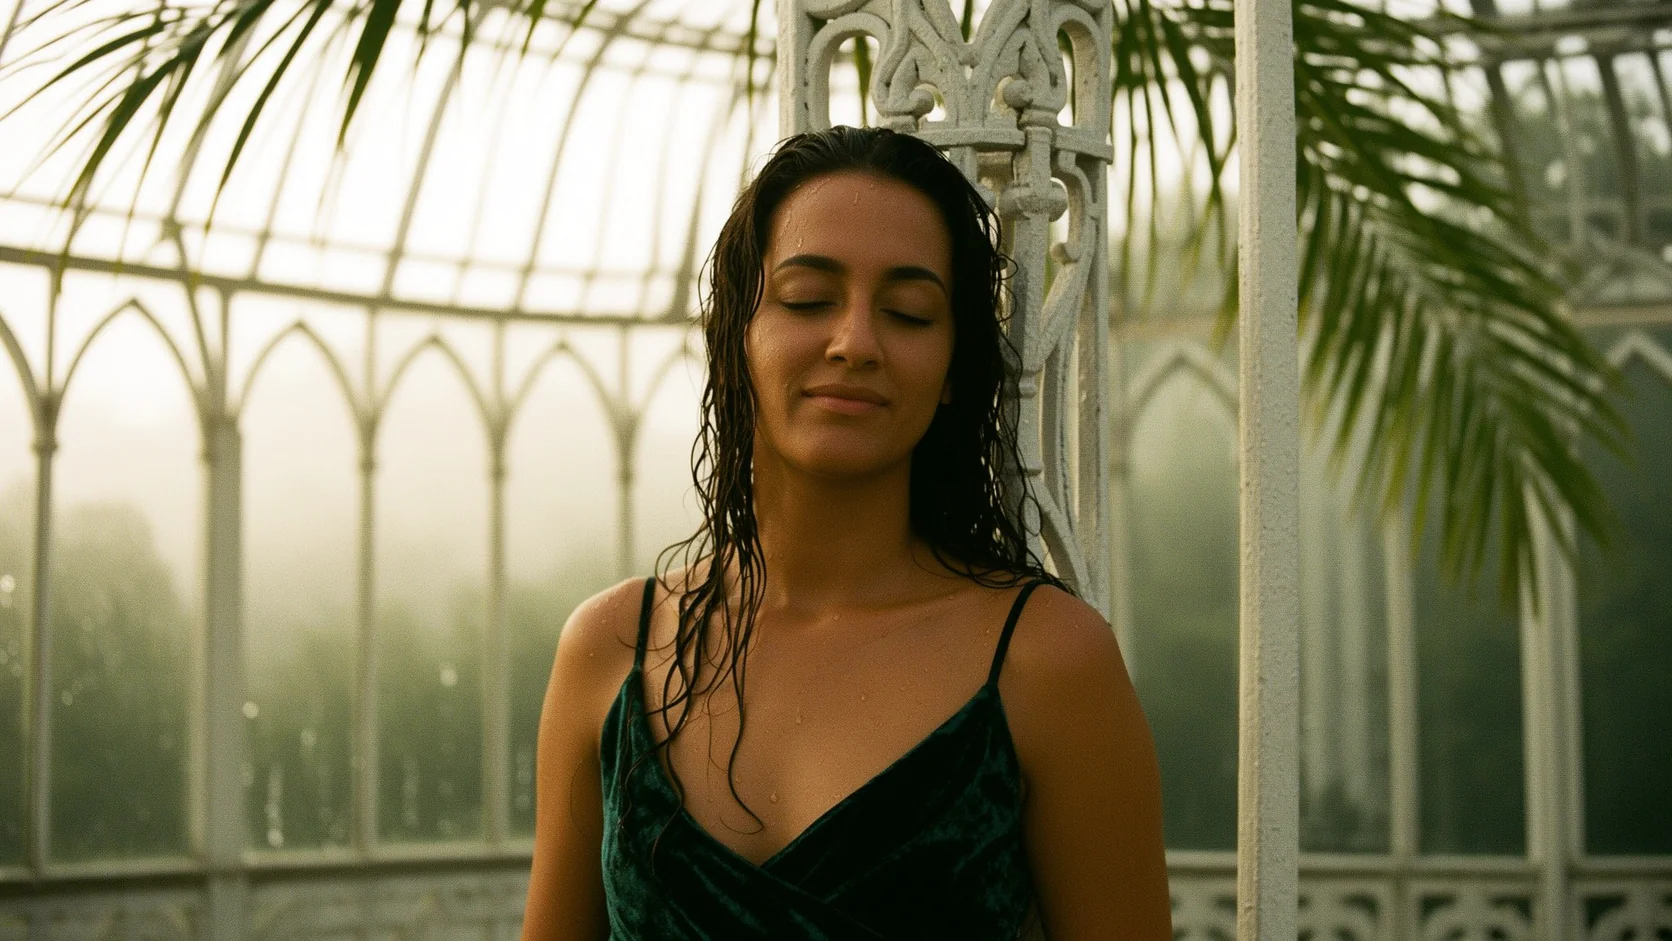
Introducción
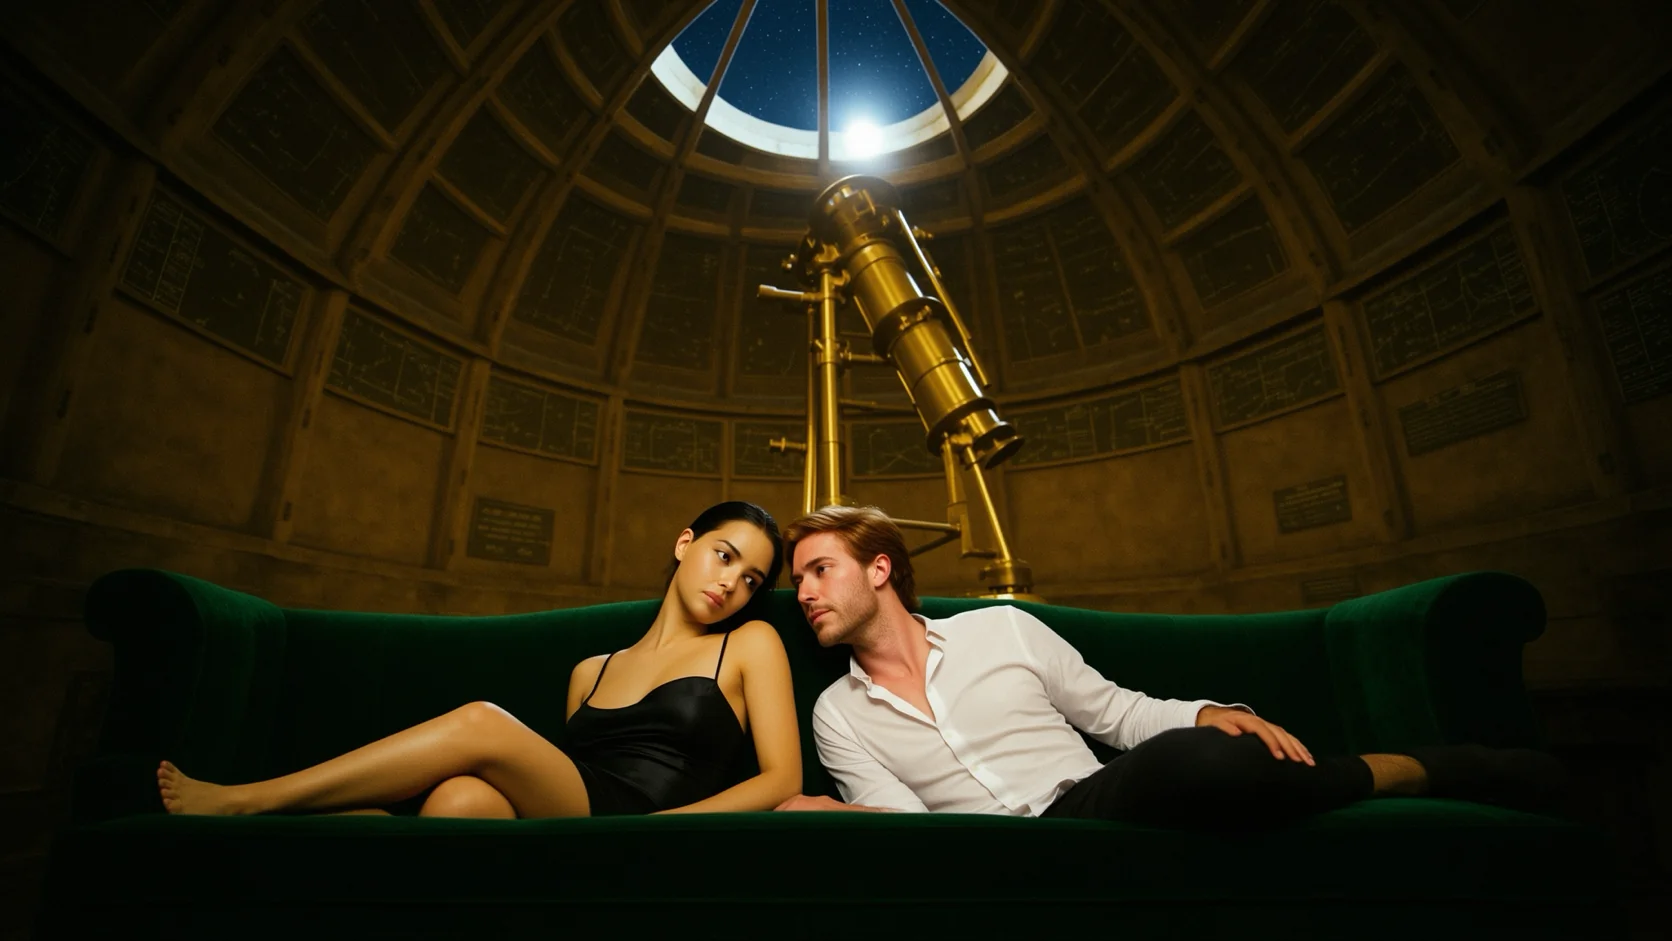
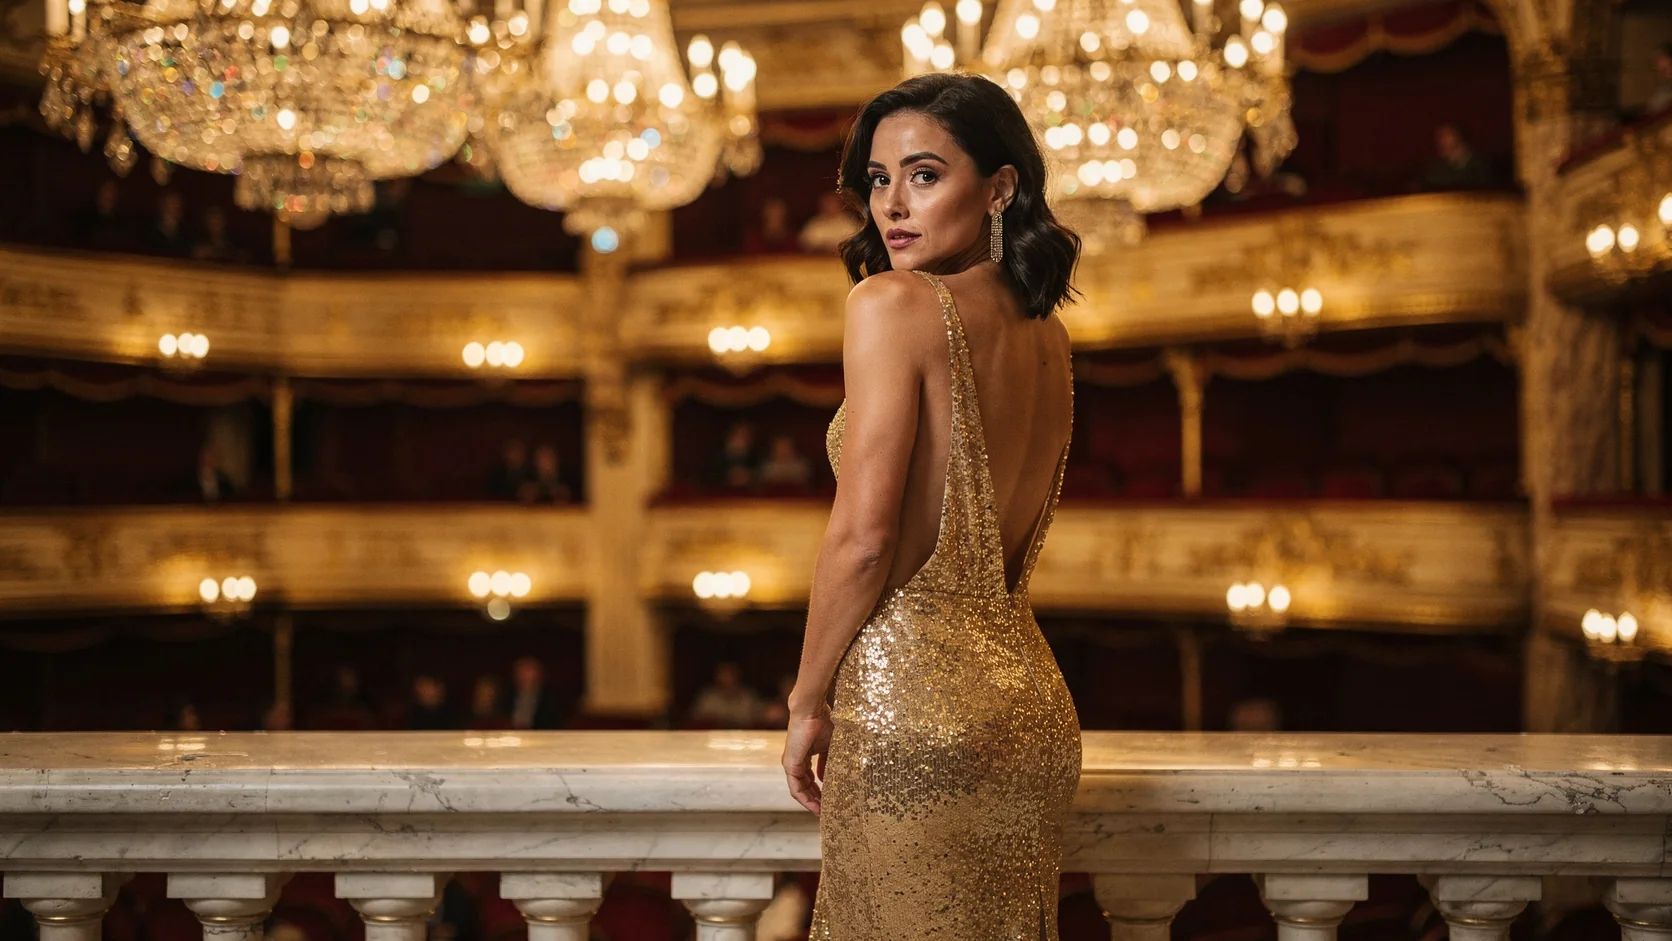
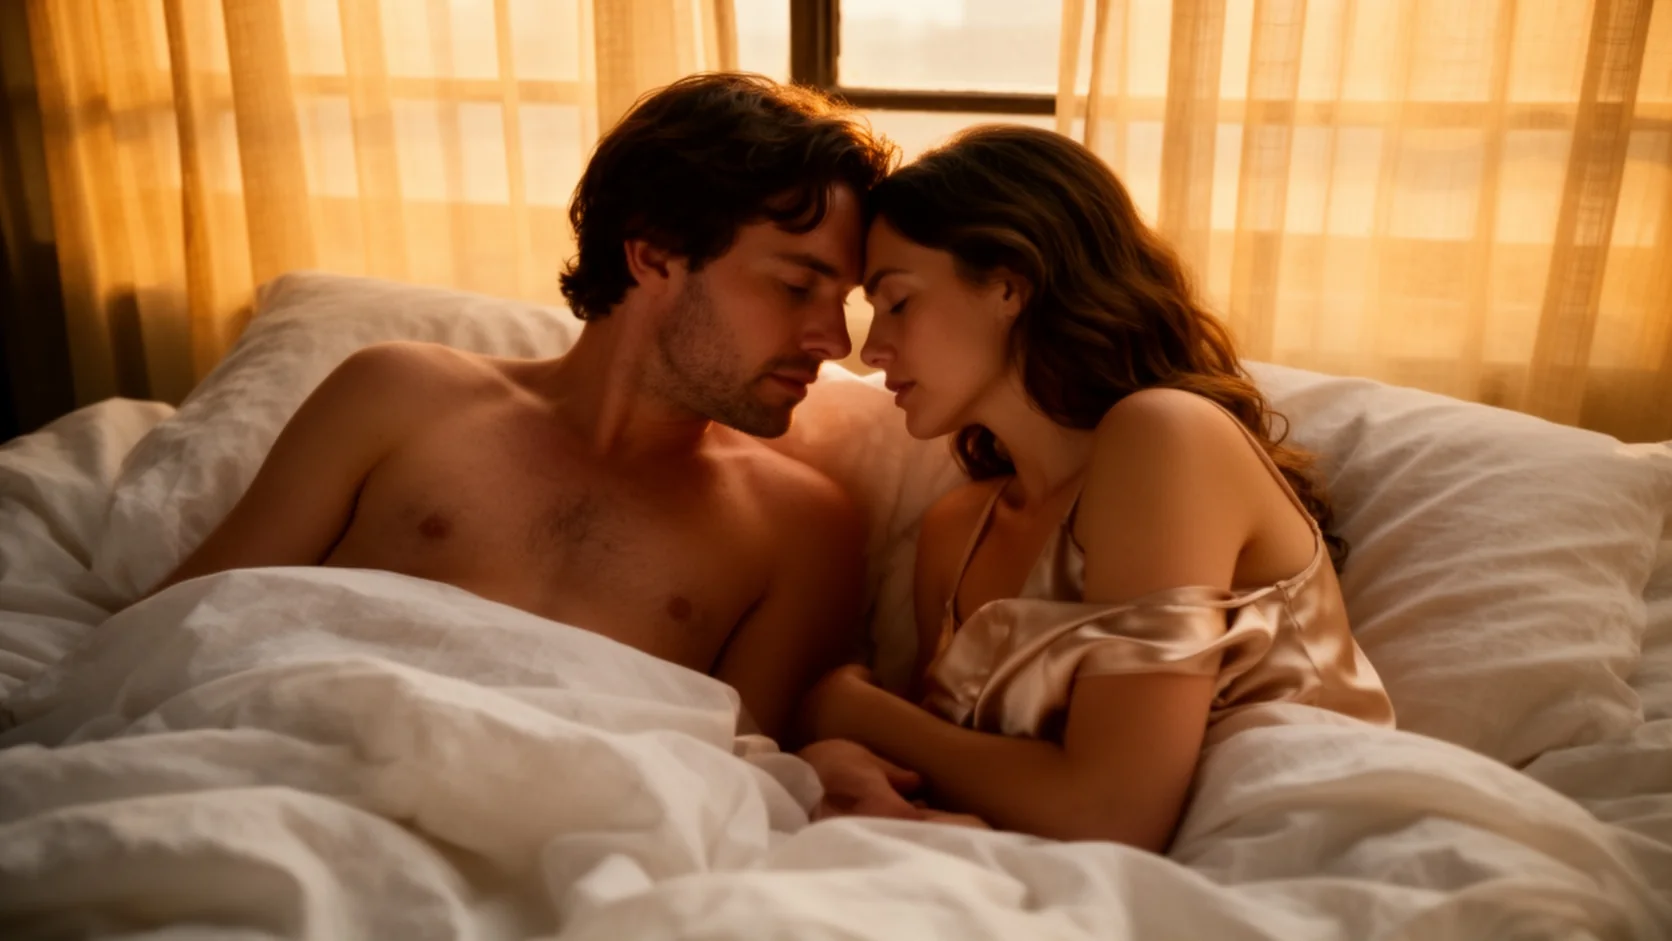
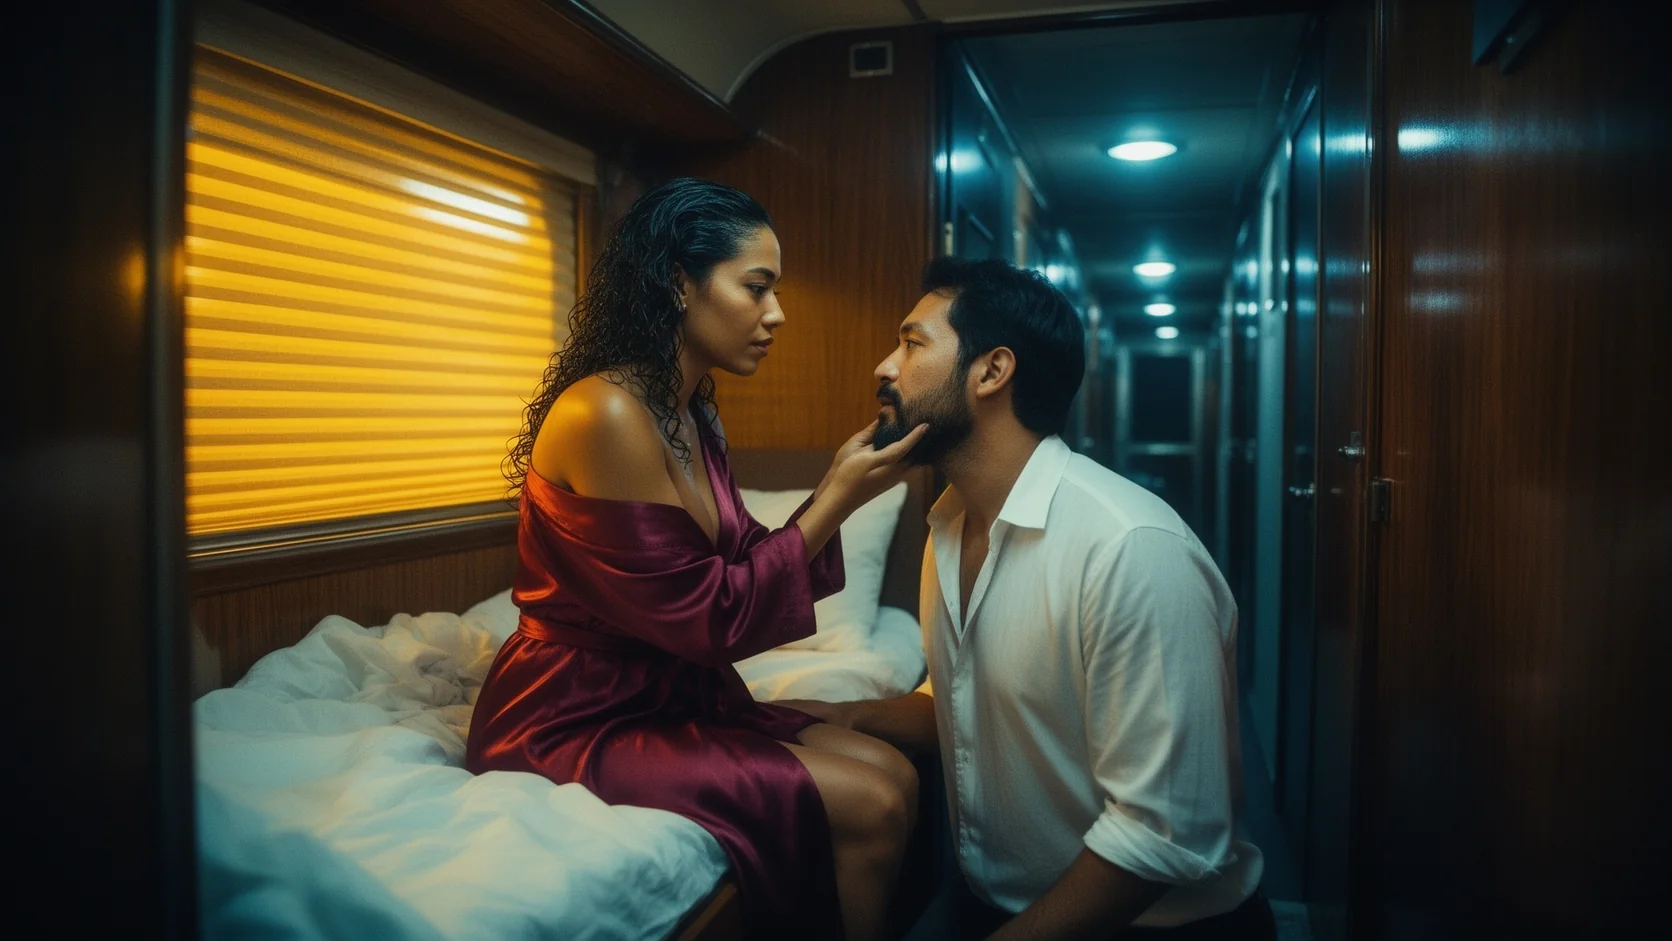
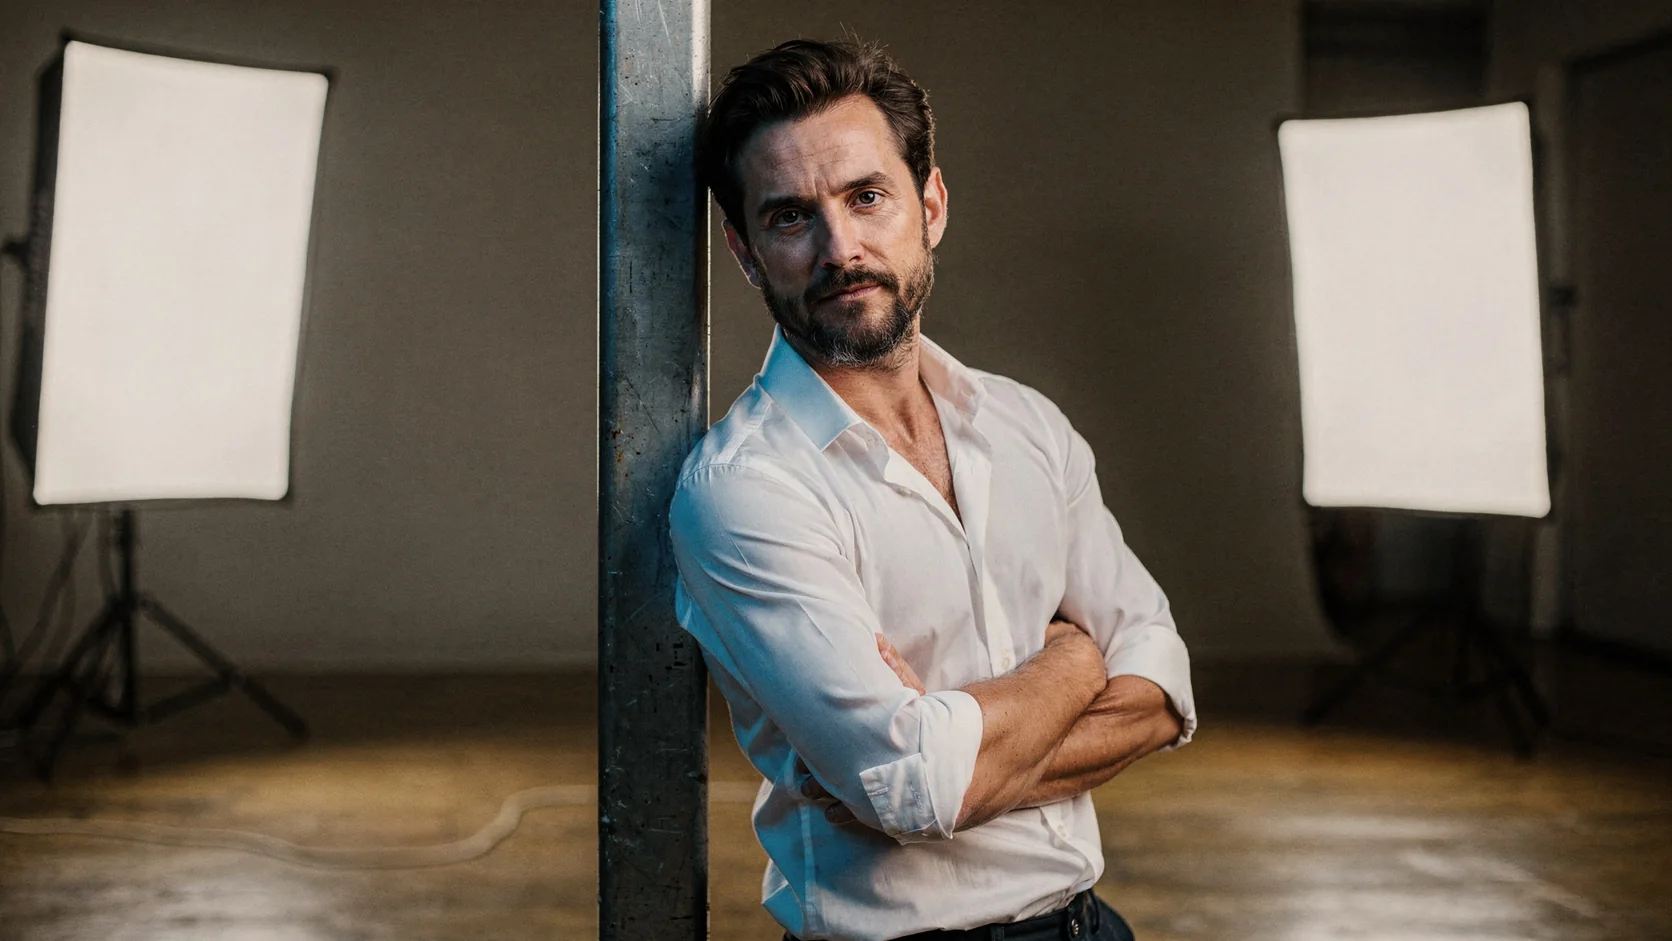
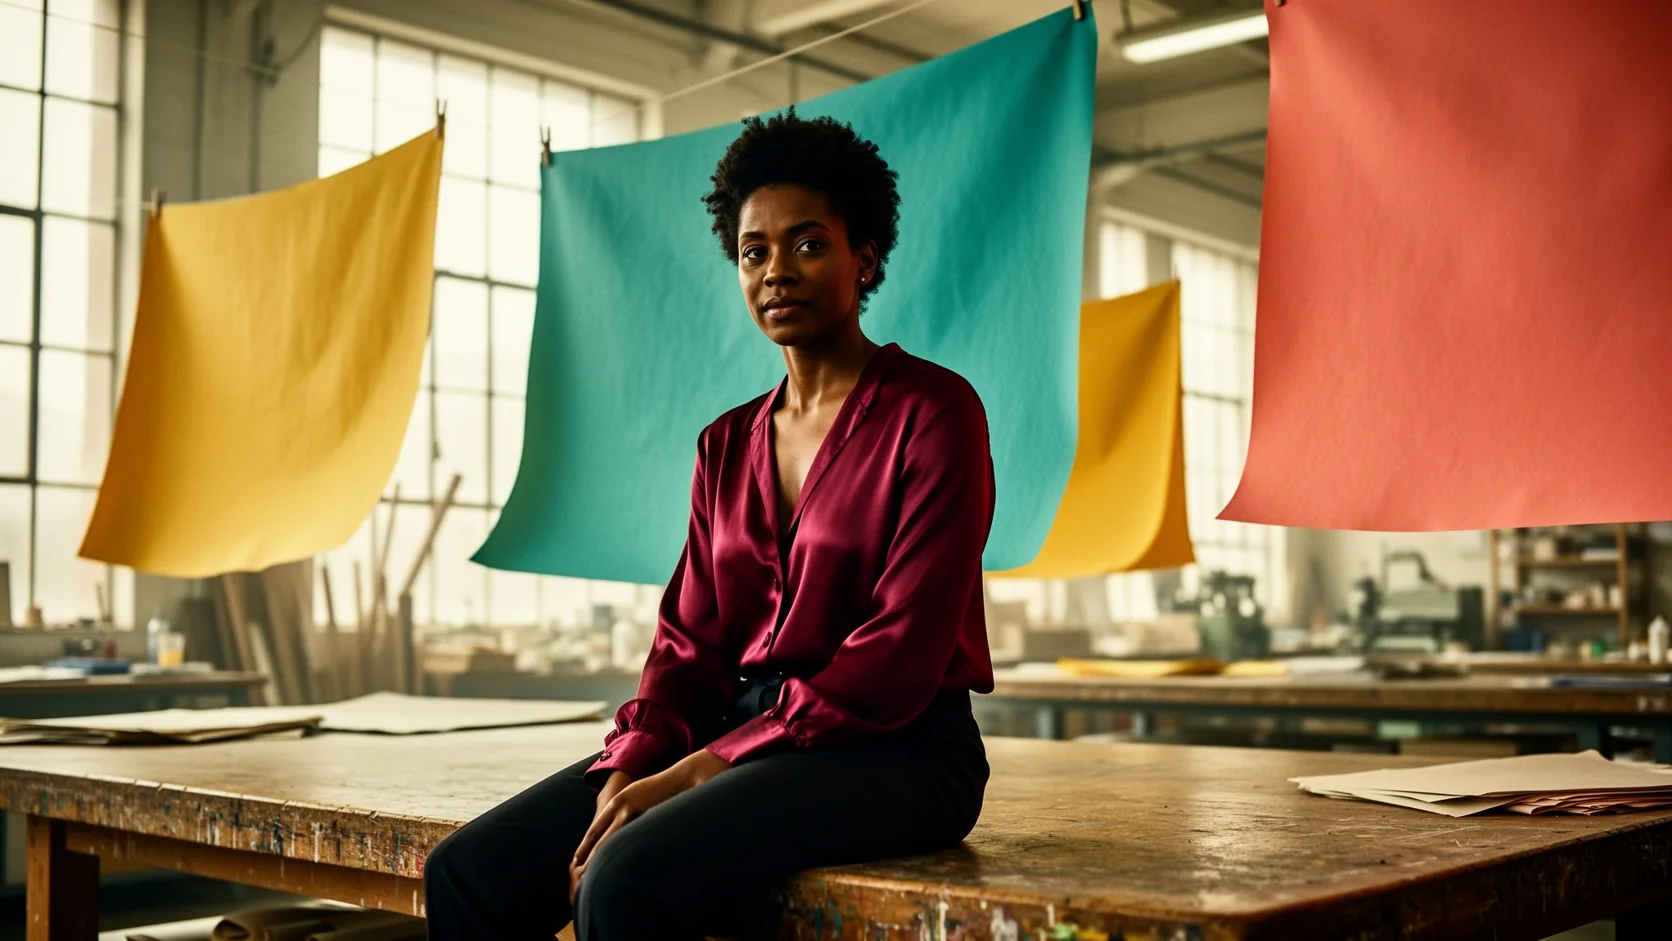
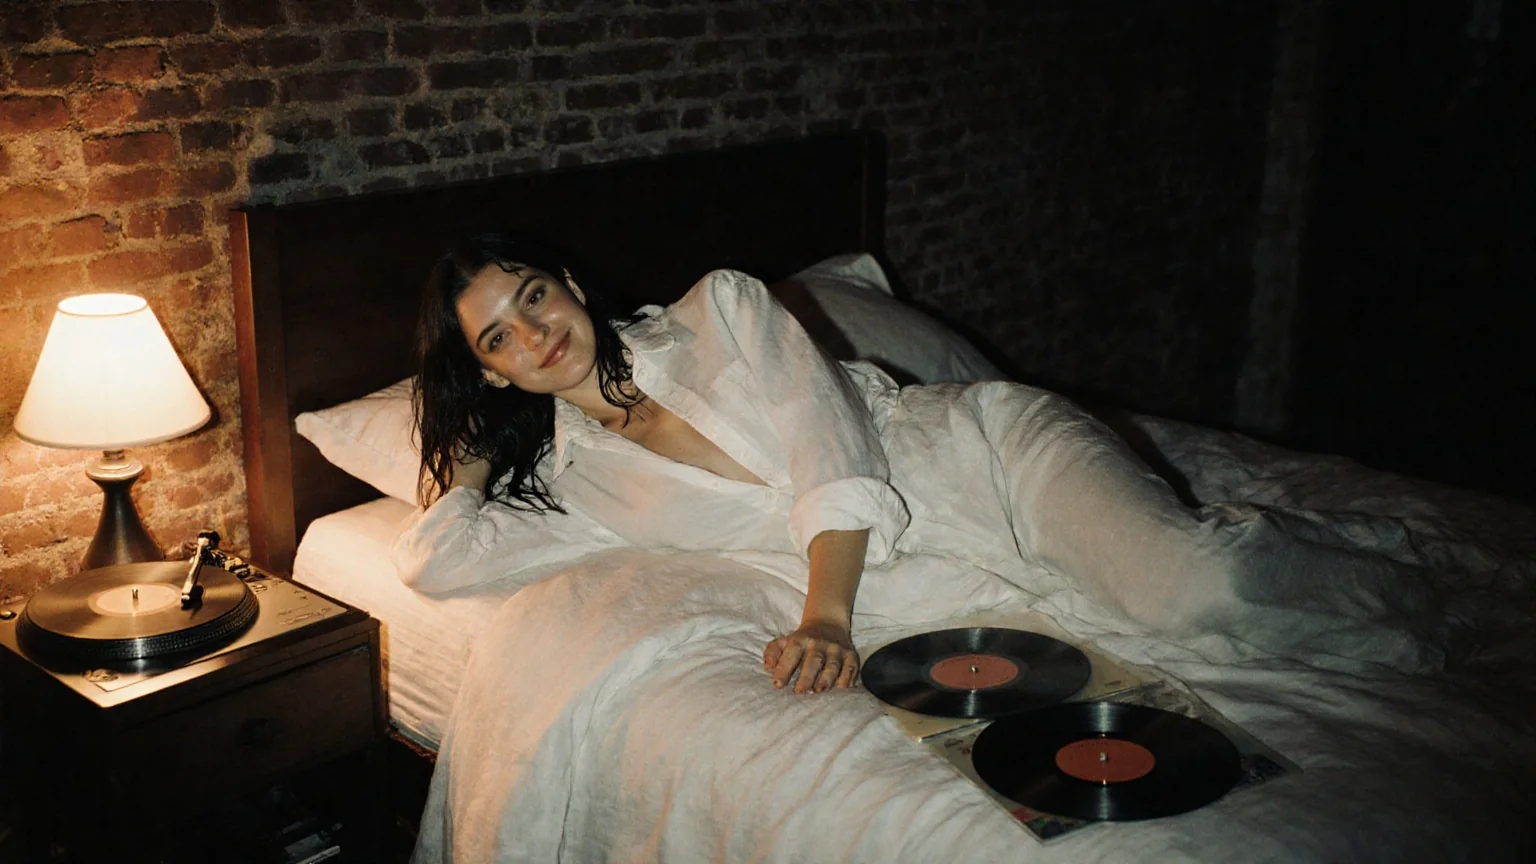
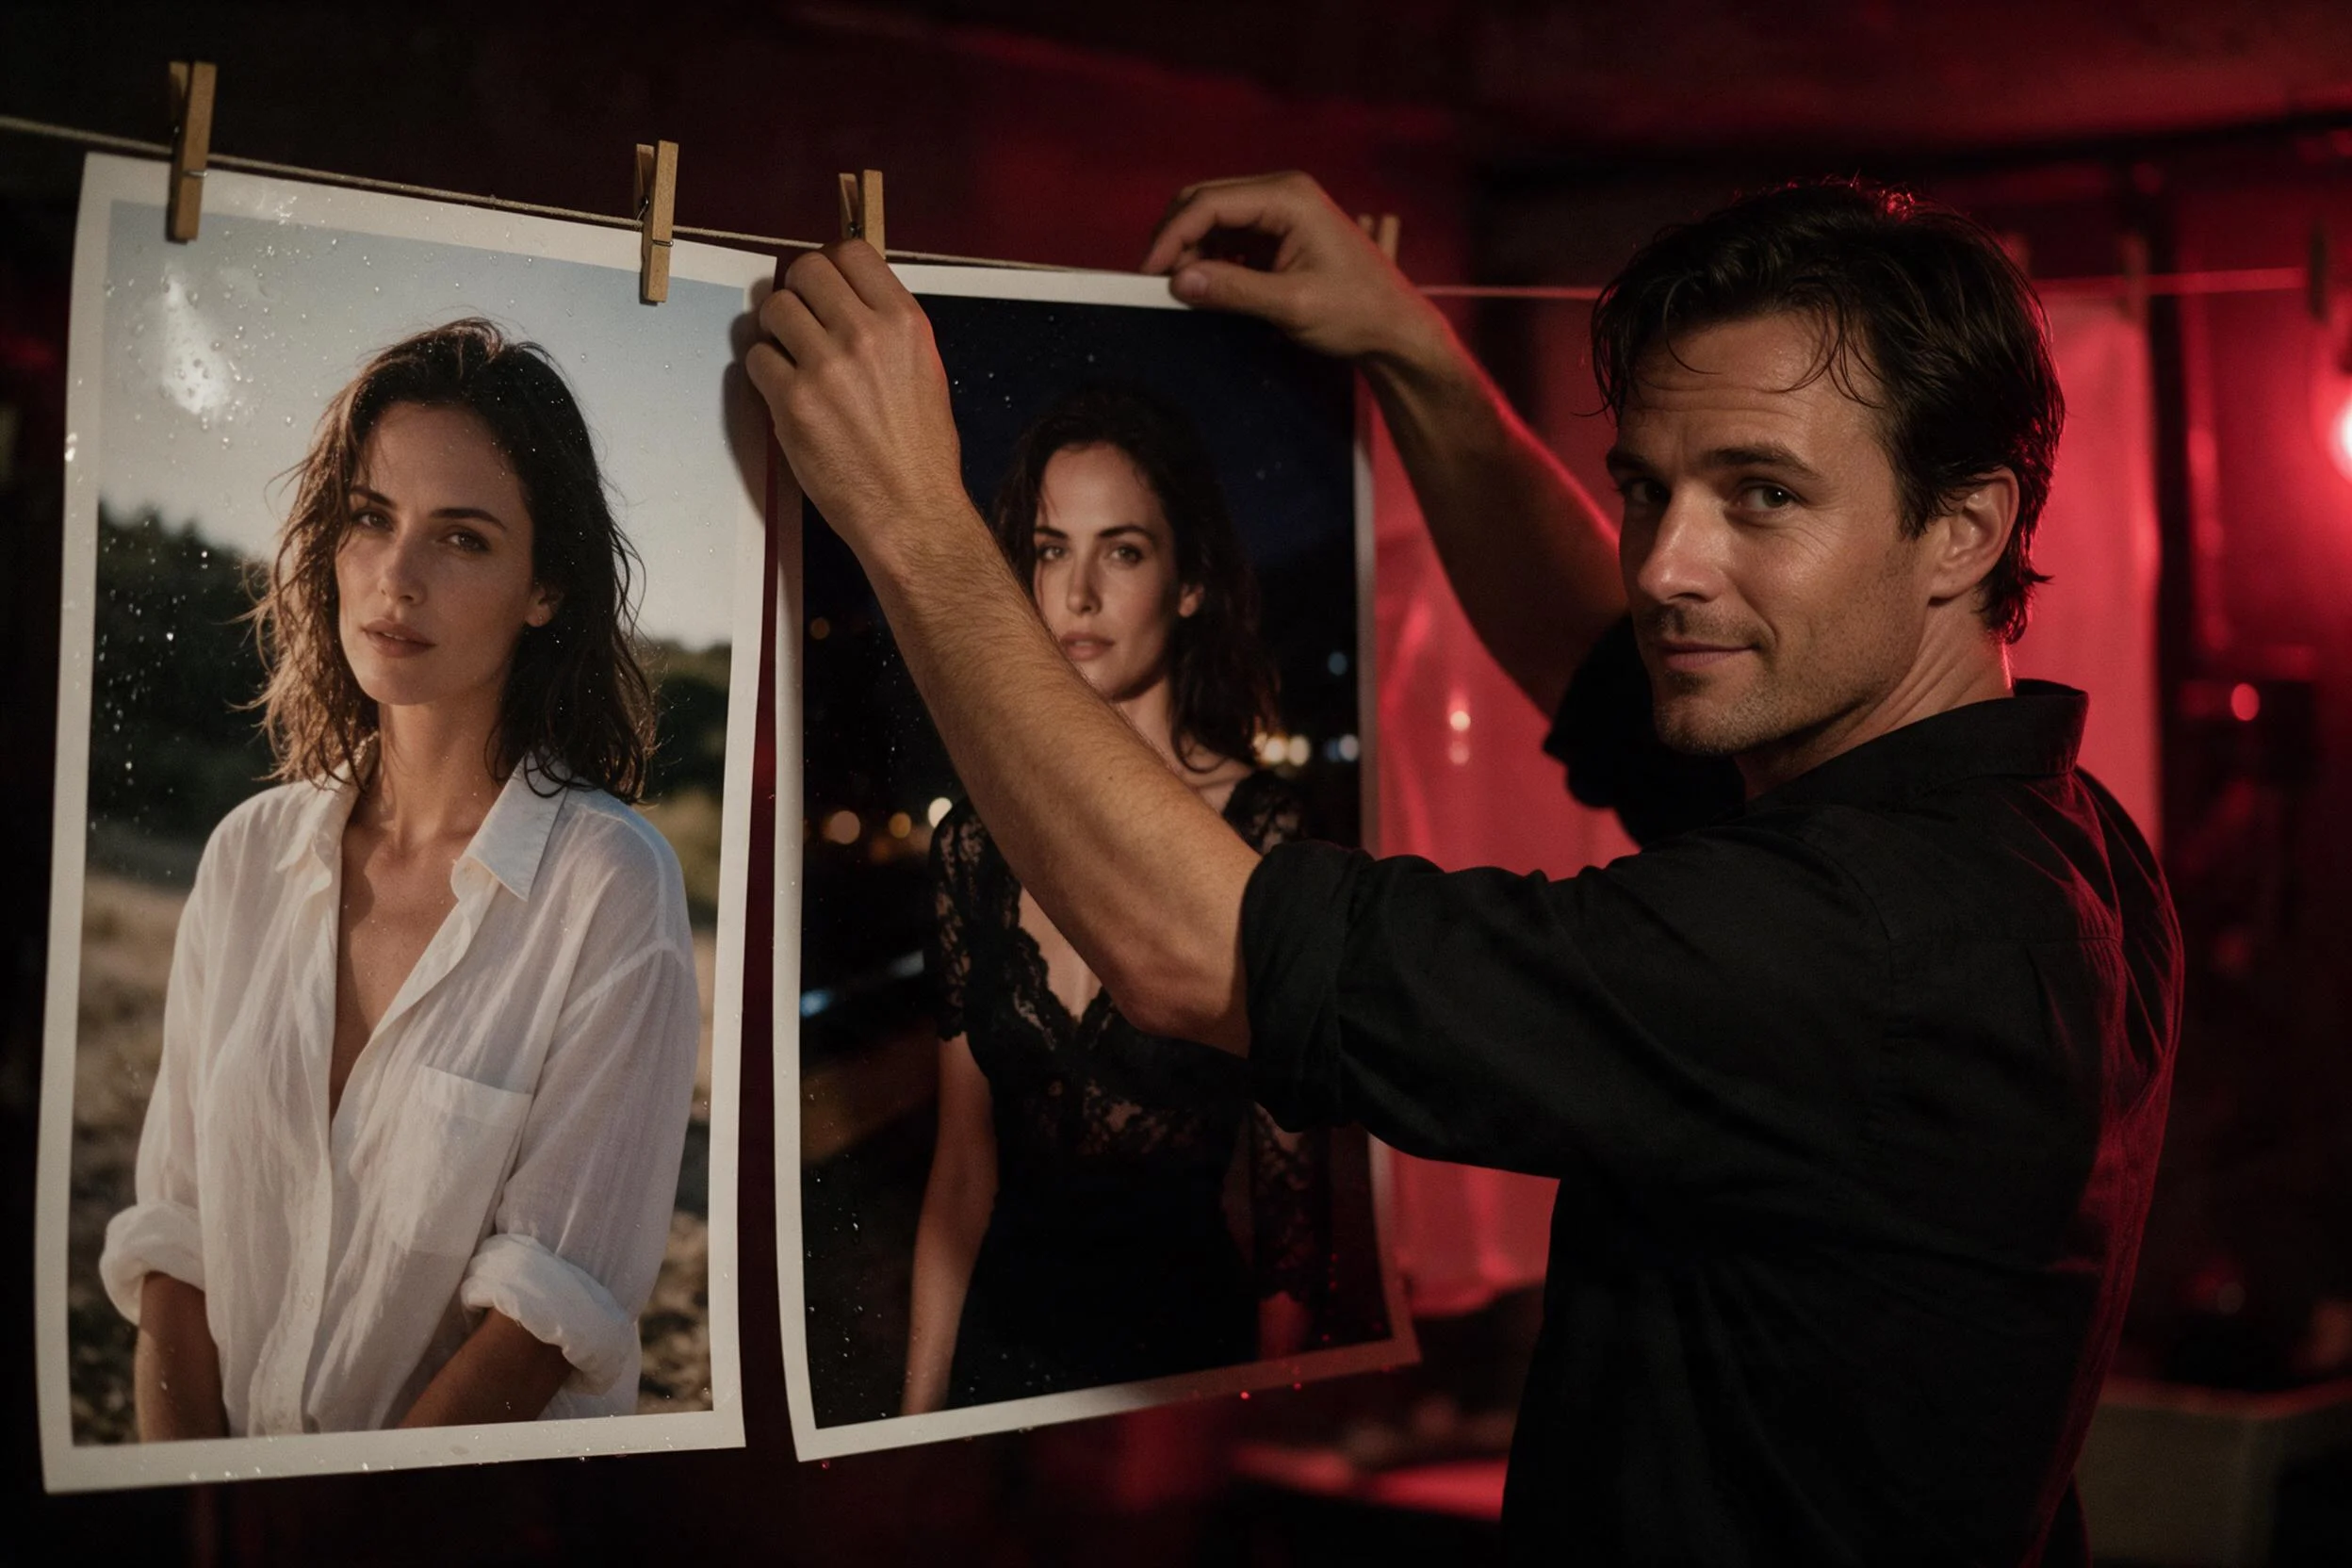
FLUX.1 Kontext [pro] Texto a imagen es el más rápido de los dos modelos Kontext comerciales que Black Forest Labs publicó el 29 de mayo de 2025. Kontext se diseñó como un modelo en contexto: la misma red que dibuja una imagen a partir de una frase puede después tomar esa imagen y cambiarle una sola cosa. Este endpoint es la primera mitad de ese ciclo. Escribes una escena, recibes una foto de alrededor de un megapíxel y envías la que te guste al endpoint de edición cuando quieras otro atuendo, otra luz o un letrero corregido.
Qué modo usar según lo que tengas
| Lo que tienes | Modo |
|---|---|
| solo una escena escrita | FLUX.1 Kontext [pro] Texto a imagen |
| una foto que quieres cambiar | FLUX.1 Kontext [pro] Edición |
Funciones y aspectos destacados
El texto aparece donde lo pones
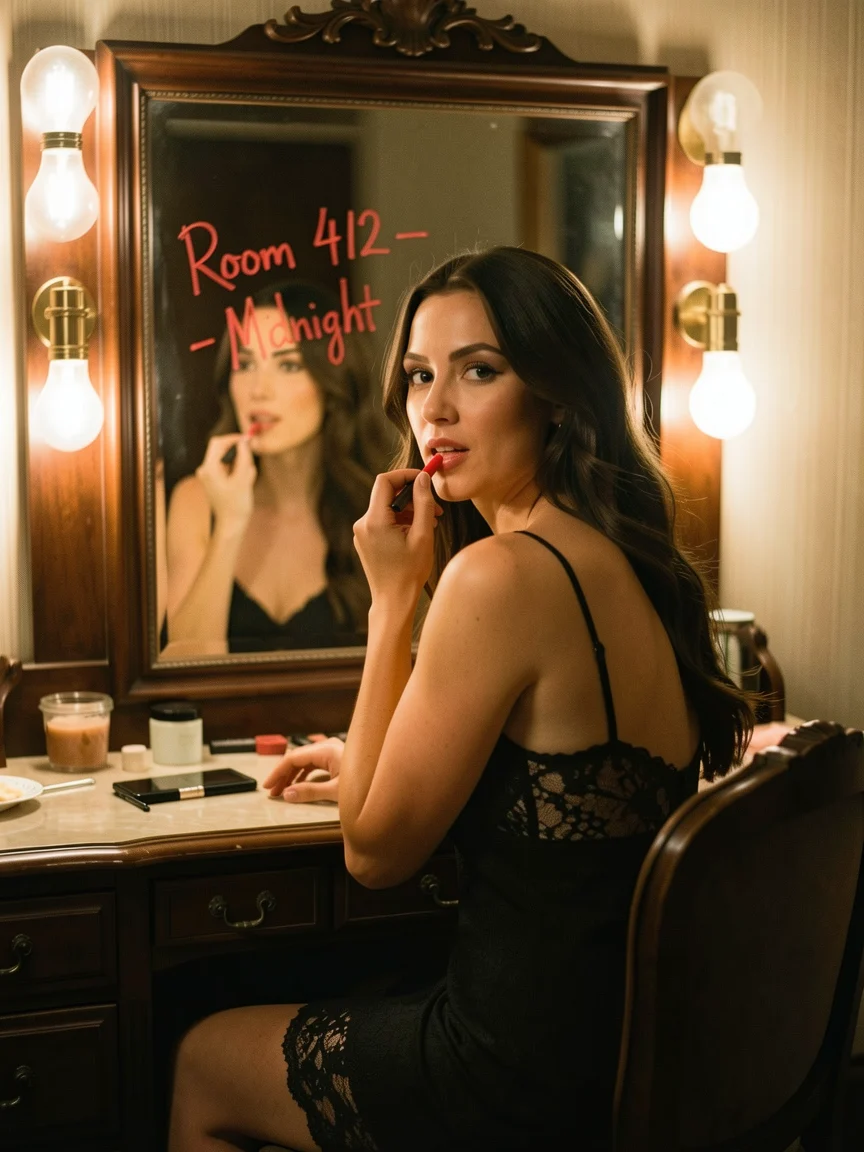
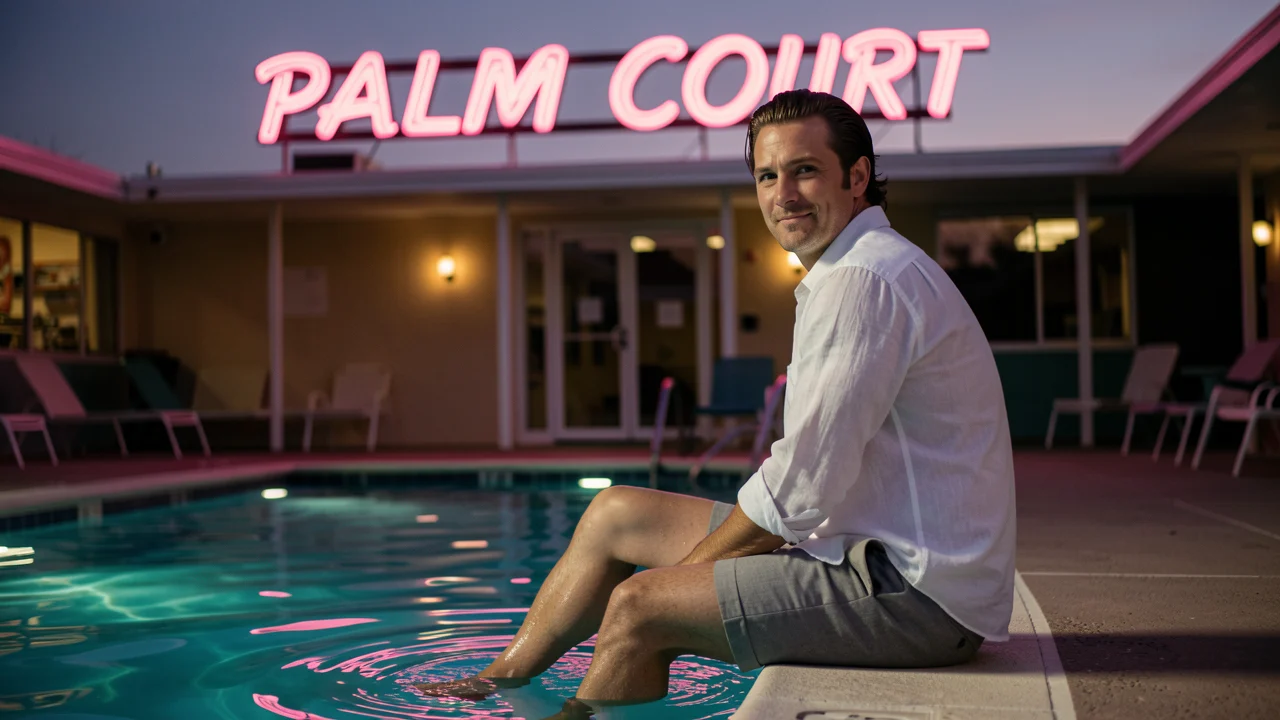
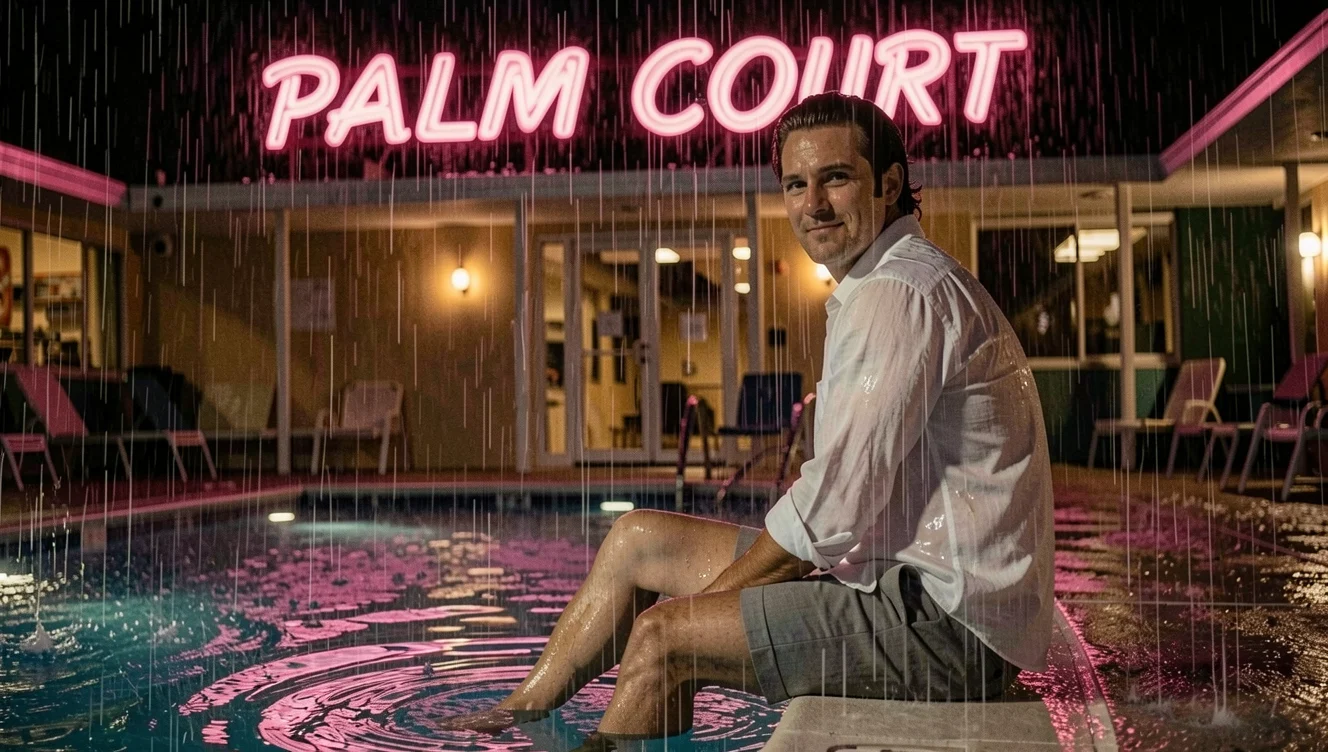
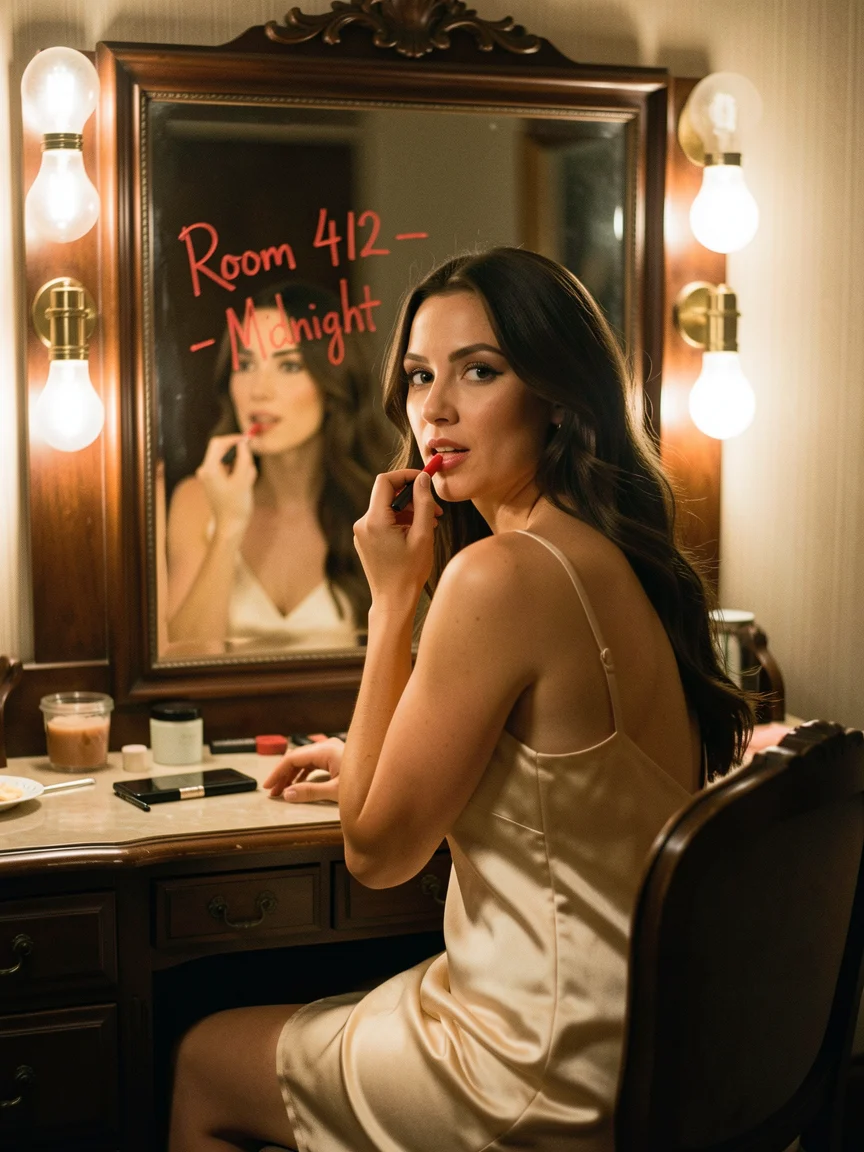
Kontext [pro] lee las palabras entre comillas como letras que debe dibujar. En nuestra prueba del tocador pedimos una nota de labial en el espejo y obtuvimos "Room 412 - Midnight" con un trazo rojo a mano sobre el cristal; en la prueba del motel, "PALM COURT" salió como un letrero de neón rosa en cursiva. Ambos con la ortografía pedida.
Seis formatos, cerca de un megapíxel cada uno
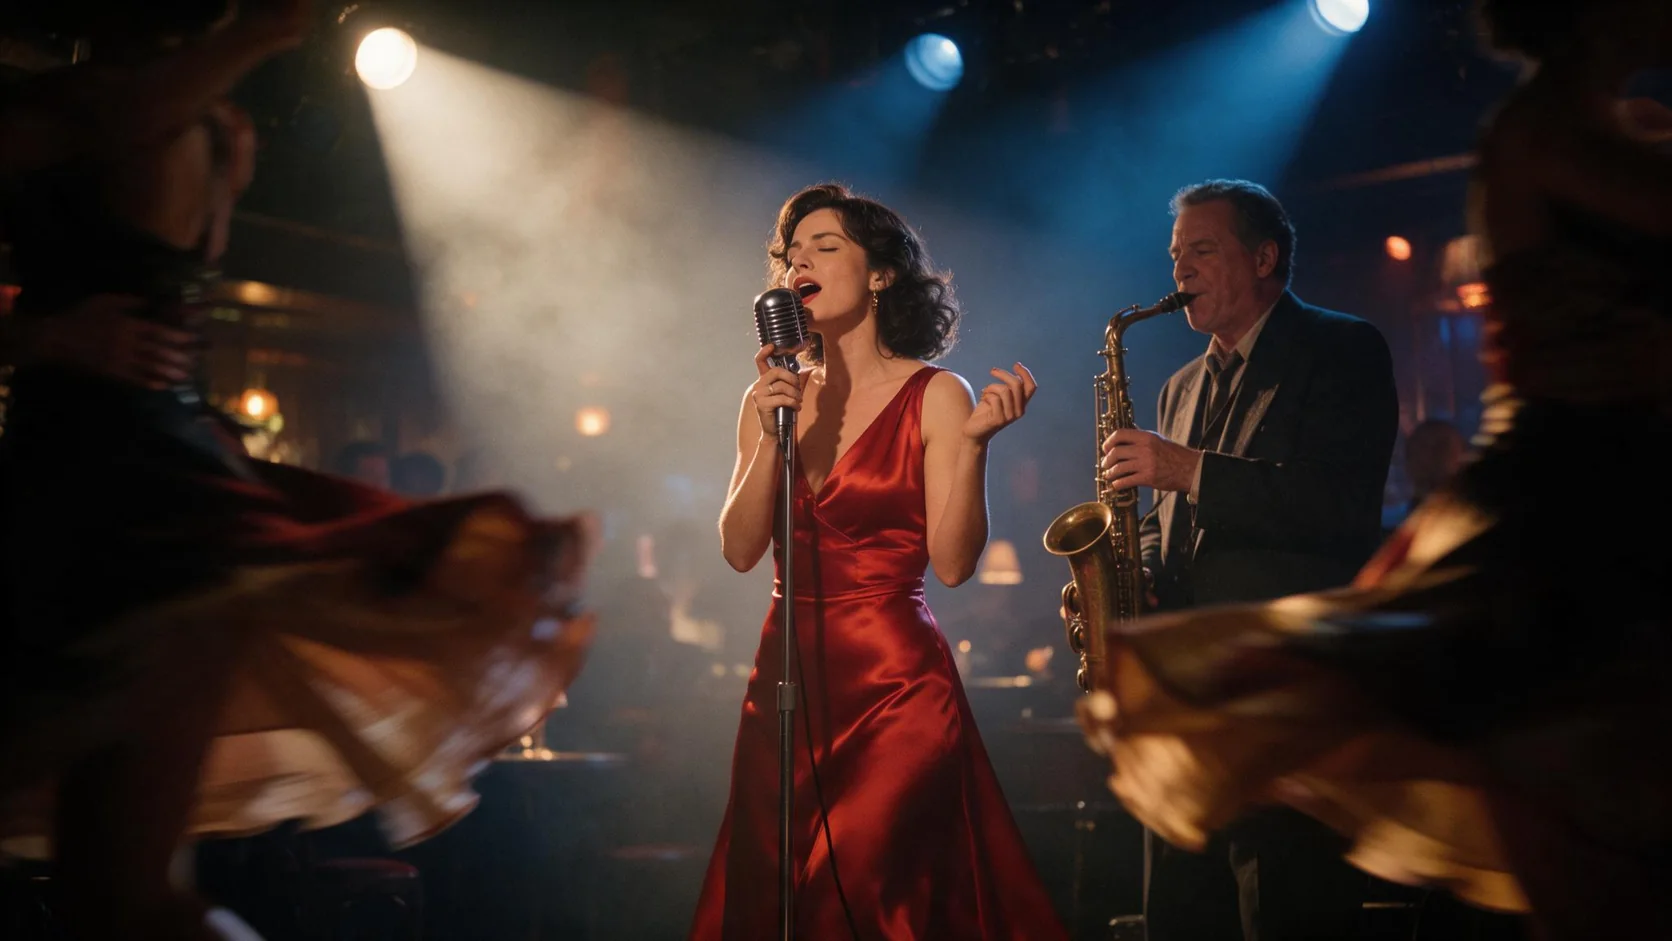
Cuadrado, dos horizontales, dos verticales y un 21:9 ultra ancho. Cada uno vuelve con alrededor de un megapíxel: 1280x720 en 16:9, 864x1152 en 3:4 y 1520x656 en 21:9 en nuestras pruebas.
Pensado para editarse después
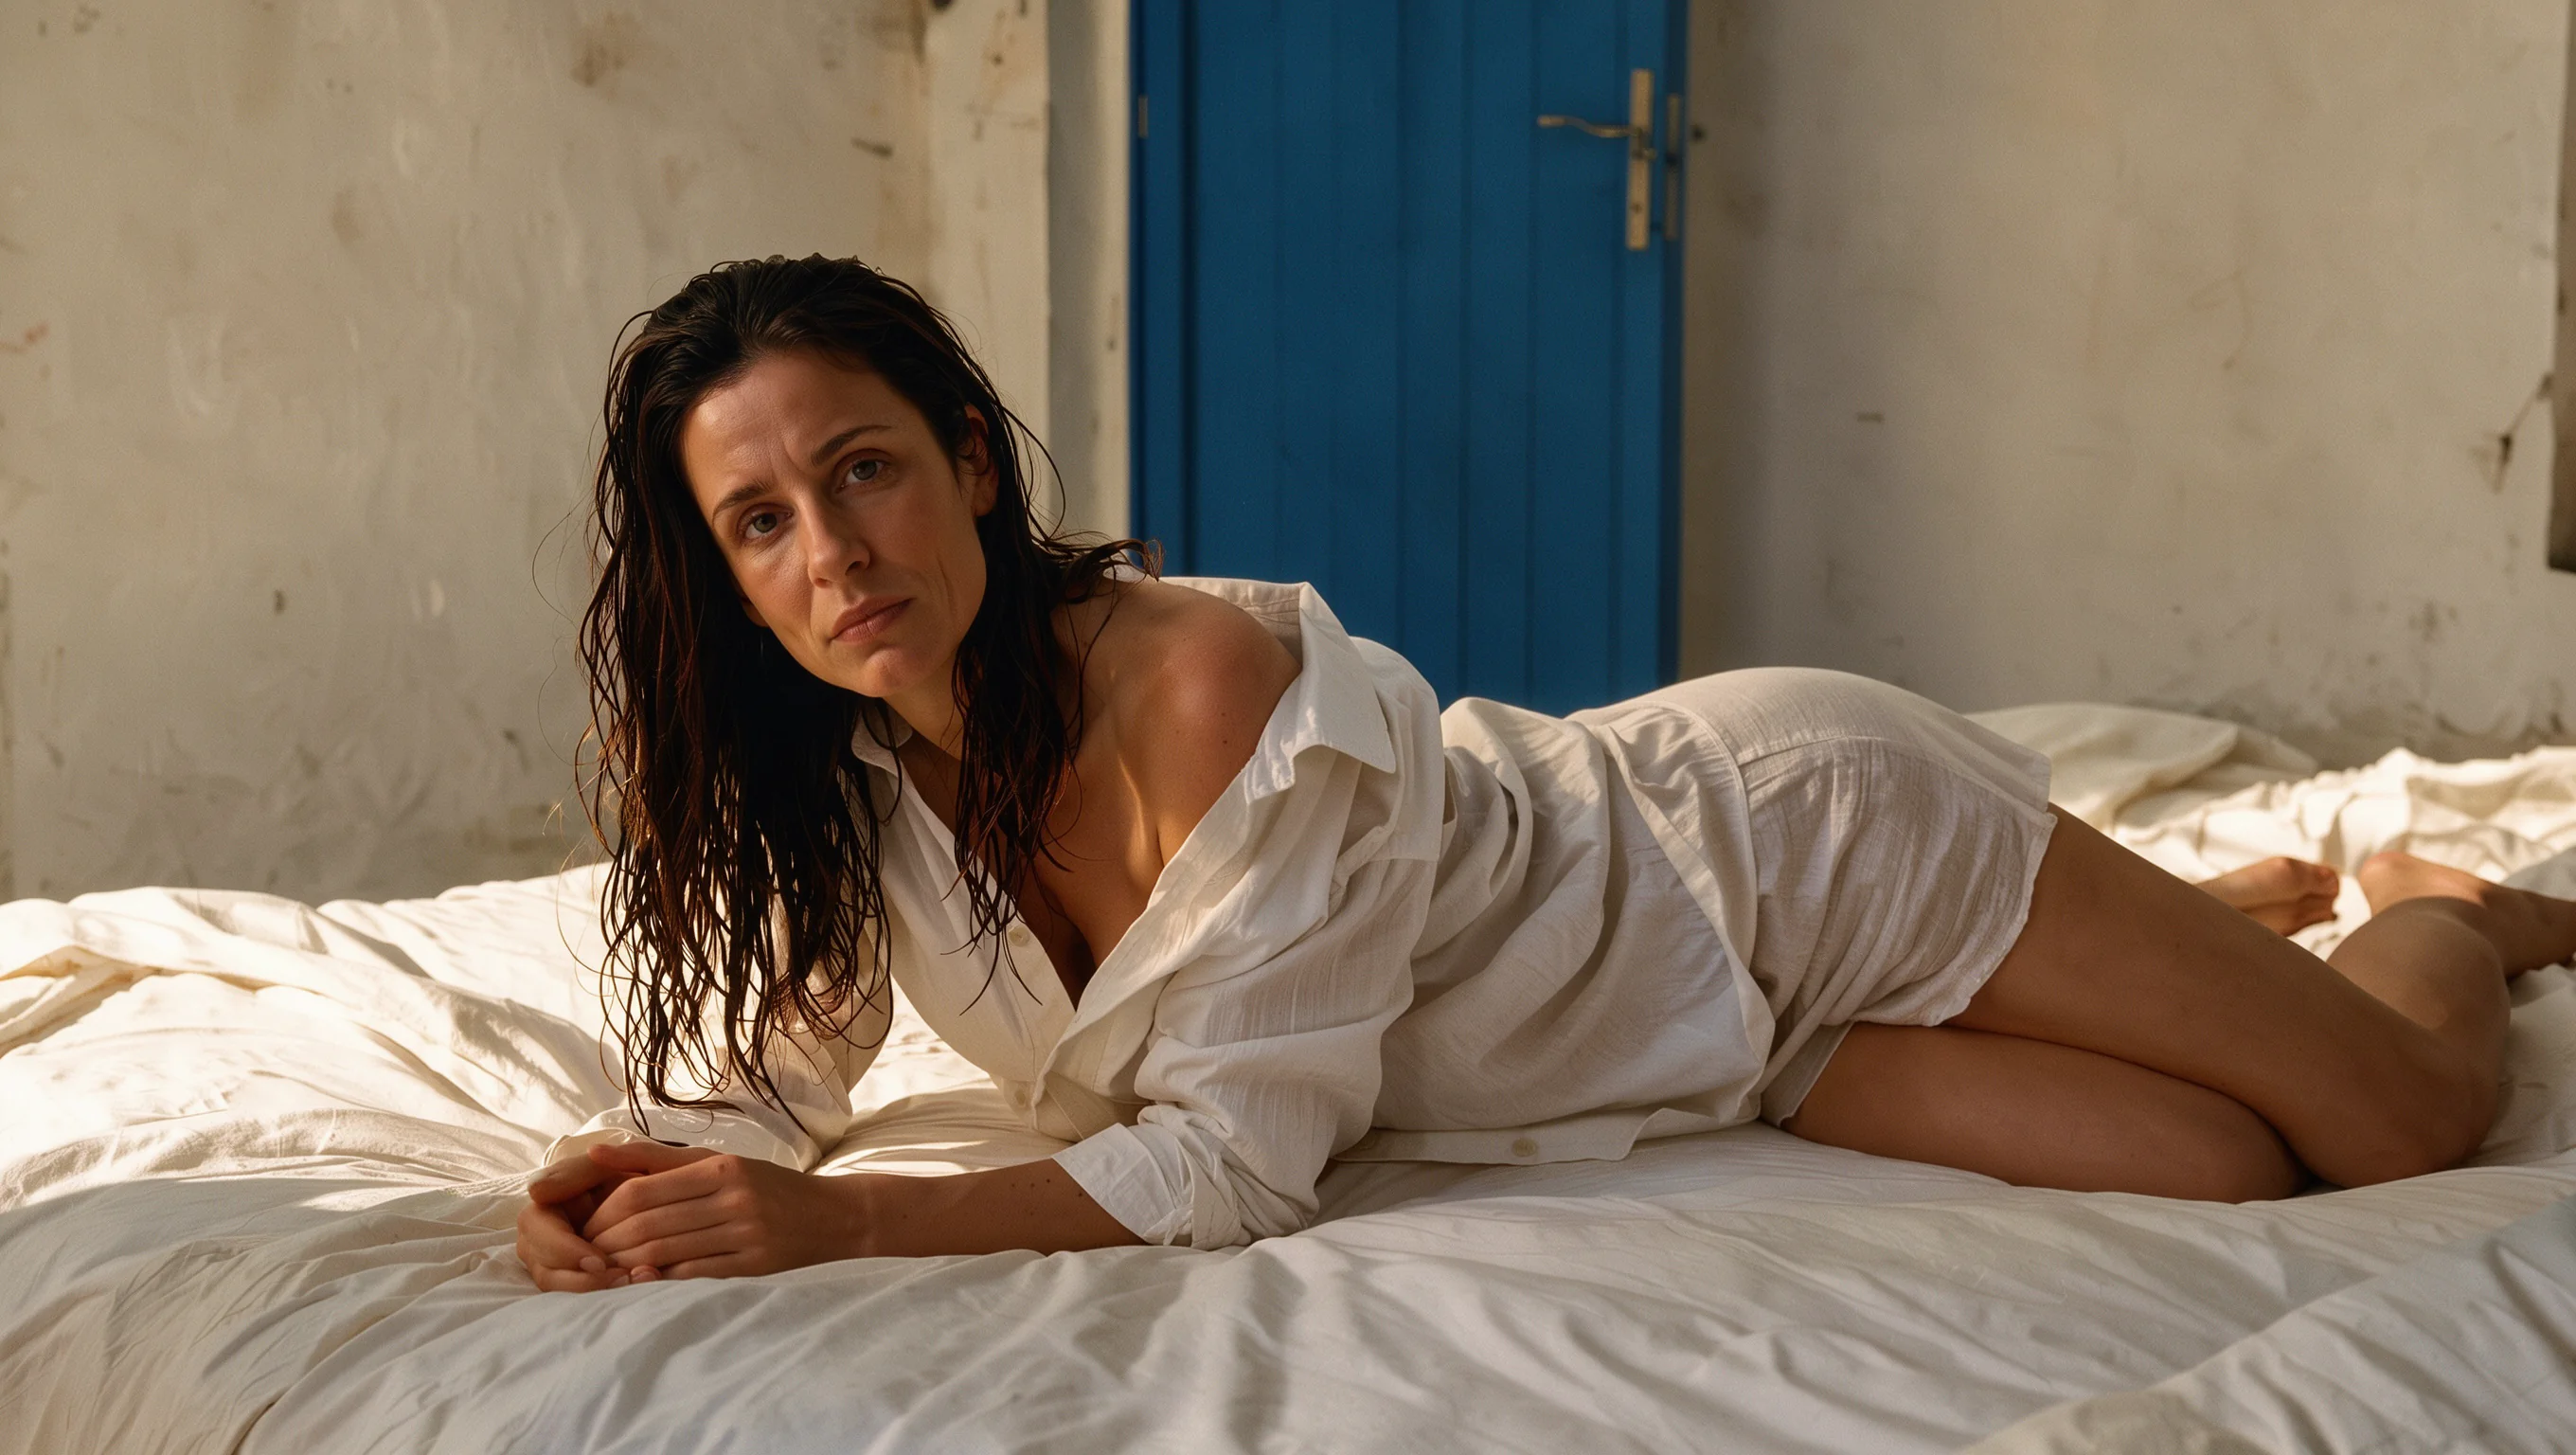
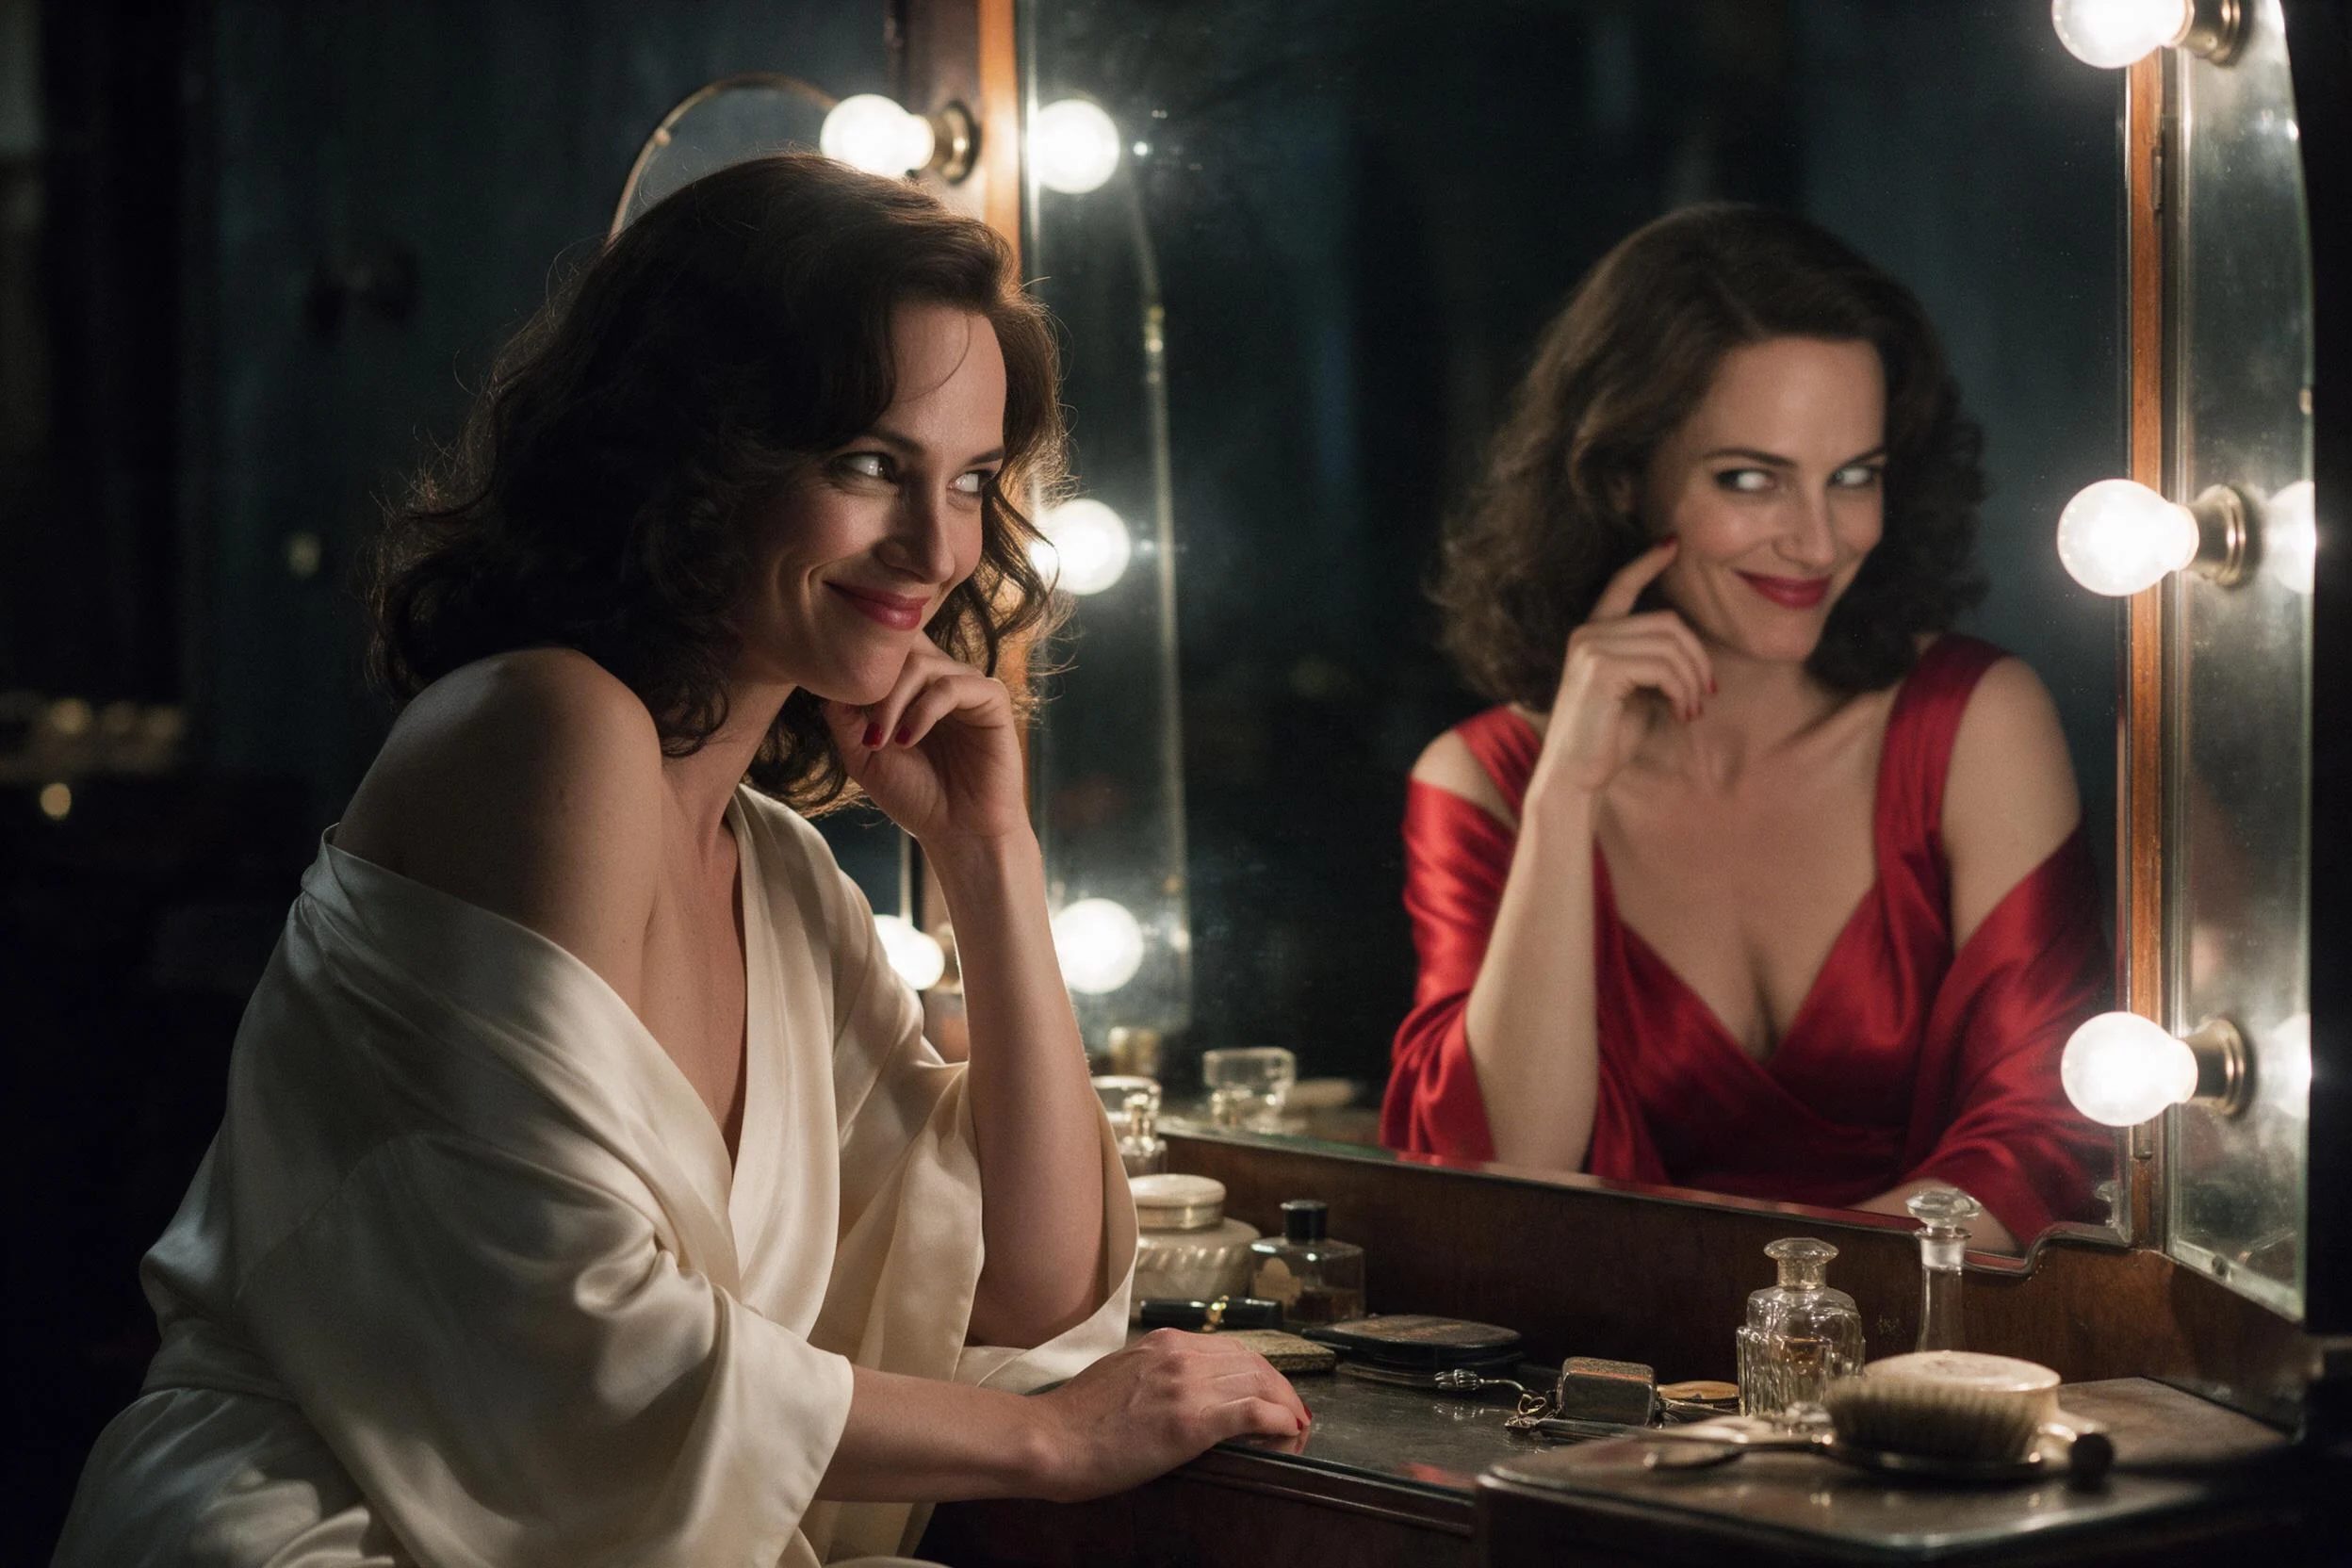
Las imágenes de este endpoint pasan directo al endpoint de edición. Allí el mismo modelo cambia ropa, clima o texto mientras el rostro y la pose se mantienen, por eso una escena dibujada aquí es un buen primer cuadro para una serie.
Respuesta rápida
La mayoría de nuestras ejecuciones de texto a imagen terminaron en 10 a 30 segundos, incluidos los formatos 21:9 y 9:16.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | Sí | Obligatorio, hasta 5,000 caracteres. Describe a la persona, la ropa, el lugar, la luz y la lente en oraciones; las palabras entre comillas se dibujan como texto. mínimo 1 caracteres · máximo 5000 caracteres |
aspect_ratio | No | Una de 1:1 (predeterminada), 16:9, 9:16, 4:3, 3:4 o 21:9. Todos los formatos tienen cerca de un megapíxel y cuestan lo mismo. |
output_format | No | jpeg (predeterminado) para archivos más ligeros, png para salida sin pérdida. El formato no cambia el precio. |
enable_prompt_expansion | No | Desactivado por defecto. Al activarlo, Kontext [pro] agrega detalles descriptivos a tu prompt antes de generar, lo que ayuda con prompts cortos y puede tardar un poco más. Valor predeterminado: |
Precios
$0.028 / imagen
El texto a imagen de Kontext [pro] se cobra por imagen; formato, tipo de archivo y expansión del prompt no cambian el precio. No pagas nada por una solicitud que se rechaza o que falla.
Casos de uso
Tableros de personajes y vestuario
Dibuja a una persona una vez en un escenario acorde a tu historia y luego ramifica esa imagen en atuendos y ambientes con ediciones, en lugar de generar una cara nueva cada vez.
Letreros, notas y utilería
Puertas de hotel, neones, notas a mano y etiquetas que deben decir algo concreto en un lugar concreto.
Imágenes para redes y campañas
Formato 9:16 para historias, 16:9 para encabezados y 21:9 para banners a partir del mismo brief escrito.
Guía de prompts y consejos prácticos
Describe la toma, no una lista de etiquetas
Quién, qué lleva puesto, dónde está, de dónde viene la luz y qué lente sugiere. Kontext [pro] sigue mejor las oraciones normales que las cadenas de palabras clave.
Toda palabra visible va entre comillas
Escribe el texto exacto entre comillas e indica dónde va: en el espejo, sobre la puerta, en un boleto.
Deja que la expansión complete los prompts cortos
Un prompt de una línea puede quedar plano. Activa la expansión del prompt para que el modelo agregue detalles, o déjala apagada cuando cada palabra de tu brief importe.
Piensa en el paso de edición
Si vas a cambiar el atuendo después, describe ahora con claridad el rostro, el cabello y la pose; en eso se apoyará la edición.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-1-kontext-pro/text-to-image",
  "input": {
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.