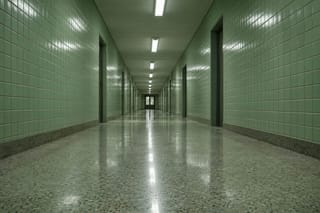
Copy the camera language of the reference clip — low, drifting right, never cutting — but stage it in the tiled corridor from reference image 1. One figure walking away from us, footsteps timed to the pulse in the reference track.
Scritto in inglese, esattamente come l’abbiamo inviato.
Stesso modello, partendo da questo prompt. Le altre impostazioni restano predefinite.
Perché questo prompt funziona
Il prompt indica da dove viene ciascun elemento: la macchina da presa dalla clip, la scenografia dall’immagine, il tempo dalla traccia. «low, drifting right, never cutting» dice al modello esattamente cosa estrarre. Nel risultato, una singola figura si allontana lungo il corridoio tratto da `reference_image_urls`, inquadrata bassa e senza tagli dall’inizio alla fine. `aspect_ratio` `21:9`, `resolution` `1080p`.
Impostazioni usate
Impostazione
Valore
A cosa serve
resolution
1080p
480p, 720p, 1080p o 4k, 720p per impostazione predefinita, e alimenta direttamente la quantità fatturata. Imposta soltanto la fascia in uscita e non renderà nitidi riferimenti a bassa risoluzione. Prova se i riferimenti si combinano a una fascia bassa, poi alzala per la ripresa finale. Qui non esiste alcuna fascia di upscaling o miglioramento.
aspect_ratio
21:9
Predefinito `adaptive`: il modello trova un'inquadratura che accoglie ogni soggetto referenziato, cosa che conta soprattutto quando gli asset di riferimento non condividono la stessa forma. Fissa proporzioni precise solo per un vincolo di consegna rigido – `9:16` per un feed verticale, per esempio – e controlla che nessuna persona o prodotto referenziato risulti tagliato. Nessun effetto sulla fatturazione.
generate_audio
true
Attivo per impostazione predefinita. Produce una colonna sonora nativa sincronizzata con le immagini. Anche fornendo `reference_audio_urls`, disattivarlo significa che nessuna colonna sonora viene resa: l'audio di riferimento modella ritmo e interpretazione, non è la traccia in uscita. Disattivalo quando il montaggio verrà musicato in post.
duration_seconds
10
Da 4 a 15 secondi, 5 per impostazione predefinita; con -1 è il modello a scegliere la durata (la stima usa il massimo di 15 secondi, l'addebito la durata consegnata). Quindici secondi sono il tetto di questa generazione; per un'inquadratura singola più lunga, passa all'endpoint 2.5. Nota che questo e la lunghezza delle tue clip di riferimento sono due contributi indipendenti alla quantità fatturata, quindi portarli entrambi al massimo è il punto in cui una sola richiesta diventa cara.
 Anteprima sfocata