Stesso modello, stesso completo aperto, terza città di notte
- Modello
- Seedance 2.0
- Attività
- Da riferimento a video
- Risoluzione
- 480p
- Durata
- 4 s
- Proporzioni
- 3:4
Risultato
Questa anteprima è sfocata
Questa anteprima è segnata come sensibile. Conferma la tua età per vederla.
Input
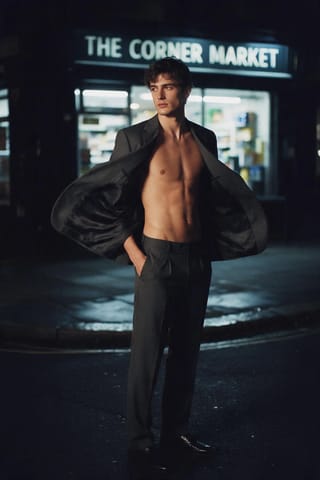
reference_image_urls 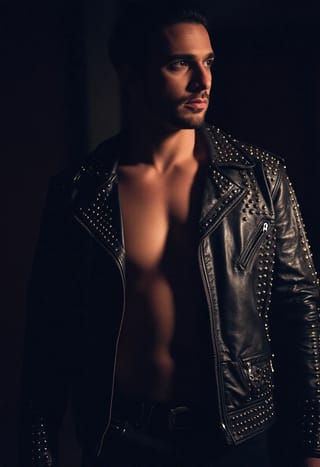
reference_image_urls 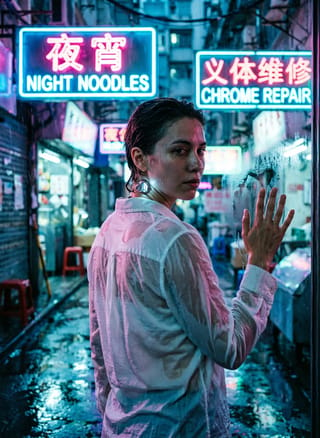
reference_image_urls
Sostituiscila con la tua quando lo esegui.
PromptEN376 caratteri
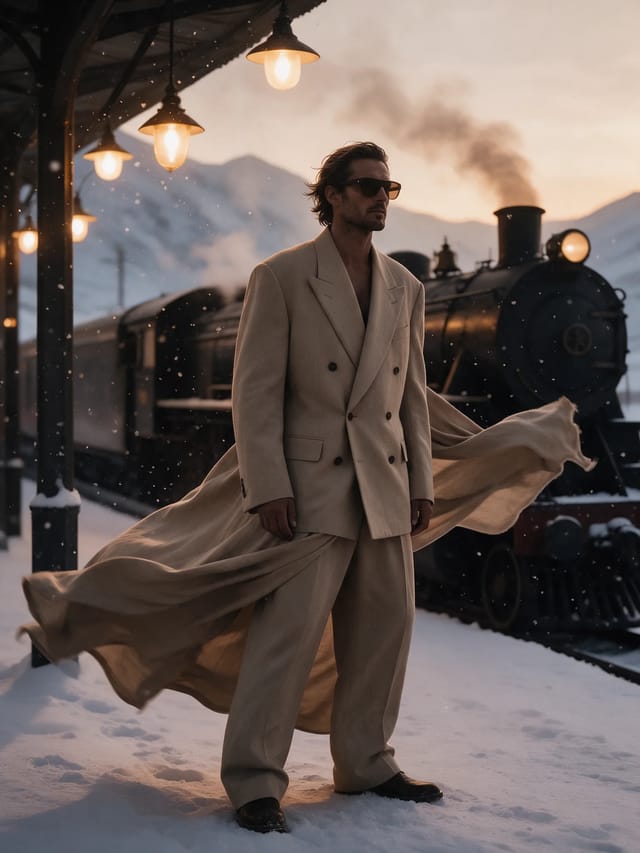
The camera stays on him as the wind takes the jacket fully open. The same model, the same unbuttoned suit, a third city corner at night: the wind takes the jacket open as he walks toward camera, traffic streaking behind. The wind takes the jacket fully open over a bare chest as he walks in; medium close. Cinematic, shallow depth of field, heavy film grain, cold street blue.Scritto in inglese, esattamente come l’abbiamo inviato.
Esegui questo esempio
Verifica del prezzo…
Apre il Playground con tutte le impostazioni già compilate e mostra il prezzo esatto prima dell’esecuzione.
Stesso modello, partendo da questo prompt. Le altre impostazioni restano predefinite.
Perché questo prompt funziona
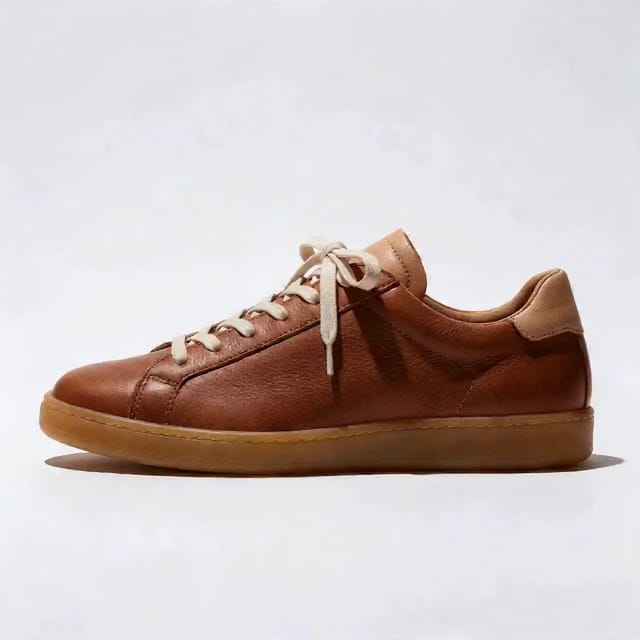
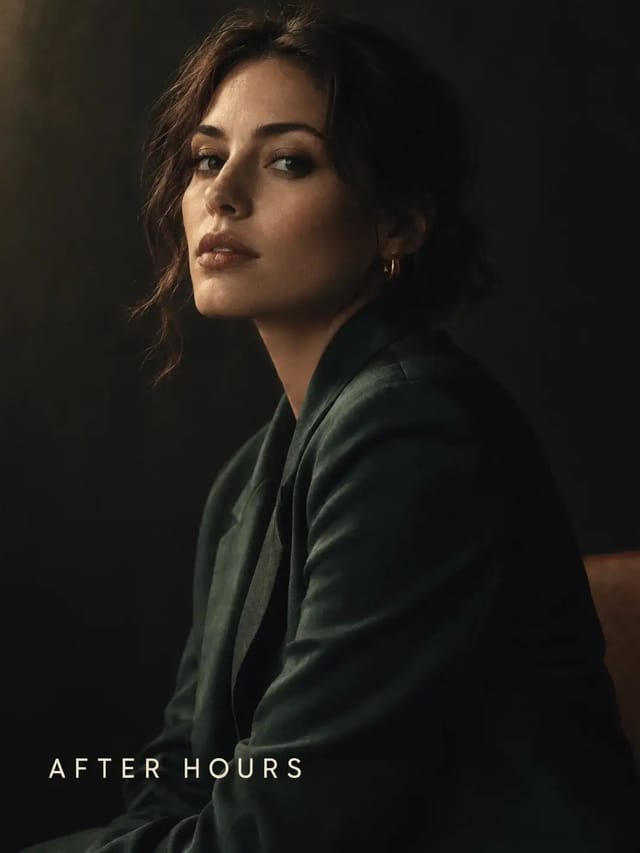
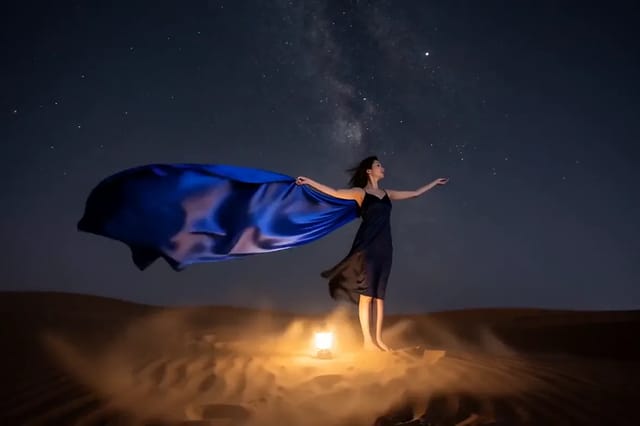
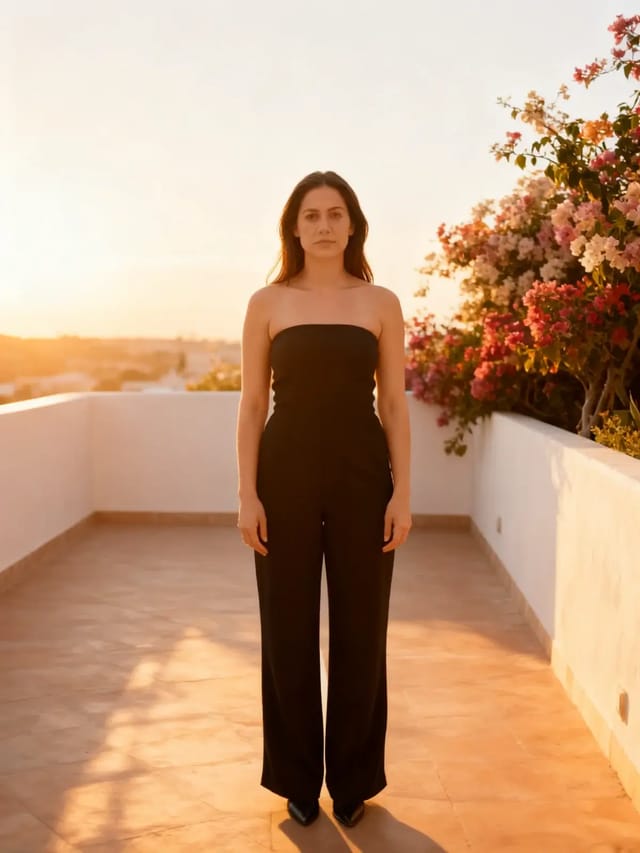
La continuità del guardaroba è la metà difficile di questo esempio: la stessa giacca aperta deve comportarsi come lo stesso capo al terzo angolo di strada, sotto una luce diversa. I riferimenti portano il modello e l'abito, lasciando al prompt solo il compito di descrivere cosa fa il vento e dove cammina. Fino a nove fermi immagine, tre clip e tre tracce audio entrano insieme, così il cast viaggia fra le inquadrature come dati e non come aggettivi.
Impostazioni usate
| Impostazione | Valore | A cosa serve |
|---|---|---|
| resolution | 480p | 480p, 720p, 1080p o 4k, 720p per impostazione predefinita, e alimenta direttamente la quantità fatturata. Imposta soltanto la fascia in uscita e non renderà nitidi riferimenti a bassa risoluzione. Prova se i riferimenti si combinano a una fascia bassa, poi alzala per la ripresa finale. Qui non esiste alcuna fascia di upscaling o miglioramento. |
| aspect_ratio | 3:4 | Predefinito `adaptive`: il modello trova un'inquadratura che accoglie ogni soggetto referenziato, cosa che conta soprattutto quando gli asset di riferimento non condividono la stessa forma. Fissa proporzioni precise solo per un vincolo di consegna rigido – `9:16` per un feed verticale, per esempio – e controlla che nessuna persona o prodotto referenziato risulti tagliato. Nessun effetto sulla fatturazione. |
| generate_audio | false | Attivo per impostazione predefinita. Produce una colonna sonora nativa sincronizzata con le immagini. Anche fornendo `reference_audio_urls`, disattivarlo significa che nessuna colonna sonora viene resa: l'audio di riferimento modella ritmo e interpretazione, non è la traccia in uscita. Disattivalo quando il montaggio verrà musicato in post. |
| duration_seconds | 4 | Da 4 a 15 secondi, 5 per impostazione predefinita; con -1 è il modello a scegliere la durata (la stima usa il massimo di 15 secondi, l'addebito la durata consegnata). Quindici secondi sono il tetto di questa generazione; per un'inquadratura singola più lunga, passa all'endpoint 2.5. Nota che questo e la lunghezza delle tue clip di riferimento sono due contributi indipendenti alla quantità fatturata, quindi portarli entrambi al massimo è il punto in cui una sola richiesta diventa cara. |