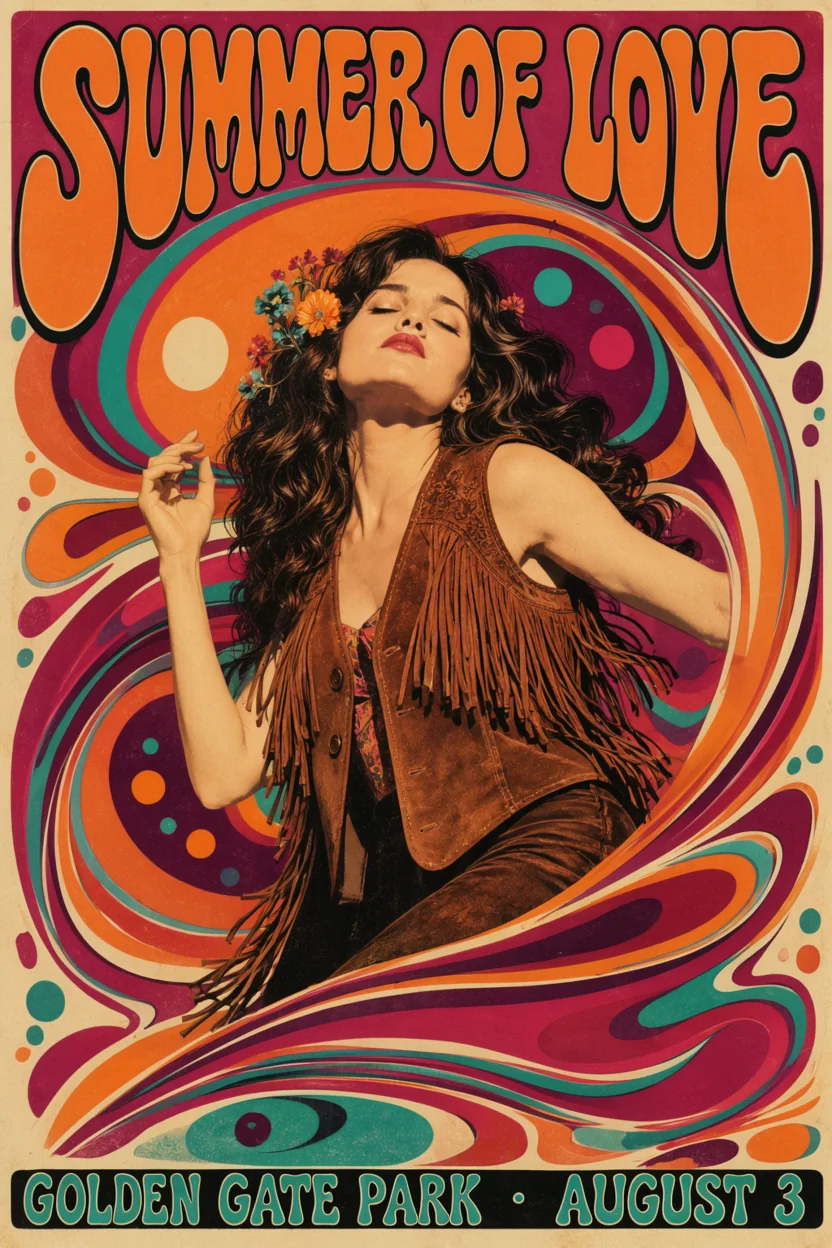
Wprowadzenie
MOSS-Image LoRA Tekst na obraz tworzy jeden obraz z pisemnego prompta na MOSS-Image, otwartym dyfuzyjnym transformerze o 5 miliardach parametrów od OpenMOSS, wydanym na licencji Apache-2.0, z załadowanymi do trzech Twoich plików LoRA. W naszych testach ładowały się LoRA wytrenowane na checkpoincie Base lub SFT, w formatach diffusers i ComfyUI, a LoRA stylu działały na scale 1. Platforma nie dodaje filtra treści do prompta, wag ani obrazu. Bez LoRA to ten sam model co MOSS-Image.
Wybierz model według potrzeb
| Czego potrzebujesz | Model |
|---|---|
| dokładny tekst, długie prompty i układ JSON z modelu bazowego | MOSS-Image Tekst na obraz |
| ten sam model plus do trzech własnych LoRA | MOSS-Image LoRA Tekst na obraz (jesteś tutaj) |
Najważniejsze funkcje
LoRA Base i SFT
LoRA wytrenowana na checkpoincie Base załadowała się tu, podobnie jak LoRA dla checkpointu SFT. W naszych testach działały oba układy plików: diffusers i ComfyUI.
Styl i tekst razem
Z LoRA psychodelicznego plakatu na scale 1 kolaż i wygląd liter zmieniły się zgodnie ze stylem LoRA, a tytuł i linia z datą pozostały poprawnie napisane.
Trzy naraz
Do trzech LoRA na żądanie, każda ze skalą od 0 do 4. Trzy nałożone na 0,7, 0,8 i 0,5 działały normalnie.
Bez cenzury
LoRA bez filtra ładuje się bez weryfikacji, a niczego nie filtrujemy. W naszych testach sam model bazowy obsługiwał każdy poziom od Łagodnego do Maksymalnego tak, jak napisano, bez odmów i bez łagodzenia.
Ten sam model, te same długie prompty
Prompty do 12 000 znaków, 15 proporcji obrazu i poziomy 1k, 1.5k oraz 2k, jak w endpoincie bazowym. Model przyjmuje też eksperymentalny prompt w układzie JSON.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
prompt | Tak | Wpisz słowo wyzwalające LoRA na początku, a potem opisz podmiot, miejsce i światło zdaniami. Każdy tekst, który ma być na obrazie, wpisz w cudzysłowie. od 1 znaków · do 12000 znaków |
aspect_ratio | Nie | 15 kształtów od 1:3 do 3:1; domyślnie 1:1. Proporcja zmienia kształt, nie cenę. |
resolution | Nie | 1k (około 1 megapiksela, domyślnie), 1.5k lub 2k. Poziom ustala cenę; wysoki obraz w 2k wyszedł jako 1536 x 2720. |
loras | Nie | Do trzech wpisów {path, scale} wytrenowanych pod MOSS-Image, na checkpoincie Base lub SFT; scale od 0 do 4, domyślnie 1. Domyślnie: |
output_format | Nie | Domyślnie JPEG, albo PNG lub WebP. Format nie zmienia ceny. |
seed | Nie | Utrzymuje porównywalność obrazów, gdy zmieniasz jedną LoRA albo jedno zdanie naraz. Nie gwarantuje identycznych pikseli. |
Cennik
Rozliczane za obraz według poziomu rozdzielczości (1k, 1.5k lub 2k). Ładowanie LoRA nie dodaje osobnej opłaty; proporcja obrazu i format wyniku nie zmieniają ceny. Za nieudane żądania nie pobieramy opłaty.
| Specyfikacja | Cena |
|---|---|
| $0.03 / obraz |
| $0.054 / obraz |
| $0.102 / obraz |
Zastosowania
Style plakatów i okładek
Załaduj LoRA stylu, zachowaj jej słowo wyzwalające na początku i wpisz tytuł oraz datę w cudzysłowie: wygląd pochodzi z pliku, słowa z prompta.
Spójny wygląd portretów
Użyj jednej LoRA portretowej w całej serii i zmieniaj proporcję albo poziom; wykończenie zostaje to samo.
Serie malowane i ilustrowane
Krótkie zdanie plus LoRA gwaszowa wystarczy na cały zestaw obrazów w jednej cenie za obraz.
Wskazówki
Słowo wyzwalające na początku
Zacznij prompt od słowa wyzwalającego LoRA, a potem podmiot, miejsce i światło opisz zdaniami.
Zacznij od scale 1
LoRA stylu były tu wyraźne na scale 1. Porównaj ze scale 0 na tym samym seedzie: jeśli oba obrazy są takie same, plik się nie zastosował. Scale 0,7 dawał łagodniejszy efekt z LoRA bez filtra.
Podawaj plik, nie stronę
Użyj bezpośredniego adresu pobrania pliku .safetensors. Strona repozytorium albo plik z ograniczonym dostępem kończy się komunikatem proszącym o bezpośredni link do pobrania, a za nieudane żądanie nie pobieramy opłaty.
Pierwsze uruchomienie bywa wolniejsze
Pierwsze żądanie z nową LoRA trwa dłużej, bo plik jest pobierany. Kolejne z tym samym plikiem są szybsze.
Cytuj tekst
Wpisz każdy tekst na obrazie w cudzysłowie i napisz, gdzie ma się znaleźć. Jeśli litery się zlewają, zmień seed.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "openmoss/moss-image-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.