Введение
Создайте MP4, передав портрет и аудиозапись задаче talking-avatar. Необязательный текст направляет видимое исполнение; resolution выбирает разрешение, а seed помогает сравнивать результаты.
| Характеристика | Значение |
|---|---|
| Ввод | Изображение Аудио |
| Вывод | Видео |
| Выбор модели | ByteDance OmniHuman 1.5; talking-avatar |
| Обязательный файл изображения | JPEG / PNG / WebP, до 30 МБ |
| Обязательный аудиофайл | MP3 / WAV, до 15 МБ; 1–60 секунд |
| Предел промпта | 2 000 символов; необязательные визуальные указания |
| Разрешения и значение по умолчанию | По умолчанию 1080p; также 720p; тариф одинаков |
| Значения seed | 0–2147483647; необязательная помощь в сравнении |
| Оплата аудио | Секунды входного аудио с округлением вверх до целых |
| Завершение и формат файла | Идентификатор задачи, опрос или уведомление; MP4 |
| Срок хранения | 14 дней до удаления сгенерированных файлов |
Ключевые возможности и особенности
Ладонь вверх дополняет реплику
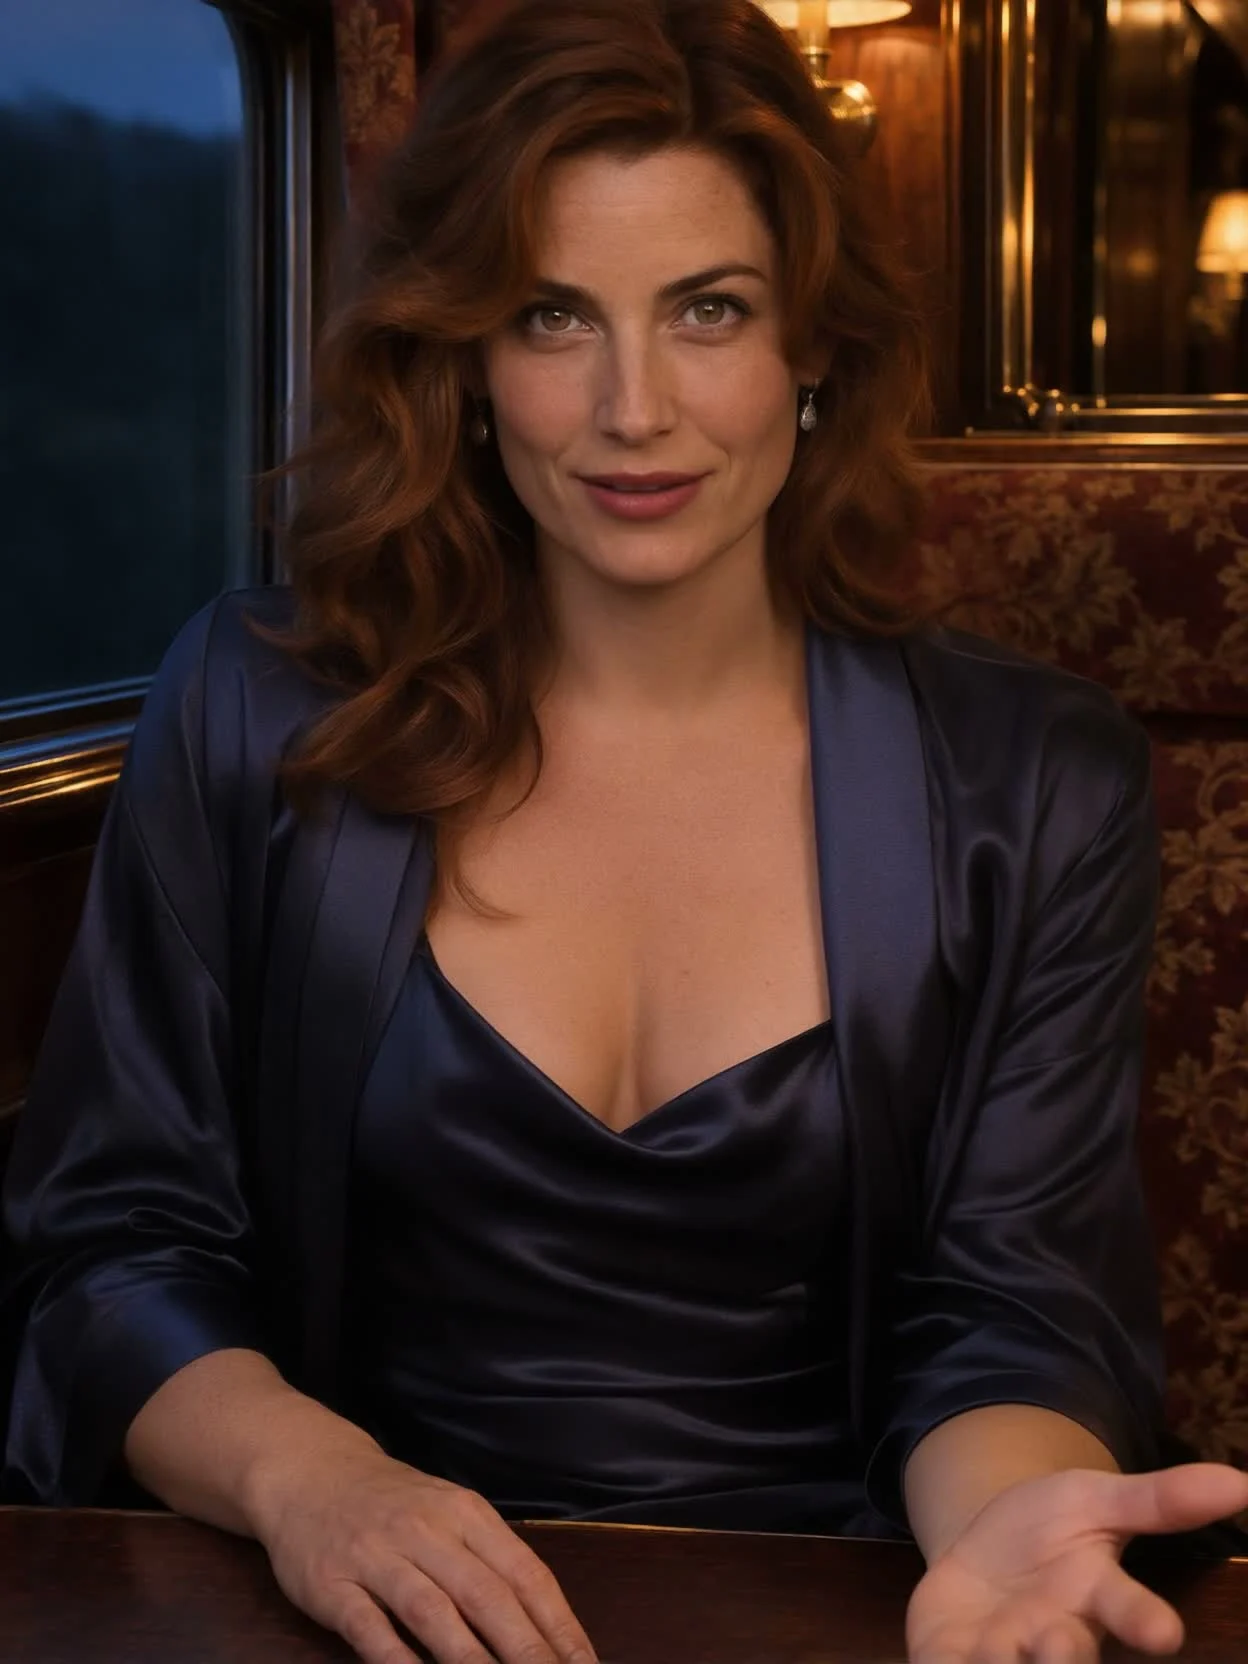
В тесте со спальным вагоном неподвижный портрет превратился в говорящего персонажа: женщина подняла руку ладонью вверх, кивнула и улыбнулась. Запрос 1080p сочетал запись на 6,35 секунды с текстовыми указаниями движений.
Портрет вернулся в кадре 3:4
Портрет из поезда размером 1024×1536 дал видео 1248×1664 при 25 кадрах/с, где женщина видна по пояс. Хотя промпт просил зафиксировать камеру, кадрирование изменилось; проверьте результат перед включением в монтаж.
Разделите слова и визуальную подачу
Именно аудиофайл задаёт голос и реплики. По заявлению ByteDance, промпт направляет жесты, настроение и камеру, а запись управляет исполнением; этот эндпоинт не клонирует голос говорящего.
Разрешение определяет изображение
По умолчанию эндпоинт использует 1080p, также принимается 720p. Цена секунды одинакова и рассчитывается по входной записи с округлением вверх, а не по измеренной длине итогового видео.
Параметры запроса
| Параметр | Обязательно | Описание |
|---|---|---|
image_url | Да | Обязателен для talking-avatar: JPEG, PNG или WebP до 30 МБ с чётким лицом анфас. Для жестов включите верхнюю часть фигуры и руки. Не менее 1 символов |
audio_url | Да | Обязателен для talking-avatar: MP3 или WAV до 15 МБ на 1–60 секунд с речью или пением. Значения по умолчанию нет; длительность округляется вверх для оплаты. Не менее 1 символов |
prompt | Нет | Необязательные указания talking-avatar по действиям, мимике, сцене и камере, до 2 000 символов. Текст по умолчанию не указан; слова остаются в записи, промпт на цену не влияет. Не менее 1 символов · Не более 2000 символов |
resolution | Нет | Для talking-avatar выберите 720p или 1080p; без поля используется 1080p. Тариф обоих уровней одинаков, а измеренные размеры результата зависят от сгенерированной композиции. |
seed | Нет | Необязательное целое число talking-avatar от 0 до 2147483647; значение по умолчанию не задано. |
Стоимость
$0.144 / секунда
Оплачивается входное аудио длительностью 1–60 секунд с округлением вверх до целых секунд. У 720p и 1080p один тариф; выбор изображения, текст промпта и seed на него не влияют.
Сценарии использования
Поставьте короткое приглашение персонажа
Возьмите портрет с пространством для рук и записанное приглашение. В примере со спальным вагоном речь сопровождают поднятая ладонь, кивок и улыбка.
Оживите объяснение ведущего
Соедините разрешённый портрет ведущего с готовым объяснением и попросите небольшой кивок или жест открытой ладонью. Лицо должно быть видно; сопоставьте движения с ключевыми словами.
Создайте поющий портрет
Для той же задачи с фотографией передайте пение вместо речи. ByteDance указывает пение среди поддерживаемых сценариев; описанные здесь запуски использовали разговорные реплики.
Попробуйте другую актёрскую подачу
Сохраняйте портрет и запись, меняя одно указание мимики или движения. Повторно используйте seed для сравнения, затем оценивайте каждое видео, не рассчитывая на совпадение кадров.
Подготовьте портрет к вертикальному монтажу
Оба измеренных результата сохранили вертикальную композицию, но размеры отличались от исходных изображений. Перед размещением ролика в макете проверьте полученное кадрирование и видимую область жестов.
Руководство по промптам и практические советы
Проверьте оба медиафайла
Убедитесь в допустимом формате портрета и размере до 30 МБ, затем проверьте MP3 или WAV до 15 МБ на 1–60 секунд. Подтвердите права на образ человека и переданный голос.
Отправьте исходники задачи с портретом
Укажите модель bytedance/omnihuman-1.5/talking-avatar с
image_urlиaudio_url. При необходимости добавьте указания исполнения или seed, выберите 720p либо стандартное 1080p.Сопоставьте звук, жесты и кадр
Отследите завершение по идентификатору, получите MP4 и сравните его с исходной записью и запрошенными действиями. Сохраните готовый файл до окончания хранения через 14 дней.
Оживление портрета с заданными движениями
OmniHuman 1.5 от ByteDance превращает портрет и запись речи или пения в MP4. По заявлению ByteDance, мимика, жесты и движения фигуры реагируют на эмоции и смысл записи. Необязательный текстовый промпт добавляет указания по видимым действиям, выражению лица, сцене и камере.
Для этого процесса с фотографией вызывайте bytedance/omnihuman-1.5/talking-avatar. Запись задаёт голос и слова; эндпоинт не клонирует голос и не читает сценарий реплики из промпта. Подготовьте аудио целиком до запроса видео.
Роли параметров
| Поле | Обязательность и допустимое значение | Значение по умолчанию и влияние на оплату |
|---|---|---|
image_url | Обязательный портрет; JPEG, PNG или WebP до 30 МБ. Желательно чёткое лицо анфас. | Изображения по умолчанию нет; оплата учитывает аудио. |
audio_url | Обязательный MP3 или WAV до 15 МБ длительностью 1–60 секунд. Принимаются речь и пение. | Записи по умолчанию нет; длительность округляется вверх до целых оплачиваемых секунд. |
prompt | Необязательные указания до 2 000 символов по движению, мимике, сцене или камере. | Текст по умолчанию не задан; указания не меняют тариф. |
resolution | Необязательное 720p или 1080p. | Без поля используется 1080p; тариф одинаков для обоих вариантов. |
seed | Необязательное целое число от 0 до 2147483647 для сравнения. | Значение по умолчанию не указано; на цену не влияет. |
Эти пять полей относятся к задаче talking-avatar. Портрет с верхней частью фигуры и руками оставляет в изображении место для жестов. Отдельного поля соотношения сторон среди этих настроек нет; оценивайте полученную композицию, не предполагая точного сохранения кадрирования.
Подготовьте портрет, запись и указания
Выберите видимую область исполнения
Возьмите резкий портрет с лицом, обращённым к зрителю. Включите руки, если для сцены важна приглашающая ладонь вверх или другой жест. Проверьте права на образ и голос по отдельности: каждый показанный человек должен быть совершеннолетним, результат не должен имитировать чужую личность.
Соблюдайте ограничения формата и размера изображения. Согласуйте указания с портретом, чтобы нужное действие было легко оценить: кивок, открытая ладонь или улыбка в конце фразы. Проверяйте и сгенерированное кадрирование, и само действие.
Подготовьте звук до текстового промпта
Прослушайте весь MP3 или WAV и измерьте его длину. Для качества ByteDance рекомендует записи не длиннее 15 секунд, хотя принимается до 60 секунд. Длина аудио определяет планируемую длительность ролика и оплачиваемый объём; удалите фрагменты, которые не нужны.
В prompt пишите указания исполнения, а реплики оставляйте в audio_url. Для текста промпта ByteDance перечисляет китайский, английский, японский, корейский, испанский и индонезийский. Это языки письменных указаний, а не измеренный здесь перечень проверенных языков речи.
Для контролируемого сравнения повторно используйте seed, меняя одно указание и сохраняя остальные исходники. seed помогает выделить влияние правки, но не гарантирует совпадения видео при повторных запросах.
Рассчитайте оплату по длине аудио
Учитываются секунды входного аудио в диапазоне 1–60 секунд с округлением вверх до ближайшей целой секунды. Выбор 720p вместо стандартного 1080p не снижает тариф. Портрет, необязательный промпт и seed не меняют правило оплаты по аудио. Актуальная цена указана на странице OmniHuman 1.5.
В примере со спальным вагоном использовалось 6,35 секунды аудио, поэтому оплачивалось 7 секунд. Возвращённое видео длилось 6,44 секунды; расчёт всё равно опирался на переданную запись, а не результат рендера. При сверке запроса различайте эти измерения.
Наблюдения жестов и кадрирования
В sleeper-train-stay портрет женщины с каштановыми волосами в тёмно-синем шёлковом наряде в купе размером 1024×1536 сочетался с коротким приглашением. В запросе 1080p были указаны улыбка, приглашающее движение руки, открытые ладони и кивок при неподвижной камере.
В нашем тесте женщина подняла руку ладонью вверх, кивнула, улыбнулась и говорила синхронно с записью. Результат: 1248×1664, 25 кадров/с, 6,44 секунды. Изображение стало композицией 3:4 с женщиной по пояс. Зафиксированное наблюдение подтверждает поднятую руку и кивок, но не точное выполнение каждого действия и ограничения кадрирования.
Отдельный запуск 720p сочетал портрет 832×1248 с речью на 4,55 секунды. Результат сохранил вертикальную композицию и составил 832×1120 при 25 кадрах/с и длине 4,52 секунды. Это размеры двух измеренных результатов, а не фиксированные пиксельные размеры, обещанные обозначением разрешения.
Отправьте задачу, получите и сохраните файл
Задачи асинхронные: отправка возвращает идентификатор, а сведения о завершении поступают через опрос или уведомление. Получите MP4 после завершения и сопоставьте движения рук, лицо, кадрирование и финальный момент с исходной записью.
Через 14 дней хранение заканчивается и сгенерированные файлы удаляются. Скачайте подходящий ролик в этот срок и сохраните входные настройки, если планируете вернуться к исполнению.
Из других вариантов OmniHuman изучите OmniHuman 2.0. InfiniteTalk и VEED Fabric 1.0 — соседние страницы оживления портретов. Перед выбором проверьте их входные данные и ограничения; наши запуски OmniHuman 1.5 не устанавливают рейтинг качества или времени обработки относительно этих моделей.
Быстрый старт API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-1.5/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "resolution": "1080p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Аутентификация, полная схема, опрос статуса и обработка ошибок описаны в справочнике API.