Введение
Передайте материал в video_url, а новую речь в audio_url. Модель перерисовывает рот под звук и возвращает MP4 с размером кадра исходника и длиной звука.
| Характеристика | Значение |
|---|---|
| Ввод | Видео Аудио |
| Вывод | Видео |
| Модель | VEED Lipsync 2.0 |
| Обязательные входы | Видео одного человека ( |
| Разрешение | Как у входного видео |
| Длительность | По звуку, до 5 минут |
| Результат | MP4 с новым звуком, 25 кадров/с |
| Оплата | За секунду аудио, с округлением вверх |
Ключевые возможности и особенности
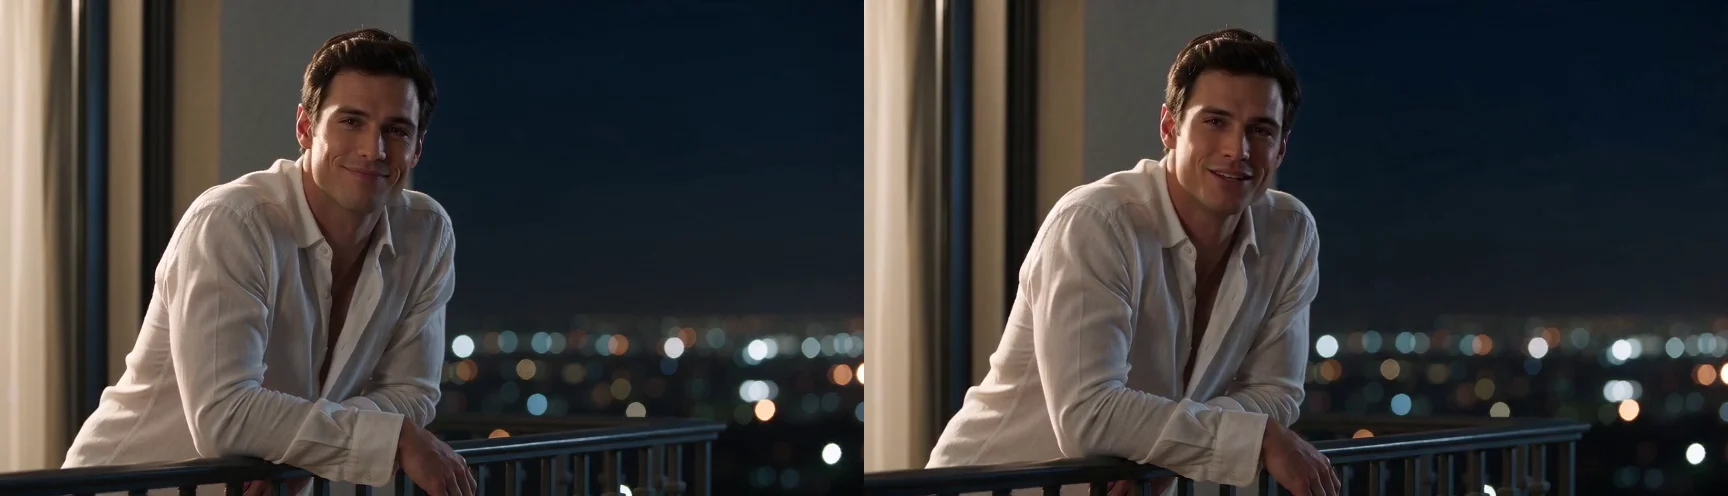
Сцена на балконе с новой пятисекундной репликой
Мы дали Lipsync 2.0 шестисекундный ролик с мужчиной в белой льняной рубашке на балконе отеля и новую записанную реплику. Его рот теперь произносит новые слова, а огни города, рубашка и полуулыбка остались как сняты. Результат: 864×496 и 5,08 секунды, обрезано по звуку.
Тот же момент, другая форма рта
Вторая секунда, рядом: слева исходный дубль с сомкнутыми в улыбке губами, справа результат с открытым ртом на новой реплике. Рубашка, перила и огни позади не изменились.
Ролик — единственный нужный образец
Никаких образцов голоса, загрузки фото лица и дообучения. Смените аудиофайл, и тот же материал скажет другую реплику.
Параметры запроса
| Параметр | Обязательно | Описание |
|---|---|---|
video_url | Да | Обязательно. MP4 или WebM с одним человеком и видимым лицом. Не менее 1 символов |
audio_url | Да | Обязательно. Новая речь, до пяти минут. Не менее 1 символов |
Стоимость
$0.084 / секунда
Оплата за секунду нового звука с округлением вверх до целой секунды. Длина и разрешение материала на цену не влияют. Неудачные рендеры не оплачиваются.
Сценарии использования
Исправить реплику после съёмки
Замените слово, цену или название продукта в готовом дубле, не вызывая человека снова на площадку.
Перевод, который выглядит родным
Положите переведённую дорожку на исходный материал, и рот последует за новым языком.
Новые реплики для сгенерированных роликов
Персонаж из видеомодели может сказать не ту фразу, с которой его сгенерировали.
Руководство по промптам и практические советы
Выберите дубль с чётким лицом
Лучше всего подходит фронтальный, хорошо освещённый и спокойный кадр. Резкие повороты головы, рука у рта и волосы на губах снижают точность.
Подготовьте новую реплику
Запишите её, создайте моделью озвучки или возьмите переведённую дорожку. Один голос без музыки; шумную запись лучше сначала очистить.
Отправьте обе ссылки
Передайте материал в
video_url, а речь вaudio_url. Готовый ролик вернётся в разрешении исходника.
Введение
VEED Lipsync 2.0 меняет то, что человек в кадре будто бы говорит. Передайте материал в video_url и новую речь в audio_url, и рот будет перерисован под неё.
Возможности и преимущества
Для уже снятого дубля
Остальной кадр остаётся как снят: фон, одежда и выражение лица сохраняются, заново рендерится только область рта.
Какое разрешение на входе, такое и на выходе
Результат сохраняет размер кадра входного видео, и цена от него не зависит.
Длину определяет звук
Более короткий звук обрезает ролик, более длинный продлевает изображение. В наших тестах результат совпадал со звуком до сотых долей секунды.
Сценарии использования
Исправления без пересъёмки
Исправьте имя, дату или предложение в записанном ролике ведущего.
Замена голоса
Положите переведённую или перезаписанную дорожку на исходное исполнение.
Советы по входным данным
Один человек, лицом к камере
Модель поддерживает одного говорящего на ролик. Держите лицо в кадре и избегайте резких поворотов головы.
Чистый звук
Используйте один голос без музыки и фонового шума, а шумную запись сначала очистите.
Попадайте в темп
Новая реплика, близкая по длине к исходной, сохраняет естественность движений.
Быстрый старт API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "veed/lipsync-2.0/lip-sync",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "video_url": "https://example.com/reference.mp4"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Аутентификация, полная схема, опрос статуса и обработка ошибок описаны в справочнике API.