Введение
Wan 2.7 Текст в изображение превращает письменную арт-дирекцию в новое изображение. Используйте его, когда композицию, объект, свет и визуальную иерархию нужно выстроить по брифу.
Выберите режим Wan 2.7 по исходному материалу
| Что у вас есть в начале | Режим |
|---|---|
| письменный визуальный бриф | Wan 2.7 Текст в изображение |
| изображение, которому нужно направленное изменение | Wan 2.7 Редактирование изображения |
Ключевые возможности и особенности
Правка по девяти картинкам рисует то, что вы написали
Дайте image-to-image референс, и она нарисует ровно тот бриф, который вы отправили, включая гардероб и кадрирование. На этой платформе нет ни флага контента, ни деклараций в запросе — ни на одном из двух эндпоинтов; разница в самой модели. На text-to-image острый промпт она отрисовывает более сдержанным кадром. Сцена в кафе на этой странице — это text-to-image: большая белая рубашка и дождь на стекле, и примерно там текстовый эндпоинт и останавливается.
Сведите до девяти картинок, не рисуя маску
Image-to-image принимает от одной до девяти исходных картинок в одном запросе, поэтому одежда, лицо, комната и цветовой референс могут войти в одну правку. Скажите в prompt, за что отвечает каждый источник: неподписанная стопка усредняется, и это самая частая причина, по которой правка на девяти картинках возвращается кашей.
Сначала раскладывает композицию, потом рисует
Wan 2.7 планирует кадр до того, как его рисует, и это видно там, где нужно пространственное решение: кто на переднем плане, что в руке, где источник света. Длинные описательные формулировки с ясным героем и одной ясной связью здесь работают лучше груды ключевых слов.
Параметры запроса
| Параметр | Обязательно | Описание |
|---|---|---|
prompt | Да | Описывайте кадр: герой, действие, положение камеры, затем свет и объектив. Не менее 1 символов · Не более 5000 символов |
aspect_ratio | Нет | 1:1, 4:3, 3:4, 16:9, 9:16, 3:2 или 2:3, по умолчанию 1:1. Пиксельный бюджет у всех одинаковый, поэтому широкое соотношение даёт шире, а не больше. |
enable_thinking | Нет | Модель разбирает запрос, прежде чем начать генерацию. Без него заметно быстрее, а на подробных запросах качество почти не меняется. По умолчанию: |
num_outputs | Нет | От 1 до 4, каждая со своим seed на одном и том же брифе. Четыре прочтения одной композиции сравнимы напрямую: кроме seed ничего не менялось, — и каждая картинка тарифицируется. |
resolution | Нет | 1k или 2k, по умолчанию 1k. В 2k вчетверо больше пикселей, а пропорции по-прежнему задаёт |
color_palette | Нет | Необязательная цветовая тема из 3–10 цветов (рекомендуется 8). Не менее 3 элементов · Не более 10 элементов |
seed | Нет | От 0 до 2147483647. Держите его и меняйте по одному обороту: при одном и том же seed выборка не сдвигается, так что меняется только оборот. |
Стоимость
$0.03 / изображение
Сценарии использования
Исследовать визуальную идею до продакшна
«Текст в изображение» — эндпоинт для кадра, в котором ещё ничего не зафиксировано: нет лица, одежды или комнаты, которые должны сохраниться. Опишите объект, действие, положение камеры, свет и объектив и запросите до четырёх вариантов сразу через num_outputs; каждый — отдельный seed на том же брифе и оплачивается как отдельное изображение.
Создать ключевой кадр для раскадровки
Сгенерируйте кадр в 3:2 или 9:16, а затем передайте его в эндпоинт «изображение в видео» как стартовый кадр. Тогда видеопромпту остаётся только движение — это самый прямой способ перенести в клип точную одежду и позу.
Задать визуальную систему кампании
Зафиксируйте один seed и один каркас промпта и пройдитесь по aspect_ratio 1:1, 3:2 и 9:16 для профиля, баннера и карточки сторис. Бюджет пикселей одинаков для всех соотношений, так что более широкий кадр становится шире, но не больше.
Руководство по промптам и практические советы
Сначала композиция, потом декор
Назовите объект, что он делает и где стоит камера, прежде чем описывать свет, материалы и стиль. Wan 2.7 планирует кадр до отрисовки, поэтому одна ясная пространственная связь работает лучше груды прилагательных.
Зафиксируйте seed и меняйте что-то одно
Когда кадр близок к цели, держите seed и меняйте одну часть: одежду, свет, формат. Тот же seed удерживает генерацию стабильной, так что любая видимая разница — результат изменённой части; идентичного изображения это не гарантирует.
Проверьте холст, прежде чем использовать изображение дальше
При значении 1k по умолчанию холст составляет примерно 1,01–1,05 мегапикселя при любом соотношении сторон, а resolution: 2k даёт примерно вчетверо больше. По одному тексту модель придумывает новое лицо на каждом seed, поэтому если человек должен оставаться узнаваемым, переходите к редактированию изображения с референсом. Выключенный enable_thinking заметно быстрее.
Быстрый старт API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/wan-2.7/text-to-image",
  "input": {
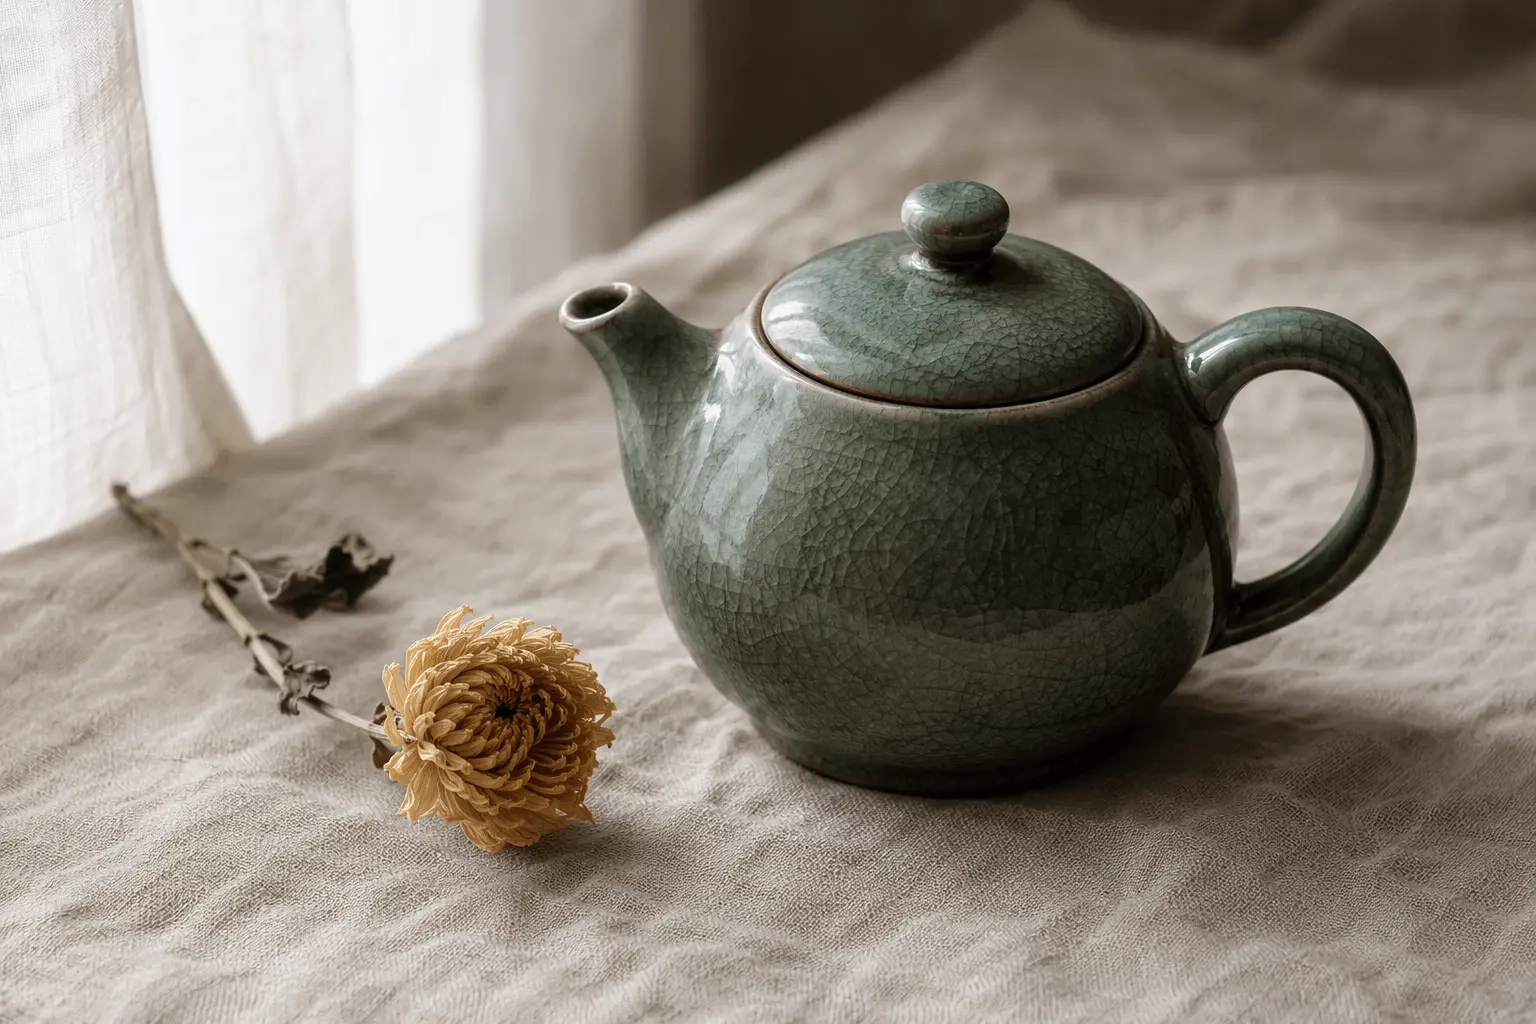
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k",
    "num_outputs": 1,
    "aspect_ratio": "1:1"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Аутентификация, полная схема, опрос статуса и обработка ошибок описаны в справочнике API.