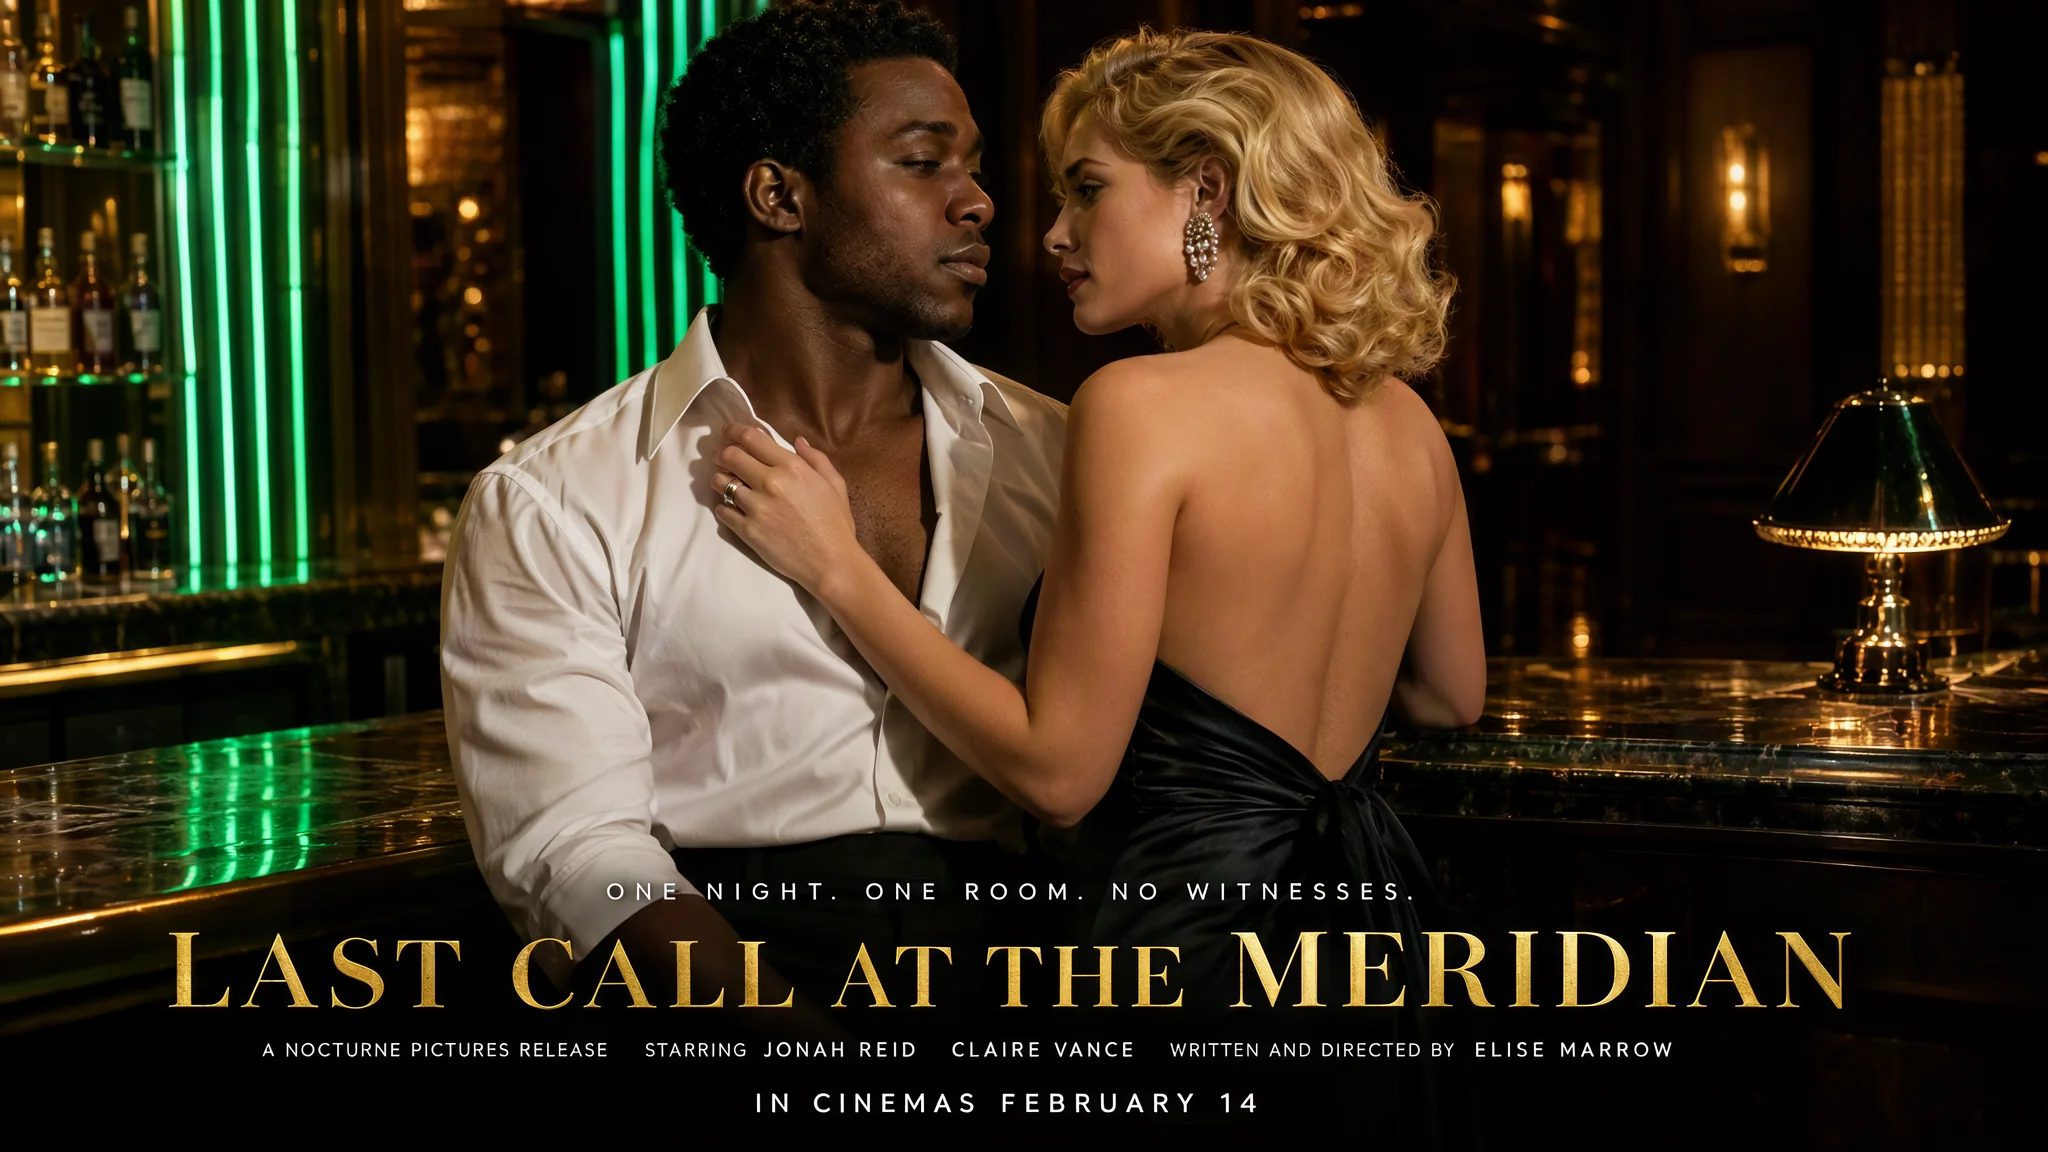
Einführung
MOSS-Image Text-zu-Bild zeichnet aus einem geschriebenen Prompt ein Bild mit MOSS-Image, einem offenen Diffusion-Transformer mit 5 Milliarden Parametern von OpenMOSS, veröffentlicht unter Apache-2.0. Er ist für Bilder gebaut, die viel exakten Text enthalten, etwa Plakate, Magazincover, Anzeigen und Schilder. In unseren Tests las er auch sehr lange Prompts bis zum Ende, und NSFW-Prompts kamen auf jeder Stufe von Mild bis Maximal so zurück, wie sie geschrieben waren. Die Plattform legt keinen Content-Filter darüber. Für eigene LoRA-Dateien nutzen Sie MOSS-Image LoRA Text-zu-Bild.
Modell nach Bedarf wählen
| Was Sie brauchen | Modell |
|---|---|
| exakten Text, lange Prompts und JSON-Layout vom Basismodell | MOSS-Image Text-zu-Bild (Sie sind hier) |
| dasselbe Modell mit bis zu drei eigenen LoRAs | MOSS-Image LoRA Text-zu-Bild |
Wichtige Funktionen und Highlights
Text, der so kommt, wie geschrieben
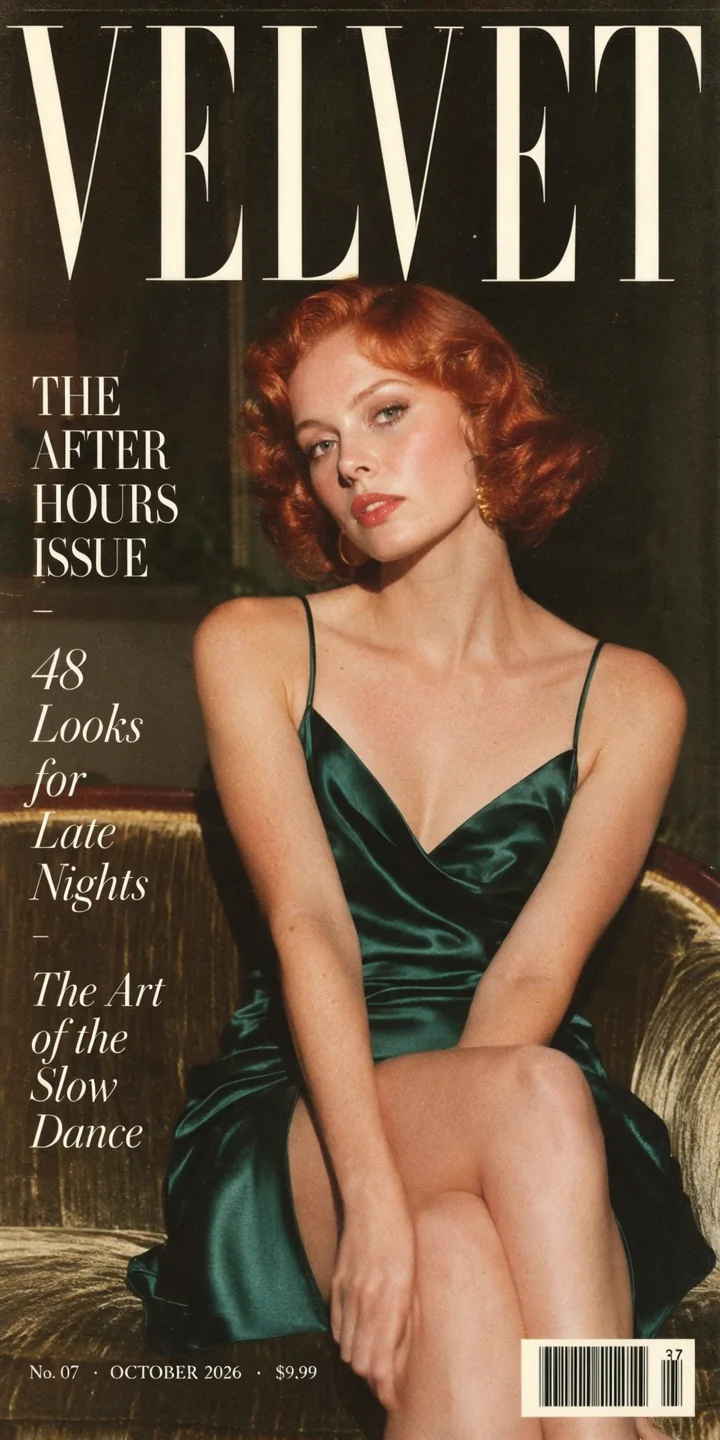
Ein Filmplakat mit Besetzung und Regie, ein Magazincover mit drei Titelzeilen und einer Preiszeile, ein Parfum-Schriftzug und ein Neon-Motelschild waren in unseren Tests alle richtig geschrieben. OpenMOSS meldet dieselbe Stärke für englischen und chinesischen Text.
Prompts, die bis zum Ende gelesen werden
Der Prompt nimmt bis zu 12.000 Zeichen. Ein roter Regenschirm, der nur im letzten Satz eines Prompts mit 13.000 Zeichen erwähnt war, wurde unten links gezeichnet.
JSON-Layout
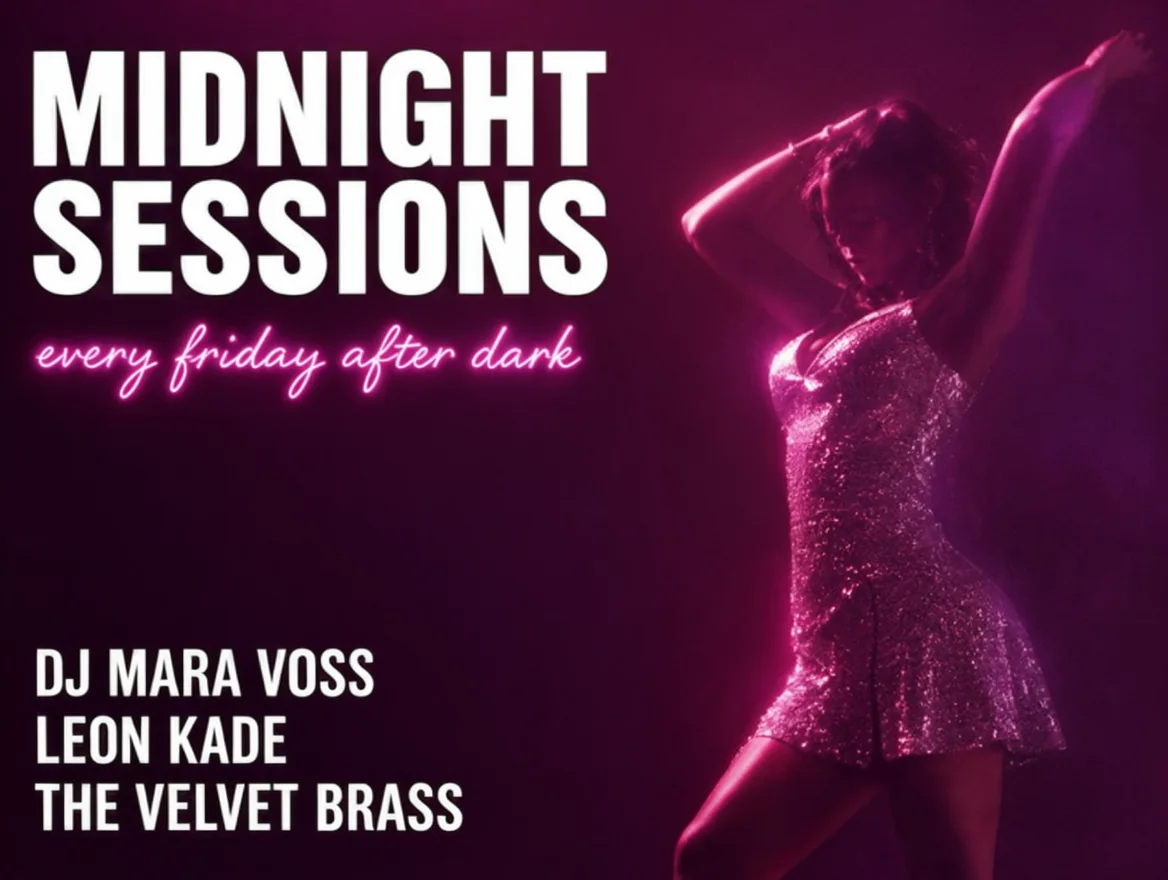
Übergeben Sie ein Layout-JSON als Prompt, und jedes Textelement oder Objekt bekommt eine eigene Box. Ein Club-Flyer mit Titel, Skript-Untertitel, Lineup und Tänzerin setzte jedes Element dorthin, wo seine Box war. OpenMOSS kennzeichnet das Format als experimentell.
Fünfzehn Formate, drei Stufen
Von 1:3 bis 3:1 in 1k, 1.5k oder 2k. Ein 16:9-Bild in 1.5k kam mit 2048 x 1152 zurück, ein 9:16-Bild in 2k mit 1536 x 2720.
Unzensiert
In unseren Tests wurde auf keiner Stufe von Mild bis Maximal etwas abgelehnt oder abgeschwächt. Weder beim Eingang noch beim Ausgang wird etwas gefiltert.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
prompt | Ja | Setzen Sie jeden Textteil in Anführungszeichen und sagen Sie, wohin er gehört. Bis zu 12.000 Zeichen; Englisch funktioniert gut. mindestens 1 Zeichen · höchstens 12000 Zeichen |
aspect_ratio | Nein | 15 Formate von 1:3 bis 3:1; standardmäßig 1:1. Bei 1k ist 4:3 gleich 1168 x 880 und 16:9 gleich 1360 x 768. |
resolution | Nein | 1k (etwa 1 Megapixel, Standard), 1.5k oder 2k. Die Stufe bestimmt den Preis; ein Querformatbild in 1.5k kam mit 2048 x 1152 zurück. |
output_format | Nein | Standardmäßig JPEG, alternativ PNG oder WebP. Das Format ändert den Preis nicht. |
seed | Nein | Hält Bilder vergleichbar, während Sie jeweils einen Satz ändern. Er verspricht keine identischen Pixel. |
Preis
Abgerechnet pro Bild nach Auflösungsstufe (1k, 1.5k oder 2k). Seitenverhältnis und Ausgabeformat ändern den Preis nicht. Fehlgeschlagene Anfragen werden nicht berechnet.
| Spezifikation | Preis |
|---|---|
| $0.024 / Bild |
| $0.048 / Bild |
| $0.096 / Bild |
Anwendungsfälle
Plakate, Cover und Anzeigen
Titel, Tagline, Namen von Besetzung und Regie sowie ein Datum in einem Bild oder eine Kopfzeile mit Titelzeilen und Preiszeile. Setzen Sie jede Zeichenfolge in Anführungszeichen und platzieren Sie sie.
Schilder, Banner und Flyer
Neonbeschriftung, Event-Flyer und breite Banner, bei denen die Worte das Bild tragen. Nutzen Sie das JSON-Layout, wenn Sie für jeden Block eine Box wollen.
Lange Briefings in einer Anfrage
Fügen Sie das vollständige Briefing ein, mit Szene, Kleidung, Licht, Objektiv und jeder Zeile Text, statt es auf ein paar Sätze zu kürzen.
Prompt-Leitfaden und Praxistipps
Den Text in Anführungszeichen setzen, dann platzieren
Schreiben Sie „LAST CALL AT THE MERIDIAN“ in Anführungszeichen und sagen Sie dann, wohin er gehört und wie er aussieht: goldene Serifen-Großbuchstaben im unteren Drittel. Setzen Sie Zeilenumbrüche innerhalb der Anführungszeichen, wo eine Zeile umbrechen soll.
Ein JSON-Layout schreiben
Der Prompt ist ein JSON-Objekt mit einem summary (einer caption für das ganze Bild) und einer items-Liste. Jedes Element hat ein label (text oder object), eine caption, optionalen text und eine bbox. Setzen Sie bbox_format auf yxyx und bbox_coord_space auf abs_centralized: Boxen sind [oben, links, unten, rechts] in Pixeln ab der Bildmitte, wobei x nach rechts und y nach unten wächst.
Auf der echten Größe rechnen
Ein 4:3-Bild in 1k ist 1168 x 880, also läuft x von -584 bis 584 und y von -440 bis 440. Eine Box [-400, -560, -140, 40] ist ein Titelbereich oben links. Schlagen Sie die Ausgabegröße für Ihr Verhältnis und Ihre Stufe nach, bevor Sie Boxen setzen.
Einen Ersatz-Seed bereithalten
Buchstaben kleben gelegentlich zusammen; ein Parfum-Durchlauf las NOIIR statt NOIR. Ändern Sie den Seed und starten Sie den Lauf erneut. Der Seed hält Läufe vergleichbar, verspricht aber keine identischen Pixel.
Alles als Sätze beschreiben
Es gibt keinen Negative Prompt und keine Guidance. Beschreiben Sie Motiv, Kleidung, Ort, Licht und Objektiv in Sätzen, und halten Sie die Textzeichenfolgen kurz genug, dass sie bei der gewählten Größe lesbar bleiben.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "openmoss/moss-image/text-to-image",
  "input": {
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.