Quizá empezaste con Replicate porque un modelo funcionando quedaba a una llamada de API. Ahora tu producto necesita un editor de imágenes, una entrega fiable de los archivos, otra unidad de precio o tu propio checkpoint. Son motivos distintos para cambiar y llevan a alternativas distintas.
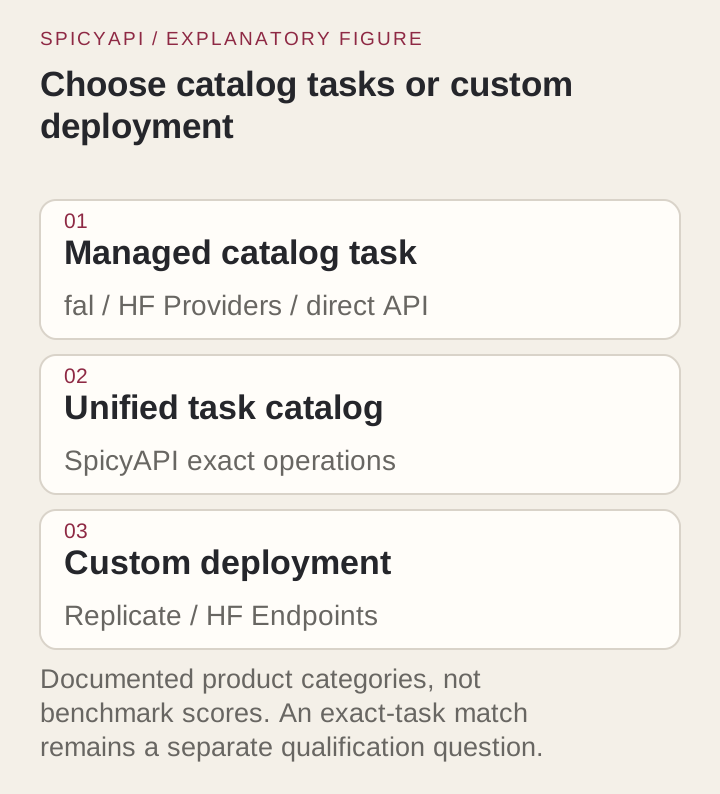
Para modelos multimedia listos para usar, incluye en tu lista fal, Hugging Face Inference Providers, las API directas de los creadores de modelos y SpicyAPI. Para tus propios pesos o tu propio pipeline de inferencia, compara despliegues gestionados o workers autoalojados. Replicate ya ofrece ambas cosas, predicciones alojadas y despliegues propios, así que primero identifica qué parte quieres sustituir.
La lista corta: ¿qué alternativa encaja con tu caso?
| Lo que necesitas | Empieza por | Por qué encaja | Principal contrapartida |
|---|---|---|---|
| Un modelo alojado de imagen, vídeo o audio | fal | Endpoints de modelos gestionados, con entradas y precios propios de cada modelo | Aun así necesitas un endpoint que admita justo tu operación |
| Modelos abiertos y varios proveedores alojados entre los que elegir | Hugging Face Inference Providers | Acceso a través del Hub y una superficie de cliente común | Una solicitud enrutada puede acabar en el propio Replicate o en fal; la interfaz y el backend son decisiones distintas |
| Funciones nativas de una familia de modelos | API directa del creador del modelo | Relación directa con el creador del modelo | Clientes, facturación y reglas de entrega independientes para cada creador |
| Tareas de imagen y vídeo sin censura compatibles | SpicyAPI | Las páginas de modelo muestran la operación, los controles creativos y el precio para el cliente | Una API de catálogo no despliega un checkpoint privado cualquiera |
| Tu propio checkpoint, entorno de ejecución o servicio privado | Despliegues de Replicate o Hugging Face Inference Endpoints | Control del despliegue y de la capacidad | El empaquetado, las decisiones de escalado y la capacidad ociosa influyen en la factura |
| Tu propia pila de servicio | Workers personalizados de Runpod o una GPU autoalojada | Control sobre los pesos y la implementación de la inferencia | El worker, la cola, las actualizaciones y la recuperación corren de tu cuenta |
Los workers de Runpod son una opción para ejecutar tu propio handler: los workers activos permanecen listos, mientras que los workers flex pueden escalar a cero y volver a arrancar cuando llega un trabajo. Aportan la infraestructura de ejecución; tú aportas el handler del modelo y las operaciones que admite.
Una aplicación de fotos de producto puede necesitar tres operaciones: editar una botella subida, quitar su fondo y animar el resultado aprobado. Un catálogo amplio de modelos solo sirve si ofrece esas operaciones. A la inversa, un equipo de investigación que necesita un checkpoint privado gana poco con un endpoint de imágenes más barato que no puede cargar sus pesos.
El precio de Replicate no siempre es por tiempo de GPU
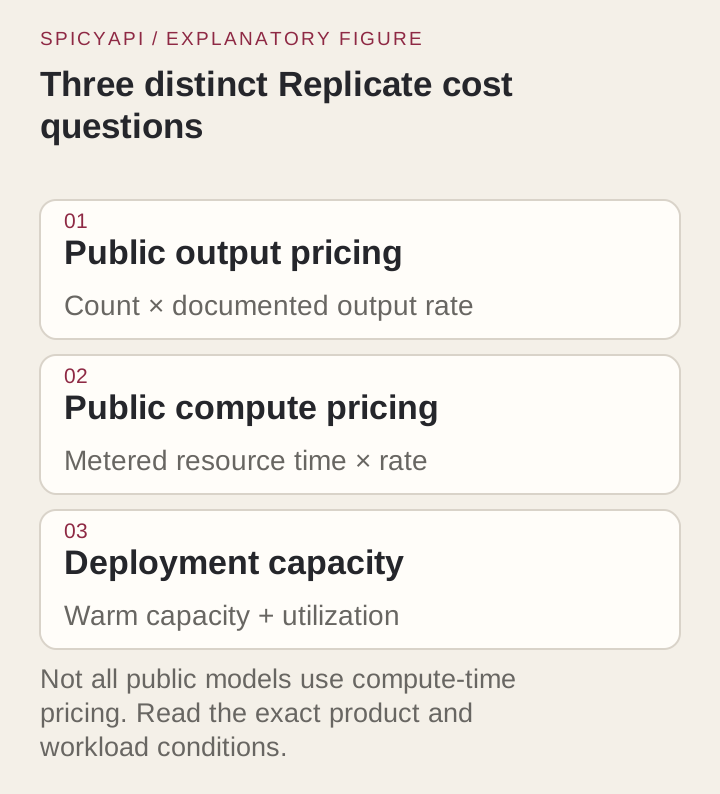
Replicate admite dos familias de facturación. Algunos modelos cobran por tiempo de cómputo; otros, por entradas o salidas. La documentación de facturación distingue además los modelos públicos de los privados y de los despliegues:
- Modelos con precio por salida: presupuesta a partir de la unidad publicada de imagen, vídeo u otro tipo, y de sus condiciones.
- Modelos públicos con precio por cómputo: el tiempo de procesamiento activo determina el cargo; la preparación y el tiempo ocioso no se facturan.
- Modelos privados y despliegues: pueden cobrarse la preparación, el tiempo activo y el tiempo ocioso. Mantener un worker en caliente compra capacidad aunque esté esperando.
Esto importa si el motivo para irte es un coste impredecible. Pasar en Replicate de un modelo de la comunidad con precio por cómputo a un modelo oficial con precio por salida puede resolver el problema sin cambiar de plataforma. Si el motivo es que falta un control de edición, cambiar el modo de facturación no lo solucionará.
fal: un candidato sólido para endpoints multimedia gestionados
fal merece un lugar en la lista cuando quieres un modelo multimedia listo para llamar en lugar de operar su GPU. Compara la superficie de entrada del endpoint elegido con tu aplicación: un modelo de texto a imagen, un editor de imágenes y un modelo de imagen a vídeo son operaciones distintas, aunque compartan nombre de familia.
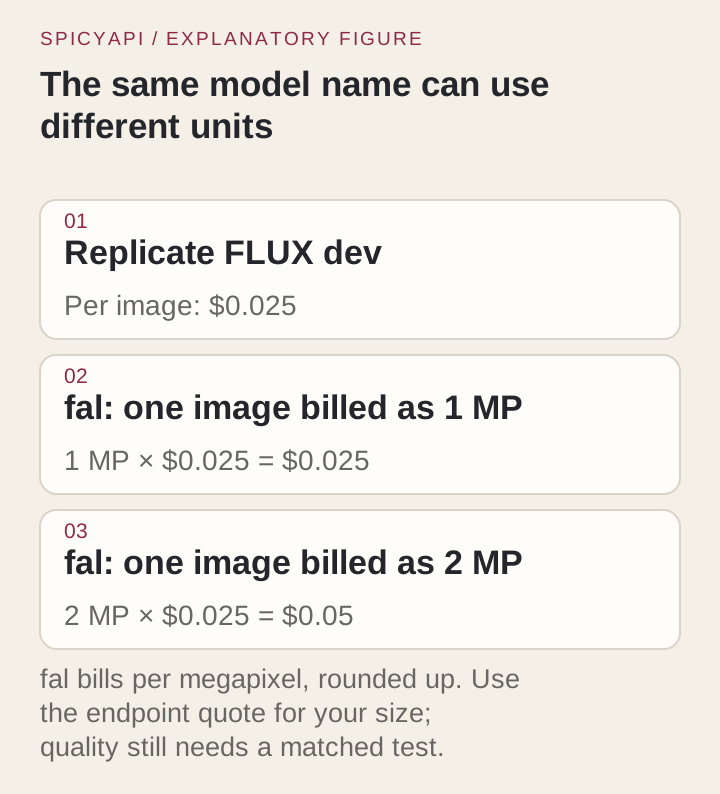
Su endpoint de FLUX.1 dev ilustra por qué la unidad de facturación merece atención. La página de FLUX.1 dev de fal indica $0.025 por megapíxel, redondeado al siguiente megapíxel entero. Eso es distinto de un precio fijo por imagen.
- Elígelo cuando: el endpoint gestionado tenga el modelo y los controles que necesitas, y su unidad publicada encaje con tu forma de generar.
- Busca en otra parte cuando: tu flujo de trabajo dependa de un checkpoint privado o de un grafo de inferencia personalizado que el endpoint elegido no pueda ejecutar.
En una aplicación existente, la migración es mucho más que cambiar el nombre de un campo de la solicitud. Conserva la distinción entre un archivo generado y un archivo descargable y retenido. Tu backend debe completar el paso de ingesta del archivo antes de decirle al cliente que su imagen o vídeo está guardado de forma segura.
Hugging Face: elige entre enrutamiento de proveedores y despliegue
Hugging Face tiene dos productos relevantes. Inference Providers enruta las llamadas a modelos compatibles hacia los proveedores participantes. Inference Endpoints ofrece un despliegue dedicado. Elige entre ellos según necesites un modelo alojado o tu propio servicio en ejecución.
El enrutamiento de proveedores puede facilitar la exploración de un flujo con modelos abiertos. Sin embargo, Replicate es en sí un proveedor de Hugging Face, y fal es otro. Llamar a través de un cliente de Hugging Face no aleja necesariamente la ejecución de Replicate. Si la migración debe cambiar el proveedor de servicio, elige también el backend, no solo el modelo.
Para las llamadas enrutadas, la guía de precios de Hugging Face distingue entre facturar a través de Hugging Face y usar tu propia clave de proveedor. En este último caso la facturación se queda con ese proveedor. Un pequeño crédito gratuito sirve para explorar; no es un presupuesto de producción.
Para un checkpoint propio, la economía de un endpoint dedicado incluye el hardware y el tiempo de ejecución facturado. Los precios de Inference Endpoints son tarifas por hora, facturadas por minuto mientras los endpoints se inicializan o se ejecutan.
- Elige Providers cuando: quieras modelos abiertos compatibles a través de un cliente común y puedas seleccionar un backend adecuado.
- Elige Endpoints cuando: necesites el despliegue de un modelo concreto en lugar de una tarea fija del catálogo.
API directas del creador del modelo: útiles cuando una familia impulsa el producto
Una API directa del creador del modelo merece consideración cuando una función nativa importa más que la amplitud del catálogo. Algunos ejemplos son el manejo de imágenes de referencia, la edición propia de un modelo o una versión disponible solo en el servicio del propio creador.
Un producto construido en torno a una sola familia puede justificar esa integración aparte. Un producto que combina imágenes fijas, vídeo, recortes y voz puede acumular varios clientes, cuentas y vías de facturación. El coste práctico es entonces mantener esas integraciones junto a las llamadas a los modelos.
Elige el acceso directo para una capacidad nativa concreta. Elige un proveedor de catálogo cuando te resulten más útiles la cobertura de tareas que ofrece y una sola integración en la aplicación.
SpicyAPI: tareas multimedia compatibles, incluidos flujos sin censura
SpicyAPI encaja con aplicaciones que necesitan operaciones de imagen y vídeo compatibles, con un precio publicado por tarea. Empieza por el catálogo de API de imagen o el catálogo de API de vídeo y elige después el modo que corresponda a tu material de partida.
Por ejemplo, una imagen de producto subida necesita un editor, mientras que una imagen fija aprobada necesita una tarea de imagen a vídeo. Background Remover ofrece una operación de recorte de una sola imagen. Wan 2.2 Spicy de imagen a vídeo ofrece clips de cinco u ocho segundos con una imagen final opcional. Cinco segundos cuestan $0.095 a 480p o $0.19 a 720p. Quitar el fondo cuesta $0.0048 por imagen. Son operaciones concretas del catálogo; no son alojamiento de modelos privados arbitrarios. Para probar una, abre su página de modelo, usa la pestaña Playground y pulsa Run model.
La tarea FLUX.1 dev LoRA de SpicyAPI cuesta $0.018 por imagen. Una tarea FLUX.1 dev LoRA no es automáticamente un sustituto idéntico de una solicitud FLUX.1 dev sin más. Una tarea con adaptador puede ser la elección adecuada para un estilo, pero la compatibilidad y sus campos de entrada dependen de esa ruta concreta.
- Elige SpicyAPI cuando: sus tareas compatibles cubran el flujo de imagen, edición o vídeo del producto, incluidos los modelos sin censura que necesitas.
- Conserva un proveedor de despliegue cuando: tu aplicación necesite sus propios pesos, código personalizado o una configuración de hardware propia.
Ejemplo práctico: FLUX.1 dev, precio por imagen y precio por megapíxel
La página de precios de Replicate indica FLUX dev a $0.025 por imagen. fal indica FLUX.1 dev a $0.025 por megapíxel, redondeando hacia arriba. Con esas unidades publicadas:
| Salida solicitada | Cálculo por imagen en Replicate | Cálculo por megapíxel en fal | Qué cambia la factura |
|---|---|---|---|
| Una imagen facturada como 1 MP | $0.025 | 1 MP × $0.025 = $0.025 | Las unidades coinciden por casualidad |
| Una imagen facturada como 2 MP | $0.025 | 2 MP × $0.025 = $0.050 | Un tamaño facturado mayor |
Usa la cantidad de megapíxeles que facture el endpoint en lugar de suponer que una imagen cuadrada de 1024 se redondea a dos unidades. Un fotograma más pequeño no es necesariamente un ahorro si tu entrega necesita el más grande, y un fotograma mayor no es necesariamente útil si vas a recortar la mayor parte.
Para una carga de trabajo de vídeo, sustituye los píxeles por la unidad que realmente compras. Los segundos de vídeo terminado y los segundos de procesamiento de GPU son cantidades distintas. Un clip entregado de cinco segundos puede requerir bastante más tiempo de cómputo, así que comparar dos etiquetas de dólares por segundo puede inducir a error.
Cuándo es mejor decisión quedarse con Replicate
Quedarse con Replicate es razonable cuando sus controles de despliegue resuelven un requisito que la alternativa eliminaría. Un checkpoint privado, una implementación de modelo fijada o un servicio en caliente pueden pesar más que un precio de imagen anunciado más bajo.
Antes de migrar, separa tres casos:
- El modelo no cumple el encargo. Plantéate otro modelo u otra versión; cambiar solo el host puede conservar la misma debilidad.
- El contrato de servicio resulta incómodo. Otra API de tareas, otra unidad de facturación u otra regla de retención pueden resolver el problema de la aplicación.
- La aplicación pierde resultados correctos. Arregla la ingesta de archivos; cambiar de proveedor no recupera un archivo sin guardar.
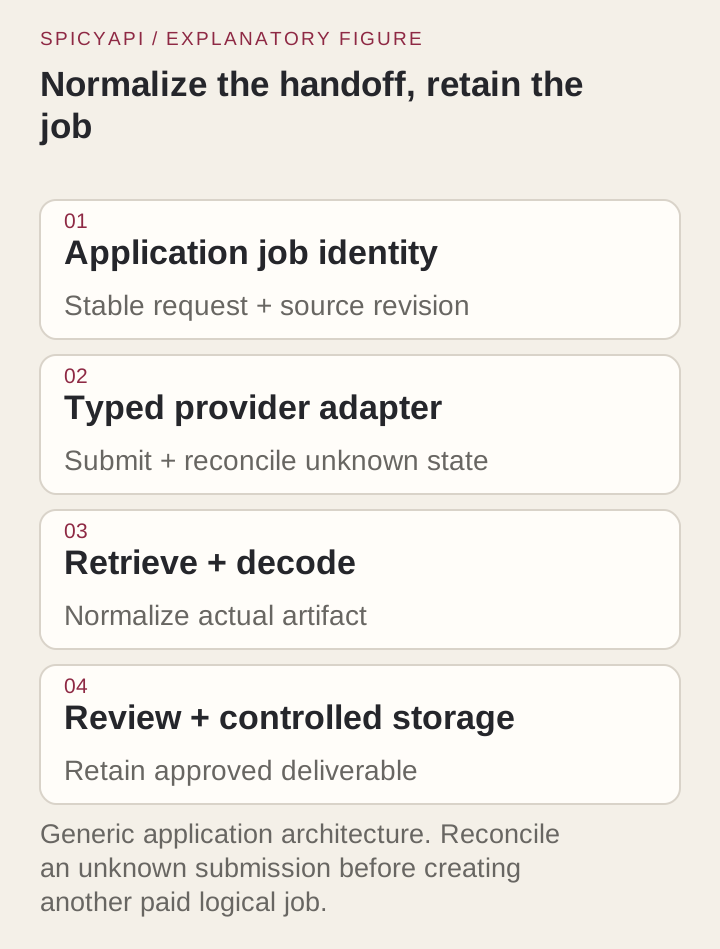
Migra el contrato de los archivos, no solo la URL de la solicitud
La documentación de retención de datos de Replicate concreta la diferencia: las predicciones creadas mediante su API pierden por defecto sus entradas, salidas, archivos y registros tras una hora, mientras que las creadas desde la web se conservan indefinidamente. Por eso, una biblioteca de cara al cliente debe descargar con rapidez los resultados de la API a un almacenamiento que controle la aplicación.
Un registro de migración útil contiene:
- Entrada creativa: prompt, archivos de referencia y su función, dimensiones solicitadas y versión del modelo.
- Identidad de la tarea: el ID de trabajo de tu aplicación y el ID de tarea del proveedor.
- Archivo entregado: archivo de imagen o vídeo, dimensiones o duración, formato y ubicación de almacenamiento.
- Estado de recuperación: si el envío, la generación y la descarga se completaron.
Conserva los archivos aceptados en almacenamiento permanente con independencia del cliente del proveedor. Si la nueva ruta falla, el cliente debería seguir teniendo los archivos de ayer y la aplicación debería saber qué trabajos están completos.
Una pequeña prueba de migración con una decisión clara
Para una aplicación de fotos de producto, compara tres operaciones: una edición que conserve la etiqueta de la botella, un vídeo que anime el fotograma inicial aprobado y un recorte con bordes transparentes limpios. Cuenta los intentos y el trabajo de acabado necesarios para cada archivo aceptado; un presupuesto más bajo puede perder su ventaja tras las repeticiones.
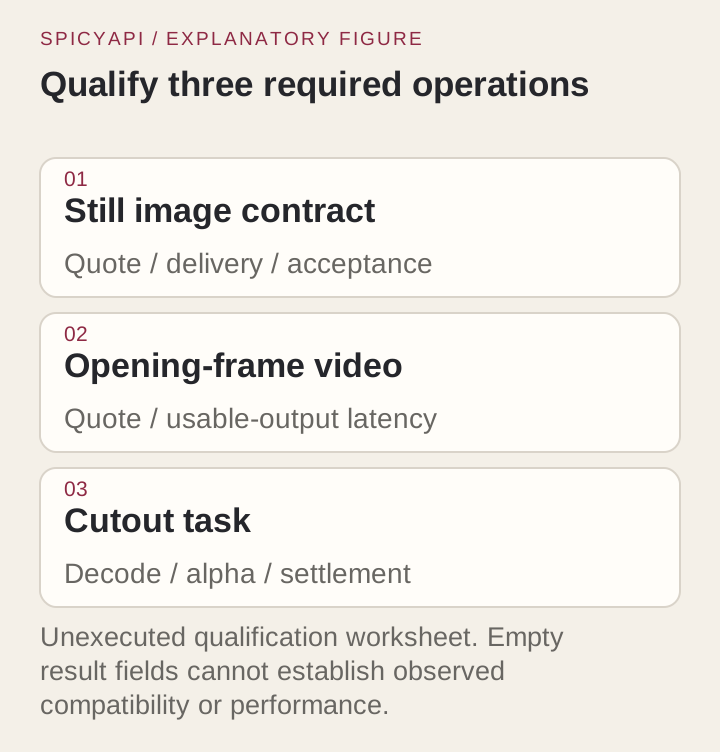
Despliega una operación cada vez. Mantén disponible el proveedor actual hasta que la nueva ruta pueda enviar, recuperar y almacenar un archivo. Si se pierde una respuesta tras el envío, concilia la tarea existente antes de crear otro trabajo de pago.
Preguntas frecuentes
¿Es gratis Replicate?
Replicate ofrece un acceso de prueba limitado a modelos seleccionados antes de exigir facturación. Para un uso continuado en producción, presupuesta a partir de la unidad publicada del modelo concreto. Los créditos gratuitos de una alternativa pueden cubrir la exploración, pero no deberían guiar la elección de proveedor a largo plazo.
¿Cuál es una buena alternativa a Replicate para imágenes y vídeo?
fal es un candidato para endpoints multimedia gestionados; Hugging Face Inference Providers ofrece modelos compatibles con enrutamiento de proveedores; SpicyAPI ofrece tareas de imagen y vídeo compatibles, incluidos flujos sin censura. Elige la ruta que tenga la operación de entrada y los controles de entrega que necesitas. Para pesos propios, usa un servicio de despliegue.
¿Es Hugging Face una alternativa independiente a Replicate?
Puede serlo, según el backend. Hugging Face también enruta hacia Replicate, así que cambiar solo el cliente puede dejar igual al proveedor de servicio. Un Hugging Face Inference Endpoint dedicado es un producto de despliegue distinto.
¿Es más fácil presupuestar un precio por imagen que el tiempo de GPU?
Normalmente sí, con una configuración de salida estable. Pero las dimensiones, los ajustes de calidad o las pasadas múltiples pueden cambiar la cantidad que compras. El precio por tiempo de GPU resulta más útil cuando también conoces el tiempo de ejecución cobrado y la utilización. Compara el trabajo completo, no solo la etiqueta de la unidad.
La decisión
Para una función multimedia estándar, incluye en tu lista las API gestionadas que admitan sus entradas y salidas reales y compara después el precio completo del trabajo. Para pesos privados o inferencia personalizada, incluye opciones de despliegue. Quédate con Replicate cuando ya te dé el control que necesitas; cambia cuando una alternativa concreta elimine una limitación concreta sin hacerte perder una capacidad necesaria.