Du hast vielleicht mit Replicate angefangen, weil ein funktionierendes Modell nur einen API-Aufruf entfernt war. Jetzt braucht dein Produkt einen Bildeditor, eine verlässliche Übergabe der Assets, eine andere Preiseinheit oder deinen eigenen Checkpoint. Das sind verschiedene Gründe für einen Wechsel, und sie führen zu verschiedenen Alternativen.
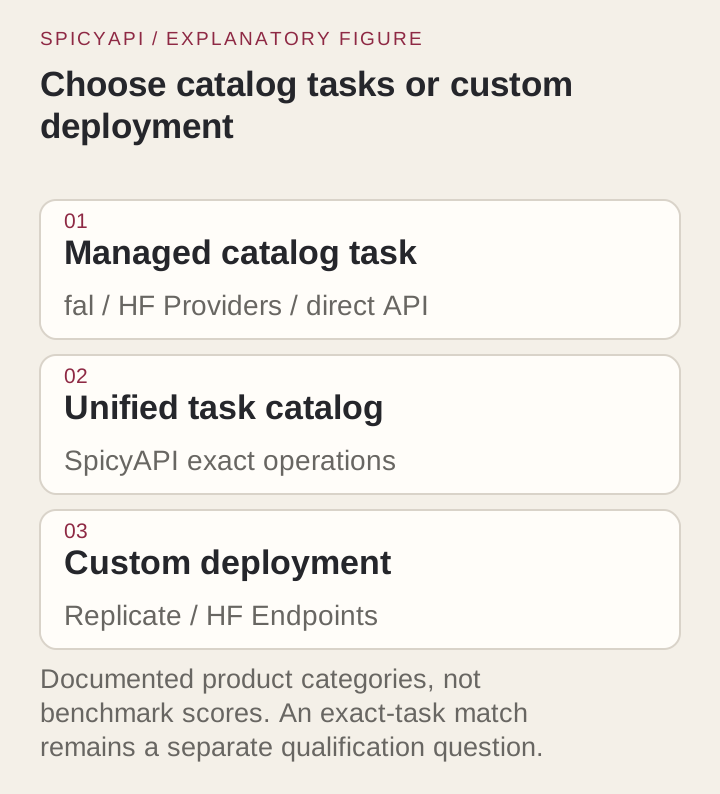
Für sofort nutzbare Medienmodelle kommen fal, Hugging Face Inference Providers, APIs direkt vom Modellanbieter und SpicyAPI in die engere Wahl. Für eigene Gewichte oder eine eigene Inferenz-Pipeline vergleichst Du verwaltete Deployments oder selbst gehostete Worker. Replicate bietet bereits beides, gehostete Predictions und eigene Deployments. Kläre deshalb zuerst, welchen Teil Du ersetzen willst.
Die Shortlist: Welche Alternative passt zu Deiner Aufgabe?
| Was Du brauchst | Starte mit | Warum es passt | Wichtigster Kompromiss |
|---|---|---|---|
| Ein gehostetes Bild-, Video- oder Audiomodell | fal | Verwaltete Modell-Endpunkte mit modellspezifischen Eingaben und Preisen | Du brauchst trotzdem einen Endpunkt, der genau Deine Operation unterstützt |
| Offene Modelle und die Wahl zwischen gehosteten Anbietern | Hugging Face Inference Providers | Zugriff über den Hub und eine gemeinsame Client-Oberfläche | Eine geroutete Anfrage kann selbst bei Replicate oder fal landen; Schnittstelle und Backend sind getrennte Entscheidungen |
| Native Funktionen einer Modellfamilie | API direkt vom Modellanbieter | Direkte Beziehung zum Modellanbieter | Eigene Clients, Abrechnung und Lieferregeln für jeden Anbieter |
| Unterstützte unzensierte Bild- und Videoaufgaben | SpicyAPI | Modellseiten zeigen Operation, kreative Steuerung und Kundenpreis | Eine Katalog-API stellt keinen beliebigen privaten Checkpoint bereit |
| Dein eigener Checkpoint, eigene Laufzeit oder ein privater Dienst | Replicate-Deployments oder Hugging Face Inference Endpoints | Steuerung von Deployment und Kapazität | Packaging, Skalierungsentscheidungen und ungenutzte Kapazität beeinflussen die Rechnung |
| Dein eigener Serving-Stack | Runpod Custom Worker oder eine selbst gehostete GPU | Kontrolle über Gewichte und Inferenz-Implementierung | Worker, Queue, Updates und Wiederherstellung liegen bei Dir |
Runpod-Worker sind eine Möglichkeit, einen eigenen Handler auszuführen: Aktive Worker bleiben bereit, Flex-Worker können auf null herunterskalieren und starten neu, sobald ein Job eintrifft. Sie liefern die Ausführungsinfrastruktur; Du lieferst den Modell-Handler und die Operationen, die er unterstützt.
Eine Produktfoto-Anwendung braucht womöglich drei Operationen: eine hochgeladene Flasche bearbeiten, ihren Hintergrund entfernen und das freigegebene Ergebnis animieren. Ein breiter Modellkatalog hilft nur, wenn er genau diese Operationen liefert. Umgekehrt hat ein Forschungsteam mit privatem Checkpoint wenig von einem günstigeren Bild-Endpunkt, der seine Gewichte nicht laden kann.
Replicate rechnet nicht immer nach GPU-Zeit ab
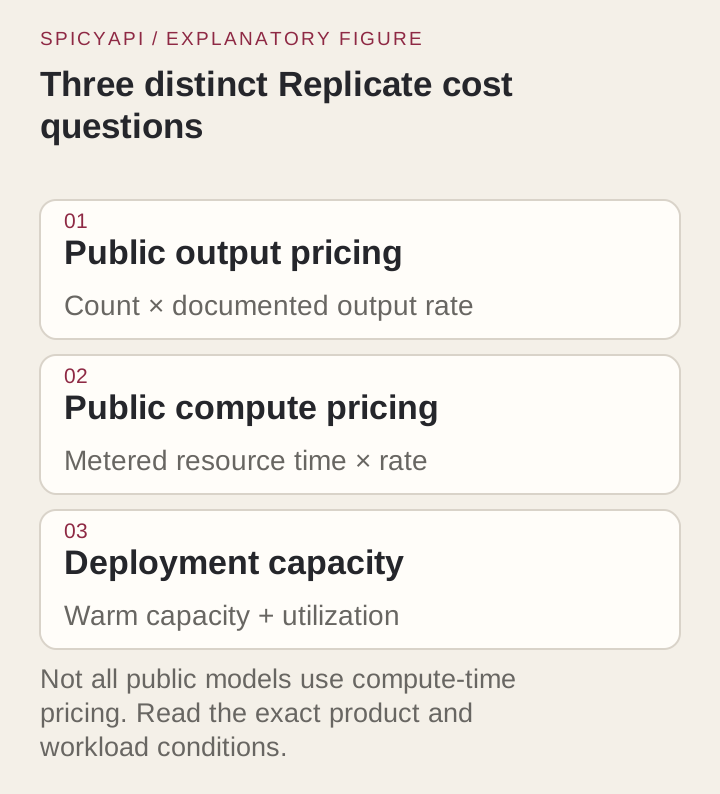
Replicate kennt zwei Abrechnungsfamilien. Manche Modelle berechnen Rechenzeit, andere Eingaben oder Ausgaben. Die Abrechnungsdokumentation unterscheidet außerdem öffentliche Modelle von privaten Modellen und Deployments:
- Nach Ausgabe abgerechnete Modelle: Plane mit dem veröffentlichten Bild-, Video- oder sonstigen Einheitspreis und seinen Bedingungen.
- Öffentliche, nach Rechenzeit abgerechnete Modelle: Die aktive Verarbeitungszeit bestimmt den Preis; Setup- und Leerlaufzeit werden nicht berechnet.
- Private Modelle und Deployments: Setup, aktive Zeit und Leerlaufzeit können alle berechnet werden. Einen Worker warmzuhalten kauft Kapazität, auch wenn er nur wartet.
Das ist wichtig, wenn unvorhersehbare Kosten der Grund für den Wechsel sind. Der Umstieg von einem nach Rechenzeit abgerechneten Community-Modell auf ein nach Ausgabe abgerechnetes offizielles Modell bei Replicate kann das Problem lösen, ohne die Plattform zu wechseln. Fehlt dagegen eine Bearbeitungsfunktion, löst ein anderer Abrechnungsmodus nichts.
fal: ein starker Kandidat für verwaltete Medien-Endpunkte
fal gehört auf die Shortlist, wenn Du ein sofort aufrufbares Medienmodell willst, statt seine GPU selbst zu betreiben. Vergleiche die Eingabeoberfläche des gewählten Endpunkts mit Deiner Anwendung: Ein Text-zu-Bild-Modell, ein Bildeditor und ein Bild-zu-Video-Modell sind verschiedene Operationen, auch wenn sie sich einen Familiennamen teilen.
Der FLUX.1-dev-Endpunkt zeigt, warum die Abrechnungseinheit Aufmerksamkeit verdient. Die FLUX.1-dev-Seite von fal nennt $0.025 pro Megapixel, aufgerundet auf das nächste volle Megapixel. Das ist etwas anderes als ein pauschaler Preis pro Bild.
- Wähle ihn, wenn: der verwaltete Endpunkt das Modell und die Steuerung bietet, die Du brauchst, und seine veröffentlichte Einheit zu Deiner Art der Generierung passt.
- Schau woanders, wenn: Dein Workflow einen privaten Checkpoint oder einen eigenen Inferenz-Graphen voraussetzt, den der gewählte Endpunkt nicht ausführen kann.
Für eine bestehende Anwendung ist die Migration mehr als ein umbenanntes Request-Feld. Erhalte die Unterscheidung zwischen einem generierten Asset und einer herunterladbaren, aufbewahrten Datei. Dein Backend sollte den Schritt der Asset-Übernahme abschließen, bevor es dem Kunden mitteilt, sein Bild oder Video sei sicher gespeichert.
Hugging Face: Provider-Routing oder Deployment
Hugging Face hat zwei relevante Produkte. Inference Providers leitet unterstützte Modellaufrufe an teilnehmende Anbieter weiter. Inference Endpoints stellt ein dediziertes Deployment bereit. Entscheide anhand der Frage, ob Du ein gehostetes Modell oder Deinen eigenen laufenden Dienst brauchst.
Provider-Routing kann es leichter machen, einen Workflow mit offenen Modellen zu erkunden. Allerdings ist Replicate selbst ein Hugging-Face-Provider, und fal ist ein weiterer. Ein Aufruf über einen Hugging-Face-Client verlagert die Ausführung nicht zwingend weg von Replicate. Wähle neben dem Modell auch das Backend, wenn die Migration den Serving-Anbieter ändern soll.
Bei gerouteten Aufrufen unterscheidet die Preisübersicht von Hugging Face zwischen der Abrechnung über Hugging Face und der Nutzung des eigenen Provider-Schlüssels. Im zweiten Fall bleibt die Abrechnung beim jeweiligen Provider. Ein kleines Gratisguthaben hilft beim Ausprobieren; ein Produktionsbudget ist es nicht.
Für einen eigenen Checkpoint gehören zur Wirtschaftlichkeit eines dedizierten Endpunkts Hardware und abgerechnete Laufzeit. Die Preise für Inference Endpoints sind Stundensätze, die minutengenau abgerechnet werden, solange Endpunkte initialisieren oder laufen.
- Wähle Providers, wenn: Du unterstützte offene Modelle über einen gemeinsamen Client nutzen willst und ein passendes Backend auswählen kannst.
- Wähle Endpoints, wenn: Du das Deployment eines bestimmten Modells brauchst statt einer festen Katalogaufgabe.
APIs direkt vom Modellanbieter: sinnvoll, wenn eine Familie das Produkt trägt
Eine API direkt vom Modellanbieter ist eine Überlegung wert, wenn eine native Funktion wichtiger ist als die Breite des Katalogs. Beispiele sind der Umgang mit Referenzbildern, modellspezifisches Editing oder ein Release, das nur über den eigenen Dienst des Anbieters verfügbar ist.
Ein Produkt rund um eine einzige Familie kann diese separate Integration rechtfertigen. Ein Produkt, das Standbilder, Video, Freisteller und Sprache kombiniert, sammelt womöglich mehrere Clients, Konten und Abrechnungswege an. Die praktischen Kosten bestehen dann darin, diese Integrationen neben den Modellaufrufen zu pflegen.
Wähle den direkten Zugang für eine konkrete native Fähigkeit. Wähle einen Katalog-Anbieter, wenn die gelieferte Aufgabenabdeckung und eine einzige Anwendungsintegration mehr nützen.
SpicyAPI: unterstützte Medien-Tasks, auch unzensierte Workflows
SpicyAPI passt zu Anwendungen, die unterstützte Bild- und Videooperationen mit einem veröffentlichten Task-Preis brauchen. Beginne mit dem Bild-API-Katalog oder dem Video-API-Katalog und wähle dann den Modus, der zu Deinem Ausgangsmaterial passt.
Ein hochgeladenes Produktbild braucht zum Beispiel einen Editor, ein freigegebenes Standbild dagegen einen Bild-zu-Video-Task. Background Remover bietet einen Freisteller für ein einzelnes Bild. Wan 2.2 Spicy Bild-zu-Video liefert Clips von fünf oder acht Sekunden mit optionalem Endbild. Fünf Sekunden kosten $0.095 bei 480p oder $0.19 bei 720p. Die Hintergrundentfernung kostet $0.0048 pro Bild. Das sind konkrete Katalogoperationen, kein Hosting beliebiger privater Modelle. Zum Ausprobieren öffnest Du die Modellseite, wechselst auf den Tab Playground und klickst auf Run model.
Der FLUX.1-dev-LoRA-Task von SpicyAPI kostet $0.018 pro Bild. Ein FLUX.1-dev-LoRA-Task ist nicht automatisch ein identischer Ersatz für eine einfache FLUX.1-dev-Anfrage. Ein Task mit Adapter kann für einen Stil die richtige Wahl sein, doch Kompatibilität und Eingabefelder gehören zu genau dieser Route.
- Wähle SpicyAPI, wenn: die unterstützten Tasks den Bild-, Bearbeitungs- oder Video-Workflow Deines Produkts abdecken, einschließlich der unzensierten Modelle, die Du brauchst.
- Behalte einen Deployment-Anbieter, wenn: Deine Anwendung eigene Gewichte, eigenen Code oder eine eigene Hardware-Konfiguration benötigt.
Rechenbeispiel: FLUX.1 dev, Bildpreis und Megapixelpreis
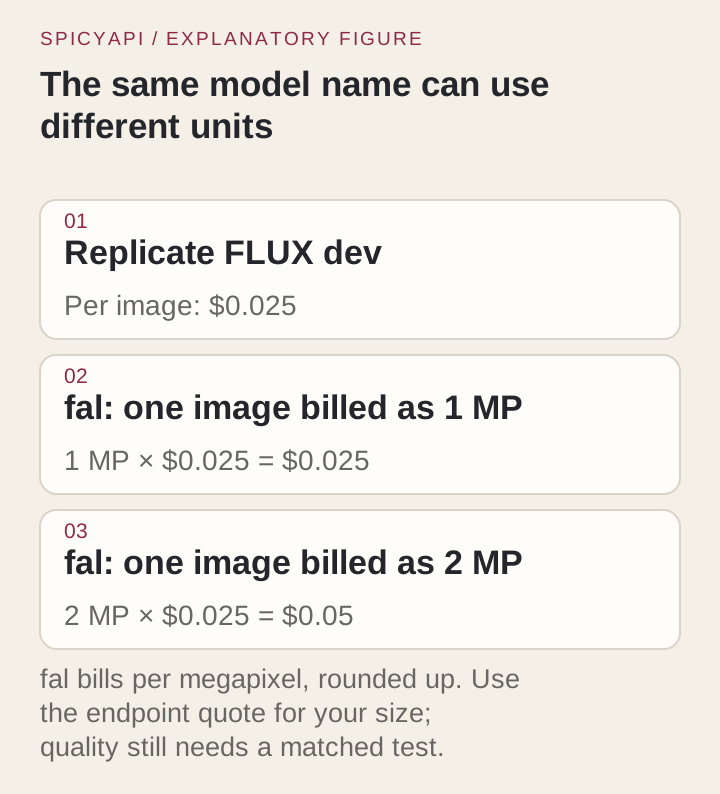
Die Preisseite von Replicate nennt FLUX dev mit $0.025 pro Bild. fal nennt FLUX.1 dev mit $0.025 pro Megapixel, aufgerundet. Mit diesen veröffentlichten Einheiten ergibt sich:
| Gewünschte Ausgabe | Replicate, Rechnung pro Bild | fal, Megapixel-Rechnung | Was die Rechnung verändert |
|---|---|---|---|
| Ein Bild, abgerechnet als 1 MP | $0.025 | 1 MP × $0.025 = $0.025 | Die Einheiten stimmen zufällig überein |
| Ein Bild, abgerechnet als 2 MP | $0.025 | 2 MP × $0.025 = $0.050 | Eine größere abgerechnete Größe |
Verwende die vom Endpunkt abgerechnete Megapixel-Menge, statt anzunehmen, dass ein quadratisches 1024er-Bild auf zwei Einheiten aufgerundet wird. Ein kleineres Bild spart nicht zwingend etwas, wenn Deine Auslieferung das größere braucht, und ein größeres ist nicht zwingend nützlich, wenn Du den Großteil davon abschneidest.
Bei einem Video-Workload ersetzt Du Pixel durch die jeweils gekaufte Einheit. Sekunden fertigen Videos und GPU-Verarbeitungssekunden sind verschiedene Größen. Ein ausgelieferter Fünf-Sekunden-Clip kann deutlich mehr Rechenzeit erfordern, deshalb kann der Vergleich zweier Dollar-pro-Sekunde-Angaben in die Irre führen.
Wann es besser ist, bei Replicate zu bleiben
Bei Replicate zu bleiben ist sinnvoll, wenn seine Deployment-Steuerung eine Anforderung erfüllt, die die Alternative entfallen ließe. Ein privater Checkpoint, eine festgelegte Modellimplementierung oder ein warmer Dienst kann wichtiger sein als ein niedrigerer ausgewiesener Bildpreis.
Unterscheide vor einer Migration drei Fälle:
- Das Modell verfehlt die Vorgabe. Erwäge ein anderes Modell oder eine andere Version; ein bloßer Wechsel des Hosts kann dieselbe Schwäche mitnehmen.
- Der Service-Vertrag ist unpraktisch. Eine andere Task-API, Abrechnungseinheit oder Aufbewahrungsregel kann das Anwendungsproblem lösen.
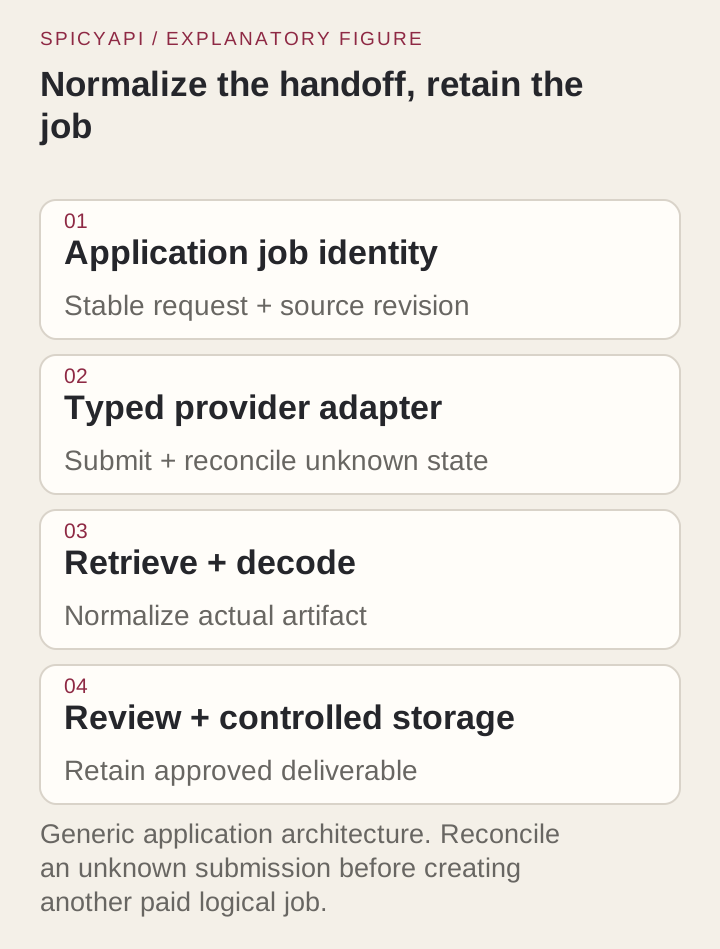
- Die Anwendung verliert erfolgreiche Ergebnisse. Behebe die Asset-Übernahme; ein Anbieterwechsel repariert keine ungespeicherte Datei.
Den Asset-Vertrag migrieren, nicht nur die Request-URL
Die Dokumentation zur Datenaufbewahrung von Replicate macht den Unterschied konkret: Über die API erstellte Predictions verlieren standardmäßig nach einer Stunde ihre Eingaben, Ausgaben, Dateien und Logs, während im Web erstellte Predictions unbegrenzt aufbewahrt werden. Eine kundenseitige Bibliothek sollte API-Ergebnisse deshalb zeitnah in einen Speicher herunterladen, den die Anwendung selbst kontrolliert.
Ein brauchbarer Migrationsdatensatz enthält:
- Kreative Eingabe: Prompt, Referenzdateien samt ihren Rollen, gewünschte Abmessungen und Modellversion.
- Task-Identität: die Job-ID Deiner Anwendung und die Task-ID des Anbieters.
- Gelieferte Assets: Bild- oder Videodatei, Abmessungen oder Dauer, Format und Speicherort.
- Wiederherstellungsstatus: ob Übermittlung, Generierung und Download abgeschlossen wurden.
Bewahre akzeptierte Dateien in dauerhaftem Speicher auf, unabhängig vom Client des Anbieters. Wenn die neue Route ausfällt, sollte der Kunde trotzdem die Assets von gestern haben, und die Anwendung sollte weiterhin wissen, welche Jobs abgeschlossen sind.
Ein kleiner Migrationstest mit klarer Entscheidung
Vergleiche bei einer Produktfoto-App drei Operationen: eine Bearbeitung, die das Flaschenetikett erhält, ein Video, das das freigegebene Startbild animiert, und einen Freisteller mit sauberen transparenten Kanten. Zähle die Versuche und den Nacharbeitsaufwand je akzeptierter Datei; ein niedrigeres Angebot kann seinen Vorteil durch Wiederholungen verlieren.
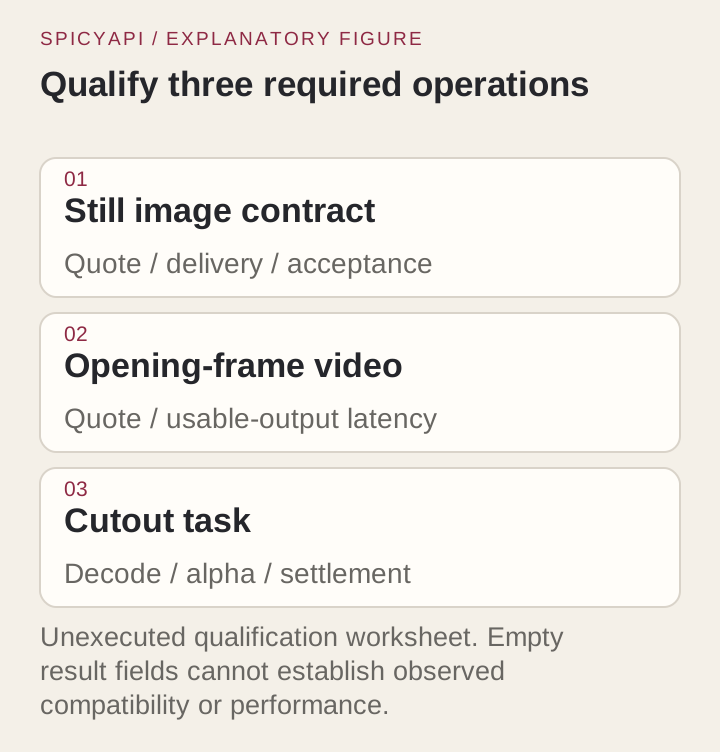
Führe jeweils eine Operation nach der anderen ein. Halte den bisherigen Anbieter bereit, bis der neue Pfad ein Asset übermitteln, abrufen und speichern kann. Geht nach der Übermittlung eine Antwort verloren, gleiche den bestehenden Task ab, bevor Du einen weiteren kostenpflichtigen Job anlegst.
Häufig gestellte Fragen
Ist Replicate kostenlos?
Replicate bietet für ausgewählte Modelle begrenzten Testzugang, bevor eine Abrechnung nötig wird. Plane für den dauerhaften Produktivbetrieb mit der veröffentlichten Einheit des jeweiligen Modells. Gratisguthaben einer Alternative kann das Ausprobieren abdecken, sollte aber nicht die langfristige Anbieterwahl bestimmen.
Was ist eine gute Alternative zu Replicate für Bilder und Video?
fal ist ein Kandidat für verwaltete Medien-Endpunkte; Hugging Face Inference Providers bietet unterstützte Modelle mit Provider-Routing; SpicyAPI bietet unterstützte Bild- und Video-Tasks, auch unzensierte Workflows. Wähle die Route, die die benötigte Eingabeoperation und die passenden Lieferfunktionen bietet. Für eigene Gewichte nutze einen Deployment-Dienst.
Ist Hugging Face eine unabhängige Alternative zu Replicate?
Das kann es sein, je nach Backend. Hugging Face leitet auch an Replicate weiter, deshalb kann ein Wechsel allein des Clients den Serving-Anbieter unverändert lassen. Ein dedizierter Hugging Face Inference Endpoint ist ein anderes Deployment-Produkt.
Lässt sich ein Preis pro Bild leichter budgetieren als GPU-Zeit?
Meistens ja, bei stabiler Ausgabekonfiguration. Aber Abmessungen, Qualitätseinstellungen oder mehrere Durchläufe können die gekaufte Menge verändern. GPU-Zeit-Preise sind aussagekräftiger, wenn Du auch die berechnete Laufzeit und die Auslastung kennst. Vergleiche den gesamten Job, nicht allein die Einheitsbezeichnung.
Die Entscheidung
Für eine Standard-Medienfunktion nimmst Du die verwalteten APIs in die engere Wahl, die ihre tatsächlichen Ein- und Ausgaben unterstützen, und vergleichst dann den Gesamtpreis des Jobs. Für private Gewichte oder eigene Inferenz wählst Du Deployment-Optionen. Bleibe bei Replicate, wenn es die benötigte Kontrolle schon bietet; wechsle, wenn eine bestimmte Alternative eine bestimmte Einschränkung beseitigt, ohne eine benötigte Fähigkeit zu verlieren.