Introducción
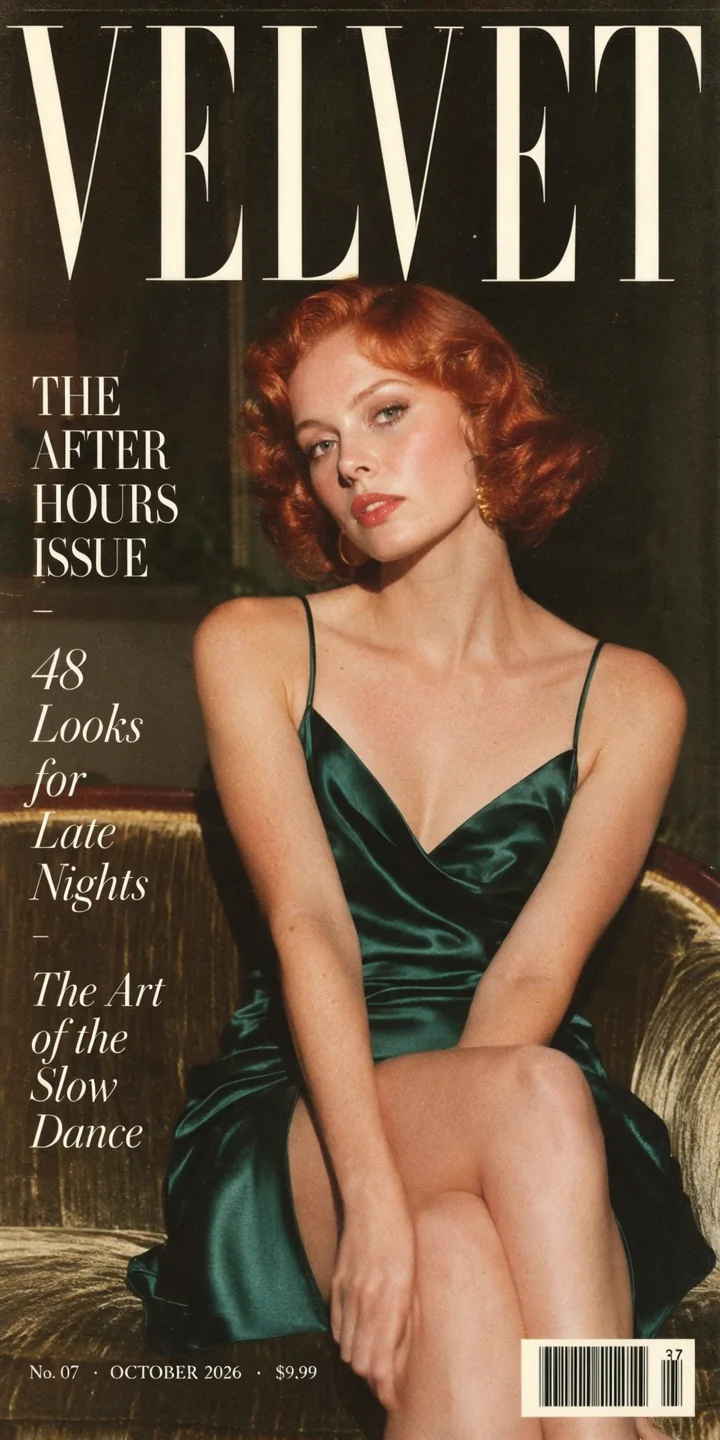
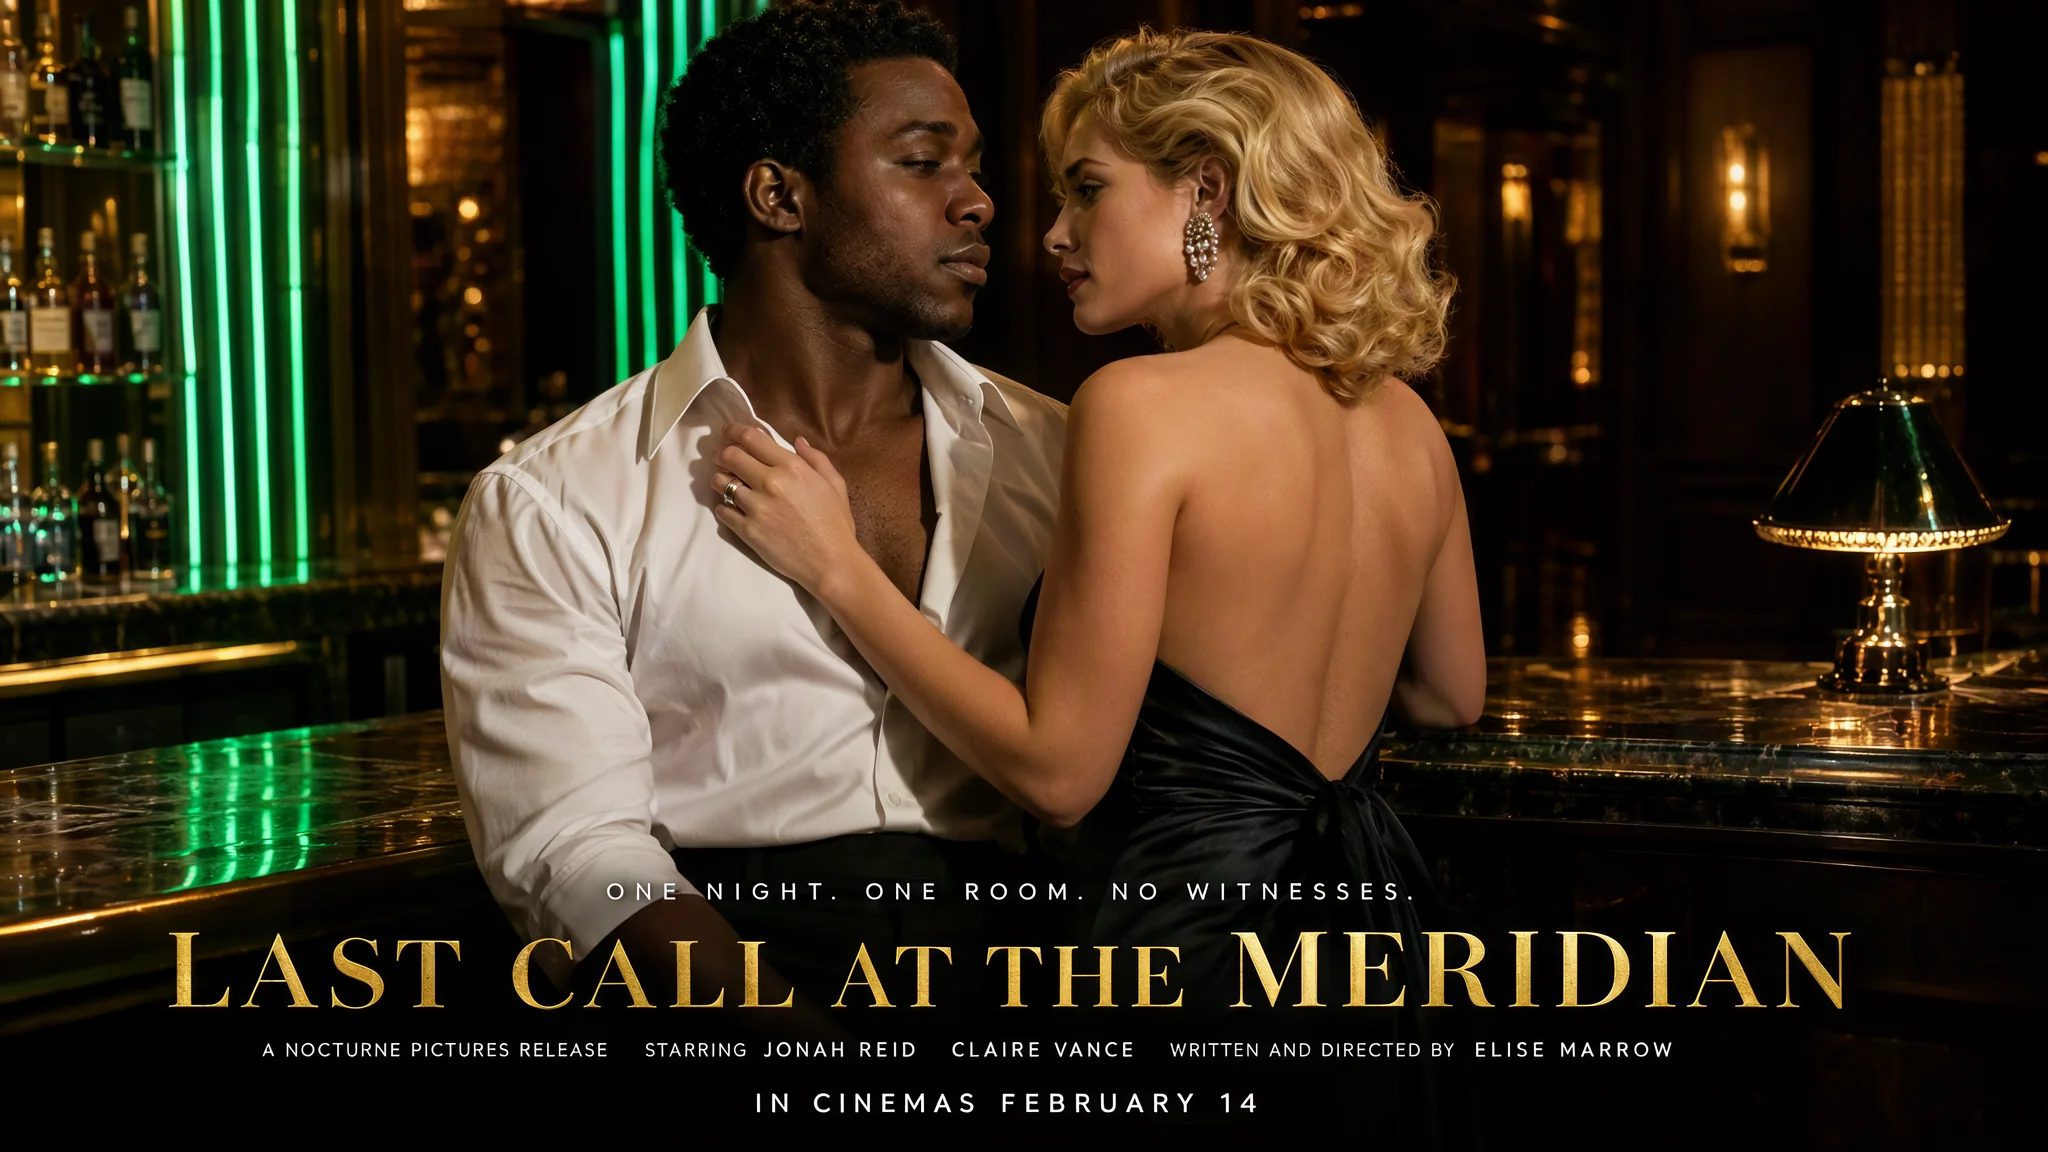
MOSS-Image Texto a imagen dibuja una imagen a partir de un prompt escrito en MOSS-Image, un transformer de difusión abierto de 5.000 millones de parámetros de OpenMOSS publicado con licencia Apache-2.0. Está pensado para imágenes con mucho texto exacto, como carteles, portadas de revista, anuncios y letreros. En nuestras pruebas también leyó prompts muy largos hasta el final, y las solicitudes NSFW salieron tal como se escribieron en todos los niveles de contenido, de Suave a Máximo. La plataforma no añade ningún filtro de contenido. Para tus propios archivos LoRA, usa MOSS-Image LoRA.
Elige un modelo según lo que necesitas
| Lo que necesitas | Modelo |
|---|---|
| texto exacto, prompts largos y layout JSON desde el modelo base | MOSS-Image Texto a imagen (estás aquí) |
| el mismo modelo más hasta tres LoRA tuyos | MOSS-Image LoRA Texto a imagen |
Funciones y aspectos destacados
Texto que sale tal como se escribió
Un cartel de cine con los nombres del reparto y del director, una portada de revista con tres titulares y una línea de precio, un logotipo de perfume y un letrero de neón de motel salieron bien escritos en nuestras pruebas. OpenMOSS informa de la misma calidad en inglés y en chino.
Prompts leídos hasta el final
El prompt admite hasta 12.000 caracteres. Un paraguas rojo mencionado solo en la última frase de un prompt de 13.000 caracteres se dibujó en la esquina inferior izquierda.
Layout JSON
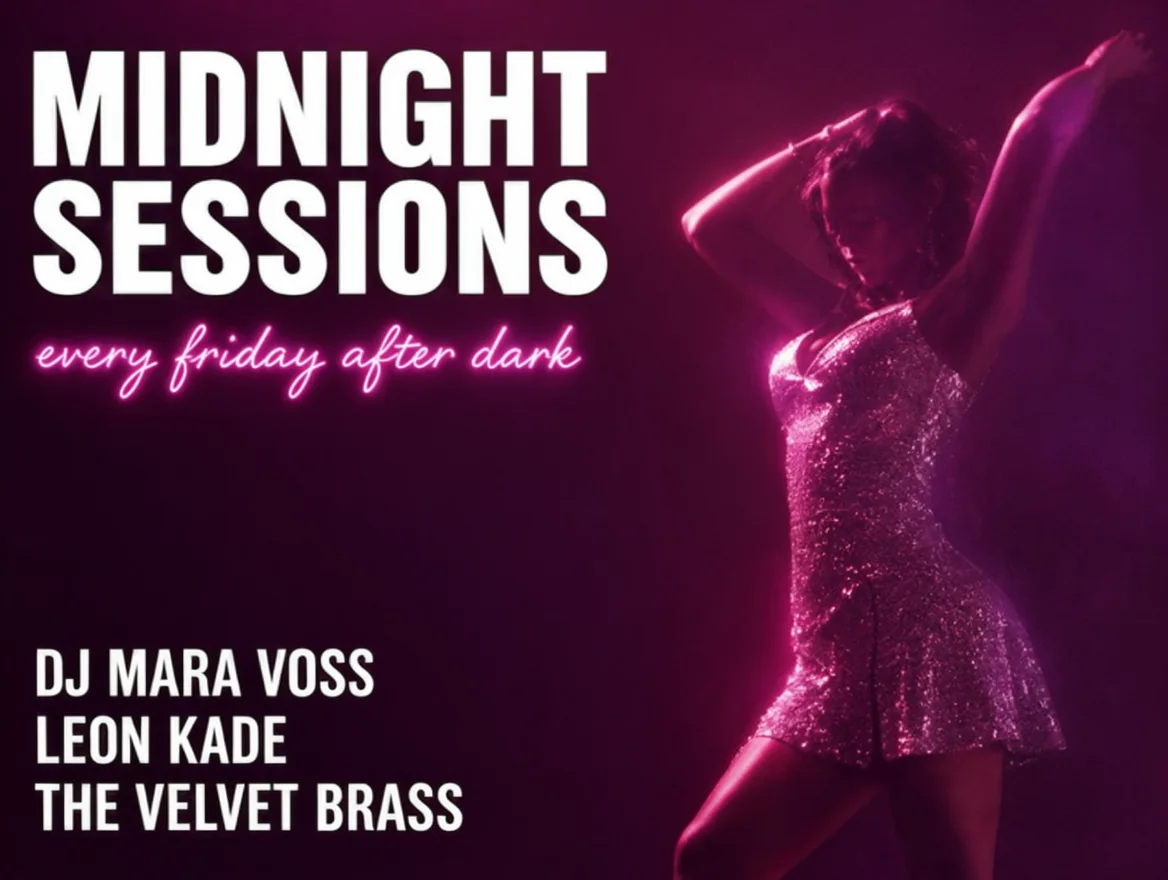
Envía un layout JSON como prompt y cada bloque de texto u objeto recibe su propio recuadro. Un volante de club con título, subtítulo de neón, cartel de artistas y una bailarina colocó cada elemento donde estaba su recuadro. OpenMOSS marca el formato como experimental.
Quince formas, tres niveles
De 1:3 a 3:1 en 1k, 1.5k o 2k. Una imagen 16:9 en 1.5k salió de 2048 x 1152 y una imagen 9:16 en 2k de 1536 x 2720.
Sin censura
En nuestras pruebas no se rechazó ni se suavizó nada en ningún nivel de contenido, de Suave a Máximo. No se filtra nada, ni a la entrada ni a la salida.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | Sí | Pon cada texto entre comillas e indica dónde va. Hasta 12.000 caracteres; el inglés funciona bien. mínimo 1 caracteres · máximo 12000 caracteres |
aspect_ratio | No | 15 formas, de 1:3 a 3:1; 1:1 por defecto. En 1k, 4:3 es 1168 x 880 y 16:9 es 1360 x 768. |
resolution | No | 1k (alrededor de 1 megapíxel, por defecto), 1.5k o 2k. El nivel fija el precio; una imagen panorámica en 1.5k salió de 2048 x 1152. |
output_format | No | JPEG por defecto, o PNG o WebP. El formato no cambia el precio. |
seed | No | Mantiene comparables las imágenes mientras cambias una frase a la vez. No garantiza píxeles idénticos. |
Precios
Se factura por imagen según el nivel de resolución (1k, 1.5k o 2k). La relación de aspecto y el formato de salida no cambian el precio. Las solicitudes fallidas no se cobran.
| Especificación | Precio |
|---|---|
| $0.024 / imagen |
| $0.048 / imagen |
| $0.096 / imagen |
Casos de uso
Carteles, portadas y anuncios
Título, eslogan, nombres del reparto y fecha en una misma imagen, o una cabecera con titulares y una línea de precio. Entrecomilla cada texto y colócalo.
Letreros, pancartas y volantes
Rótulos de neón, volantes de eventos y pancartas anchas en las que las palabras son lo importante. Usa el layout JSON cuando quieras un recuadro para cada bloque.
Briefs largos en una sola solicitud
Pega el brief completo, con escena, vestuario, luz, lente y cada línea de texto, en lugar de recortarlo a unas pocas frases.
Guía de prompts y consejos prácticos
Entrecomilla el texto y luego colócalo
Escribe «LAST CALL AT THE MERIDIAN» entre comillas y después indica dónde va y cómo se ve: mayúsculas doradas con serifa en el tercio inferior. Usa saltos de línea dentro de las comillas donde debe cortarse una línea.
Cómo escribir un layout JSON
El prompt es un objeto JSON con un summary (un caption para toda la imagen) y una lista items. Cada elemento tiene un label (text u object), un caption, un text opcional y un bbox. Pon bbox_format en yxyx y bbox_coord_space en abs_centralized: los recuadros son [arriba, izquierda, abajo, derecha] en píxeles desde el centro del lienzo, con x creciendo hacia la derecha e y creciendo hacia abajo.
Calcula con el tamaño real
Una imagen 4:3 en 1k es 1168 x 880, así que x va de -584 a 584 e y de -440 a 440. Un recuadro [-400, -560, -140, 40] es un área de título arriba a la izquierda. Consulta el tamaño de salida de tu relación y nivel antes de colocar los recuadros.
Guarda una seed de repuesto
Las letras a veces se pegan; en una prueba del perfume, leyó NOIIR en lugar de NOIR. Cambia la seed y vuelve a ejecutar. La seed mantiene comparables las pruebas, pero no garantiza píxeles idénticos.
Añade lo que necesitas en frases
No hay prompt negativo ni guidance. Describe sujeto, vestuario, lugar, luz y lente en frases, y mantén las cadenas de texto lo bastante cortas para leerlas al tamaño que elijas.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "openmoss/moss-image/text-to-image",
  "input": {
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.