Introducción
Envía el material en video_url y la voz nueva en audio_url. El modelo redibuja la boca según el audio y devuelve un MP4 con el tamaño de cuadro de la fuente y la duración del audio.
| Campo | Valor |
|---|---|
| Entrada | Video y Audio |
| Salida | Video |
| Modelo | VEED Lipsync 2.0 |
| Entradas obligatorias | Video de una persona ( |
| Resolución | La misma del video de entrada |
| Duración | Sigue al audio, hasta 5 minutos |
| Cobro | Por segundo de audio, redondeado hacia arriba |
Funciones y aspectos destacados
Una toma en un balcón con una frase nueva de cinco segundos
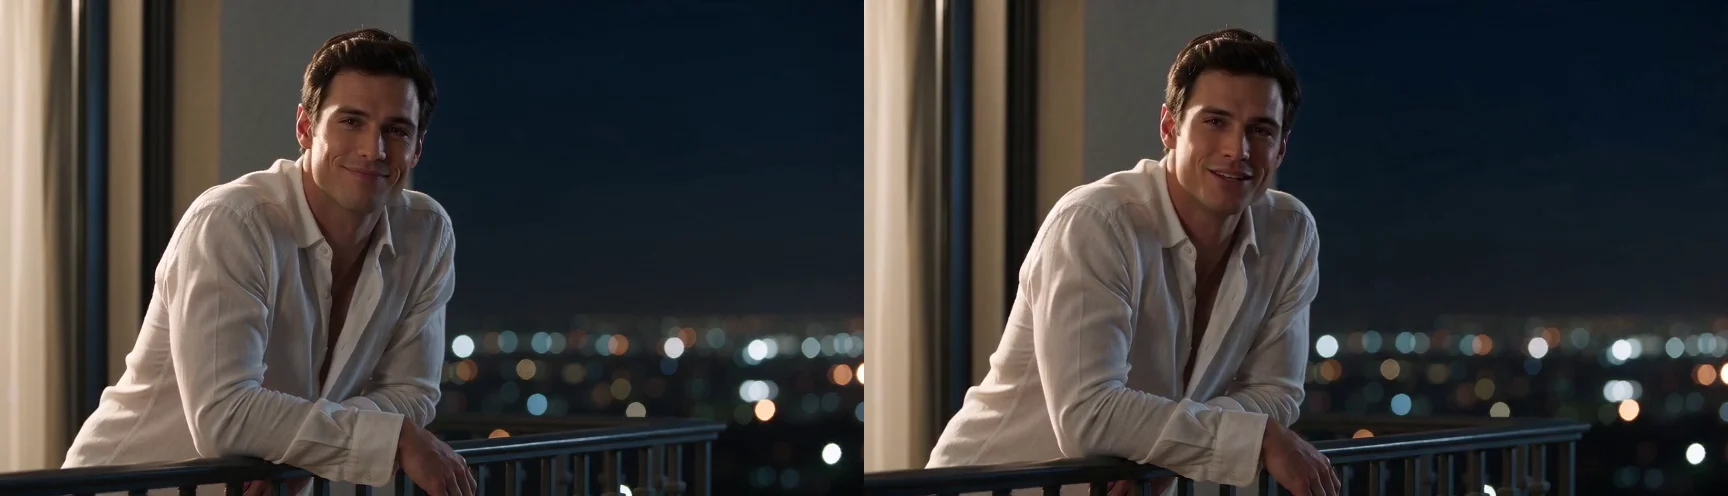
Le dimos a Lipsync 2.0 un clip de seis segundos de un hombre con camisa de lino blanca en el balcón de un hotel y una frase nueva grabada. Su boca ahora forma las palabras nuevas, mientras las luces de la ciudad, la camisa y su media sonrisa quedan como se filmaron. El resultado midió 864×496 y 5,08 segundos, recortado al audio.
El mismo instante, otra forma de boca
A los dos segundos, lado a lado: a la izquierda la toma original con los labios cerrados en una sonrisa; a la derecha el resultado con la boca abierta en la frase nueva. La camisa, la baranda y las luces de fondo no cambian.
El clip es toda la referencia que necesita
No hay muestra de voz, foto del rostro ni ajuste fino. Cambia el archivo de audio y el mismo material dice otra frase.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
video_url | Sí | Obligatorio. MP4 o WebM de una persona con el rostro visible. mínimo 1 caracteres |
audio_url | Sí | Obligatorio. La voz nueva, de hasta cinco minutos. mínimo 1 caracteres |
Precios
$0.084 / segundo
Se cobra por segundo del audio nuevo, redondeado al segundo entero siguiente. La duración y la resolución del material no cambian el precio. Los renders fallidos no se cobran.
Casos de uso
Corregir una frase después de grabar
Cambia una palabra, un precio o el nombre de un producto en una toma terminada sin volver a llamar a quien habla.
Locución traducida que se ve natural
Coloca una pista traducida sobre el material original y deja que la boca siga el nuevo idioma.
Diálogo nuevo para clips generados
Un personaje de un modelo de video puede decir una frase distinta a la que tenía al generarse.
Guía de prompts y consejos prácticos
Elige una toma con el rostro claro
De frente, bien iluminada y estable funciona mejor. Los giros rápidos de cabeza, las manos sobre la boca y el pelo sobre los labios restan precisión.
Prepara la frase nueva
Grábala, créala con un modelo de voz o usa una pista traducida. Una sola voz y sin música: si el audio tiene ruido, límpialo antes.
Envía los dos enlaces
Pasa el material en
video_urly la voz enaudio_url. El clip final vuelve con la resolución del material.
Introducción
VEED Lipsync 2.0 cambia lo que una persona en pantalla parece decir. Envía el material en video_url y la voz nueva en audio_url, y la boca se redibuja para coincidir.
Funciones y ventajas
Sobre la toma que ya tienes
El resto del cuadro queda como se filmó: fondo, ropa y expresión se mantienen y solo se vuelve a renderizar la zona de la boca.
Misma resolución de entrada y salida
La salida conserva el tamaño de cuadro del video de entrada y el precio no depende de ello.
El audio decide la duración
Un audio más corto recorta el clip y uno más largo extiende la imagen. En nuestras pruebas el resultado coincidió con el audio por centésimas de segundo.
Casos de uso
Correcciones sin volver a grabar
Corrige un nombre, una fecha o una oferta en un clip grabado de un presentador.
Reemplazo de voz
Coloca una pista traducida o regrabada sobre la actuación original.
Guía de entrada y consejos
Una persona, mirando a cámara
El modelo admite una persona por clip. Mantén el rostro visible y evita giros rápidos de cabeza.
Audio limpio
Usa una sola voz sin música ni ruido de fondo y limpia antes una grabación con ruido.
Respeta el ritmo
Una frase nueva de duración parecida a la original mantiene natural el movimiento del cuerpo.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "veed/lipsync-2.0/lip-sync",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "video_url": "https://example.com/reference.mp4"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.