Introducción
InfiniteTalk lip-sync utiliza material original y una grabación nueva para generar una interpretación hablada con movimientos renovados de boca, cabeza y cuerpo. La dirección opcional de escena y una máscara blanca de hablante orientan la solicitud; el MP4 sigue la duración del audio.
| Campo | Valor |
|---|---|
| Entrada | Video y Audio |
| Salida | Video |
| Identidad del modelo | MeiGen-AI InfiniteTalk; modelo estándar de pesos abiertos, Apache-2.0 |
| Nombre de tarea | meigen-ai/infinitetalk-v1/lip-sync |
| Par multimedia |
|
| Duración de audio de entrada | 3–600 segundos; determina la duración de salida |
| Niveles de salida | 480p por defecto; 720p opcional al doble de tarifa |
| Dirección opcional |
|
| Cálculo de duración | Segundos de audio redondeados hacia arriba, mínimo tres segundos |
| Salida medida de la florista | 1264×720, 25 fps, 6,10 segundos |
| Formato de entrega | Resultado MP4 asíncrono mediante consultas o notificación |
| Período de almacenamiento | Salidas eliminadas después de 14 días |
Funciones y aspectos destacados
Una explicación corta de Saturno
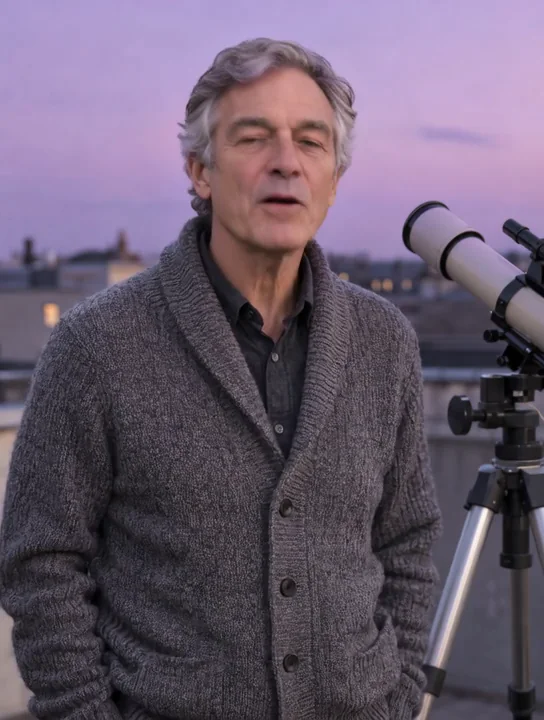
El astrónomo habló junto a su telescopio de azotea durante unos nueve segundos en nuestras pruebas. La interpretación siguió la grabación con movimiento natural sutil.
Un retrato de bar interpreta la frase
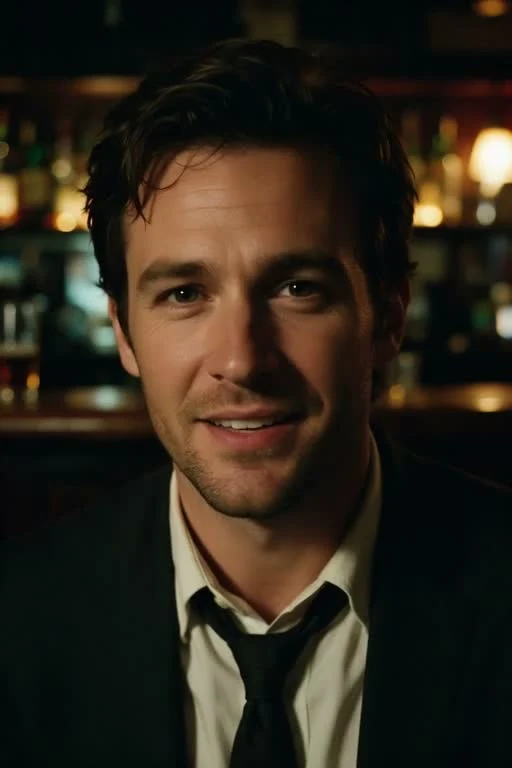
El bar en 480p anima a un hombre con corbata aflojada diciendo: «Last call already? Then stay for one more.» Hay movimiento natural de cabeza ante el cálido entorno del bar.
Identifica a la persona y cambia un detalle
Marca a quien habla en blanco en una máscara opcional si comparten foto varias personas. seed fijo ayuda a comparar un ajuste de prompt o resolución a la vez, sin prometer resultados idénticos.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
video_url | Sí | Material obligatorio para lip-sync con la persona deseada claramente visible. mínimo 1 caracteres |
audio_url | Sí | Grabación nueva obligatoria para lip-sync, de 3–600 segundos y sin valor predeterminado. mínimo 1 caracteres |
prompt | No | Dirección opcional de lip-sync para expresión, acción e iluminación, de hasta 2.000 caracteres. Puede omitirse; el diálogo procede del audio. mínimo 1 caracteres · máximo 2000 caracteres |
mask_url | No | Imagen opcional de selección de hablante para lip-sync si aparecen varias personas; marca en blanco a la deseada. Omítela para una solicitud sin máscara. mínimo 1 caracteres |
resolution | No | La sincronización labial de video acepta 480p o 720p y utiliza 480p por defecto. |
seed | No | Semilla aleatoria opcional para comparar sincronización labial de video; aquí no se especifica rango numérico ni valor predeterminado. |
Precios
Cuenta los segundos del audio de entrada redondeados hacia arriba al entero, con un mínimo facturado de tres segundos y audio limitado a 3–600 segundos. La tarifa 720p duplica la de 480p; la duración del video original, mask, prompt y seed no alteran el cobro.
| Especificación | Precio |
|---|---|
| $0.036 / segundo |
| $0.072 / segundo |
Casos de uso
Dale una respuesta grabada a un personaje fijo
Usa talking-avatar cuando partas de un retrato. Tu grabación aporta la voz y la frase, mientras el modelo añade los movimientos al hablar.
Cambia el ánimo de material existente
Elige lip-sync para obtener una interpretación nueva a partir de un clip. En la prueba del taller floral, una grabación que pasó de duda a alegría hizo que levantara la cabeza, animara la expresión y moviera los hombros.
Crea un clip de presentador desde una narración
Combina una foto o video de presentador con una explicación preparada. Se acepta audio de 3 a 600 segundos; revisa el resultado completo si utilizas una grabación más larga.
Dirige a una persona en una escena compartida
Marca en blanco al hablante deseado en una máscara enviada por mask_url. Así seleccionas a una persona del original; la prueba de la florista mostrada usa un solo hablante sin máscara.
Afina la interpretación antes de una ejecución larga
Prueba una grabación breve y una instrucción de movimiento moderada en 480p. Compara un cambio con semilla fija y decide si usar 720p para el clip final con el doble de tarifa.
Guía de prompts y consejos prácticos
Combina material grabado y audio nuevo
Asigna a
video_urlun clip con el hablante claramente visible y aaudio_urluna grabación de 3–600 segundos. Comprueba los derechos de ambos archivos y utiliza personas adultas sin suplantación.Configura la interpretación y la tarifa
Añade
mask_urlpara seleccionar hablante o prompt para dirigir el movimiento, según necesites. Usa 480p por defecto o elige 720p al doble de tarifa por segundo; seed es opcional para comparar.Recupera y evalúa el clip hablado
Recoge el resultado asíncrono mediante consultas o notificación. Observa las expresiones y posturas regeneradas mientras suena la grabación y guarda el MP4 antes de su eliminación a los 14 días.
Un doblaje nuevo que cambia la interpretación
InfiniteTalk de MeiGen-AI es un modelo estándar de pesos abiertos bajo Apache-2.0. El endpoint meigen-ai/infinitetalk-v1/lip-sync acepta material grabado y una grabación nueva para producir un MP4. Puede regenerar conjuntamente animación de boca, movimientos de cabeza, expresiones faciales y postura. Elige este proceso cuando quieras que una frase nueva influya en la interpretación visible.
MeiGen-AI describe el método como doblaje de video con cuadros dispersos: el original proporciona identidad, fondo y contexto de cámara, y el audio guía el movimiento generado. Revisa toda la interpretación sin esperar una reproducción del movimiento original cuadro por cuadro. La voz viene de tu grabación subida; el endpoint no realiza clonación de voz.
Seis campos de solicitud
| Campo | Obligatorio | Valor admitido y función |
|---|---|---|
video_url | Sí | Material original con la persona deseada claramente visible. |
audio_url | Sí | Grabación de 3–600 segundos; aporta la voz y el tiempo de salida. |
mask_url | No | Imagen de selección de hablante; marca en blanco a la persona deseada si aparecen varias. |
prompt | No | Hasta 2.000 caracteres que describen expresión, acción o iluminación. |
resolution | No | 480p por defecto o 720p al doble de tarifa por segundo. |
seed | No | Semilla aleatoria fija para comparar un único cambio de entrada; no se garantiza repetibilidad. |
No hay campo independiente de duración: prepara la grabación con la longitud que necesites. Si el clip original supera la duración grabada, se acorta en el resultado. El ejemplo de la florista también devolvió 6,10 segundos con 6,1 segundos de audio y 6,04 segundos de video; esa pequeña extensión no establece el comportamiento para todas las diferencias de duración.
Cuenta los segundos de audio y elige un nivel
El cobro cuenta los segundos del audio de entrada, redondeados hacia arriba al siguiente entero con mínimo de tres segundos. La tarifa 720p equivale al doble de la de 480p. La duración del original, la máscara, el texto de dirección y la semilla no modifican esa regla. Consulta el precio del modelo InfiniteTalk para conocer la tarifa actual.
En la solicitud de la florista, la grabación de 6,1 segundos contó como siete segundos en el nivel 720p. Empieza revisando todo el audio, incluidas pausas y cierre, porque esa pista determina duración hablada y cantidad cobrable. Un clip original más corto no reduce los segundos de audio facturados.
Prepara la escena y la grabación
Haz visible al hablante
Elige material donde puedas evaluar claramente la expresión y los movimientos de la persona deseada. Confirma por separado el permiso para rostro, video y voz: cada persona mostrada debe ser adulta y el resultado no debe suplantar a nadie. En una escena grupal, envía mask_url con blanco sobre el hablante deseado. La máscara selecciona a la persona; no sustituye la pista de audio.
Centra las indicaciones en la interpretación
Coloca el diálogo real en la grabación. Una dirección opcional útil para un taller tranquilo sería: «La hablante levanta la vista con una pequeña sonrisa de sorpresa y un movimiento suave de hombros; mantén estable la luz cálida del taller». Adapta las indicaciones a la escena de tu video. El campo de texto puede orientar la interpretación visible, pero no reemplaza audio_url.
Compara una sola indicación modificada manteniendo los mismos archivos, semilla y resolución. Una semilla fija facilita esa comparación; no promete cuadros idénticos ni repetir un gesto. Reproduce ambas salidas con sonido para evaluar qué cambió.
Resultados de video observados
El ejemplo rainy-florist-surprise partió de un clip tranquilo de taller de 6,04 segundos a 864×496. La grabación de 6,1 segundos pasa de la duda a la alegría. Con una instrucción de movimiento y resolution: 720p, el resultado midió 1264×720 a 25 fps y duró 6,10 segundos. Ella levantó la cabeza, animó la expresión y movió hombros y torso mientras la boca seguía las palabras.
En otra prueba 480p, un original de 5,4 segundos con grabación de 4,55 segundos devolvió 4,55 segundos a 512×768 y 25 fps. La boca y la postura de cabeza siguieron la frase nueva. Son medidas de clips cortos; no garantizan dimensiones concretas ni calidad sostenida durante una grabación de diez minutos.
Recupera, revisa y elige un proceso
Las solicitudes se procesan de forma asíncrona. Conserva el identificador tras enviarlas y consulta la finalización o usa una notificación para obtener el MP4. Revisa el tiempo del habla, los cambios de expresión, los movimientos de cabeza y la escena hasta el final de la grabación. Los archivos generados se conservan durante 14 días y luego se eliminan; guarda los resultados aceptados antes de que venzan.
Usa el endpoint talking-avatar con foto de InfiniteTalk si el original es una imagen fija. Para material grabado, compara Sync Lipsync 2 si importa conservar la forma de hablar original y elegir cómo resolver duraciones distintas. Considera OmniHuman 1.5 para un proceso de retrato con dirección textual de gestos, expresión y cámara. Elige según tus archivos y controles necesarios, y evalúa una salida breve con material propio autorizado.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "meigen-ai/infinitetalk-v1/lip-sync",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "resolution": "480p",
    "video_url": "https://example.com/reference.mp4"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.