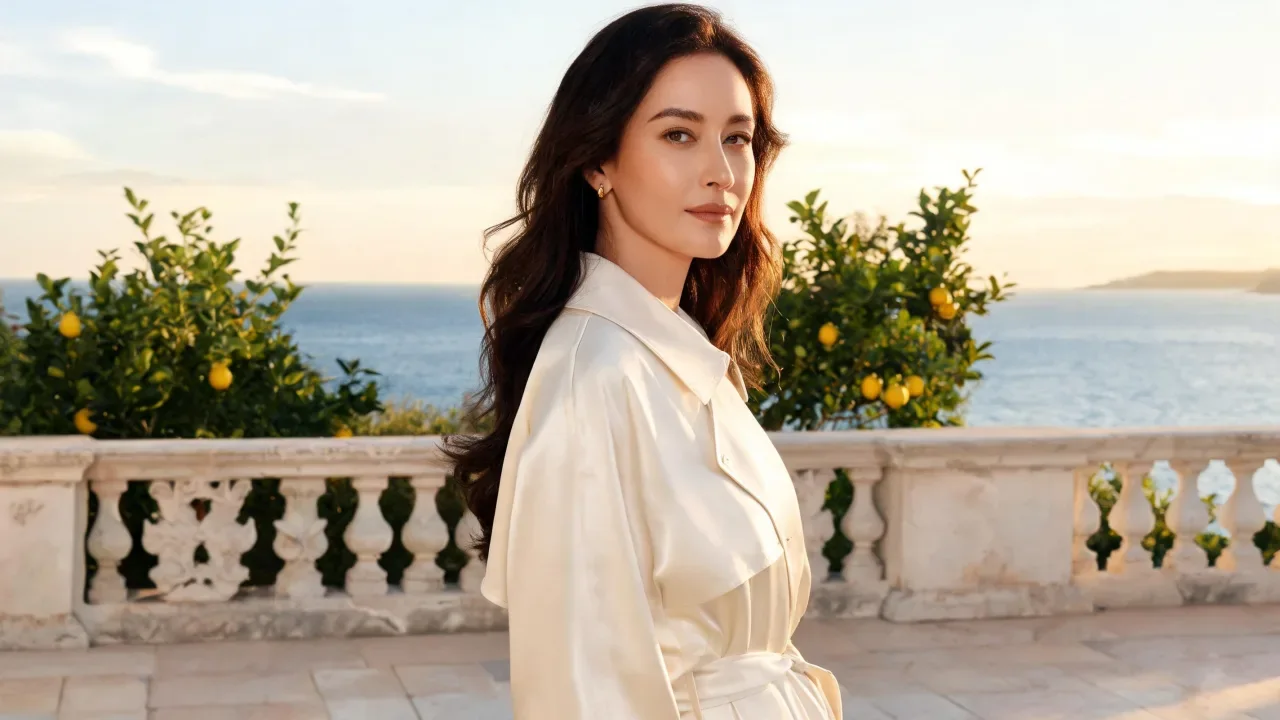
Introducción
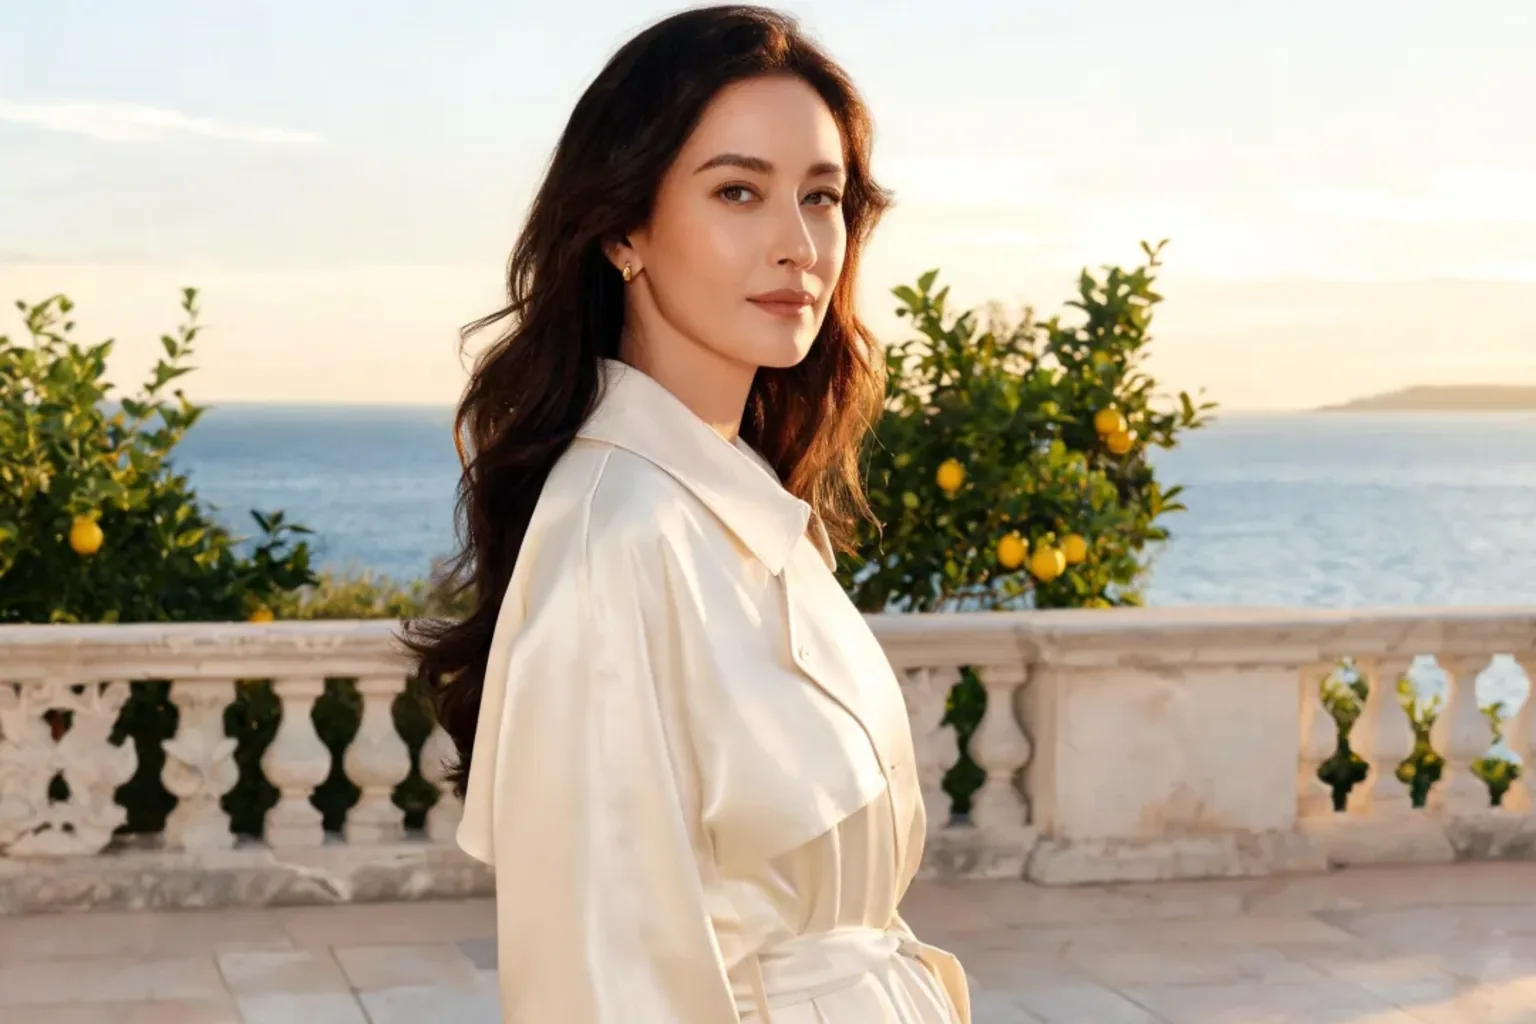
Talking Avatar convierte un solo retrato en un clip que habla. Envías la cara en image_url y una grabación de voz en audio_url; la boca, la mandíbula y pequeños movimientos de cabeza se animan para que la persona parezca decir exactamente lo que hay en la grabación. El clip dura lo mismo que el audio, de tres a sesenta segundos, y vuelve con tu grabación ya incluida, listo para publicar o para llevar a la edición.
Funciones y aspectos destacados
El audio marca el ritmo
Cada forma de la boca sale del propio sonido, así que las pausas, las frases rápidas y los énfasis caen donde los puso quien habla. No hay campo de guion ni tiempos que ajustar: graba la frase como debe sonar y la cara la sigue segundo a segundo.
El retrato sigue siendo la escena
Ropa, pelo, fondo y encuadre salen directamente de la imagen. No se regenera nada alrededor de la cara, por lo que un presentador, un personaje o un portavoz se reconoce igual de un clip a otro. El resultado es compacto, unos 0,2 megapíxeles a 25 fotogramas por segundo (una foto 16:9 volvió en 640×352 y un retrato 3:4 en 400×544), así que piensa en feeds y ventanas de chat más que en pantalla completa.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
image_url | Sí | La cara que va a hablar. Una sola persona, mirando más o menos a cámara, con luz pareja; un plano de busto funciona mejor. mínimo 1 caracteres |
audio_url | Sí | La voz que se sincroniza, de 3 a 60 segundos, en MP3 o WAV. Tiene que ser un enlace directo al archivo de audio; subirlo es la vía más fiable. mínimo 1 caracteres |
prompt | No | Opcional. Unas palabras sobre la expresión o el tono: tranquilo, alegre, serio. máximo 1000 caracteres |
mask_url | No | Opcional. Solo hace falta si el retrato muestra a varias personas: una imagen en blanco y negro del mismo tamaño, en blanco sobre quien debe hablar. mínimo 1 caracteres |
seed | No | Fíjalo para comparar dos ejecuciones con el mismo retrato y el mismo audio; déjalo vacío para obtener una toma nueva cada vez. |
Precios
$0.018 / segundo de salida
Se cobra por segundo de video entregado, que dura lo mismo que tu audio, redondeado hacia arriba con un mínimo de 3 segundos.
Casos de uso
Clips de presentador a partir de una foto
Intros de cursos, recorridos de producto y avisos semanales pueden reutilizar un retrato aprobado con una grabación nueva cada vez. Cambiar de idioma es solo enviar otro archivo de audio con la misma imagen, de modo que un presentador cubre varios mercados.
Personajes que responden en voz alta
Las apps de compañía y de rol pueden hacer que un personaje diga su respuesta frente a cámara: conserva un retrato del personaje, convierte la respuesta en voz y envía el par. Incluso una respuesta corta tarda uno o dos minutos en renderizarse, así que lanza la tarea mientras la respuesta en texto ya está en pantalla.
Guía de prompts y consejos prácticos
Elige el retrato pensando en la boca
Lo que se mueve es la boca, así que dale píxeles: plano de busto, cara más o menos hacia la cámara, luz pareja y nada que tape los labios. Las gafas de sol, los perfiles marcados y las caras pequeñas en un plano abierto son las causas habituales de un resultado raro.
Mejor audio limpio que audio fuerte
Exporta voz sin música de fondo, sin salas con eco ni voces superpuestas. Recorta el silencio al principio y al final, porque el silencio también cuenta en la duración que se cobra. Mantén cada archivo entre tres y sesenta segundos y divide los guiones largos en pausas naturales.
Prompt para el tono, máscara para quién
El campo prompt orienta un poco la expresión, tranquila, alegre o seria, pero no cambia quién habla ni dónde. Si el retrato muestra a varias personas, pasa mask_url con quien habla en blanco sobre negro, del mismo tamaño que la imagen. Fija seed para comparar dos grabaciones sobre el mismo retrato.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.