Introducción
OmniHuman 2.0 Talking Avatar es el modelo de avatar guiado por audio de ByteDance. Envías un retrato (image_url) y un archivo de audio hablado o cantado (audio_url), y devuelve un video de 720p de esa persona interpretando el audio: el rostro, los labios, la cabeza y la parte superior del cuerpo se mueven con él, en lugar de dejar el torso congelado. El clip dura lo mismo que el audio, de 4 a 300 segundos. No hay campo de duración, de resolución ni de relación de aspecto. Un prompt opcional de hasta 300 caracteres dirige el ánimo, los gestos, hacia dónde miran los ojos y, según el publicador, el movimiento de cámara.
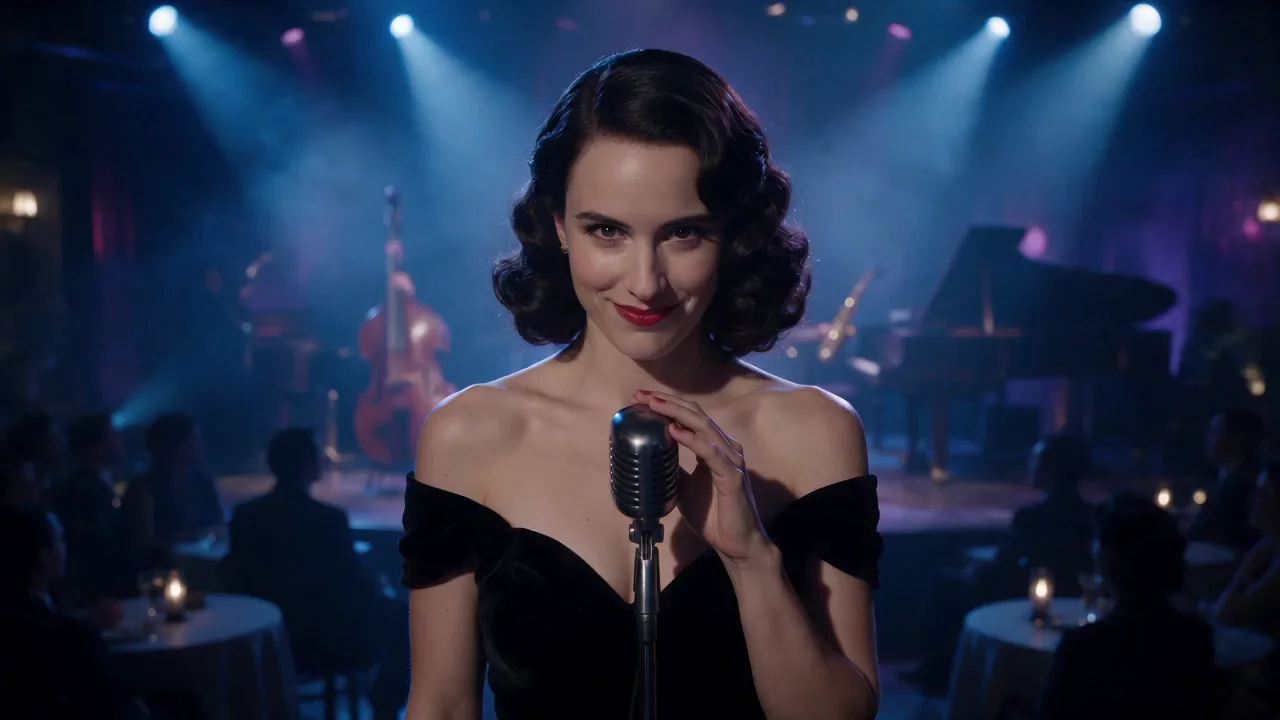
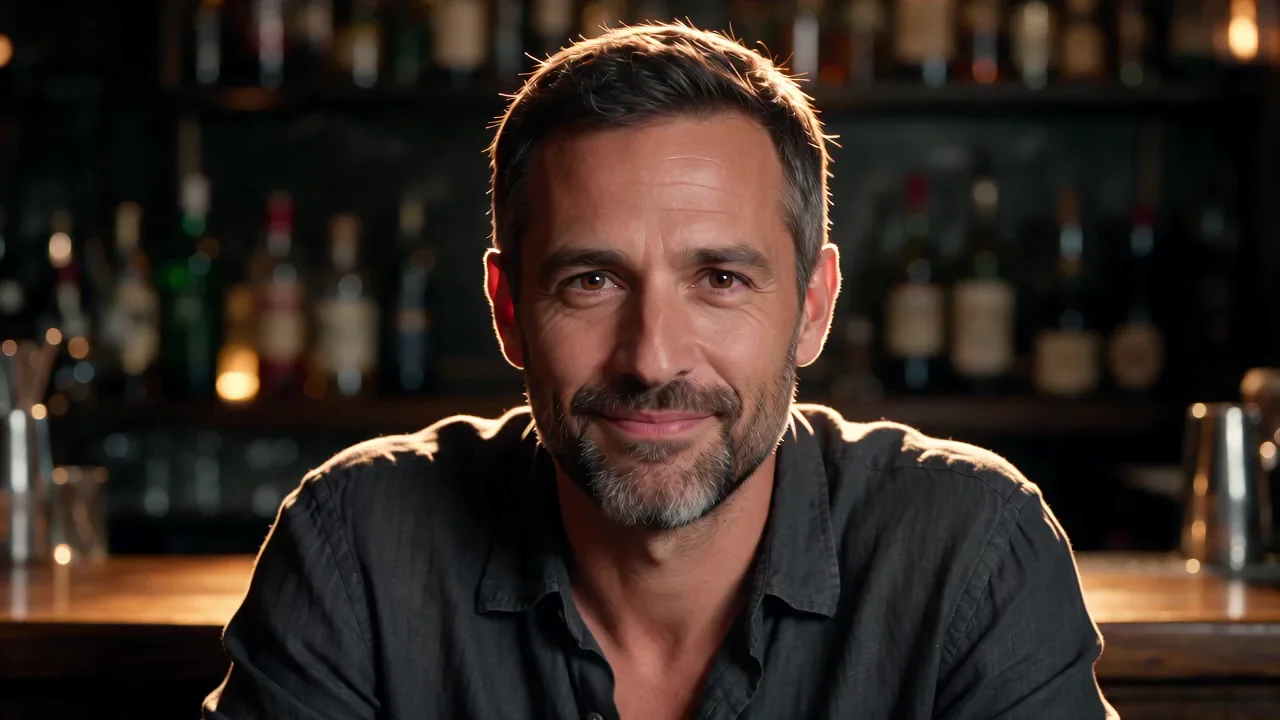
Tres de los cuatro ejemplos de esta página (la cantante del club nocturno, la barra y el programa nocturno) usan los mismos retratos y audios que Kling Avatar 2.0, recortados a unos cinco segundos, para que compares las dos páginas lado a lado.
Funciones y aspectos destacados
El audio fija la duración
Recorta tu audio a la duración que quieres que tenga el clip antes de enviarlo. El audio de menos de 4 segundos o de más de 300 se rechaza antes de cobrar nada. En nuestras pruebas, el clip salió entre 0,2 y 1 segundo más largo que el audio, siempre en un número entero de segundos: 4,55 segundos de audio dieron un clip de 5 segundos, y 5,2 segundos dieron uno de 6. El cobro sigue la duración del audio, no la del clip terminado.
Lo que medimos
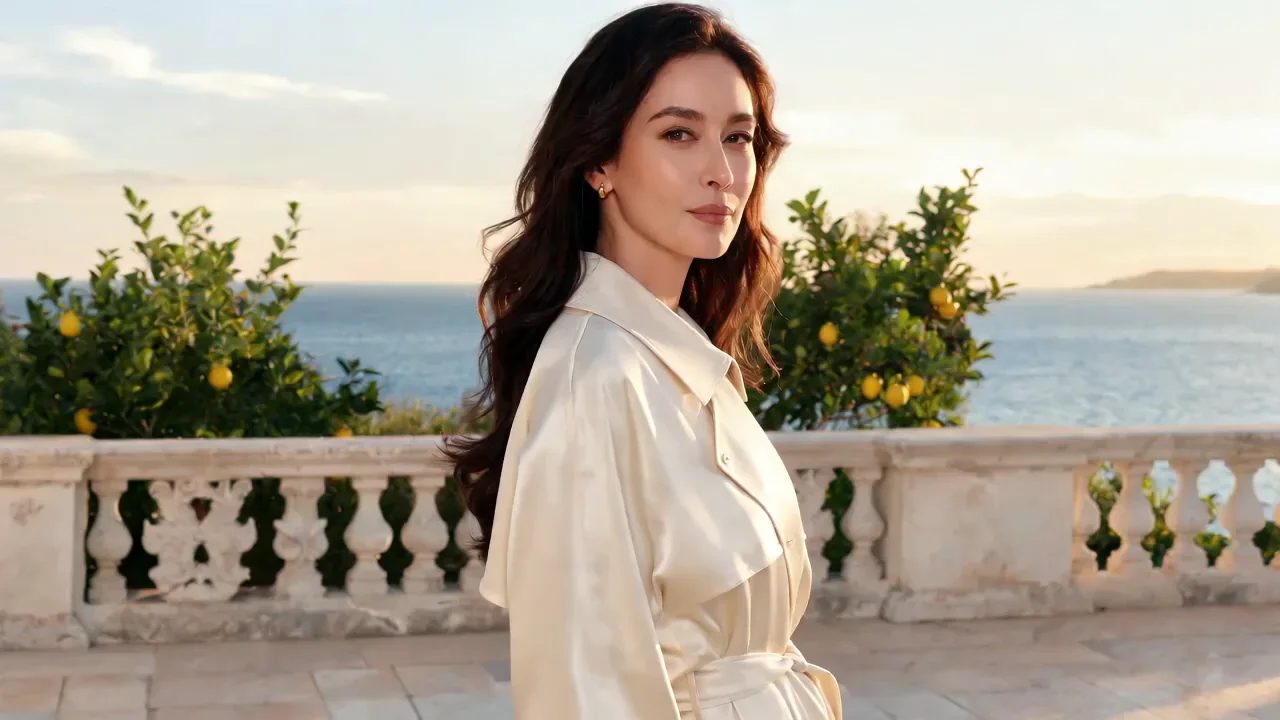
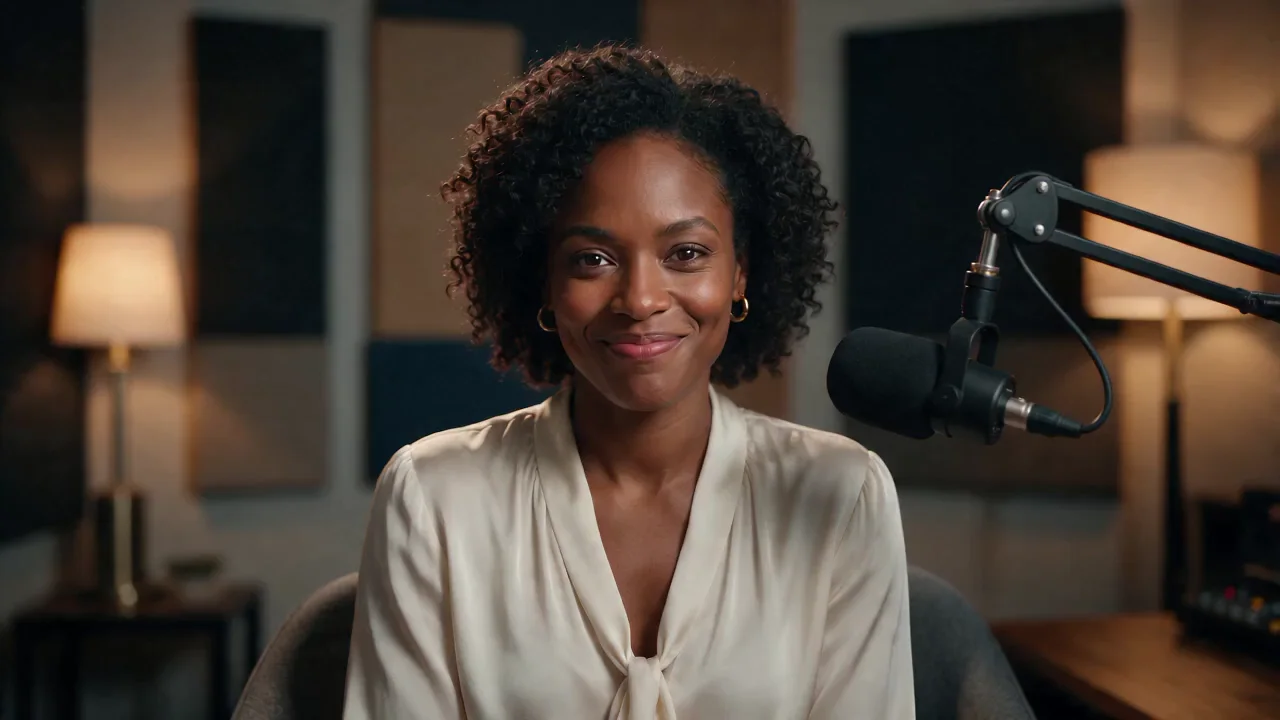
Probamos cuatro retratos, cada uno con su propio audio de 4,55 a 5,2 segundos y su propio prompt de una línea. Los cuatro retratos eran 16:9. Todos los clips salieron a 1280×720 y 24 fps con la pista de audio incluida, y el procesamiento tomó unos dos minutos por clip: de 110 a 133 segundos desde el envío hasta el archivo terminado. Al comparar fotogramas con el retrato de entrada, el rostro se mantuvo reconocible como la misma persona en los cuatro clips.
Labios, expresión y gesto
En los cuatro clips los labios siguieron el audio. Los prompts pedían gestos pequeños y concretos, y la mayoría apareció: una sonrisa y una leve inclinación de cabeza en la última palabra, con una mano que se mantiene sobre el micrófono; una media sonrisa y una ceja levantada, con las botellas detrás de la barra estables; una cabeza que gira hacia el mar en el último segundo; y una risa breve con cejas amplias en la última palabra. Una instrucción no se apreció en pantalla: la inclinación hacia el micrófono en el clip del programa nocturno.
El prompt es opcional
Deja prompt vacío y el modelo sigue el audio por sí solo. El publicador lista chino, inglés, japonés, coreano, español (de México) e indonesio como idiomas del prompt. Nuestros cuatro prompts estaban en inglés y dirigían la expresión, los gestos y hacia dónde miran los ojos; no probamos instrucciones de movimiento de cámara.
Lo que no hemos probado
El publicador lista escenas con más de una persona; no las hemos probado. Nuestros clips tenían todos unos cinco segundos de audio, así que no hemos probado un clip largo cerca del máximo de 300 segundos, una canción completa ni retratos que no sean 16:9.
Revisión de contenido
Los retratos que no superan la revisión de contenido de ByteDance se rechazan y no se cobra nada. Uno de nuestros retratos de prueba fue rechazado así: sin clip, sin cobro. Cuenta con que cada solicitud pase por esa revisión.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | No | Opcional, de hasta 300 caracteres. Dirige el ánimo, los gestos, hacia dónde miran los ojos y el movimiento de cámara. máximo 300 caracteres |
image_url | Sí | Retrato a animar. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC o HEIF, de menos de 30 MB, de 300 a 6000 px en cada lado, con una relación ancho-alto entre 0,4 y 2,5. |
audio_url | Sí | Habla o canto, WAV o MP3, de menos de 15 MB, de 4 a 300 segundos. El clip dura lo mismo que este audio; el audio fuera de ese rango se rechaza antes de cobrar nada. |
Precios
$0.108 / segundo
Se cobra por segundo del audio de entrada, con un mínimo de 4 segundos y un máximo de 300; la reserva sigue la duración del audio (o el máximo de 300 segundos cuando no puede leerse) y la diferencia se libera al entregar. Las solicitudes fallidas o rechazadas no se cobran.
Casos de uso
Dale rostro a una línea grabada
Combina una línea grabada o generada con un retrato para obtener un clip de esa persona diciéndola: intros narradas, testimonios o diálogos de un personaje cuyo rostro ya definiste.
Intros cortas de presentador y aperturas en frío
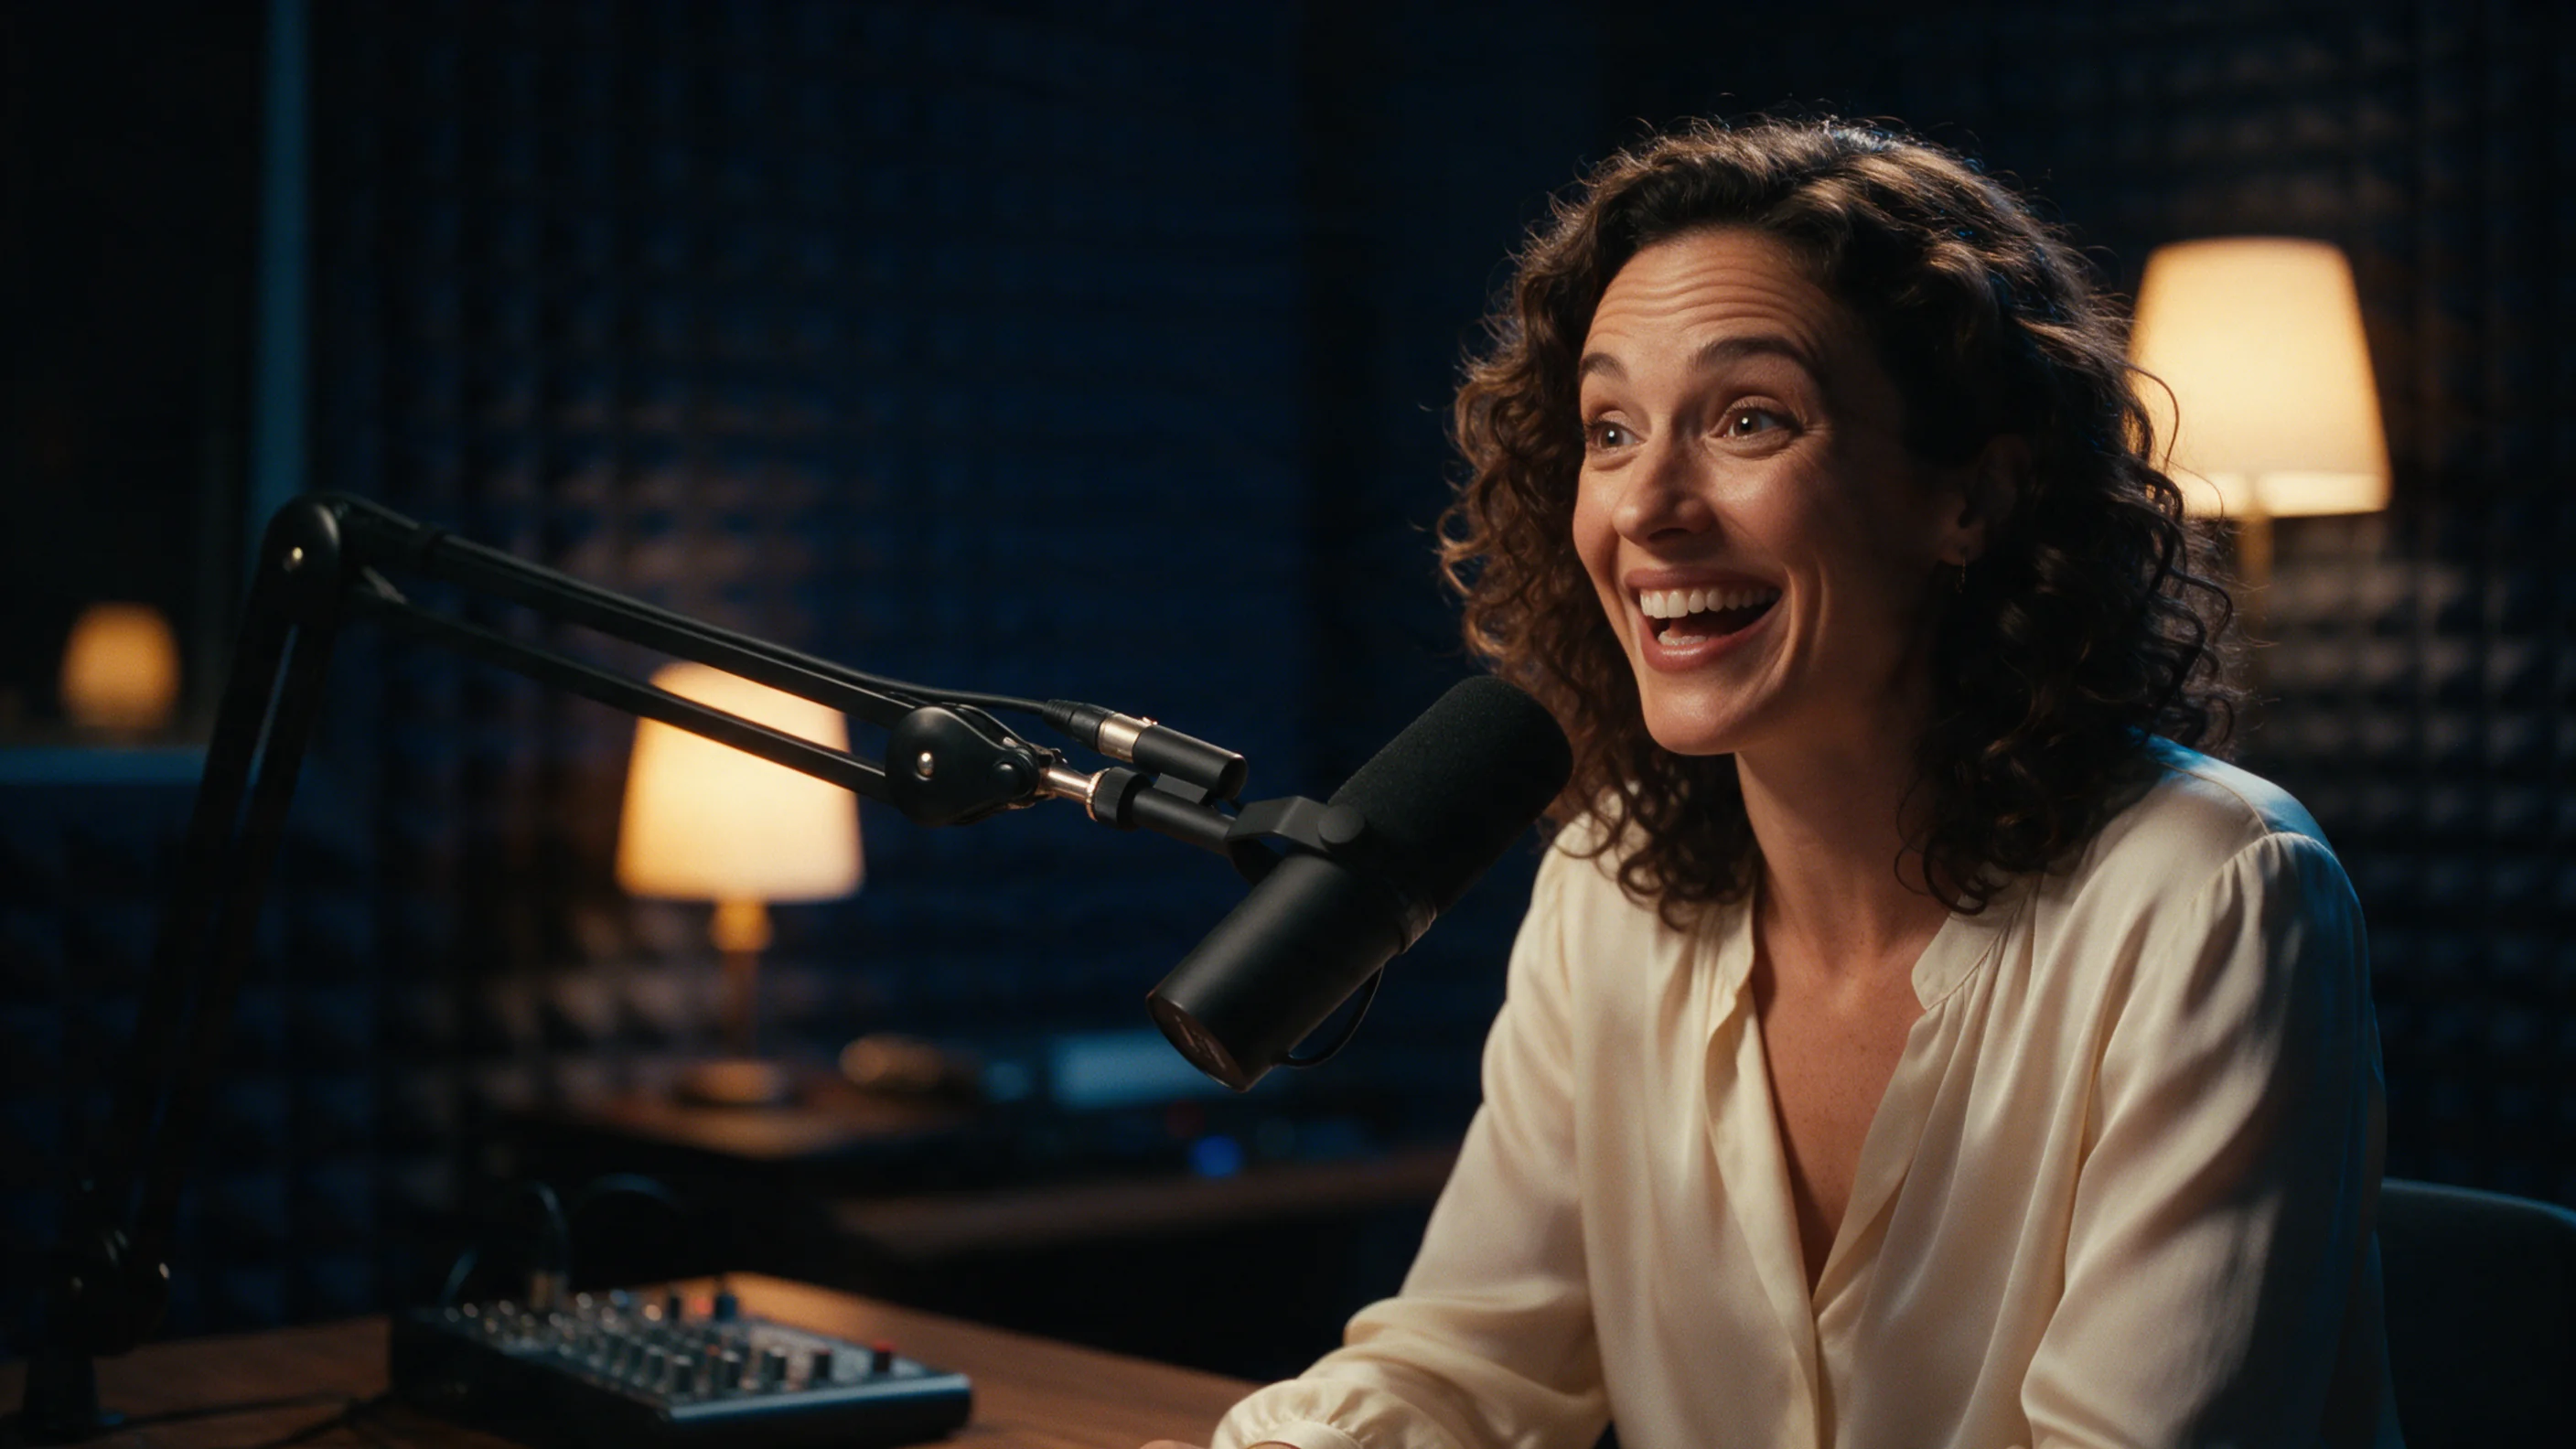
Una línea de apertura alegre y juguetona, con un prompt que nombra el ánimo y un gesto en la última palabra, nos dio expresiones amplias, cejas vivas y una risa, como en el ejemplo del programa nocturno de esta página.
Una línea cantada a partir de una foto fija
El publicador lista el canto junto con el habla. Nuestra prueba incluyó una línea lenta cantada y hablada, de unos cinco segundos, frente a un micrófono vintage; no hemos probado una canción completa.
Fotos de teléfono tal como son
El retrato puede ser JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC o HEIF, de menos de 30 MB, así que una foto tomada directamente con el teléfono puede enviarse sin convertirla antes.
Guía de prompts y consejos prácticos
Vincula una expresión a un momento de la línea
«A lazy smile on the last word» y «glances away at the end» llegaron donde los colocamos: la sonrisa y la inclinación de cabeza llegaron al final del clip del club nocturno, y la cabeza giró hacia el mar en el último segundo del clip de la terraza. Nombrar en qué parte de la línea debe ocurrir un gesto le da al modelo algo que sincronizar.
Mantén pocos gestos
Cada uno de nuestros prompts pedía un ánimo, uno o dos gestos faciales y, a veces, una postura. Eso basta para dar forma a un clip de cinco segundos. En nuestras pruebas, los gestos faciales siguieron el prompt con más fiabilidad que el movimiento corporal.
No cuentes solo con un movimiento corporal
«A lean toward the mic» en el prompt del programa nocturno no se apreció en pantalla, mientras que la risa y las cejas que lo acompañaban sí. Es una observación de una sola prueba, pero si un movimiento corporal te importa, genera una vez y compruébalo antes de construir sobre él.
Elige el retrato teniendo en cuenta los límites
El ancho y el alto deben estar cada uno entre 300 y 6000 píxeles, y la relación ancho-alto debe estar entre 0,4 y 2,5. Solo probamos retratos 16:9.
Recorta el audio a la actuación
El clip dura lo mismo que el audio, y el cobro sigue la duración del audio, así que corta el archivo a la parte hablada o cantada que realmente quieres. WAV o MP3, de menos de 15 MB.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.