En resumen: Lip Sync toma un clip que ya tienes más un archivo de voz de 3 a 60 segundos, y vuelve a dibujar solo la boca para que la persona en pantalla diga tu frase. El vídeo dura lo que dure el audio, no el clip. El flujo: escribir la frase, darle voz con un modelo de síntesis de voz, enviar el clip y el audio como una sola tarea asíncrona y luego revisar los pocos puntos de tiempo donde la sincronización se rompe. La voz cuesta una fracción de céntimo; la sincronización cuesta $0.012 por segundo de audio, así que una frase de 10 segundos cuesta unos $0.12.
Cambiar la pista de audio con ffmpeg deja la boca diciendo otra cosa, como en una película mal doblada. Volver a dibujar la boca es trabajo del modelo de lip sync.
En nuestras pruebas de octubre de 2026, los clips de adultos desde abrazos con ropa hasta material claramente adulto se aceptaron al precio normal, sin nada difuminado ni recortado. Lip Sync vuelve a dibujar solo la boca, así que funciona mejor en un clip en el que la persona mira a la cámara y habla; los besos o los planos muy cerrados no le dan nada que sincronizar.
De un vistazo
- Dos archivos de entrada, sin prompt.
video_urles el clip yaudio_urles la nueva voz; no hay nada más que ajustar. - El audio marca la duración. Un clip más largo se recorta a la frase; un clip más corto se repite hasta que la frase termina. Las dos duraciones de archivo son tu único control.
- El audio debe durar de 3 a 60 segundos, en MP3 o WAV. Cualquier cosa fuera de ese rango falla en segundos y no cuesta nada.
- Pagas por el audio, por segundo, redondeando hacia arriba, con un mínimo de 3 segundos. El vídeo devuelto se prolonga medio segundo más allá del audio, y esa cola es gratis.
- Tarda minutos, no segundos. Envíalo y déjalo correr; una frase de 10 segundos tarda unos cuatro minutos.
Antes y después
Aparte de la duración, que ahora sigue a la frase, solo cambia la boca. La expresión, el movimiento de la cabeza, la luz y el encuadre vienen de los fotogramas originales, así que Lip Sync encaja con una toma que ya te gusta y no puede animar una actuación plana.
Paso 1: parte de un clip que pueda sostener una frase
El modelo repinta la boca y deja intacto todo lo demás, así que el metraje decide en gran parte el resultado. Lo que funciona:
- Una persona, con el rostro de un tamaño razonable en el cuadro y girado sobre todo hacia la cámara. Un plano medio corto es la elección segura; un rostro al fondo lejano no lo es.
- Un único plano continuo. Un corte seco en mitad del clip rompe la sincronización en el corte.
- Una boca despejada. Una mano, un vaso, un micrófono o un mechón de pelo cruzando los labios es donde la sincronización se desliza.
- Una actuación que encaje con la frase. Como el resto del rostro no se toca, una cara tranquila con una frase gritada sigue leyéndose como tranquila.
La resolución llega como máximo a 720p: un clip de 1920×1080 vuelve en 1280×720, y enviar 1080p no cuesta más.
Si generas el clip de origen
Pide al modelo de vídeo una toma que ya esté hablando: el movimiento de la mandíbula y de la cabeza que hace que el habla parezca real tiene que estar en el clip. Este es el prompt de movimiento que usamos en Seedance 2.0 Mini Spicy, partiendo de una imagen fija del hombre en la barra:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Fija la duración del clip al menos en la longitud de tu frase: Seedance 2.0 Mini Spicy admite de 4 a 15 segundos. Deja el audio nativo desactivado, porque Lip Sync reemplaza la pista de sonido.
Dos comprobaciones antes de pagar la sincronización:
- Fija la cámara. Un empuje lento hace que el corte del bucle salte desde el primer plano de nuevo al primer fotograma más abierto, así que busca uno.
- Compara el rostro con tu imagen fija. La imagen a vídeo puede derivar un rostro a lo largo de unos segundos, y Lip Sync conserva el rostro que tenga el clip. Descarta un clip derivado antes de la sincronización.
¿Por qué no dejar que el modelo de vídeo haga el sonido?
Los modelos de vídeo como Seedance 2.x, Wan 3.0 y Kling 3.0 pueden generar sonido junto con la imagen. Eso está bien para el ambiente o el diálogo suelto, pero el audio viene horneado en un render completo: cambiar una palabra significa pagar otra vez por todo el clip. Una frase nueva de 10 segundos cuesta unos $0.12 sincronizarla, mientras que volver a renderizar un clip de 720p de 10 segundos en Seedance 2.0 Mini Spicy cuesta $0.82.
Paso 2: escribe la frase y dale voz
Sirve cualquier MP3 o WAV de entre 3 y 60 segundos, incluida tu propia grabación. Si no tienes un locutor, un modelo de síntesis de voz es la ruta más rápida. Estos cuatro funcionan bien con lip sync:
| Modelo | Cómo diriges la interpretación | Precio de lista | Una frase de 10 segundos cuesta unos |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Texto más una de 30 voces, con style, accent, pace opcionales y una nota de interpretación. Las claves entre corchetes, como [laughs], suelen interpretarse en vez de leerse | $0.00032 por segundo de audio | $0.0032 |
| Gemini 2.5 Pro TTS | Los mismos controles que Flash; modelo más antiguo, precio algo mayor | $0.00045 por segundo de audio | $0.0045 |
| MiniMax Speech 2.8 HD | Un ajuste de emotion. Las claves van entre paréntesis, como (sighs) | $0.12 por 1.000 caracteres | $0.018 |
| Seed Speech 2.0 | 41 voces, 10 idiomas y una nota aparte que dirige la interpretación sin leerse en voz alta | $0.072 por 1.000 caracteres | $0.011 |
Elijas el que elijas, la voz no cuesta nada junto a la sincronización. Para lip sync, empieza con Gemini 3.8 Flash TTS: tiene los mismos controles que 2.5 Pro y cuesta menos. Cambia a MiniMax si quieres el ajuste emotion, o a Seed Speech 2.0 si prefieres su nota de interpretación en lenguaje llano.
Cuatro reglas evitan que el audio socave la imagen:
- Quédate dentro de 3 a 60 segundos. El inglés generado va de 12 a 19 caracteres por segundo, así que escribe al menos 60 caracteres (unas doce palabras); de 700 a 1.100 caracteres llenan 60 segundos. Mide el archivo, no el guion: una frase de 10 caracteres como "Come here." salió con 1.76 segundos y fue rechazada (las frases muy cortas van más lentas por carácter).
- Recorta el silencio en ambos extremos. Las voces de Gemini añaden de 0.1 a 0.3 segundos antes de la primera palabra y hasta 0.45 después de la última. La facturación redondea hacia arriba, así que una frase de 4.04 segundos se cobra como 5 segundos y la misma frase recortada por debajo de 4, como 4.
- Ajusta la interpretación al rostro. Un susurro con mucho aire sobre una cara que ríe se ve mal, por muy buena que sea la sincronización. Elige la emoción o el estilo que encaje con el metraje que tienes.
- Envía habla limpia. Sin música debajo. Si quieres una banda sonora, añádela después de la sincronización.
La voz cambia la boca tanto como las palabras. El mismo clip y las mismas palabras con la voz de MiniMax Speech 2.8 HD dan formas de boca distintas:
Los cuatro leen guiones para adultos; el detalle por modelo está en las páginas de los modelos de texto a voz.
Paso 3: pruébalo en el Playground y luego con la API
Pruébalo primero en el Playground, con tu propio clip y una frase:
- Abre la página de Gemini 3.8 Flash TTS, pega tu frase en Text, elige una Voice y ejecútalo. Descarga el WAV, o omite este paso si tienes tu propia grabación.
- Abre la página de Lip Sync, añade tu clip en Input video y el audio en Input audio, comprueba la estimación de precio y ejecútalo. Cuenta con una espera de unos minutos: unos cuatro para una frase de 10 segundos.
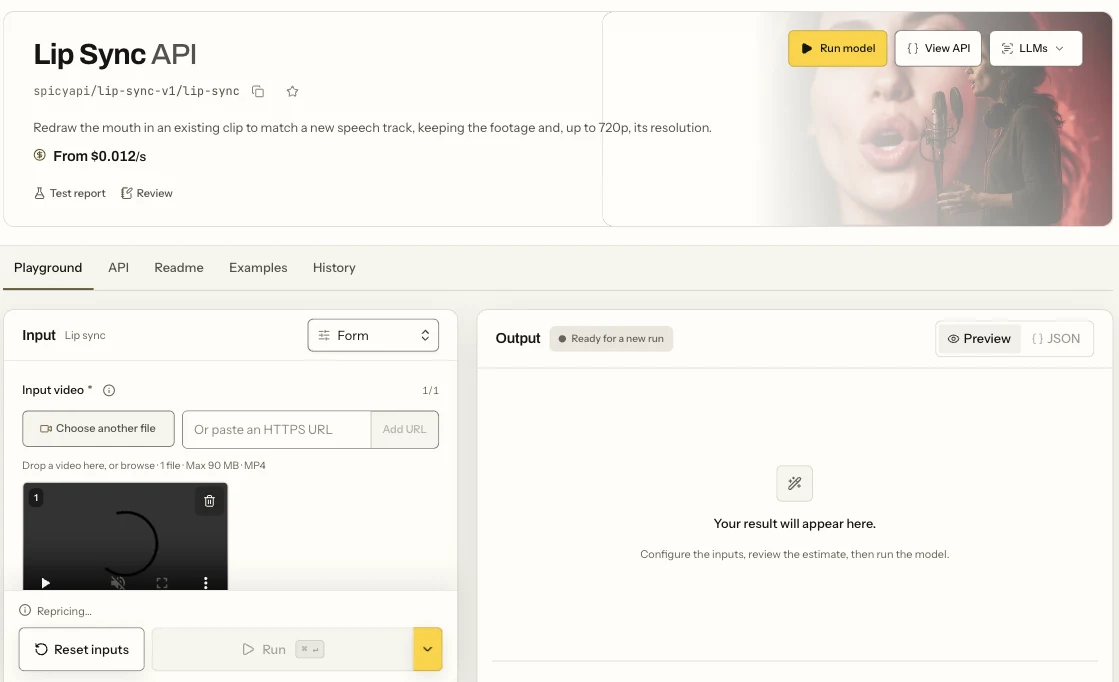
La página de Lip Sync en el Playground: la vista Form, el campo Input video donde añades tu clip y el botón Run.
Los límites que importan: un clip MP4 y un archivo MP3 o WAV, cada uno de hasta 90 MB.
Para tu propia aplicación, envía las mismas dos entradas como una sola tarea (sube primero el clip y el audio, como se explica en la guía de medios):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Solicitud completa, sondeo y callbacks: guía de tasks.
Deja que un agente lo ejecute
Usa el Playground para una frase puntual. Cuando voz, sincronización y recorte formen un flujo repetido, pásalo a un agente; las tres herramientas muestran el precio y preguntan antes de una llamada de pago.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, coninput.jsonconteniendo el objetoinputanterior (documentación de la CLI). - MCP: añade el servidor MCP y luego pregunta: "Lip-sync ./take.mp4 with ./line.wav." Llama a
spicyapi_upload_file,spicyapi_task_createyspicyapi_task_wait. - Skill:
npx skills add spicyapi-ai/spicy-skillinstala el Agent Skill, que hace que el asistente lea el esquema del modelo en vivo antes de construir la entrada.
Paso 4: comprueba el resultado donde se rompe
Un vídeo con lip sync puede verse bien durante el 90 % de su duración y desmoronarse en un momento. Ve a estos puntos:
- El primer medio segundo. ¿La boca se queda quieta hasta la primera palabra?
- Los sonidos P, B y M. Los labios deberían cerrarse por completo. Cierres débiles o ausentes son la señal más rápida de una sincronización deficiente.
- Cada múltiplo de la duración del clip, si la frase es más larga que el clip. Un clip de 5 segundos bajo una frase de 10 segundos se repite en 0:05 y 0:10. Ahí es donde se ve la costura.
- El último medio segundo. El archivo se prolonga unos 0.5 segundos más allá del audio, y la boca debería quedar en reposo ahí.
- Cualquier fotograma en el que una mano, un vaso o un giro de cabeza cruce la boca.
Cuando la frase es más larga que el clip
El bucle es un corte directo de vuelta al primer fotograma del clip, y ningún ajuste lo cambia. Se arregla con los archivos que envías:
- Alarga el clip. Generar un clip de origen tan largo como la frase es la solución limpia, y normalmente la más barata si vas a generar de todas formas.
- Divide la frase. Parte el guion en pausas naturales en trozos no más largos que el clip, sincroniza cada trozo por separado y une los resultados en tu editor. Cada trozo aún tiene que durar al menos 3 segundos.
- Elige una toma estable. Si tienes que repetir, un clip con poco movimiento de cabeza esconde mejor el salto que uno con un gesto grande.
Cuánto cuesta
Lip Sync factura por segundo de audio, redondeando hacia arriba, con un mínimo de 3 segundos. Con Gemini 3.8 Flash TTS para la voz:
| Duración de la frase | Voz (Gemini 3.8 Flash TTS) | Lip Sync | Total |
|---|---|---|---|
| 5 segundos | $0.0016 | $0.06 | unos $0.06 |
| 10 segundos | $0.0032 | $0.12 | unos $0.12 |
| 30 segundos | $0.0096 | $0.36 | unos $0.37 |
| 60 segundos | $0.0192 | $0.72 | unos $0.74 |
Mientras la tarea se ejecuta, la cotización retiene el máximo de 60 segundos ($0.72); la parte sin usar se libera en cuanto queda fijada la duración del audio. Un archivo fuera del rango de 3 a 60 segundos falla en segundos con invalid_request y no cuesta nada, y cualquier tarea fallida libera su retención por completo. El clip de origen, si lo generas, suele ser el coste más grande, y por eso volver a poner voz es barato: cada frase nueva cuesta unos $0.12 por 10 segundos en lugar de un render nuevo.
¿Lip Sync, Talking Avatar o Kling Avatar 2.0?
Los tres ponen tu audio en la boca de alguien. Lo que decide entre ellos es de dónde partes:
| Tienes | Usa | Precio | Salida | Conviene saber |
|---|---|---|---|---|
| Un clip con la persona ya en él | Lip Sync | $0.012 por segundo de audio | Hasta unos 720p, se conserva la actuación original | Audio de 3 a 60 segundos |
| Solo una foto de retrato | Talking Avatar | $0.018 por segundo | Unos 0.2 megapíxeles (640×352 desde una foto 16:9) | Añade parpadeos y pequeños movimientos de cabeza; audio de 3 a 60 segundos |
| Solo un retrato y necesitas 720p o 1080p o una toma más larga | Kling Avatar 2.0 | $0.0512 por segundo a 720p, $0.1024 a 1080p | 720p o 1080p | Audio de hasta unos 5 minutos. Kling modera las entradas: se rechazó un retrato con contenido de nivel fuerte, y una solicitud rechazada no se cobra |
Si tienes metraje, empieza por Lip Sync: es el más barato por segundo y el único que conserva una actuación real. Pasa a una herramienta de retrato solo cuando no haya metraje con el que trabajar.
FAQ
¿Puede Lip Sync traducir mi vídeo?
No. Sincroniza el audio que le das. Para hacer otra versión en otro idioma, traduce la frase tú mismo, dale voz con un modelo que hable ese idioma (Gemini 3.8 Flash TTS cubre más de 130 idiomas) y sincroniza el archivo nuevo sobre el mismo clip.
¿Qué pasa con el sonido original?
Se sustituye; la salida solo lleva el audio que enviaste.
¿Por qué mi tarea falló de inmediato?
El audio duraba menos de 3 segundos, más de 60 segundos, o no era MP3 ni WAV; el error indica la duración. Para una frase corta, añade palabras en lugar de silencio, porque el silencio cuenta para los segundos que pagas.
¿Funciona Lip Sync con material NSFW?
Sí para un solo adulto en pantalla: el clip pasa al precio normal y vuelve sin nada difuminado ni tapado. El modelo solo vuelve a dibujar la boca, así que necesita un rostro que hable a la cámara.
¿Puedo usar mi propia grabación de voz?
Sí. Cualquier MP3 o WAV de entre 3 y 60 segundos sobre el que tengas derechos funciona exactamente igual que una voz generada.
Siguiente paso
¿Ya tienes una toma que te gusta? Lip Sync más una de estas voces es la forma más barata de cambiar lo que dice un personaje: unos $0.12 por 10 segundos, sin render nuevo. Pruébalo con tu propio clip en la página del modelo Lip Sync, o lee la reseña de Lip Sync.