In breve: Lip Sync prende una clip che hai già più un file vocale da 3 a 60 secondi e ridisegna solo la bocca, così la persona inquadrata dice la tua battuta. Il video dura quanto l'audio, non quanto la clip. Il flusso: scrivi la battuta, dagli voce con un modello di sintesi vocale, invia clip e audio come un unico task asincrono, poi controlla i pochi punti temporali in cui la sincronizzazione si rompe. La voce costa una frazione di centesimo; la sincronizzazione costa $0.012 al secondo di audio, quindi una battuta di 10 secondi costa circa $0.12.
Sostituire la traccia audio con ffmpeg lascia la bocca dire altro, come in un film doppiato male. Ridisegnare la bocca è il lavoro del modello di lip sync.
Nei nostri test di ottobre 2026 le clip per adulti, dagli abbracci vestiti fino al materiale esplicitamente adulto, sono state accettate al prezzo normale, senza nulla di sfocato o ritagliato. Lip Sync ridisegna solo la bocca, quindi funziona meglio su una clip in cui la persona guarda la camera e parla; un bacio o un'inquadratura molto stretta non gli danno nulla da sincronizzare.
In sintesi
- Due file in ingresso, nessun prompt.
video_urlè la clip eaudio_urlè la nuova voce; non c'è altro da regolare. - L'audio determina la durata. Una clip più lunga viene tagliata alla lunghezza della battuta; una clip più corta va in loop finché la battuta non finisce. Le due durate dei file sono l'unico controllo che hai.
- L'audio deve durare da 3 a 60 secondi, in MP3 o WAV. Qualsiasi cosa fuori da questo intervallo fallisce in pochi secondi e non costa nulla.
- Paghi l'audio, al secondo, arrotondato per eccesso, con un minimo di 3 secondi. Il video restituito prosegue circa mezzo secondo oltre l'audio, e quella coda è gratuita.
- Ci vanno minuti, non secondi. Invialo e lascialo girare; una battuta di 10 secondi richiede circa quattro minuti.
Prima e dopo
A parte la durata, che ora segue la battuta, cambia solo la bocca. Espressione, movimento della testa, luce e inquadratura vengono dai fotogrammi originali, quindi Lip Sync è adatto a una ripresa che ti piace già e non può ravvivare una performance piatta.
Passo 1: parti da una clip che possa reggere una battuta
Il modello ridipinge la bocca e lascia tutto il resto intatto, quindi il girato decide per buona parte il risultato. Cosa funziona:
- Una persona, volto ragionevolmente grande nell'inquadratura, rivolto per lo più verso la camera. Un mezzo primo piano è la scelta sicura; un volto sullo sfondo lontano no.
- Un unico piano continuo. Un taglio netto a metà clip spezza la sincronizzazione nel punto di taglio.
- Una bocca libera. Una mano, un bicchiere, un microfono o una ciocca di capelli davanti alle labbra è il punto in cui la sincronizzazione scivola.
- Una performance adatta alla battuta. Poiché il resto del viso non viene toccato, un volto calmo con una battuta urlata si legge comunque come calmo.
La risoluzione si ferma a circa 720p: una clip 1920×1080 torna a 1280×720, e mandare 1080p non costa di più.
Se stai generando la clip sorgente
Chiedi al modello video una ripresa in cui la persona sta già parlando: il movimento della mandibola e della testa che rende credibile il parlato devono essere nella clip. Questo è il prompt di movimento che abbiamo usato su Seedance 2.0 Mini Spicy, partendo da un'immagine fissa dell'uomo al bar:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Imposta la durata della clip almeno alla lunghezza della tua battuta: Seedance 2.0 Mini Spicy accetta da 4 a 15 secondi. Lascia disattivato l'audio nativo, perché Lip Sync sostituisce la traccia sonora.
Due controlli prima di pagare la sincronizzazione:
- Blocca la camera. Una lenta spinta in avanti fa saltare il taglio del loop dal primo piano al primo fotogramma più largo, quindi controlla che non ce ne sia uno.
- Confronta il volto con la tua immagine fissa. Il passaggio da immagine a video può far slittare il volto nel giro di pochi secondi, e Lip Sync mantiene il volto che la clip ha. Scarta una clip con il volto slittato prima della sincronizzazione.
Perché non far produrre il suono al modello video?
Modelli video come Seedance 2.x, Wan 3.0 e Kling 3.0 possono generare suono insieme all'immagine. Va bene per l'ambiente o per dialoghi non precisi, ma l'audio è incorporato in un rendering completo: cambiare una sola parola significa pagare di nuovo tutta la clip. Una nuova battuta di 10 secondi costa circa $0.12 da sincronizzare, mentre rifare il rendering di una clip 720p di 10 secondi su Seedance 2.0 Mini Spicy costa $0.82.
Passo 2: scrivi la battuta e dagli voce
Funziona qualsiasi MP3 o WAV tra 3 e 60 secondi, compresa la tua registrazione. Se non hai un doppiatore, un modello di sintesi vocale è la strada più rapida. Questi quattro si prestano al lip sync:
| Modello | Come dirigi la recitazione | Prezzo di listino | Una battuta di 10 secondi costa circa |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Testo più una delle 30 voci, con style, accent, pace facoltativi e una nota di recitazione. I segni tra parentesi quadre, come [laughs], vengono di solito eseguiti invece che letti | $0.00032 al secondo di audio | $0.0032 |
| Gemini 2.5 Pro TTS | Gli stessi controlli di Flash; modello più vecchio, prezzo leggermente più alto | $0.00045 al secondo di audio | $0.0045 |
| MiniMax Speech 2.8 HD | Un'impostazione emotion. I segni vanno tra parentesi tonde, come (sighs) | $0.12 ogni 1.000 caratteri | $0.018 |
| Seed Speech 2.0 | 41 voci, 10 lingue e una nota separata che guida la recitazione senza essere letta ad alta voce | $0.072 ogni 1.000 caratteri | $0.011 |
Qualunque tu scelga, la voce costa quasi nulla rispetto alla sincronizzazione. Per il lip sync, inizia con Gemini 3.8 Flash TTS: ha gli stessi controlli di 2.5 Pro e costa meno. Passa a MiniMax per l'impostazione emotion, o a Seed Speech 2.0 se preferisci la sua nota di recitazione in linguaggio semplice.
Quattro regole impediscono all'audio di rovinare l'immagine:
- Resta tra 3 e 60 secondi. L'inglese generato corre da 12 a 19 caratteri al secondo, quindi scrivi almeno 60 caratteri (una dozzina di parole); da 700 a 1.100 caratteri riempiono 60 secondi. Misura il file, non il copione: una battuta di 10 caratteri come "Come here." è risultata di 1.76 secondi ed è stata rifiutata (le battute molto brevi corrono più lente per carattere).
- Taglia il silenzio a entrambe le estremità. Le voci Gemini aggiungono da 0.1 a 0.3 secondi prima della prima parola e fino a 0.45 dopo l'ultima. La fatturazione arrotonda per eccesso, quindi una battuta di 4.04 secondi viene addebitata come 5 secondi e la stessa battuta tagliata sotto i 4 come 4.
- Abbina la recitazione al volto. Un sussurro soffiato sopra un volto che ride sembra sbagliato, per quanto buona sia la sincronizzazione. Scegli l'emozione o lo stile che si adatta al girato che hai.
- Manda una voce pulita. Nessuna musica sotto. Se vuoi un sottofondo musicale, aggiungilo dopo la sincronizzazione.
La voce cambia la bocca tanto quanto le parole. La stessa clip e le stesse parole con la voce di MiniMax Speech 2.8 HD danno forme della bocca diverse:
Tutti e quattro leggono copioni per adulti; il dettaglio per singolo modello è nelle pagine dei modelli di sintesi vocale.
Passo 3: provalo nel Playground, poi con le API
Provalo prima nel Playground, con la tua clip e una battuta:
- Apri la pagina Gemini 3.8 Flash TTS, incolla la battuta in Text, scegli una Voice ed esegui. Scarica il WAV, oppure salta questo passo se hai una registrazione tua.
- Apri la pagina Lip Sync, aggiungi la clip sotto Input video e l'audio sotto Input audio, controlla la stima del prezzo ed esegui. Prevedi un'attesa di minuti: circa quattro per una battuta di 10 secondi.
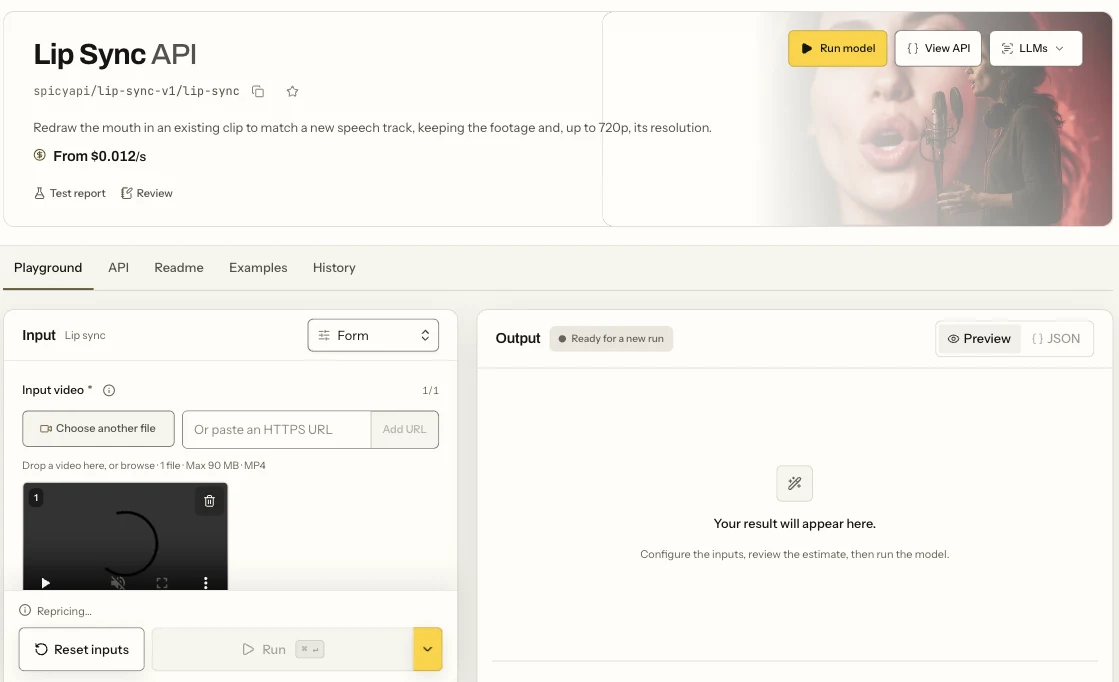
La pagina Lip Sync nel Playground: la vista Form, il campo Input video in cui aggiungi la clip e il pulsante Run.
I limiti che contano: una clip MP4 e un file MP3 o WAV, ciascuno fino a 90 MB.
Per la tua applicazione, manda gli stessi due input come un unico task (carica prima clip e audio, come spiegato nella guida dei media):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Richiesta completa, polling e callback: guida ai task.
Fai eseguire il lavoro a un agente
Usa il Playground per una battuta una tantum. Quando voce, sincronizzazione e taglio diventano un flusso ripetuto, affidalo a un agente; tutti e tre gli strumenti mostrano il prezzo e chiedono prima di una chiamata a pagamento.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, coninput.jsonche contiene l'oggettoinputqui sopra (documentazione CLI). - MCP: aggiungi il server MCP, poi chiedi: "Lip-sync ./take.mp4 with ./line.wav." Chiama
spicyapi_upload_file,spicyapi_task_createespicyapi_task_wait. - Skill:
npx skills add spicyapi-ai/spicy-skillinstalla l'Agent Skill, che fa leggere all'assistente lo schema del modello prima che costruisca l'input.
Passo 4: controlla il risultato dove si rompe
Un video con lip sync può stare benissimo per il 90% della sua durata e crollare in un solo momento. Vai a questi punti:
- Il primo mezzo secondo. La bocca resta ferma fino alla prima parola?
- I suoni P, B e M. Le labbra dovrebbero chiudersi completamente. Chiusure morbide o assenti sono il segno più rapido di una sincronizzazione debole.
- Ogni multiplo della durata della clip, se la battuta è più lunga della clip. Una clip di 5 secondi sotto una battuta di 10 secondi si ripete a 0:05 e 0:10. È lì che si vede la giuntura.
- L'ultimo mezzo secondo. Il file prosegue circa 0.5 secondi oltre l'audio, e la bocca dovrebbe restare a riposo.
- Ogni fotogramma in cui una mano, un bicchiere o un movimento di testa attraversa la bocca.
Quando la battuta è più lunga della clip
Il loop è un taglio diretto al primo fotogramma della clip, e nessuna impostazione lo cambia. Si risolve con i file che mandi:
- Allunga la clip. Generare una clip sorgente lunga quanto la battuta è la soluzione pulita, ed è di solito la più economica se stai comunque generando.
- Spezza la battuta. Spezza il copione nelle pause naturali in pezzi non più lunghi della clip, sincronizza ogni pezzo separatamente e unisci i risultati nel tuo editor. Ogni pezzo deve comunque durare almeno 3 secondi.
- Scegli una ripresa stabile. Se devi fare il loop, una clip con poco movimento della testa nasconde meglio il salto rispetto a una con un gesto ampio.
Quanto costa
Lip Sync fattura al secondo di audio, arrotondato per eccesso, con un minimo di 3 secondi. Con Gemini 3.8 Flash TTS per la voce:
| Lunghezza della battuta | Voce (Gemini 3.8 Flash TTS) | Lip Sync | Totale |
|---|---|---|---|
| 5 secondi | $0.0016 | $0.06 | circa $0.06 |
| 10 secondi | $0.0032 | $0.12 | circa $0.12 |
| 30 secondi | $0.0096 | $0.36 | circa $0.37 |
| 60 secondi | $0.0192 | $0.72 | circa $0.74 |
Mentre il task è in esecuzione, il preventivo trattiene il massimo di 60 secondi ($0.72); la parte non utilizzata viene liberata quando la durata dell'audio è definita. Un file fuori dal range da 3 a 60 secondi fallisce in pochi secondi con invalid_request e non costa nulla, e qualsiasi task fallito rilascia del tutto la sua trattenuta. La clip sorgente, se la generi, è di solito la voce di costo più grande, ed è per questo che rifare la voce conviene: ogni nuova battuta costa circa $0.12 ogni 10 secondi invece di un nuovo rendering.
Lip Sync, Talking Avatar o Kling Avatar 2.0?
Tutti e tre mettono il tuo audio nella bocca di qualcuno. A decidere tra loro è il punto di partenza:
| Hai | Usa | Prezzo | Output | Da sapere |
|---|---|---|---|---|
| Una clip con la persona già dentro | Lip Sync | $0.012 al secondo di audio | Fino a circa 720p, la performance originale viene mantenuta | Audio da 3 a 60 secondi |
| Solo una foto di ritratto | Talking Avatar | $0.018 al secondo | Circa 0.2 megapixel (640×352 da una foto 16:9) | Aggiunge battiti di ciglia e piccoli movimenti della testa; audio da 3 a 60 secondi |
| Solo un ritratto, e ti servono 720p o 1080p o una ripresa più lunga | Kling Avatar 2.0 | $0.0512 al secondo a 720p, $0.1024 a 1080p | 720p o 1080p | Audio fino a circa 5 minuti. Kling modera gli input: un ritratto con contenuto di livello forte è stato rifiutato, e una richiesta rifiutata non viene fatturata |
Se hai del girato, parti da Lip Sync: è il più economico al secondo ed è l'unico che conserva una performance reale. Passa a uno strumento per ritratti solo quando non c'è girato su cui lavorare.
FAQ
Lip Sync può tradurre il mio video?
No. Sincronizza l'audio che gli dai. Per fare una versione in un'altra lingua, traduci tu la battuta, dagli voce con un modello che parla quella lingua (Gemini 3.8 Flash TTS copre oltre 130 lingue) e sincronizza il nuovo file sulla stessa clip.
Che fine fa il suono originale?
Viene sostituito; l'output porta solo l'audio che hai inviato.
Perché il mio task è fallito subito?
L'audio era sotto i 3 secondi, sopra i 60 secondi, oppure non era MP3 o WAV; l'errore indica la durata. Per una battuta corta, aggiungi parole invece di silenzio, perché il silenzio conta nei secondi che paghi.
Lip Sync funziona con materiale NSFW?
Sì per un solo adulto inquadrato: la clip passa al prezzo normale e torna senza nulla di sfocato o coperto. Il modello ridisegna solo la bocca, quindi ha bisogno di un volto che parli verso la camera.
Posso usare la mia registrazione vocale?
Sì. Qualsiasi MP3 o WAV tra 3 e 60 secondi di cui hai i diritti funziona esattamente come una voce generata.
Passo successivo
Hai già una ripresa che ti piace? Lip Sync più una di queste voci è il modo più economico di cambiare ciò che dice un personaggio: circa $0.12 ogni 10 secondi, senza nuovi rendering. Provalo sulla tua clip alla pagina del modello Lip Sync, oppure leggi la recensione di Lip Sync.