Resumindo: Lip Sync recebe um clipe que você já tem mais um arquivo de voz de 3 a 60 segundos e redesenha apenas a boca, para que a pessoa na tela diga a sua fala. O vídeo dura o que durar o áudio, não o clipe. O fluxo: escrever a fala, dar voz a ela com um modelo de síntese de voz, enviar clipe e áudio como uma única tarefa assíncrona e depois conferir os poucos pontos de tempo em que a sincronização se quebra. A voz custa uma fração de centavo; a sincronização custa $0.012 por segundo de áudio, então uma fala de 10 segundos custa cerca de $0.12.
Trocar a trilha de áudio com ffmpeg deixa a boca dizendo outra coisa, como num filme mal dublado. Redesenhar a boca é trabalho do modelo de sincronização labial.
Nos nossos testes de outubro de 2026, clipes adultos, de abraços com roupa até material claramente adulto, foram aceitos pelo preço normal, sem nada borrado nem cortado. O Lip Sync redesenha apenas a boca, então funciona melhor num clipe em que a pessoa olha para a câmera e fala; beijos ou planos muito fechados não dão a ele nada para sincronizar.
Em resumo
- Dois arquivos de entrada, sem prompt.
video_urlé o clipe eaudio_urlé a nova voz; não há mais nada para ajustar. - O áudio define a duração. Um clipe mais longo é cortado até a fala; um clipe mais curto se repete até a fala terminar. As durações dos dois arquivos são seu único controle.
- O áudio deve ter de 3 a 60 segundos, em MP3 ou WAV. Qualquer coisa fora dessa faixa falha em segundos e não custa nada.
- Você paga pelo áudio, por segundo, arredondado para cima, com mínimo de 3 segundos. O vídeo devolvido dura cerca de meio segundo além do áudio, e essa cauda é gratuita.
- Leva minutos, não segundos. Envie e deixe rodar; uma fala de 10 segundos leva cerca de quatro minutos.
Antes e depois
Além da duração, que agora acompanha a fala, só a boca muda. Expressão, movimento de cabeça, luz e enquadramento vêm dos quadros originais, então o Lip Sync serve para uma tomada de que você já gosta e não consegue dar vida a uma atuação rasa.
Passo 1: comece com um clipe capaz de carregar uma fala
O modelo repinta a boca e deixa tudo o mais intacto, então o material decide a maior parte do resultado. O que funciona:
- Uma pessoa, com o rosto razoavelmente grande no quadro e virado principalmente para a câmera. Um plano médio fechado é a escolha segura; um rosto no fundo distante não é.
- Um único plano contínuo. Um corte duro no meio do clipe quebra a sincronização no ponto do corte.
- Uma boca livre. Uma mão, um copo, um microfone ou uma mecha de cabelo sobre os lábios é onde a sincronização escorrega.
- Uma atuação que combine com a fala. Como o resto do rosto não é tocado, um rosto calmo com uma fala gritada continua sendo lido como calmo.
A resolução chega no máximo a 720p: um clipe 1920×1080 volta em 1280×720, e mandar 1080p não custa mais.
Se você está gerando o clipe de origem
Peça ao modelo de vídeo uma tomada em que a pessoa já está falando: o movimento da mandíbula e da cabeça que faz a fala parecer real precisa estar no clipe. Este é o prompt de movimento que usamos no Seedance 2.0 Mini Spicy, começando de uma imagem fixa do homem no bar:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Defina a duração do clipe pelo menos igual à duração da sua fala: o Seedance 2.0 Mini Spicy aceita de 4 a 15 segundos. Deixe o áudio nativo desligado, porque o Lip Sync substitui a trilha de som.
Duas verificações antes de pagar pela sincronização:
- Trave a câmera. Um push-in lento faz o corte do loop saltar do plano fechado de volta para o primeiro quadro mais aberto, então procure um.
- Compare o rosto com a sua imagem fixa. A conversão de imagem em vídeo pode alterar o rosto ao longo de alguns segundos, e o Lip Sync mantém o rosto que o clipe tiver. Descarte um clipe com o rosto alterado antes da sincronização.
Por que não deixar o modelo de vídeo fazer o som?
Modelos de vídeo como Seedance 2.x, Wan 3.0 e Kling 3.0 conseguem gerar som junto com a imagem. Isso serve para ambientação ou diálogos soltos, mas o áudio vem assado em uma renderização completa: mudar uma única palavra significa pagar pelo clipe inteiro de novo. Uma nova fala de 10 segundos custa cerca de $0.12 para sincronizar, enquanto refazer a renderização de um clipe 720p de 10 segundos no Seedance 2.0 Mini Spicy custa $0.82.
Passo 2: escreva a fala e dê voz a ela
Qualquer MP3 ou WAV entre 3 e 60 segundos serve, inclusive a sua própria gravação. Se você não tem um dublador, um modelo de síntese de voz é o caminho mais rápido. Estes quatro funcionam bem com sincronização labial:
| Modelo | Como você dirige a interpretação | Preço de tabela | Uma fala de 10 segundos custa cerca de |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Texto mais uma das 30 vozes, com style, accent, pace opcionais e uma nota de entrega. Marcas entre colchetes, como [laughs], costumam ser interpretadas em vez de lidas | $0.00032 por segundo de áudio | $0.0032 |
| Gemini 2.5 Pro TTS | Os mesmos controles do Flash; modelo mais antigo, preço um pouco maior | $0.00045 por segundo de áudio | $0.0045 |
| MiniMax Speech 2.8 HD | Um ajuste de emotion. As marcas vão entre parênteses, como (sighs) | $0.12 por 1.000 caracteres | $0.018 |
| Seed Speech 2.0 | 41 vozes, 10 idiomas e uma nota separada que dirige a interpretação sem ser lida em voz alta | $0.072 por 1.000 caracteres | $0.011 |
Qualquer que seja sua escolha, a voz custa quase nada em comparação com a sincronização. Para sincronização labial, comece com o Gemini 3.8 Flash TTS: ele tem os mesmos controles do 2.5 Pro e custa menos. Troque para o MiniMax se quiser o ajuste emotion, ou para o Seed Speech 2.0 se quiser a nota de entrega em linguagem simples.
Quatro regras evitam que o áudio sabote a imagem:
- Fique entre 3 e 60 segundos. O inglês gerado corre de 12 a 19 caracteres por segundo, então escreva pelo menos 60 caracteres (uma dúzia de palavras); de 700 a 1.100 caracteres preenchem 60 segundos. Meça o arquivo, não o roteiro: uma fala de 10 caracteres como "Come here." saiu com 1.76 segundo e foi rejeitada (falas muito curtas correm mais devagar por caractere).
- Corte o silêncio nas duas pontas. As vozes do Gemini acrescentam de 0.1 a 0.3 segundos antes da primeira palavra e até 0.45 depois da última. A cobrança arredonda para cima, então uma fala de 4.04 segundos é cobrada como 5 segundos, e a mesma fala cortada abaixo de 4 segundos é cobrada como 4.
- Combine a interpretação com o rosto. Um sussurro ofegante sobre um rosto que ri fica estranho, por melhor que seja a sincronização. Escolha a emoção ou o estilo que combina com o material que você tem.
- Envie fala limpa. Sem música embaixo. Se quiser uma trilha, adicione depois da sincronização.
A voz muda a boca tanto quanto as palavras. O mesmo clipe e as mesmas palavras com a voz do MiniMax Speech 2.8 HD dão formas de boca diferentes:
Os quatro leem roteiros para adultos; o detalhe de cada modelo está nas páginas dos modelos de texto para fala.
Passo 3: teste no Playground e depois na API
Teste primeiro no Playground, com o seu próprio clipe e uma fala:
- Abra a página do Gemini 3.8 Flash TTS, cole sua fala em Text, escolha uma Voice e execute. Baixe o WAV, ou pule este passo se você tiver a sua própria gravação.
- Abra a página do Lip Sync, adicione seu clipe em Input video e o áudio em Input audio, confira a estimativa de preço e execute. Espere alguns minutos: cerca de quatro para uma fala de 10 segundos.
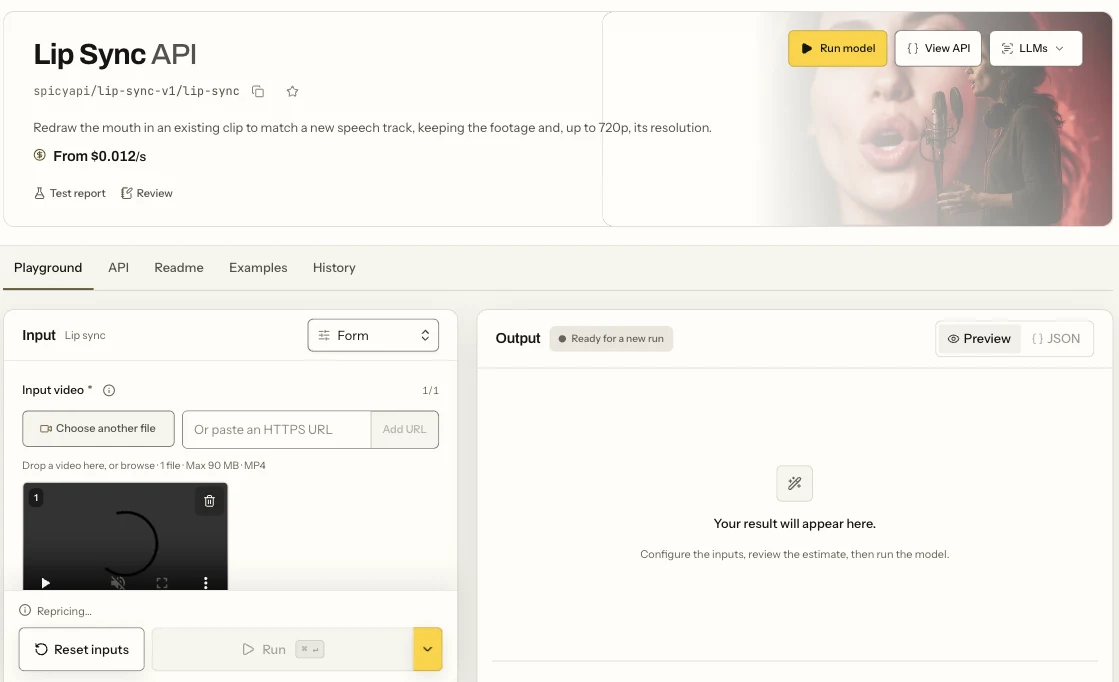
A página do Lip Sync no Playground: a visão Form, o campo Input video onde você adiciona seu clipe e o botão Run.
Os limites que importam: um clipe MP4 e um arquivo MP3 ou WAV, cada um de até 90 MB.
Para o seu próprio aplicativo, envie as mesmas duas entradas como uma única tarefa (envie o clipe e o áudio primeiro, como explicado no guia de mídia):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Requisição completa, sondagem e callbacks: guia de tasks.
Deixe um agente executar
Use o Playground para uma fala única. Quando voz, sincronização e corte virarem um fluxo repetido, entregue a um agente; as três ferramentas mostram o preço e pedem confirmação antes de uma chamada paga.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, com oinput.jsoncontendo o objetoinputacima (documentação da CLI). - MCP: adicione o servidor MCP e então pergunte: "Lip-sync ./take.mp4 with ./line.wav." Ele chama
spicyapi_upload_file,spicyapi_task_createespicyapi_task_wait. - Skill:
npx skills add spicyapi-ai/spicy-skillinstala o Agent Skill, que faz o assistente ler o esquema do modelo ao vivo antes de montar a entrada.
Passo 4: confira o resultado onde ele se quebra
Um vídeo com sincronização labial pode parecer bom por 90% da duração e desmoronar em um instante. Vá até estes pontos:
- O primeiro meio segundo. A boca fica parada até a primeira palavra?
- Os sons P, B e M. Os lábios devem fechar por completo. Fechamentos frouxos ou ausentes são o sinal mais rápido de uma sincronização fraca.
- Cada múltiplo da duração do clipe, se a fala for mais longa que o clipe. Um clipe de 5 segundos sob uma fala de 10 segundos se repete em 0:05 e 0:10. É aí que a emenda aparece.
- O último meio segundo. O arquivo dura cerca de 0.5 segundo além do áudio, e a boca deve repousar ali.
- Qualquer quadro em que uma mão, um copo ou uma virada de cabeça atravesse a boca.
Quando a fala é mais longa que o clipe
O loop é um corte direto de volta ao primeiro quadro do clipe, e nenhuma configuração muda isso. Corrija com os arquivos que você envia:
- Deixe o clipe mais longo. Gerar um clipe de origem tão longo quanto a fala é a solução limpa e normalmente a mais barata, se você já vai gerar.
- Divida a fala. Quebre o roteiro nas pausas naturais em pedaços não mais longos que o clipe, sincronize cada pedaço separadamente e junte os resultados no seu editor. Cada pedaço ainda precisa ter pelo menos 3 segundos.
- Escolha uma tomada estável. Se você precisar repetir, um clipe com pouco movimento de cabeça esconde melhor o salto do que um com um gesto grande.
Quanto custa
O Lip Sync cobra por segundo de áudio, arredondado para cima, com mínimo de 3 segundos. Com o Gemini 3.8 Flash TTS para a voz:
| Duração da fala | Voz (Gemini 3.8 Flash TTS) | Lip Sync | Total |
|---|---|---|---|
| 5 segundos | $0.0016 | $0.06 | cerca de $0.06 |
| 10 segundos | $0.0032 | $0.12 | cerca de $0.12 |
| 30 segundos | $0.0096 | $0.36 | cerca de $0.37 |
| 60 segundos | $0.0192 | $0.72 | cerca de $0.74 |
Enquanto a tarefa roda, a cotação reserva o máximo de 60 segundos ($0.72); a parte não usada é liberada assim que a duração do áudio é definida. Um arquivo fora da faixa de 3 a 60 segundos falha em segundos com invalid_request e não custa nada, e qualquer tarefa que falhe libera a reserva inteira. O clipe de origem, se você o gerar, costuma ser o maior custo, e é por isso que dar voz de novo é barato: cada fala nova custa cerca de $0.12 por 10 segundos em vez de uma nova renderização.
Lip Sync, Talking Avatar ou Kling Avatar 2.0?
Os três colocam seu áudio na boca de alguém. O que decide entre eles é o seu ponto de partida:
| Você tem | Use | Preço | Saída | Vale saber |
|---|---|---|---|---|
| Um clipe com a pessoa já nele | Lip Sync | $0.012 por segundo de áudio | Até cerca de 720p, a atuação original é mantida | Áudio de 3 a 60 segundos |
| Só uma foto de retrato | Talking Avatar | $0.018 por segundo | Cerca de 0.2 megapixels (640×352 a partir de uma foto 16:9) | Adiciona piscadas e pequenos movimentos de cabeça; áudio de 3 a 60 segundos |
| Só um retrato e você precisa de 720p ou 1080p ou de uma tomada mais longa | Kling Avatar 2.0 | $0.0512 por segundo em 720p, $0.1024 em 1080p | 720p ou 1080p | Áudio de até cerca de 5 minutos. O Kling modera as entradas: um retrato com conteúdo de nível forte foi recusado, e uma solicitação recusada não é cobrada |
Se você tem material, comece pelo Lip Sync: é o mais barato por segundo e o único que preserva uma atuação real. Vá para uma ferramenta de retrato só quando não houver material para trabalhar.
FAQ
O Lip Sync traduz o meu vídeo?
Não. Ele sincroniza o áudio que você fornece. Para fazer uma versão em outro idioma, traduza a fala você mesmo, dê voz a ela com um modelo que fale esse idioma (o Gemini 3.8 Flash TTS cobre mais de 130 idiomas) e sincronize o arquivo novo no mesmo clipe.
O que acontece com o som original?
Ele é substituído; a saída carrega apenas o áudio que você enviou.
Por que minha tarefa falhou logo de cara?
O áudio tinha menos de 3 segundos, mais de 60 segundos, ou não era MP3 nem WAV; o erro informa a duração. Para uma fala curta, acrescente palavras em vez de silêncio, porque o silêncio conta para os segundos que você paga.
O Lip Sync funciona em material NSFW?
Sim para um único adulto na tela: o clipe passa pelo preço normal e volta sem nada borrado ou coberto. O modelo só redesenha a boca, então precisa de um rosto que fale para a câmera.
Posso usar minha própria gravação de voz?
Sim. Qualquer MP3 ou WAV entre 3 e 60 segundos sobre o qual você tenha os direitos funciona exatamente como uma voz gerada.
Próximo passo
Já tem uma tomada de que você gosta? Lip Sync mais uma dessas vozes é o jeito mais barato de mudar o que um personagem fala: cerca de $0.12 por 10 segundos, sem nova renderização. Teste no seu próprio clipe na página do modelo Lip Sync, ou leia a avaliação do Lip Sync.