한 줄 답변: Lip Sync는 손에 있는 클립과 3~60초짜리 음성 파일을 받아서 입만 다시 그리므로, 화면 속 인물이 내 대사를 말하게 됩니다. 영상 길이는 클립이 아니라 오디오를 따릅니다. 순서는 이렇습니다. 대사를 쓰고, 텍스트 음성 변환 모델로 음성을 만들고, 클립과 오디오를 하나의 비동기 작업으로 보내고, 싱크가 어긋나는 몇몇 타임스탬프를 확인합니다. 음성 비용은 1센트도 안 되는 값이고, 싱크는 오디오 1초당 $0.012이므로 10초짜리 대사는 약 $0.12입니다.
ffmpeg로 오디오 트랙을 바꾸면 입이 다른 말을 하게 됩니다. 대충 더빙한 영화와 같습니다. 입을 다시 그리는 것이 립싱크 모델의 몫입니다.
2026년 10월 테스트에서 옷을 입은 포옹부터 분명한 성인 자료까지 성인 클립이 정상 가격으로 처리되었고, 뭉개지거나 잘린 부분은 없었습니다. Lip Sync는 입만 다시 그리므로 카메라를 향해 말하는 인물이 있는 클립에서 가장 잘 맞습니다. 키스나 지나치게 잘라낸 샷은 싱크할 대상이 남아 있지 않습니다.
30초 요약
- 파일 두 개만 넣으면 되고, 프롬프트는 없습니다.
video_url이 클립이고audio_url이 새 음성입니다. 따로 조정할 것은 없습니다. - 길이는 오디오가 정합니다. 더 긴 클립은 대사 길이로 잘리고, 더 짧은 클립은 대사가 끝날 때까지 반복됩니다. 두 파일의 길이가 유일한 제어 수단입니다.
- 오디오는 3~60초의 MP3 또는 WAV여야 합니다. 이 범위를 벗어나면 몇 초 만에 실패하고 비용도 없습니다.
- 요금은 오디오에 대해 초 단위, 올림 계산, 최소 3초입니다. 돌아오는 영상은 오디오보다 약 반 초 더 길게 끝나며, 그 끝부분은 무료입니다.
- 소요 시간은 초가 아니라 분입니다. 제출하고 두면 됩니다. 10초짜리 대사는 약 4분이 걸립니다.
Before와 After
길이가 이제 대사를 따르게 된다는 점 외에는, 달라지는 것은 입뿐입니다. 표정, 머리 움직임, 조명, 구도는 원본 프레임에서 오므로, Lip Sync는 이미 마음에 드는 테이크에 적합하며 평평한 연기를 생생하게 만들어내지는 못합니다.
1단계: 대사를 담을 수 있는 클립에서 시작하기
모델은 입만 다시 칠하고 나머지는 그대로 두므로, 결과의 대부분은 영상이 결정합니다. 통하는 조건은 다음과 같습니다.
- 한 명, 얼굴이 화면에 어느 정도 크게, 대부분 카메라를 향하게. 미디엄 클로즈업이 안전한 선택이고, 아주 먼 배경의 얼굴은 안 됩니다.
- 하나의 연속된 장면. 클립 중간에 하드 컷이 있으면 그 컷 지점에서 싱크가 끊어집니다.
- 또렷한 입. 손, 유리잔, 마이크, 입술을 가로지르는 머리카락이 있으면 그곳에서 싱크가 어긋납니다.
- 대사와 맞는 연기. 얼굴의 나머지는 건드리지 않으므로, 차분한 얼굴에 소리치는 대사를 붙여도 여전히 차분해 보입니다.
해상도는 약 720p가 한계입니다. 1920×1080 클립은 1280×720로 돌아오고, 1080p를 보내도 더 비싸지 않습니다.
원본 클립을 직접 생성한다면
이미 말하고 있는 테이크를 영상 모델에 요청하세요. 발화가 진짜처럼 보이게 하는 턱과 머리 움직임이 클립 안에 있어야 합니다. 바에 서 있는 남자의 스틸 이미지에서 시작해 Seedance 2.0 Mini Spicy에서 사용한 모션 프롬프트입니다.
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
클립 길이는 대사 길이 이상으로 설정하세요. Seedance 2.0 Mini Spicy는 4~15초를 받습니다. Lip Sync가 사운드 트랙을 대체하므로 네이티브 오디오는 꺼 두세요.
싱크 비용을 지불하기 전에 확인할 두 가지:
- 카메라를 고정하세요. 느린 돌리인에서는 반복 컷이 클로즈업에서 더 넓은 첫 프레임으로 튀어 갑니다. 그런 컷이 있는지 살펴보세요.
- 얼굴을 스틸 이미지와 비교하세요. 이미지에서 영상으로 변환하는 과정에서 몇 초에 걸쳐 얼굴이 달라질 수 있고, Lip Sync는 클립에 있는 얼굴을 그대로 유지합니다. 얼굴이 달라진 클립은 싱크 전에 버리세요.
왜 영상 모델에 소리를 맡기지 않는가
Seedance 2.x, Wan 3.0, Kling 3.0 같은 영상 모델은 이미지와 함께 소리를 만들 수 있습니다. 앰비언스나 대략적인 대사에는 괜찮지만, 오디오는 완성된 렌더에 함께 구워집니다. 단어 하나를 바꾸면 클립 전체 값을 다시 지불해야 합니다. 새 10초짜리 대사를 싱크하는 비용은 약 $0.12인 반면, Seedance 2.0 Mini Spicy에서 10초짜리 720p 클립을 다시 렌더하면 $0.82입니다.
2단계: 대사를 쓰고 음성 만들기
3~60초 사이의 MP3나 WAV면 무엇이든 됩니다. 직접 녹음한 파일도 마찬가지입니다. 성우가 없다면 텍스트 음성 변환 모델이 가장 빠른 길입니다. 다음 네 모델이 립싱크에 잘 맞습니다.
| 모델 | 읽는 방식을 어떻게 지정하나 | 정가 | 10초짜리 대사 비용 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 텍스트에 30개 음성 중 하나를 고르고, 선택적으로 style, accent, pace와 읽는 법 메모를 넣습니다. [laughs] 같은 대괄호 지시는 대개 읽지 않고 연기합니다 | 오디오 1초당 $0.00032 | $0.0032 |
| Gemini 2.5 Pro TTS | Flash와 같은 조절 항목. 오래된 모델이라 가격이 약간 높습니다 | 오디오 1초당 $0.00045 | $0.0045 |
| MiniMax Speech 2.8 HD | emotion 설정 하나. 지시는 (sighs)처럼 괄호로 씁니다 | 1,000자당 $0.12 | $0.018 |
| Seed Speech 2.0 | 음성 41개, 언어 10개, 그리고 소리 내어 읽히지 않으면서 읽는 방식을 이끄는 별도 메모 | 1,000자당 $0.072 | $0.011 |
어느 것을 고르든 싱크와 비교하면 음성 비용은 거의 0입니다. 립싱크라면 Gemini 3.8 Flash TTS로 시작하세요. 2.5 Pro와 조절 항목이 같으면서 더 저렴합니다. emotion 설정이 필요하면 MiniMax로, 평이한 언어의 읽기 메모를 원하면 Seed Speech 2.0으로 바꾸세요.
오디오가 화면을 망가뜨리지 않게 하는 네 가지 규칙:
- 3~60초 안에 머무르세요. 생성된 영어는 1초에 12~19자로 진행되므로 최소 60자(대략 열두 단어)는 쓰세요. 700~1,100자로 60초가 채워집니다. 스크립트가 아니라 파일을 재세요. 10자짜리 "Come here."는 1.76초로 나왔고 거부되었습니다(아주 짧은 대사는 글자당 속도가 더 느립니다).
- 양 끝의 침묵을 잘라내세요. Gemini 음성은 첫 단어 앞에 0.1~0.3초, 마지막 단어 뒤에 최대 0.45초를 붙입니다. 과금은 올림이므로 4.04초짜리 대사는 5초로 청구되고, 같은 대사를 4초 미만으로 잘라내면 4초로 청구됩니다.
- 읽는 방식을 얼굴에 맞추세요. 웃고 있는 얼굴 위에 숨소리 섞인 속삭임을 얹으면 싱크가 아무리 좋아도 어색해 보입니다. 손에 있는 영상에 맞는 감정이나 스타일을 고르세요.
- 배경음악 없는 음성을 보내세요. 아래에 음악을 깔지 마세요. 스코어를 원한다면 싱크 뒤에 더하세요.
음성은 단어만큼이나 입을 바꿉니다. 같은 클립과 같은 단어를 MiniMax Speech 2.8 HD로 읽으면 입 모양이 달라집니다.
네 모델 모두 성인용 대본을 읽습니다. 모델별 세부 내용은 텍스트 음성 변환 모델 목록의 각 모델 페이지에서 확인할 수 있습니다.
3단계: Playground에서 먼저, 그다음 API로
먼저 Playground에서 직접 가진 클립과 대사 하나로 해 보세요.
- Gemini 3.8 Flash TTS 페이지를 열고 Text에 대사를 붙여 넣고, Voice를 골라 실행합니다. WAV를 내려받거나, 직접 녹음한 것이 있다면 이 단계를 건너뛰세요.
- Lip Sync 페이지를 열고 Input video에 클립을, Input audio에 오디오를 넣고, 가격 예상치를 확인한 뒤 실행합니다. 몇 분 정도 기다려야 합니다. 10초짜리 대사는 약 4분입니다.
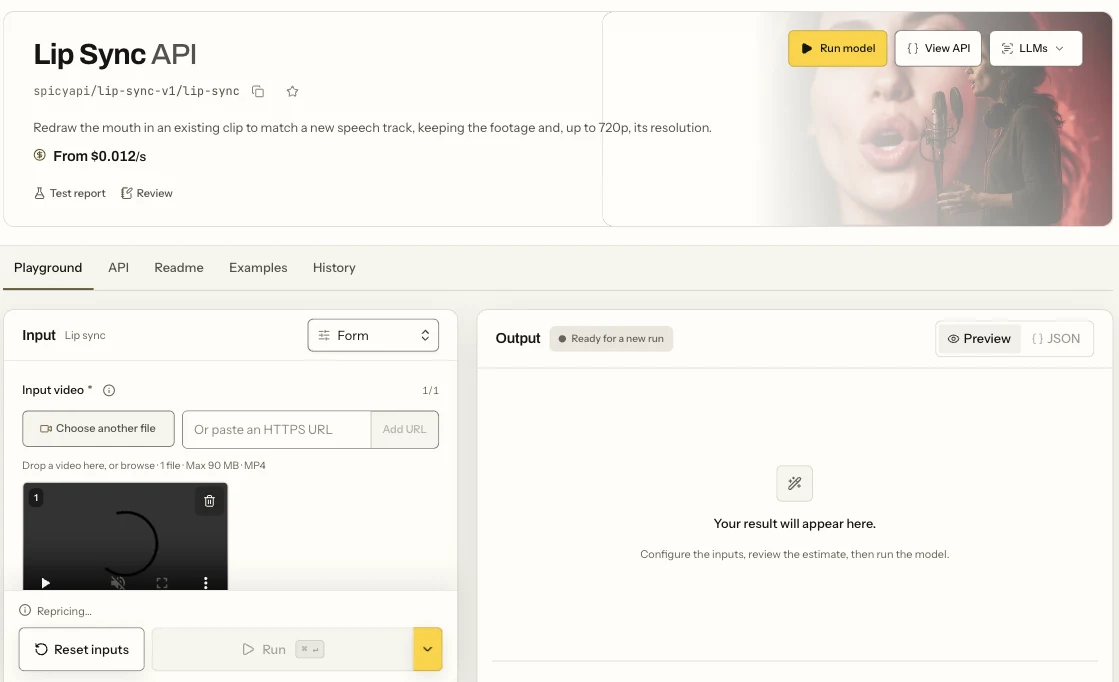
Playground의 Lip Sync 페이지. Form 뷰, 클립을 넣는 Input video 필드, 그리고 Run 버튼.
핵심 제한: MP4 클립 하나와 MP3 또는 WAV 파일 하나로 각각 90 MB까지입니다.
자기 앱에서는 같은 두 입력을 하나의 작업으로 보내세요. 클립과 오디오는 먼저 업로드합니다(media 가이드 참고).
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
전체 요청, 폴링, 콜백은 tasks 가이드를 참고하세요.
Agent에게 맡기기
한 번 쓸 대사라면 Playground면 충분합니다. 음성, 싱크, 자르기가 반복되는 흐름이라면 Agent에게 맡기세요. 세 도구 모두 가격을 표시하고 유료 호출 전에 확인을 요청합니다.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait.input.json에는 위의input객체를 넣습니다(CLI 문서). - MCP: MCP 서버를 추가한 뒤 이렇게 물어보세요. "Lip-sync ./take.mp4 with ./line.wav."
spicyapi_upload_file,spicyapi_task_create,spicyapi_task_wait를 호출합니다. - Skill:
npx skills add spicyapi-ai/spicy-skill로 Agent Skill을 설치하면, 어시스턴트가 입력을 만들기 전에 현재 모델 스키마를 읽습니다.
4단계: 어긋나는 지점에서 결과 확인하기
립싱크된 영상은 길이의 90%까지는 괜찮다가 한 순간 무너질 수 있습니다. 다음 지점으로 이동해 보세요.
- 처음 반 초. 첫 단어가 나올 때까지 입이 가만히 있나요?
- P, B, M 소리. 입술이 완전히 닫혀야 합니다. 느슨하게 닫히거나 아예 닫히지 않는 것은 싱크가 약하다는 가장 빠른 신호입니다.
- 대사가 클립보다 길다면 클립 길이의 모든 배수 지점. 5초짜리 클립에 10초짜리 대사를 올리면 0:05와 0:10에서 반복됩니다. 이음새가 보이는 곳이 바로 그곳입니다.
- 마지막 0.5초. 파일은 오디오보다 약 0.5초 더 길게 끝나고, 입은 그 자리에서 가만히 있어야 합니다.
- 손, 유리잔, 머리 회전이 입을 가로지르는 모든 프레임.
대사가 클립보다 길 때
반복은 클립의 첫 프레임으로 곧장 되돌아가는 컷이며, 어떤 설정으로도 바뀌지 않습니다. 보내는 파일로 해결하세요.
- 클립을 길게 만드세요. 대사만큼 긴 원본 클립을 생성하는 것이 가장 깔끔한 해결책이고, 어차피 생성할 계획이라면 대개 가장 저렴합니다.
- 대사를 나누세요. 대본을 자연스럽게 끊기는 지점에서 클립보다 길지 않은 조각으로 나누고, 각 조각을 따로 싱크한 뒤 편집기에서 결과를 이어 붙이세요. 각 조각은 여전히 3초 이상이어야 합니다.
- 안정적인 테이크를 고르세요. 반복이 불가피하다면, 머리 움직임이 적은 클립이 크게 동작하는 클립보다 점프를 잘 감춰 줍니다.
비용
Lip Sync는 오디오 초 수에 대해 올림으로, 최소 3초로 과금합니다. 음성에 Gemini 3.8 Flash TTS를 썼을 때:
| 대사 길이 | 음성(Gemini 3.8 Flash TTS) | Lip Sync | 합계 |
|---|---|---|---|
| 5초 | $0.0016 | $0.06 | 약 $0.06 |
| 10초 | $0.0032 | $0.12 | 약 $0.12 |
| 30초 | $0.0096 | $0.36 | 약 $0.37 |
| 60초 | $0.0192 | $0.72 | 약 $0.74 |
작업이 실행되는 동안 견적은 60초 상한($0.72)을 잡아 두고, 쓰지 않은 부분은 오디오 길이가 확정되면 해제됩니다. 3~60초 범위를 벗어난 파일은 몇 초 만에 invalid_request로 실패하고 비용이 없으며, 실패한 작업은 잡아 둔 금액을 전부 해제합니다. 원본 클립은 직접 생성한다면 대개 가장 큰 비용 항목입니다. 그래서 다시 입히는 것이 저렴한 것입니다. 새 대사 하나는 새 렌더 대신 10초당 약 $0.12입니다.
Lip Sync, Talking Avatar, Kling Avatar 2.0 중 무엇을 쓸까
셋 다 여러분의 오디오를 누군가의 입에 넣습니다. 무엇을 고를지는 출발점이 정합니다.
| 가지고 있는 것 | 사용할 도구 | 가격 | 출력 | 알아 둘 점 |
|---|---|---|---|---|
| 인물이 이미 들어 있는 클립 | Lip Sync | 오디오 1초당 $0.012 | 약 720p까지, 원본 연기 유지 | 오디오 3~60초 |
| 인물 사진만 있음 | Talking Avatar | 1초당 $0.018 | 약 0.2메가픽셀(16:9 사진에서 640×352) | 눈 깜빡임과 작은 머리 움직임을 추가. 오디오 3~60초 |
| 인물 사진만 있고 720p나 1080p, 또는 더 긴 테이크가 필요함 | Kling Avatar 2.0 | 720p에서 1초당 $0.0512, 1080p에서 $0.1024 | 720p 또는 1080p | 오디오는 약 5분까지. Kling은 입력을 검수합니다. 높은 수위 인물 사진은 거절됐고, 거절된 요청은 과금되지 않습니다 |
영상이 있다면 Lip Sync로 시작하세요. 초당 가장 저렴하고, 실제 연기를 보존하는 유일한 도구입니다. 다룰 영상이 없을 때에만 인물 사진 도구로 넘어가세요.
FAQ
Lip Sync가 제 영상을 번역하나요
아닙니다. 넘겨준 오디오를 싱크할 뿐입니다. 다른 언어판을 만들려면 대사를 직접 번역하고, 그 언어를 말하는 모델(Gemini 3.8 Flash TTS는 130개 이상의 언어를 지원합니다)로 음성을 만든 다음, 새 파일을 같은 클립에 싱크하세요.
원래 소리는 어떻게 되나요
대체됩니다. 출력에는 넘겨준 오디오만 들어 있습니다.
작업이 바로 실패한 이유는 무엇인가요
오디오가 3초 미만이거나 60초를 넘었거나 MP3나 WAV가 아니었습니다. 오류가 길이를 알려 줍니다. 짧은 대사라면 침묵 대신 말을 추가하세요. 침묵도 지불하는 초 수에 포함됩니다.
Lip Sync는 NSFW 영상에서도 동작하나요
화면에 성인 한 명만 있으면 됩니다. 클립은 정상 가격으로 처리되고, 뭉개지거나 가려진 부분 없이 돌아옵니다. 모델은 입만 다시 그리므로 카메라를 향해 말하는 얼굴이 필요합니다.
제 직접 녹음한 음성을 사용할 수 있나요
있습니다. 권리가 있는 3~60초 사이의 MP3나 WAV라면 생성된 음성과 똑같이 동작합니다.
다음 단계
이미 마음에 드는 테이크가 있나요? Lip Sync에 이 음성 중 하나를 더하는 것이 캐릭터가 하는 말을 바꾸는 가장 저렴한 방법입니다. 10초당 약 $0.12이고 새 렌더는 필요 없습니다. Lip Sync 모델 페이지에서 직접 가진 클립으로 해 보거나, Lip Sync 리뷰를 읽어 보세요.