소개
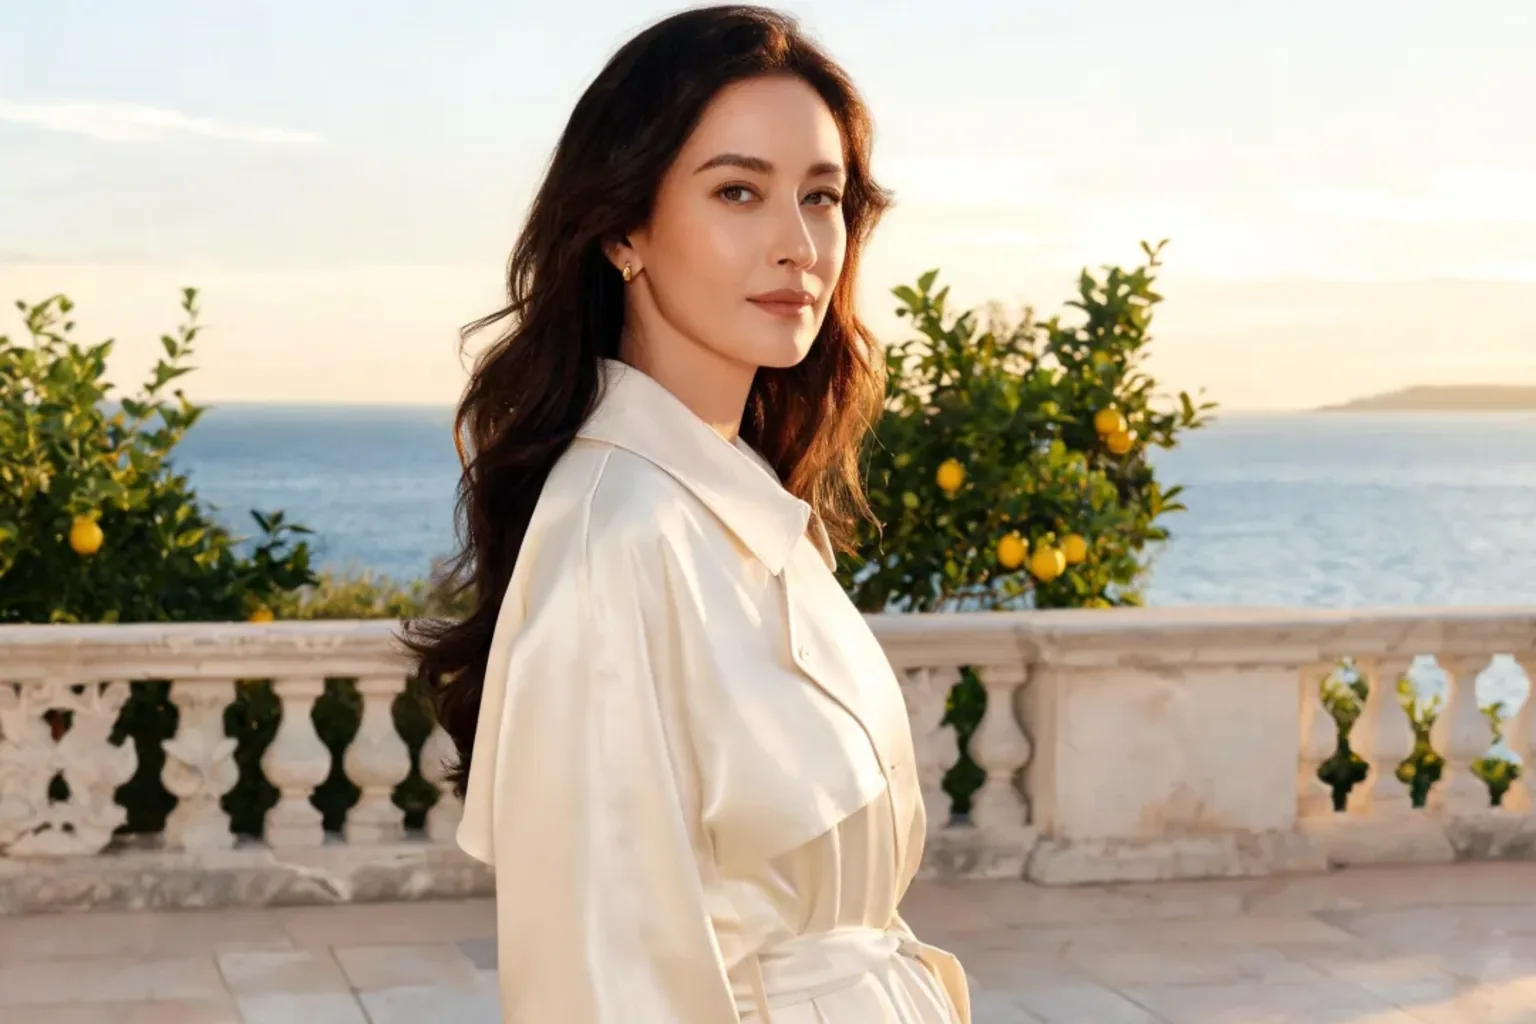
토킹 아바타는 인물 사진 한 장을 말하는 영상으로 바꿉니다. image_url에 얼굴을, audio_url에 음성 녹음을 보내면 입과 턱, 머리의 작은 움직임이 만들어져 그 사람이 녹음 내용을 그대로 말하는 것처럼 보입니다. 영상 길이는 음성과 같은 3~60초이고, 녹음이 입혀진 채로 돌아오므로 바로 게시하거나 편집에 넣을 수 있습니다.
핵심 기능 및 하이라이트
타이밍은 음성이 정합니다
입 모양은 모두 소리에서 만들어지므로 쉼, 빠른 구절, 강조가 말한 사람이 둔 자리에 정확히 맞습니다. 대본 입력란도 타이밍 조정도 없습니다. 전하고 싶은 방식대로 녹음하면 얼굴이 초 단위로 따라옵니다.
사진이 그대로 장면이 됩니다
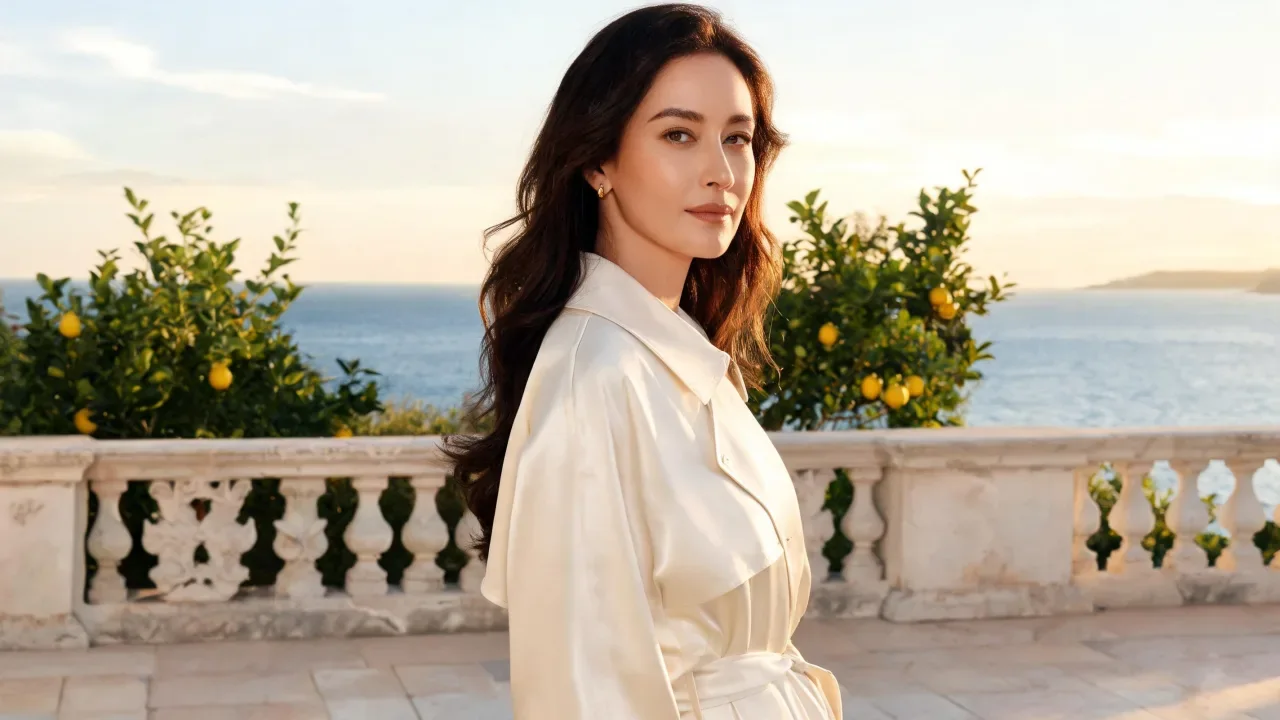
옷차림, 머리, 배경, 구도는 이미지에서 그대로 가져옵니다. 얼굴 주변을 다시 만들지 않기 때문에 진행자나 캐릭터, 대변인이 클립마다 다른 사람처럼 보이지 않습니다. 출력은 약 0.2메가픽셀, 25fps로 작은 편(16:9 사진은 640×352, 3:4 세로 인물 사진은 400×544)이니 전체 화면보다는 피드와 채팅 창을 기준으로 계획하세요.
요청 파라미터
| 파라미터 | 필수 | 설명 |
|---|---|---|
image_url | 예 | 말하게 할 얼굴입니다. 한 사람이 거의 카메라를 보고 조명이 고르게 비친 사진이 좋고, 상반신 구도가 가장 잘 맞습니다. 1자 이상 |
audio_url | 예 | 립싱크할 말소리로, 3~60초의 MP3 또는 WAV입니다. 오디오 파일 자체로 바로 연결되는 링크여야 하며, 업로드가 가장 확실합니다. 1자 이상 |
prompt | 아니요 | 선택 항목입니다. 차분하게, 밝게, 진지하게처럼 표정이나 분위기를 몇 단어로 적으세요. 1000자 이하 |
mask_url | 아니요 | 선택 항목입니다. 사진에 여러 사람이 있을 때만 필요하며, 사진과 같은 크기의 흑백 이미지에서 말할 사람 부분을 흰색으로 칠합니다. 1자 이상 |
seed | 아니요 | 같은 사진과 음성으로 두 번의 결과를 비교할 때 고정하세요. 비워 두면 매번 새로운 결과가 나옵니다. |
요금
$0.018 / 출력 초
반환된 영상(음성과 같은 길이)의 초당으로, 올림하여 최소 3초 기준으로 과금됩니다.
활용 사례
사진 한 장으로 진행자 영상
강의 인트로, 제품 소개, 주간 공지에 승인된 인물 사진 한 장을 계속 쓰고 매번 새 녹음만 준비하면 됩니다. 언어를 바꿀 때도 같은 이미지에 다른 음성 파일을 보내면 되므로 진행자 한 명으로 여러 시장을 맡을 수 있습니다.
소리 내어 답하는 캐릭터
컴패니언이나 롤플레이 앱에서 캐릭터가 답변을 카메라 앞에서 말하게 할 수 있습니다. 캐릭터 이미지는 한 장으로 두고, 답변을 음성으로 바꿔 함께 보내면 됩니다. 짧은 답변도 렌더링에 1~2분이 걸리니 텍스트 답변을 화면에 띄우는 동안 작업을 시작해 두세요.
프롬프트 가이드 및 실전 팁
입이 잘 보이는 사진 고르기
움직이는 곳은 입이므로 그곳에 픽셀을 주세요. 상반신 구도, 거의 카메라를 향한 얼굴, 고른 조명, 입술을 가리는 것이 없는 사진이 좋습니다. 선글라스, 옆모습에 가까운 각도, 넓은 화면 속 작은 얼굴은 결과가 어색해지는 흔한 원인입니다.
큰 소리보다 깨끗한 소리
배경 음악, 울림이 큰 방, 겹치는 목소리가 없는 말소리를 내보내세요. 앞뒤의 무음은 잘라 내세요. 무음도 과금되는 길이에 포함됩니다. 파일 하나는 3~60초로 맞추고, 긴 대본은 자연스러운 쉼에서 나누세요.
분위기는 프롬프트, 화자는 마스크
prompt는 차분하게, 밝게, 진지하게처럼 표정을 조금 이끌 뿐, 누가 어디서 말하는지는 바꾸지 못합니다. 사진에 여러 사람이 있으면 검은 바탕에 화자를 흰색으로 칠한 이미지를 사진과 같은 크기로 mask_url에 넘기세요. 같은 사진으로 두 녹음을 비교하려면 seed를 고정하세요.
API 빠른 시작
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
인증, 전체 스키마, 폴링과 오류 처리는 API 레퍼런스에서 확인하세요.