En bref : Lip Sync prend un clip que vous avez déjà plus un fichier vocal de 3 à 60 secondes, et redessine uniquement la bouche pour que la personne à l'écran dise votre réplique. La vidéo dure ce que dure l'audio, pas le clip. Le flux : écrire la réplique, la faire dire par un modèle de synthèse vocale, envoyer le clip et l'audio comme une seule tâche asynchrone, puis vérifier les quelques instants où la synchronisation se casse. La voix coûte une fraction de centime ; la synchronisation coûte $0.012 par seconde d'audio, donc une réplique de 10 secondes coûte environ $0.12.
Remplacer la piste audio avec ffmpeg laisse la bouche dire autre chose, comme dans un film mal doublé. Redessiner la bouche est le travail du modèle de lip sync.
Dans nos tests d'octobre 2026, les clips adultes, des étreintes habillées aux images nettement adultes, ont été acceptés au tarif normal, sans rien de flouté ni de rogné. Lip Sync ne redessine que la bouche, il fonctionne donc mieux sur un clip où la personne regarde la caméra et parle ; un baiser ou un cadrage très serré ne lui laisse rien à synchroniser.
En bref
- Deux fichiers en entrée, aucun prompt.
video_urlest le clip etaudio_urlest la nouvelle voix ; il n'y a rien d'autre à régler. - L'audio impose la durée. Un clip plus long est coupé à la longueur de la réplique ; un clip plus court boucle jusqu'à la fin de la réplique. Les deux durées de fichier sont votre seul contrôle.
- L'audio doit durer de 3 à 60 secondes, en MP3 ou WAV. Tout ce qui sort de cette plage échoue en quelques secondes et ne coûte rien.
- Vous payez l'audio, à la seconde, arrondi à l'unité supérieure, avec un minimum de 3 secondes. La vidéo renvoyée dépasse l'audio d'environ une demi-seconde, et cette queue est gratuite.
- Cela prend des minutes, pas des secondes. Envoyez et laissez tourner ; une réplique de 10 secondes prend environ quatre minutes.
Avant et après
À part la durée, qui suit désormais la réplique, seule la bouche change. L'expression, les mouvements de tête, la lumière et le cadrage viennent des images d'origine, donc Lip Sync convient à une prise que vous aimez déjà et ne peut pas animer une performance plate.
Étape 1 : partez d'un clip capable de porter une réplique
Le modèle repeint la bouche et ne touche à rien d'autre, donc les images de départ décident en grande partie du résultat. Ce qui fonctionne :
- Une personne, le visage assez grand dans le cadre, tourné surtout vers la caméra. Un plan rapproché poitrine est le choix sûr ; un visage à l'arrière-plan lointain ne l'est pas.
- Un seul plan continu. Une coupe dure au milieu du clip casse la synchronisation à la coupe.
- Une bouche dégagée. Une main, un verre, un micro ou une mèche de cheveux devant les lèvres est là où la synchronisation dérape.
- Une performance qui colle à la réplique. Comme le reste du visage est intact, un visage calme avec une réplique criée se lit toujours comme calme.
La résolution plafonne à environ 720p : un clip en 1920×1080 revient en 1280×720, et envoyer du 1080p ne coûte pas plus cher.
Si vous générez le clip source
Demandez au modèle vidéo une prise qui parle déjà : le mouvement de la mâchoire et de la tête qui rend la parole crédible doit être dans le clip. Voici le prompt de mouvement que nous avons utilisé sur Seedance 2.0 Mini Spicy, en partant d'une image fixe de l'homme au bar :
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Réglez la durée du clip au moins sur celle de votre réplique : Seedance 2.0 Mini Spicy accepte de 4 à 15 secondes. Laissez l'audio natif désactivé, car Lip Sync remplace la piste sonore.
Deux vérifications avant de payer la synchronisation :
- Fixez la caméra. Un lent push-in fait sauter la coupe de boucle du gros plan vers la première image plus large, surveillez-en une.
- Comparez le visage avec votre image fixe. L'image vers vidéo peut faire dériver un visage en quelques secondes, et Lip Sync garde le visage que le clip possède. Jetez un clip dérivé avant la synchronisation.
Pourquoi ne pas laisser le modèle vidéo faire le son ?
Des modèles vidéo comme Seedance 2.x, Wan 3.0 et Kling 3.0 peuvent générer du son avec l'image. Cela convient à l'ambiance ou aux dialogues approximatifs, mais l'audio est intégré à un rendu complet : changer un seul mot signifie payer à nouveau tout le clip. Une nouvelle réplique de 10 secondes coûte environ $0.12 à synchroniser, alors que refaire un rendu d'un clip 720p de 10 secondes sur Seedance 2.0 Mini Spicy coûte $0.82.
Étape 2 : écrivez la réplique et faites-la dire
Tout MP3 ou WAV entre 3 et 60 secondes fonctionne, y compris votre propre enregistrement. Si vous n'avez pas de comédien, un modèle de synthèse vocale est la voie la plus rapide. Ces quatre modèles conviennent à la synchronisation labiale :
| Modèle | Comment vous dirigez le rendu | Prix public | Une réplique de 10 secondes coûte environ |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Du texte plus une voix parmi 30, avec style, accent, pace en option et une note de diction. Les repères entre crochets, comme [laughs], sont généralement joués plutôt que lus | $0.00032 par seconde d'audio | $0.0032 |
| Gemini 2.5 Pro TTS | Les mêmes réglages que Flash ; modèle plus ancien, prix légèrement supérieur | $0.00045 par seconde d'audio | $0.0045 |
| MiniMax Speech 2.8 HD | Un réglage emotion. Les repères vont entre parenthèses, comme (sighs) | $0.12 pour 1 000 caractères | $0.018 |
| Seed Speech 2.0 | 41 voix, 10 langues et une note séparée qui dirige le rendu sans être lue à voix haute | $0.072 pour 1 000 caractères | $0.011 |
Quel que soit votre choix, la voix ne coûte presque rien à côté de la synchronisation. Pour la synchronisation labiale, commencez par Gemini 3.8 Flash TTS : il offre les mêmes réglages que 2.5 Pro et coûte moins cher. Passez à MiniMax pour le réglage emotion, ou à Seed Speech 2.0 si vous préférez sa note de diction en langage courant.
Quatre règles empêchent l'audio de miner l'image :
- Restez entre 3 et 60 secondes. L'anglais généré se débite à 12 à 19 caractères par seconde, écrivez donc au moins 60 caractères (une douzaine de mots) ; de 700 à 1 100 caractères remplissent 60 secondes. Mesurez le fichier, pas le script : une réplique de 10 caractères comme "Come here." a duré 1.76 seconde et a été refusée (les répliques très courtes sont plus lentes par caractère).
- Coupez le silence aux deux extrémités. Les voix Gemini ajoutent de 0.1 à 0.3 secondes avant le premier mot et jusqu'à 0.45 après le dernier. La facturation arrondit à l'unité supérieure, donc une réplique de 4.04 secondes est facturée 5 secondes et la même réplique coupée sous 4 secondes est facturée 4.
- Adaptez le rendu au visage. Un murmure soufflé sur un visage qui rit paraît faux, quelle que soit la qualité de la synchronisation. Choisissez l'émotion ou le style qui convient à vos images.
- Envoyez une voix nue. Pas de musique en dessous. Si vous voulez une bande-son, ajoutez-la après la synchronisation.
La voix change la bouche autant que les mots. Le même clip et les mêmes mots dits par MiniMax Speech 2.8 HD donnent des formes de bouche différentes :
Les quatre lisent des scripts pour adultes ; le détail par modèle se trouve sur les pages des modèles de synthèse vocale.
Étape 3 : essayez dans le Playground, puis via l'API
Essayez d'abord dans le Playground, avec votre propre clip et une réplique :
- Ouvrez la page Gemini 3.8 Flash TTS, collez votre réplique dans Text, choisissez une Voice et lancez. Téléchargez le WAV, ou sautez cette étape si vous avez votre propre enregistrement.
- Ouvrez la page Lip Sync, ajoutez votre clip sous Input video et l'audio sous Input audio, vérifiez l'estimation de prix et lancez. Prévoyez une attente de quelques minutes : environ quatre pour une réplique de 10 secondes.
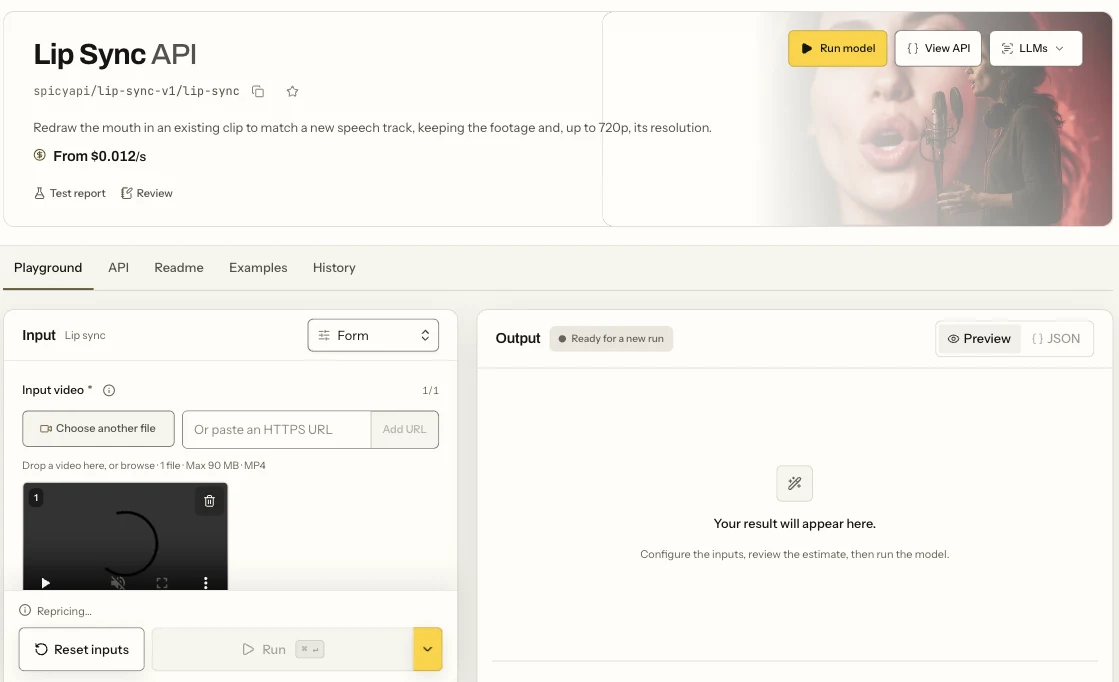
La page Lip Sync dans le Playground : la vue Form, le champ Input video où vous ajoutez votre clip, et le bouton Run.
Les limites qui comptent : un clip MP4 et un fichier MP3 ou WAV, chacun jusqu'à 90 MB.
Pour votre propre application, envoyez les deux mêmes entrées comme une seule tâche (téléversez d'abord le clip et l'audio, comme expliqué dans le guide des médias) :
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Requête complète, interrogation et callbacks : guide des tasks.
Laissez un agent l'exécuter
Utilisez le Playground pour une réplique ponctuelle. Quand voix, synchronisation et coupe forment un flux répété, confiez-le à un agent ; les trois outils affichent le prix et demandent avant un appel payant.
- CLI :
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, avecinput.jsoncontenant l'objetinputci-dessus (doc CLI). - MCP : ajoutez le serveur MCP, puis demandez : "Lip-sync ./take.mp4 with ./line.wav." Il appelle
spicyapi_upload_file,spicyapi_task_createetspicyapi_task_wait. - Skill :
npx skills add spicyapi-ai/spicy-skillinstalle l'Agent Skill, qui fait lire le schéma du modèle à l'assistant avant qu'il ne construise l'entrée.
Étape 4 : vérifiez le résultat là où il casse
Une vidéo synchronisée peut sembler correcte sur 90 % de sa durée et s'effondrer à un instant. Sautez à ces points :
- La première demi-seconde. La bouche reste-t-elle immobile jusqu'au premier mot ?
- Les sons P, B et M. Les lèvres devraient se fermer complètement. Des fermetures molles ou absentes sont le signe le plus rapide d'une synchronisation faible.
- Chaque multiple de la durée du clip, si la réplique est plus longue que le clip. Un clip de 5 secondes sous une réplique de 10 secondes se répète à 0:05 et 0:10. C'est là que la couture se voit.
- La dernière demi-seconde. Le fichier dépasse l'audio d'environ 0.5 seconde, et la bouche doit y rester au repos.
- Toute image où une main, un verre ou un mouvement de tête traverse la bouche.
Quand la réplique est plus longue que le clip
La boucle est une coupe directe vers la première image du clip, et aucun réglage ne la change. Vous la corrigez avec les fichiers que vous envoyez :
- Allongez le clip. Générer un clip source aussi long que la réplique est la solution propre, et généralement la moins chère si vous générez de toute façon.
- Découpez la réplique. Découpez le script aux pauses naturelles en morceaux pas plus longs que le clip, synchronisez chaque morceau séparément et joignez les résultats dans votre logiciel de montage. Chaque morceau doit toujours faire au moins 3 secondes.
- Choisissez une prise stable. Si vous devez boucler, un clip avec peu de mouvement de tête masque mieux le saut qu'un clip avec un grand geste.
Ce que ça coûte
Lip Sync facture à la seconde d'audio, arrondie à l'unité supérieure, avec un minimum de 3 secondes. Avec Gemini 3.8 Flash TTS pour la voix :
| Longueur de la réplique | Voix (Gemini 3.8 Flash TTS) | Lip Sync | Total |
|---|---|---|---|
| 5 secondes | $0.0016 | $0.06 | environ $0.06 |
| 10 secondes | $0.0032 | $0.12 | environ $0.12 |
| 30 secondes | $0.0096 | $0.36 | environ $0.37 |
| 60 secondes | $0.0192 | $0.72 | environ $0.74 |
Pendant l'exécution de la tâche, le devis retient le maximum de 60 secondes ($0.72) ; la partie inutilisée est libérée une fois la durée de l'audio arrêtée. Un fichier hors de 3 à 60 secondes échoue en quelques secondes avec invalid_request et ne coûte rien, et toute tâche en échec libère entièrement sa retenue. Le clip source, si vous le générez, est généralement le poste le plus coûteux, ce qui explique que refaire la voix soit bon marché : chaque nouvelle réplique coûte environ $0.12 pour 10 secondes au lieu d'un nouveau rendu.
Lip Sync, Talking Avatar ou Kling Avatar 2.0 ?
Les trois mettent votre audio dans la bouche de quelqu'un. Ce qui décide entre eux, c'est votre point de départ :
| Vous avez | Utilisez | Prix | Sortie | Bon à savoir |
|---|---|---|---|---|
| Un clip avec la personne déjà dedans | Lip Sync | $0.012 par seconde d'audio | Jusqu'à environ 720p, la performance d'origine est conservée | Audio de 3 à 60 secondes |
| Seulement une photo de portrait | Talking Avatar | $0.018 par seconde | Environ 0.2 mégapixel (640×352 à partir d'une photo 16:9) | Ajoute des clignements et de petits mouvements de tête ; audio de 3 à 60 secondes |
| Seulement un portrait, et il vous faut 720p ou 1080p ou une prise plus longue | Kling Avatar 2.0 | $0.0512 par seconde en 720p, $0.1024 en 1080p | 720p ou 1080p | Audio jusqu'à environ 5 minutes. Kling modère les entrées : un portrait en contenu de niveau fort a été refusé, et une requête refusée n'est pas facturée |
Si vous avez déjà des images tournées, commencez par Lip Sync : c'est le moins cher à la seconde et le seul qui conserve une vraie performance. Ne passez à un outil de portrait que lorsqu'il n'y a aucune image sur laquelle travailler.
FAQ
Lip Sync peut-il traduire ma vidéo ?
Non. Il synchronise l'audio que vous lui donnez. Pour faire une version dans une autre langue, traduisez la réplique vous-même, faites-la dire par un modèle qui parle cette langue (Gemini 3.8 Flash TTS couvre plus de 130 langues), puis synchronisez le nouveau fichier sur le même clip.
Que devient le son original ?
Il est remplacé ; la sortie ne porte que l'audio que vous avez envoyé.
Pourquoi ma tâche a-t-elle échoué immédiatement ?
L'audio faisait moins de 3 secondes, plus de 60 secondes, ou n'était pas en MP3 ni WAV ; l'erreur indique la durée. Pour une réplique courte, ajoutez des mots plutôt que du silence, car le silence compte dans les secondes que vous payez.
Lip Sync fonctionne-t-il sur du contenu NSFW ?
Oui pour un seul adulte à l'écran : le clip passe au tarif normal et revient sans rien de flouté ou de couvert. Le modèle ne redessine que la bouche, il lui faut donc un visage qui parle à la caméra.
Puis-je utiliser mon propre enregistrement vocal ?
Oui. Tout MP3 ou WAV entre 3 et 60 secondes dont vous détenez les droits fonctionne exactement comme une voix générée.
Étape suivante
Vous avez déjà une prise qui vous plaît ? Lip Sync plus l'une de ces voix est le moyen le moins cher de changer ce que dit un personnage : environ $0.12 pour 10 secondes, sans nouveau rendu. Essayez sur votre propre clip sur la page du modèle Lip Sync, ou lisez le test de Lip Sync.