Introduction
Talking Avatar transforme un seul portrait en clip parlant. Vous envoyez le visage dans image_url et un enregistrement vocal dans audio_url ; la bouche, la mâchoire et de petits mouvements de tête sont animés pour que la personne semble dire exactement ce que contient l'enregistrement. Le clip dure autant que l'audio, de trois à soixante secondes, et revient avec votre enregistrement déjà posé, prêt à publier ou à monter.
Fonctionnalités et points forts
L'audio fixe le rythme
Chaque forme de bouche est produite à partir du son lui-même : les pauses, les passages rapides et les appuis tombent là où la personne les a placés. Il n'y a ni champ de script ni réglage de timing. Enregistrez la réplique comme elle doit sonner, et le visage la suit, seconde après seconde.
Le portrait reste la scène
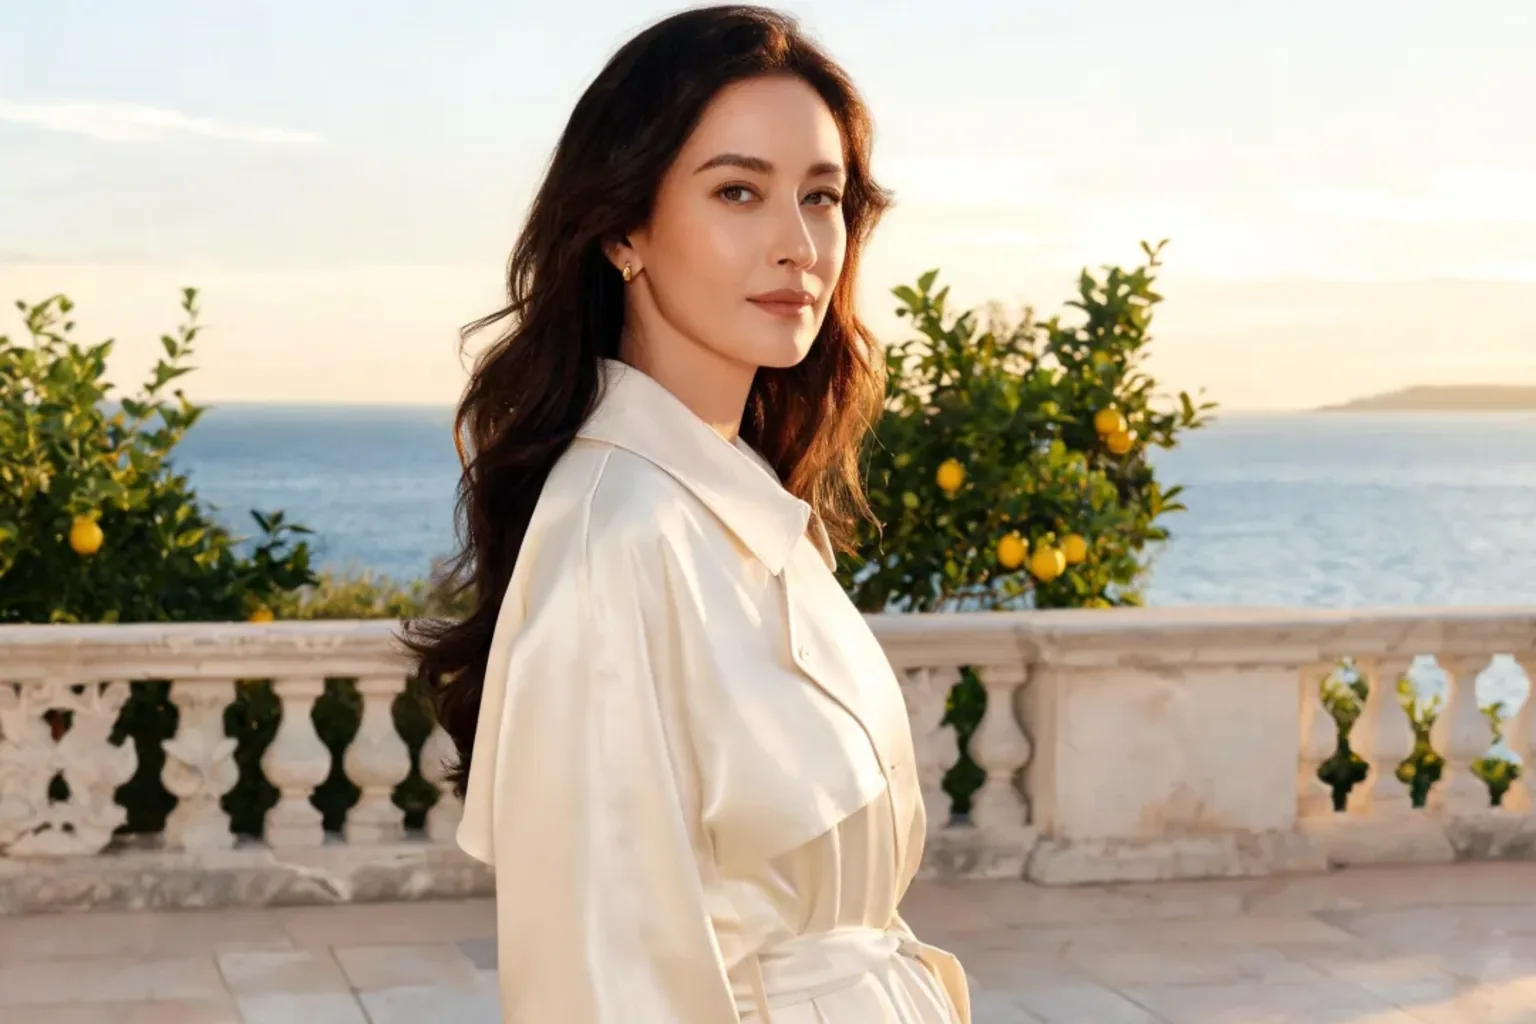
Vêtements, cheveux, décor et cadrage viennent directement de l'image. Rien n'est régénéré autour du visage, si bien qu'un présentateur, un personnage ou un porte-parole reste reconnaissable d'un clip à l'autre. Le rendu est compact, environ 0,2 mégapixel à 25 images par seconde (une photo 16:9 est revenue en 640×352, un portrait 3:4 en 400×544) : prévoyez les fils sociaux et les fenêtres de chat plutôt que le plein écran.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
image_url | Oui | Le visage qui va parler. Une seule personne, tournée à peu près vers l'objectif, éclairage homogène ; un cadrage buste marche le mieux. 1 caractères minimum |
audio_url | Oui | La voix à synchroniser, de 3 à 60 secondes, en MP3 ou WAV. Il faut un lien direct vers le fichier audio ; le téléverser reste le plus fiable. 1 caractères minimum |
prompt | Non | Facultatif. Quelques mots sur l'expression ou l'ambiance : calme, enjouée, sérieuse. 1000 caractères maximum |
mask_url | Non | Facultatif. Utile seulement si le portrait montre plusieurs personnes : une image noir et blanc de même taille, blanche sur la personne qui doit parler. 1 caractères minimum |
seed | Non | Fixez-le pour comparer deux essais avec le même portrait et le même audio ; laissez-le vide pour une nouvelle prise à chaque fois. |
Tarification
$0.018 / seconde produite
Facturé à la seconde de vidéo livrée, qui dure autant que votre audio, arrondie au-dessus avec un minimum de 3 secondes.
Cas d’utilisation
Des clips de présentateur à partir d'une image
Intros de cours, démonstrations de produit et points hebdomadaires peuvent réutiliser un portrait validé avec un nouvel enregistrement à chaque fois. Changer de langue revient à envoyer un autre fichier audio avec la même image, et un seul présentateur couvre ainsi plusieurs marchés.
Des personnages qui répondent à voix haute
Les applications de compagnon et de jeu de rôle peuvent faire dire une réponse face caméra : gardez un portrait du personnage, convertissez la réponse en voix et envoyez la paire. Même une réponse courte demande une à deux minutes de rendu, lancez donc la tâche pendant que la réponse écrite s'affiche.
Guide de prompt et conseils pratiques
Choisir le portrait pour la bouche
C'est la bouche qui bouge : donnez-lui des pixels. Cadrage buste, visage tourné à peu près vers l'objectif, lumière homogène et rien devant les lèvres. Lunettes de soleil, profils marqués et petits visages dans un plan large sont les causes habituelles d'un résultat bizarre.
Un son propre plutôt qu'un son fort
Exportez une voix sans musique de fond, sans pièce qui résonne ni voix qui se chevauchent. Coupez le silence au début et à la fin, car le silence compte aussi dans la durée facturée. Gardez chaque fichier entre trois et soixante secondes et découpez les scripts plus longs aux pauses naturelles.
Le prompt pour l'humeur, le masque pour la personne
Le champ prompt oriente un peu l'expression, calme, enjouée ou sérieuse, mais ne change ni qui parle ni où. Si le portrait montre plusieurs personnes, passez mask_url avec la personne qui parle en blanc sur fond noir, à la même taille que l'image. Fixez seed pour comparer deux enregistrements sur le même portrait.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.