Introduction
OmniHuman 2.0 Talking avatar est le modèle d’avatar piloté par l’audio de ByteDance. Vous envoyez un portrait (image_url) et un fichier audio de parole ou de chant (audio_url), et il renvoie une vidéo 720p de cette personne qui interprète l’audio : le visage, les lèvres, la tête et le haut du corps bougent avec lui, au lieu de laisser le torse figé. Le clip dure autant que l’audio, de 4 à 300 secondes. Il n’existe ni champ de durée, ni champ de résolution, ni champ de proportions. Un prompt optionnel, jusqu’à 300 caractères, dirige l’ambiance, les gestes, la direction du regard et, selon l’éditeur, les mouvements de caméra.
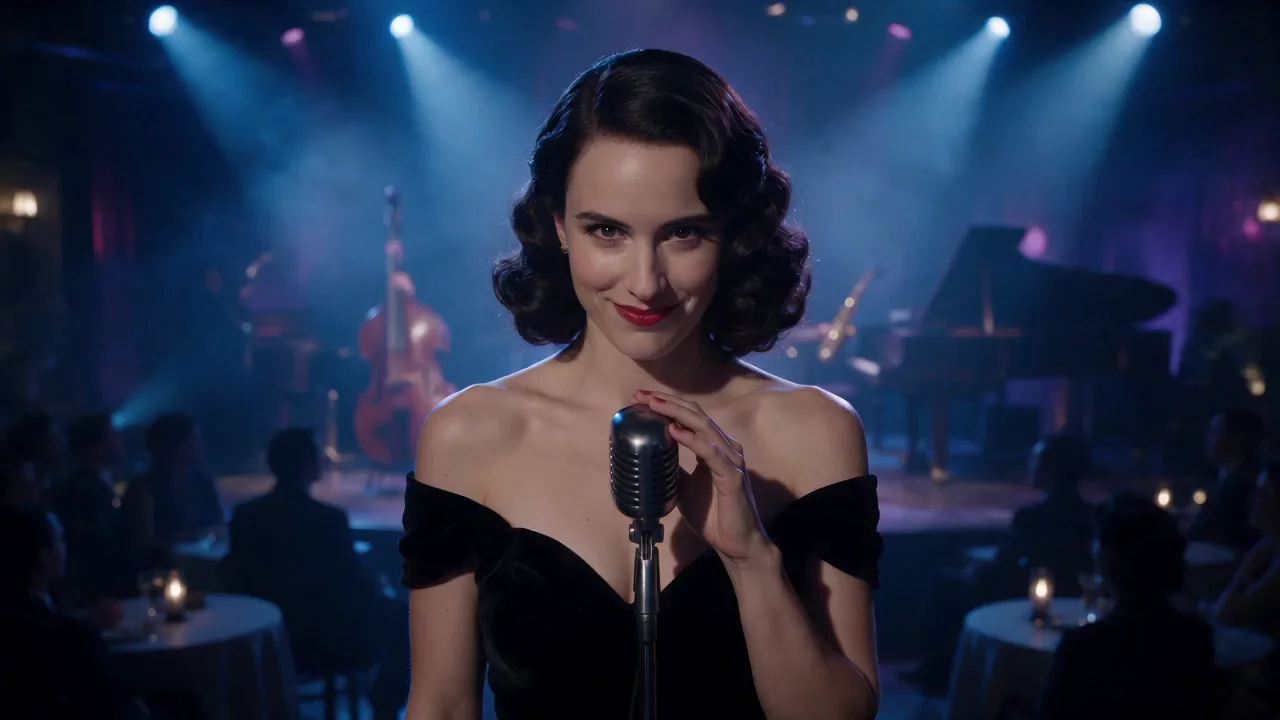
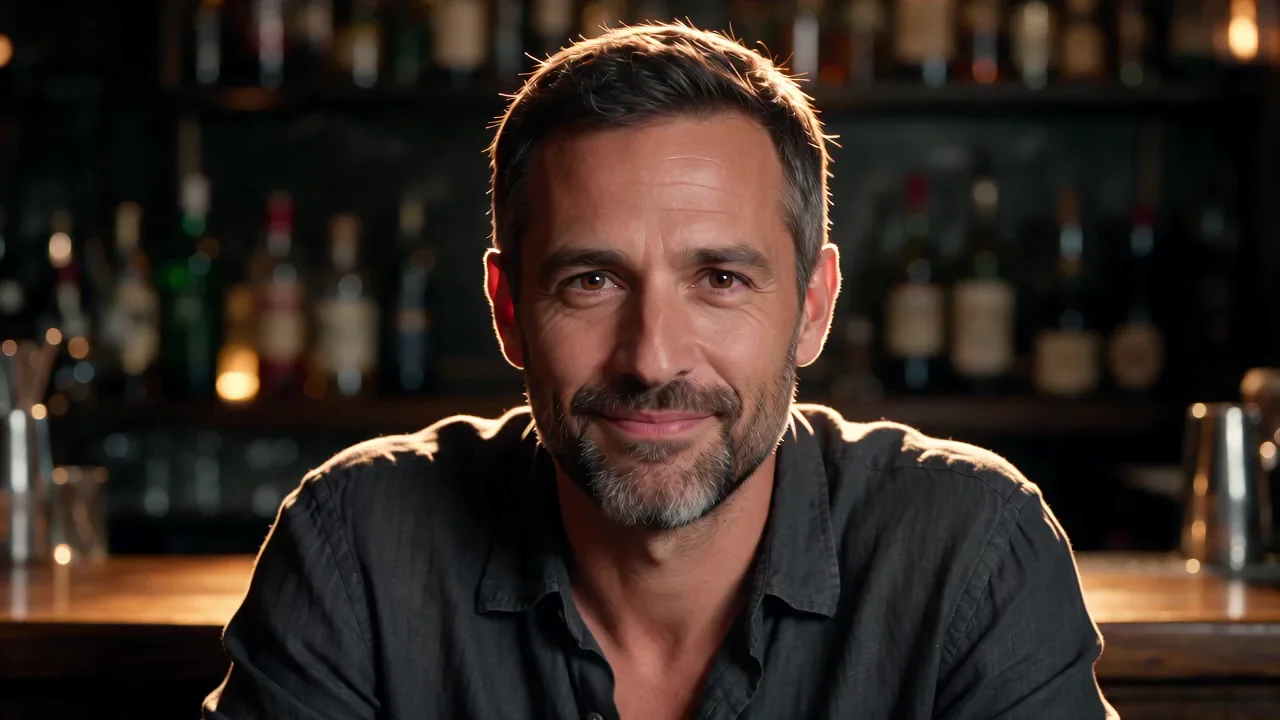
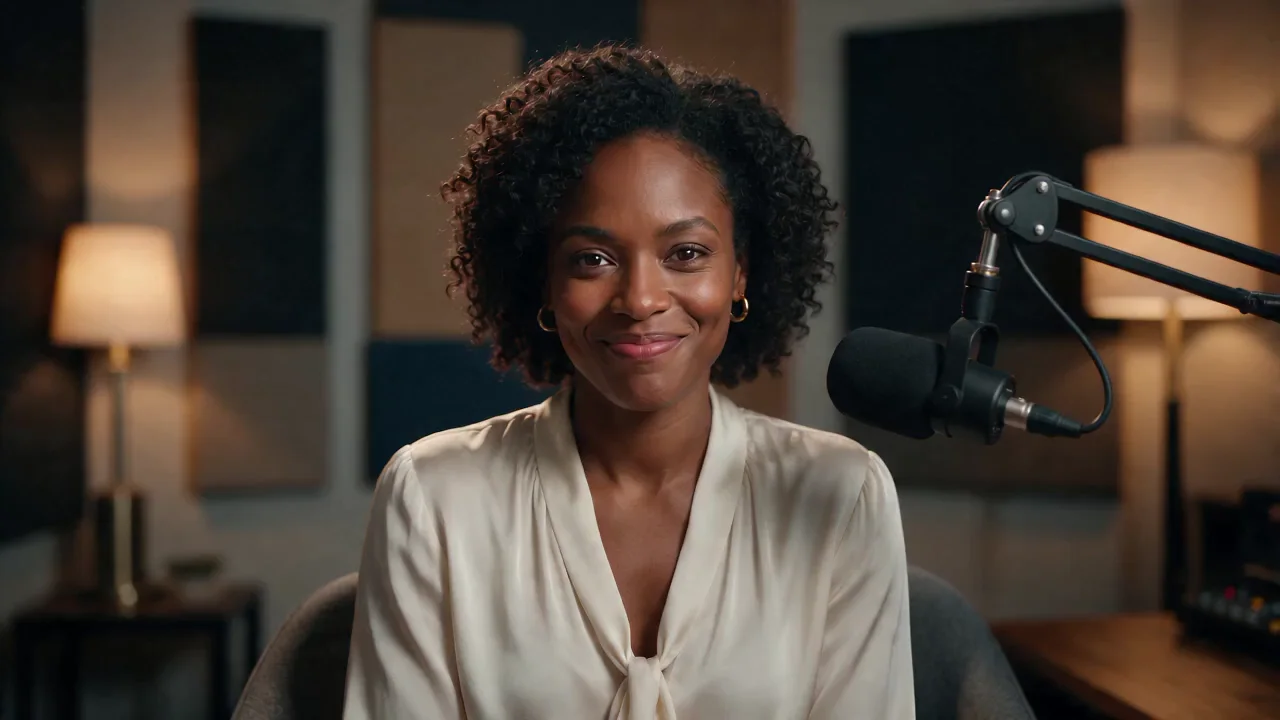
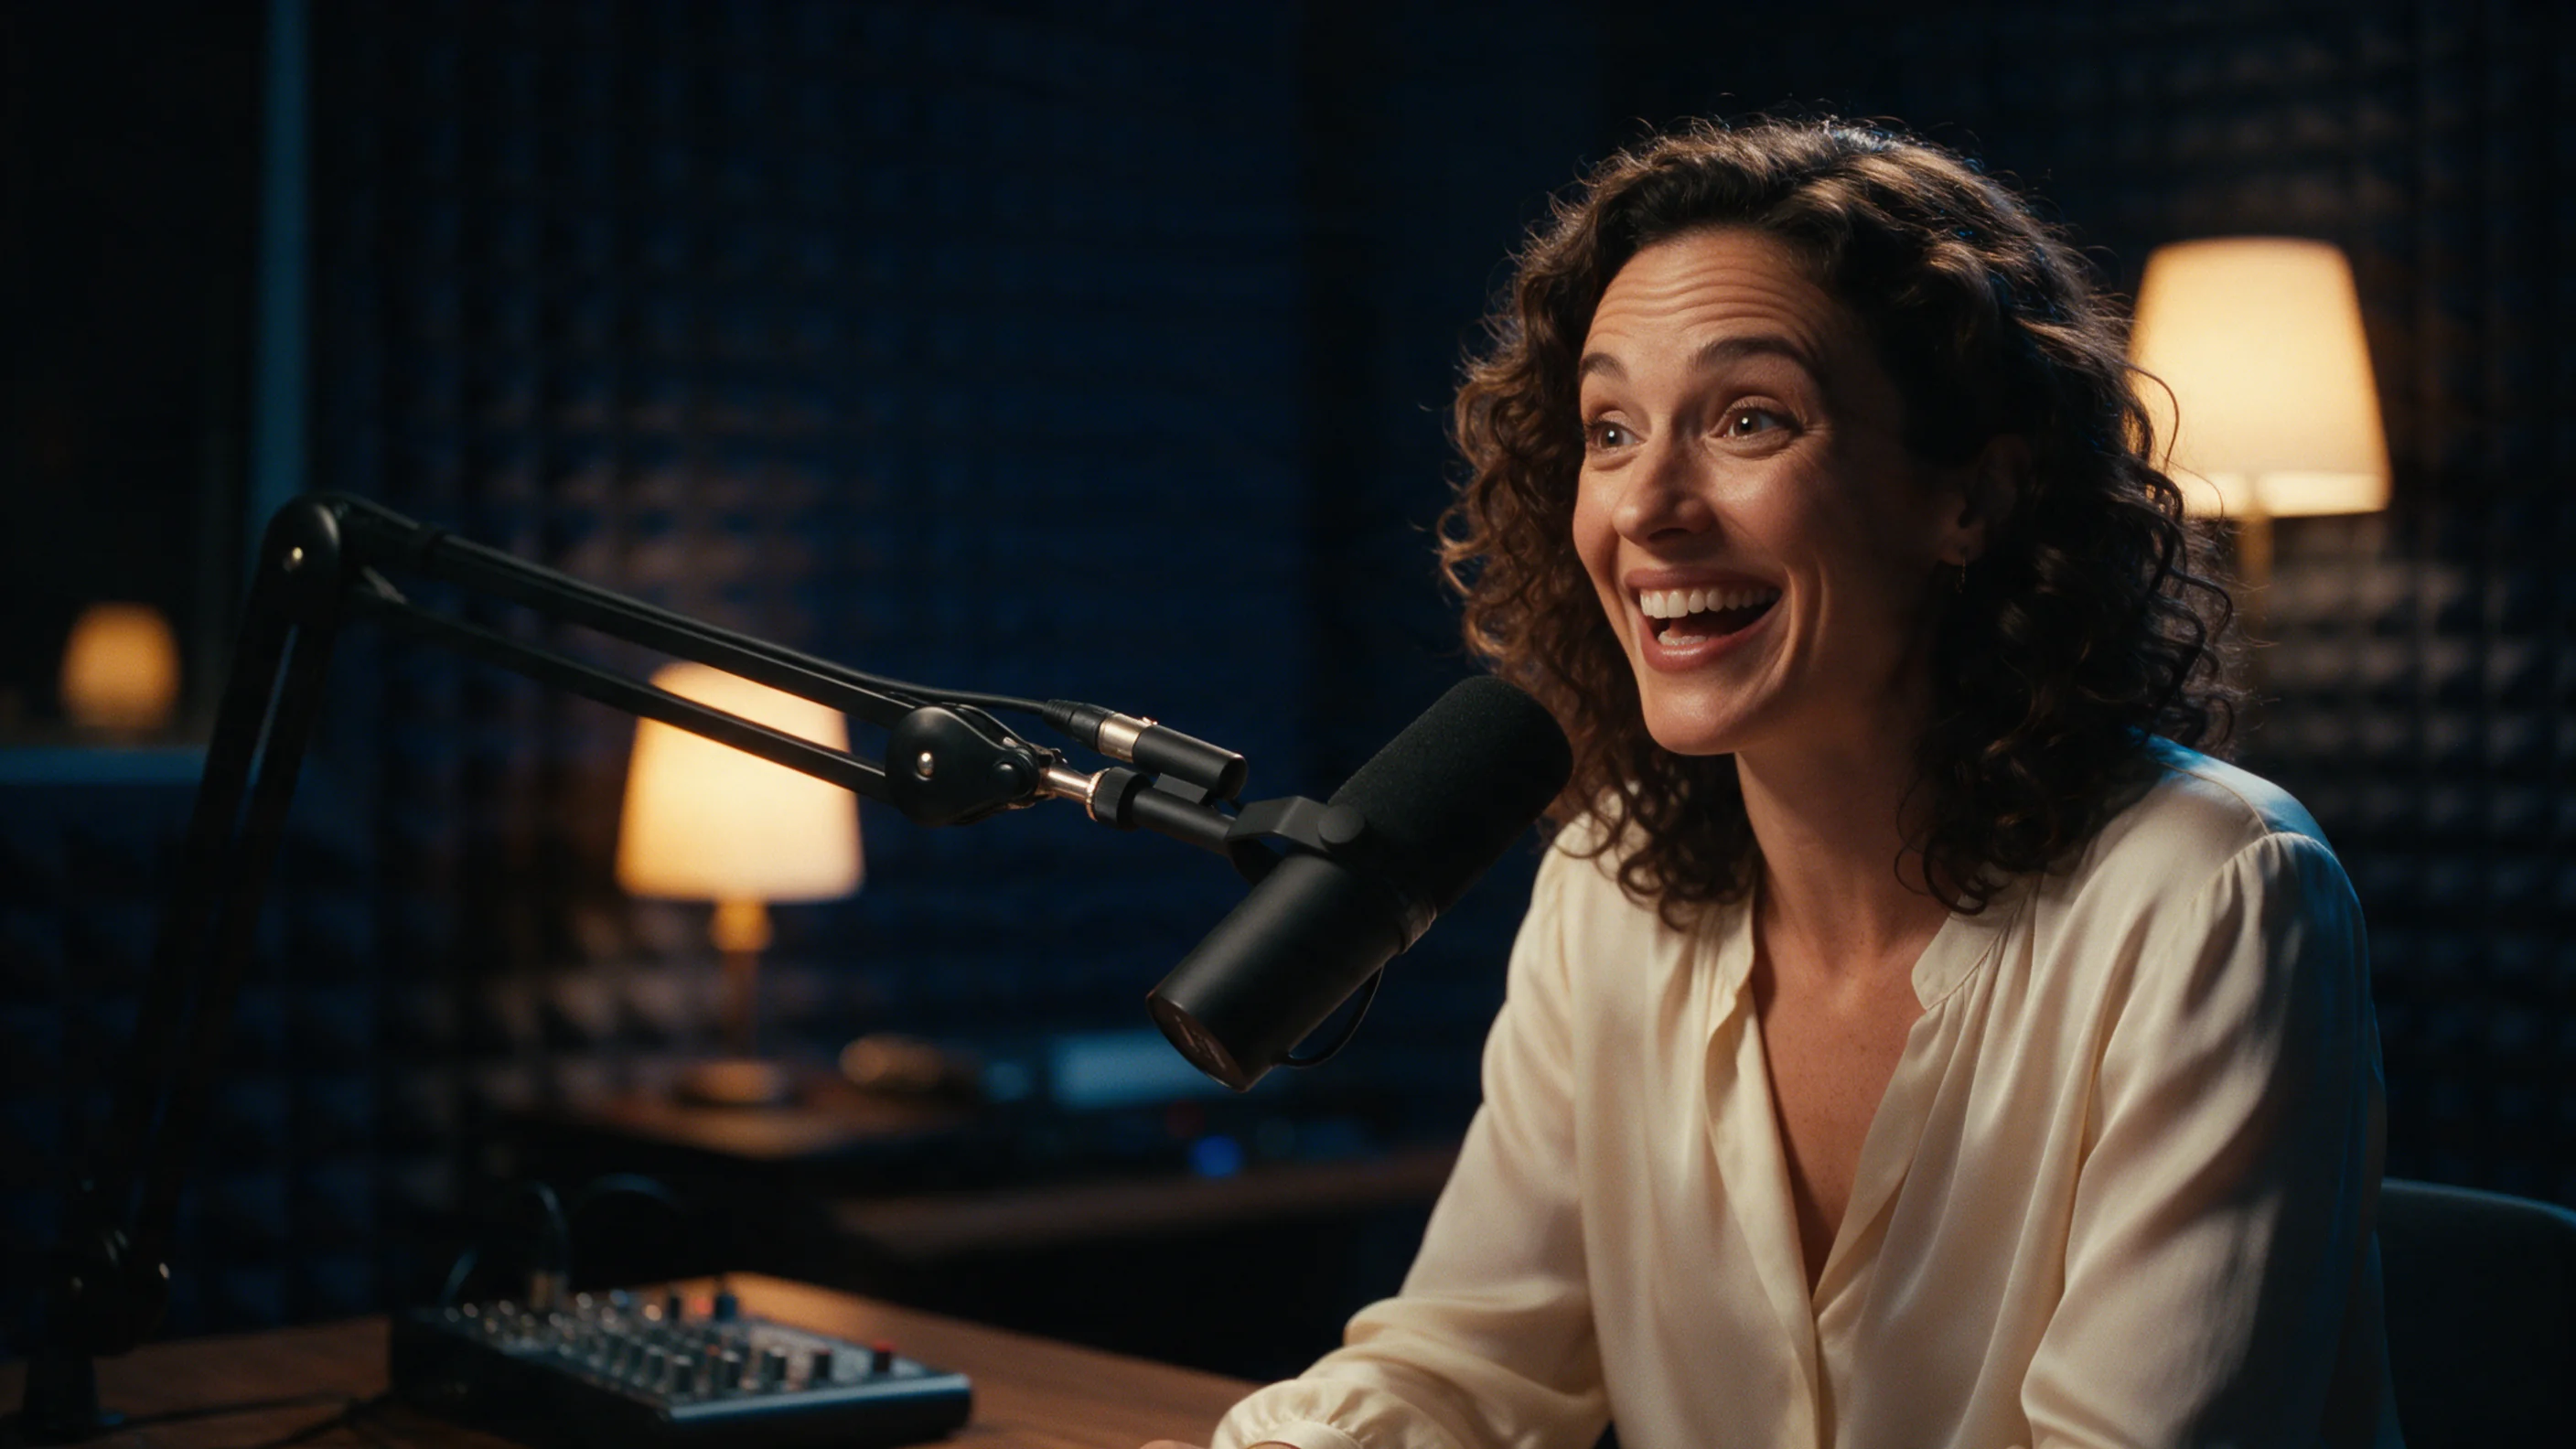
Trois des quatre exemples de cette page (la chanteuse du supper club, le comptoir du bar et l’émission de fin de soirée) utilisent les mêmes portraits et le même audio que Kling Avatar 2.0, coupés à environ cinq secondes, pour que vous puissiez comparer les deux pages côte à côte.
Fonctionnalités et points forts
L’audio fixe la durée
Coupez votre audio à la durée souhaitée pour le clip avant de l’envoyer. Un audio de moins de 4 secondes ou de plus de 300 secondes est refusé avant toute facturation. Dans nos essais, le clip est revenu entre 0,2 et 1 seconde de plus que l’audio, en tombant sur un nombre entier de secondes : 4,55 secondes d’audio ont donné un clip de 5 secondes, et 5,2 secondes ont donné un clip de 6 secondes. La facturation suit la durée de l’audio, et non celle du clip final.
Ce que nous avons mesuré
Nous avons testé quatre portraits, chacun avec son propre audio de 4,55 à 5,2 secondes et son propre prompt d’une ligne. Les quatre portraits étaient en 16:9. Chaque clip est revenu en 1280×720 et 24 fps, piste audio incluse, et le traitement a pris environ deux minutes par clip : de 110 à 133 secondes entre l’envoi et le fichier final. En comparant des images extraites au portrait d’origine, le visage est resté reconnaissable comme la même personne dans les quatre clips.
Lèvres, expression et gestes
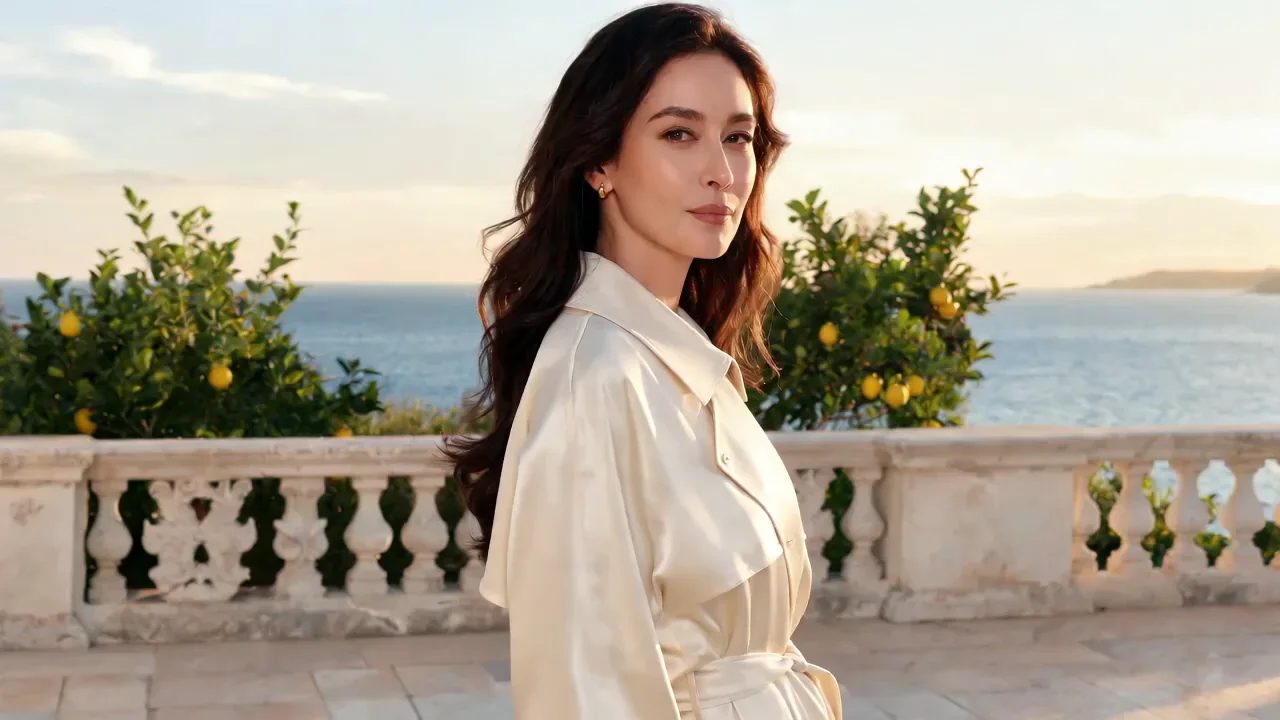
Dans les quatre clips, les lèvres ont suivi l’audio. Les prompts demandaient de petits temps forts précis, et la plupart sont apparus : un sourire et une légère inclinaison de la tête sur le dernier mot, la main restant sur le micro ; un demi-sourire et un sourcil levé, les bouteilles derrière le bar restant stables ; une tête qui se tourne vers la mer dans la dernière seconde ; et un rire bref, sourcils amples, sur le dernier mot. Une consigne n’est pas apparue de façon visible : le fait de pencher vers le micro, dans le clip de l’émission de fin de soirée.
Le prompt est optionnel
Laissez prompt vide et le modèle suit seul l’audio. L’éditeur indique le chinois, l’anglais, le japonais, le coréen, l’espagnol (mexicain) et l’indonésien comme langues de prompt. Nos quatre prompts étaient en anglais et dirigeaient l’expression, les gestes et la direction du regard ; nous n’avons pas testé les consignes de mouvement de caméra.
Ce que nous n’avons pas testé
L’éditeur indique des scènes avec plusieurs personnes ; nous ne les avons pas testées. Nos clips faisaient tous environ cinq secondes d’audio : nous n’avons donc pas testé de clip long proche du maximum de 300 secondes, de chanson complète, ni de portraits qui ne sont pas en 16:9.
Contrôle de contenu
Les portraits qui échouent au contrôle de contenu de ByteDance sont refusés, et rien n’est facturé. Un de nos portraits de test a été refusé ainsi : pas de clip, pas de facturation. Prévoyez que chaque requête passe par ce contrôle.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
prompt | Non | Optionnel, jusqu’à 300 caractères. Dirigez l’ambiance, les gestes, la direction du regard et les mouvements de caméra. 300 caractères maximum |
image_url | Oui | Portrait à animer. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC ou HEIF, moins de 30 Mo, de 300 à 6000 px de chaque côté, rapport largeur/hauteur entre 0,4 et 2,5. |
audio_url | Oui | Parole ou chant, WAV ou MP3, moins de 15 Mo, de 4 à 300 secondes. Le clip dure autant que cet audio ; un audio hors de cette plage est refusé avant toute facturation. |
Tarification
$0.108 / seconde
Facturé à la seconde d’audio en entrée, avec un minimum de 4 secondes et un maximum de 300 secondes ; la réservation suit la durée de l’audio (ou le maximum de 300 secondes lorsqu’elle ne peut pas être lue), et la différence est libérée à la livraison. Les requêtes échouées ou refusées ne sont pas facturées.
Cas d’utilisation
Donner un visage à une réplique enregistrée
Associez une réplique enregistrée ou générée à un portrait pour obtenir un clip de cette personne qui la délivre : intros narrées, témoignages ou dialogues pour un personnage dont le visage est déjà fixé.
Intros d’animateur et accroches
Une réplique d’ouverture enjouée, accompagnée d’un prompt qui nomme l’ambiance et un temps fort sur le dernier mot, nous a donné des expressions amples, des sourcils animés et un rire, comme dans l’exemple de l’émission de fin de soirée de cette page.
Une réplique chantée à partir d’une photo fixe
L’éditeur indique le chant en plus de la parole. Notre test comprenait une réplique lente, chantée-parlée, d’environ cinq secondes devant un micro vintage ; nous n’avons pas essayé de chanson complète.
Des photos de téléphone telles quelles
Le portrait peut être au format JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC ou HEIF, de moins de 30 Mo : une photo prise directement avec un téléphone peut donc être envoyée sans conversion préalable.
Guide de prompt et conseils pratiques
Lier une expression à un moment de la réplique
« Un sourire nonchalant sur le dernier mot » et « un regard détourné à la fin » sont tous deux tombés là où nous les avions placés : le sourire et l’inclinaison de la tête sont arrivés à la fin du clip du supper club, et la tête s’est tournée vers la mer dans la dernière seconde du clip de la terrasse. Nommer l’endroit de la réplique où le temps fort doit se produire donne au modèle un repère pour le synchroniser.
Limitez-vous à quelques temps forts
Chacun de nos prompts demandait une ambiance, un ou deux temps forts du visage et parfois une posture. Cela suffit pour façonner un clip de cinq secondes. Dans nos essais, les temps forts du visage ont suivi le prompt plus fidèlement que les mouvements du corps.
Ne comptez pas sur un mouvement du corps seul
« Pencher vers le micro », dans le prompt de l’émission de fin de soirée, ne s’est pas produit de façon visible, alors que le rire et les sourcils à côté, si. Ce n’est qu’une observation sur un essai, mais si un mouvement du corps compte pour vous, générez une fois et vérifiez avant de vous y fier.
Choisissez le portrait en tenant compte des limites
La largeur et la hauteur doivent chacune être comprises entre 300 et 6000 pixels, et le rapport largeur/hauteur entre 0,4 et 2,5. Nous n’avons testé que des portraits en 16:9.
Coupez l’audio à la performance
Le clip dure autant que l’audio, et la facturation suit la durée de l’audio : coupez donc le fichier à la parole ou au chant que vous voulez vraiment. WAV ou MP3, moins de 15 Mo.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.