Krótka odpowiedź: Lip Sync bierze klip, który już masz, plus plik głosowy od 3 do 60 sekund i przerysowuje wyłącznie usta, tak aby osoba w kadrze powiedziała twoją kwestię. Wideo trwa tyle, ile trwa audio, a nie tyle, ile klip. Pipeline: napisz kwestię, nagraj ją modelem syntezy mowy, wyślij klip i audio jako jedno zadanie asynchroniczne, a potem sprawdź te kilka znaczników czasu, w których synchronizacja się rozjeżdża. Głos kosztuje ułamek centa; synchronizacja kosztuje 0,012 $ za sekundę audio, więc kwestia trwająca 10 sekund kosztuje około 0,12 $.
Podmiana ścieżki dźwiękowej przez ffmpeg sprawia, że usta mówią co innego, jak w kiepsko dubbowanym filmie. Przerysowanie ust jest zadaniem modelu synchronizacji ust.
W naszych testach z października 2026 klipy dla dorosłych, od przytulań w ubraniu po wyraźnie dorosłe materiały, przyjmowano w normalnej cenie, bez rozmazywania i bez przycinania. Lip Sync przerysowuje tylko usta, więc najlepiej działa na klipie, w którym osoba patrzy w obiektyw i mówi; pocałunki albo bardzo ciasne kadry nie dają mu nic do synchronizacji.
W skrócie
- Dwa pliki na wejściu, bez promptu.
video_urlto klip, aaudio_urlto nowa mowa; nie ma nic więcej do ustawienia. - Dźwięk wyznacza długość. Dłuższy klip jest przycinany do długości kwestii; krótszy klip zapętla się, dopóki kwestia się nie skończy. Długości obu plików to jedyna kontrola, jaką masz.
- Audio musi trwać od 3 do 60 sekund, w MP3 lub WAV. Wszystko poza tym zakresem pada w kilka sekund i nic nie kosztuje.
- Płacisz za audio, za sekundę, z zaokrągleniem w górę, z minimum 3 sekund. Zwrócone wideo jest o około pół sekundy dłuższe niż audio, a ten ogon jest bezpłatny.
- To trwa minuty, nie sekundy. Wyślij zadanie i pozwól mu się wykonać; kwestia trwająca 10 sekund zajmuje około czterech minut.
Przed i po
Poza długością, która teraz idzie za kwestią, zmieniają się tylko usta. Mimika, ruch głowy, światło i kadrowanie pochodzą z klatek oryginalnych, więc Lip Sync pasuje do ujęcia, które już ci się podoba, i nie ożywi płaskiej gry aktorskiej.
Krok 1: zacznij od klipu, który udźwignie kwestię
Model maluje usta i zostawia wszystko inne w spokoju, więc w dużej mierze to materiał decyduje o wyniku. Co działa:
- Jedna osoba, twarz dość duża w kadrze, zwrócona głównie do obiektywu. Plan średni to bezpieczny wybór; twarz daleko w tle nie.
- Jedno ciągłe ujęcie. Twarde cięcie w połowie klipu rozrywa synchronizację w miejscu cięcia.
- Wyraźne usta. Dłoń, szklanka, mikrofon albo kosmyk włosów na ustach to miejsce, w którym synchronizacja się zsuwa.
- Gra aktorska pasująca do kwestii. Ponieważ reszta twarzy zostaje nietknięta, spokojna twarz z okrzykniętą kwestią wciąż czyta się jako spokojna.
Rozdzielczość kończy się na około 720p: klip 1920×1080 wraca jako 1280×720, a wysłanie 1080p nie kosztuje więcej.
Jeśli generujesz klip źródłowy
Poproś model wideo o ujęcie, w którym ktoś już mówi: ruch żuchwy i głowy, który sprawia, że mowa wygląda wiarygodnie, musi być w klipie. To jest prompt ruchu, którego użyliśmy w Seedance 2.0 Mini Spicy, zaczynając od nieruchomego obrazu mężczyzny przy barze:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Ustaw długość klipu co najmniej na długość swojej kwestii: Seedance 2.0 Mini Spicy przyjmuje od 4 do 15 sekund. Zostaw dźwięk natywny wyłączony, bo Lip Sync zastępuje ścieżkę dźwiękową.
Dwa sprawdzenia przed opłaceniem synchronizacji:
- Zablokuj kamerę. Powolny najazd kamery powoduje, że cięcie pętli skacze ze zbliżenia z powrotem na szerszą pierwszą klatkę, więc wypatruj takiego skoku.
- Porównaj twarz z nieruchomym obrazem. Zamiana obrazu na wideo potrafi rozjechać twarz w ciągu kilku sekund, a Lip Sync zachowuje twarz, jaką ma klip. Odrzuć rozjechany klip przed synchronizacją.
Dlaczego nie zlecić dźwięku modelowi wideo
Modele wideo takie jak Seedance 2.x, Wan 3.0 i Kling 3.0 potrafią generować dźwięk razem z obrazem. To w porządku dla dźwięku tła albo luźnych dialogów, ale dźwięk jest wtopiony w pełne renderowanie: zmiana jednego słowa oznacza zapłacenie za cały klip od nowa. Nowa kwestia trwająca 10 sekund kosztuje około 0,12 $ na synchronizację, a ponowne wyrenderowanie 10-sekundowego klipu 720p w Seedance 2.0 Mini Spicy kosztuje 0,82 $.
Krok 2: napisz kwestię i nagraj ją
Pasuje każdy MP3 lub WAV od 3 do 60 sekund, także twoje nagranie. Jeśli nie masz lektora, model syntezy mowy to najszybsza droga. Te cztery dobrze sprawdzają się przy synchronizacji ust:
| Model | Jak sterujesz interpretacją | Cena katalogowa | Kwestia trwająca 10 sekund kosztuje około |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Tekst plus jeden z 30 głosów, z opcjonalnym style, accent, pace i notatką o interpretacji. Wskazówki w nawiasach kwadratowych, takie jak [laughs], są zwykle wykonywane, a nie czytane | 0,00032 $ za sekundę audio | 0,0032 $ |
| Gemini 2.5 Pro TTS | To samo sterowanie co Flash; starszy model, nieco wyższa cena | 0,00045 $ za sekundę audio | 0,0045 $ |
| MiniMax Speech 2.8 HD | Jedno ustawienie emotion. Wskazówki piszesz w nawiasach okrągłych, jak (sighs) | 0,12 $ za 1 000 znaków | 0,018 $ |
| Seed Speech 2.0 | 41 głosów, 10 języków i osobna notatka, która steruje interpretacją, nie będąc czytana na głos | 0,072 $ za 1 000 znaków | 0,011 $ |
Cokolwiek wybierzesz, głos kosztuje przy synchronizacji praktycznie nic. Do synchronizacji ust zacznij od Gemini 3.8 Flash TTS: ma to samo sterowanie co 2.5 Pro i kosztuje mniej. Przejdź na MiniMax, jeśli potrzebujesz ustawienia emotion, albo na Seed Speech 2.0, jeśli chcesz jego notatkę o interpretacji w prostym języku.
Cztery zasady, które nie pozwalają dźwiękowi podkopać obrazu:
- Zostań w zakresie od 3 do 60 sekund. Generowany angielski ma 12 do 19 znaków na sekundę, więc napisz co najmniej 60 znaków (mniej więcej tuzin słów); od 700 do 1 100 znaków wypełnia 60 sekund. Mierz plik, nie scenariusz: 10-znakowe "Come here." wyszło w 1,76 sekundy i zostało odrzucone (bardzo krótkie kwestie czytają się wolniej na znak).
- Przytnij ciszę na obu końcach. Głosy Gemini dodają od 0,1 do 0,3 sekundy przed pierwszym słowem i do 0,45 po ostatnim. Rozliczenie zaokrągla w górę, więc kwestia trwająca 4,04 sekundy jest pobierana jako 5 sekund, a ta sama kwestia przytnięta poniżej 4 sekund jako 4 sekundy.
- Dopasuj interpretację do twarzy. Szept z oddechem nałożony na twarz, która się śmieje, wygląda źle, niezależnie od tego, jak dobra jest synchronizacja. Wybierz emocję lub styl pasujący do materiału, który masz.
- Wysyłaj suchą mowę. Bez muzyki pod spodem. Jeśli chcesz podkład muzyczny, dodaj go po synchronizacji.
Głos zmienia usta tak samo jak słowa. Ten sam klip i te same słowa nagrane głosem MiniMax Speech 2.8 HD dają inne kształty ust:
Wszystkie cztery czytają scenariusze dla dorosłych; szczegóły dla każdego modelu znajdziesz na stronach modeli syntezy mowy.
Krok 3: najpierw Playground, potem API
Najpierw sprawdź to w Playground, z własnym klipem i jedną kwestią:
- Otwórz stronę Gemini 3.8 Flash TTS, wklej kwestię w Text, wybierz Voice i uruchom. Pobierz WAV albo pomiń ten krok, jeśli masz własne nagranie.
- Otwórz stronę Lip Sync, dodaj klip w Input video, a audio w Input audio, sprawdź szacunek ceny i uruchom. Przygotuj się na kilka minut: około czterech dla kwestii trwającej 10 sekund.
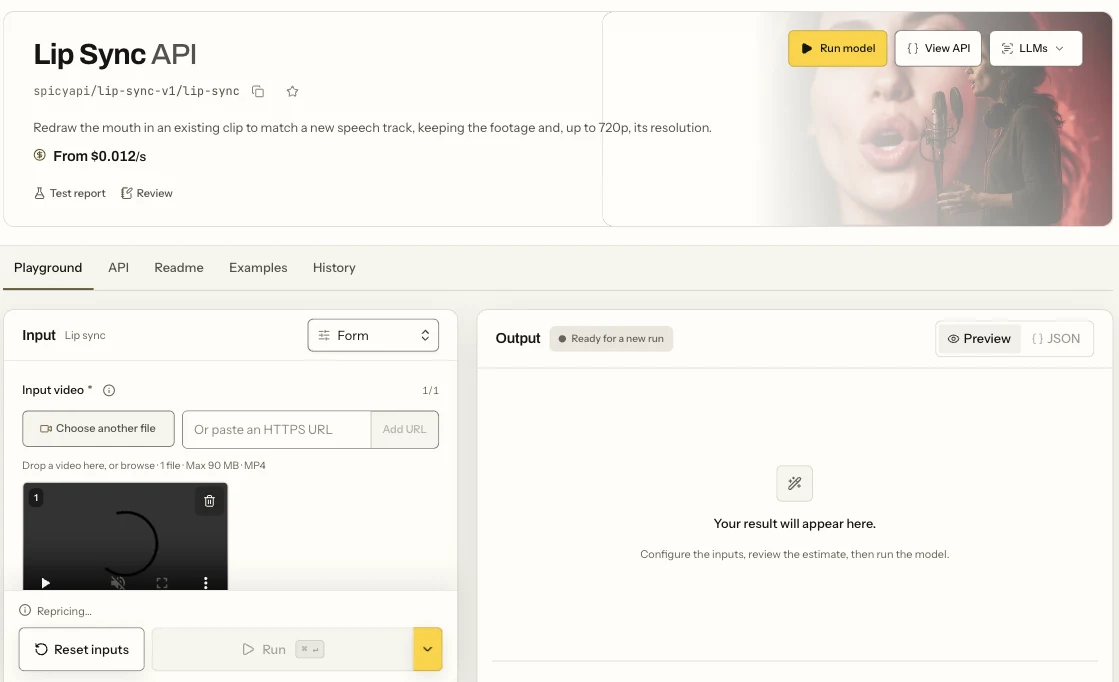
Strona Lip Sync w Playground: widok Form, pole Input video, w którym dodajesz klip, oraz przycisk Run.
Limity, które mają znaczenie: klip MP4 oraz plik MP3 lub WAV, każdy do 90 MB.
Do własnej aplikacji wyślij te same dwa wejścia jako jedno zadanie (najpierw wgraj klip i audio, jak opisano w przewodniku po mediach):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Pełne żądanie, odpytywanie i callbacki: przewodnik po zadaniach.
Niech to wykona agent
Playground wystarczy do pojedynczej kwestii. Gdy głos, synchronizacja i cięcie tworzą powtarzalny przepływ, oddaj to agentowi; wszystkie trzy narzędzia pokazują cenę i pytają przed płatnym wywołaniem.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, gdzieinput.jsonzawiera powyższy obiektinput(dokumentacja CLI). - MCP: dodaj serwer MCP, a potem zapytaj: "Lip-sync ./take.mp4 with ./line.wav." Wywołuje
spicyapi_upload_file,spicyapi_task_createispicyapi_task_wait. - Skill:
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, dzięki któremu asystent odczytuje aktualny schemat modelu, zanim zbuduje wejście.
Krok 4: sprawdź wynik tam, gdzie się psuje
Wideo zsynchronizowane może wyglądać dobrze przez 90 % swojej długości i rozpaść się w jednej chwili. Przejdź do tych punktów:
- Pierwsza półsekunda. Czy usta pozostają nieruchome do pierwszego słowa?
- Dźwięki P, B i M. Wargi powinny się całkowicie zamykać. Miękkie lub brakujące zwarcia to najszybszy znak słabej synchronizacji.
- Każda wielokrotność długości klipu, jeśli kwestia jest dłuższa niż klip. 5-sekundowy klip pod 10-sekundową kwestią powtarza się w 0:05 i 0:10. Właśnie tam widać szw.
- Ostatnia półsekunda. Plik trwa około 0,5 sekundy dłużej niż audio, a usta powinny tam spoczywać.
- Każda klatka, w której dłoń, szklanka albo obrót głowy przechodzi przez usta.
Gdy kwestia jest dłuższa niż klip
Pętla to proste cięcie z powrotem do pierwszej klatki klipu i żadne ustawienie tego nie zmieni. Napraw to plikami, które wysyłasz:
- Wydłuż klip. Wygenerowanie klipu źródłowego tak długiego jak kwestia to czyste rozwiązanie i zwykle najtańsze, jeśli i tak generujesz.
- Podziel kwestię. Rozbij scenariusz w naturalnych przerwach na fragmenty nie dłuższe niż klip, zsynchronizuj każdy osobno i połącz wyniki w swoim edytorze. Każdy fragment i tak musi mieć co najmniej 3 sekundy.
- Wybierz stabilne ujęcie. Jeśli musisz zapętlać, klip z małym ruchem głowy lepiej ukrywa skok niż klip z dużym gestem.
Ile to kosztuje
Lip Sync rozlicza za sekundę audio, z zaokrągleniem w górę, z minimum 3 sekund. Przy głosie Gemini 3.8 Flash TTS:
| Długość kwestii | Głos (Gemini 3.8 Flash TTS) | Lip Sync | Razem |
|---|---|---|---|
| 5 sekund | 0,0016 $ | 0,06 $ | około 0,06 $ |
| 10 sekund | 0,0032 $ | 0,12 $ | około 0,12 $ |
| 30 sekund | 0,0096 $ | 0,36 $ | około 0,37 $ |
| 60 sekund | 0,0192 $ | 0,72 $ | około 0,74 $ |
Gdy zadanie działa, wycena rezerwuje maksimum 60 sekund (0,72 $); nieużywana część jest zwalniana, gdy długość audio jest już ustalona. Plik poza zakresem od 3 do 60 sekund pada w kilka sekund z invalid_request i nic nie kosztuje, a każde nieudane zadanie zwalnia całą rezerwację. Klip źródłowy, jeśli go generujesz, jest zwykle największym kosztem, dlatego ponowne nagranie głosu jest tanie: każda nowa kwestia kosztuje około 0,12 $ na 10 sekund zamiast nowego renderu.
Lip Sync, Talking Avatar czy Kling Avatar 2.0?
Wszystkie trzy sprawiają, że osoba na ekranie wypowiada twoje audio. O tym, co wybierzesz, decyduje punkt wyjścia:
| Masz | Użyj | Cena | Wynik | Warto wiedzieć |
|---|---|---|---|---|
| Klip z osobą już na obrazie | Lip Sync | 0,012 $ za sekundę audio | Do około 720p, oryginalna gra aktorska zachowana | Audio od 3 do 60 sekund |
| Tylko zdjęcie portretowe | Talking Avatar | 0,018 $ za sekundę | Około 0,2 megapiksela (640×352 ze zdjęcia 16:9) | Dodaje mrugnięcia i drobne ruchy głowy; audio od 3 do 60 sekund |
| Tylko portret, a potrzebujesz 720p albo 1080p albo dłuższego ujęcia | Kling Avatar 2.0 | 0,0512 $ za sekundę w 720p, 0,1024 $ w 1080p | 720p lub 1080p | Audio do około 5 minut. Kling moderuje wejścia: portret z pełną nagością został odrzucony, a odrzucone żądanie nie jest pobierane |
Jeśli masz materiał, zacznij od Lip Sync: jest najtańszy na sekundę i jedyny, który zachowuje prawdziwą grę aktorską. Przechodź do narzędzia od portretów dopiero wtedy, gdy nie ma materiału, na którym można pracować.
FAQ
Czy Lip Sync przetłumaczy moje wideo?
Nie. Synchronizuje audio, które mu dasz. Aby zrobić wersję w innym języku, przetłumacz kwestię sam, nagraj ją modelem, który mówi w tym języku (Gemini 3.8 Flash TTS obsługuje ponad 130 języków), i zsynchronizuj nowy plik z tym samym klipem.
Co dzieje się z oryginalnym dźwiękiem?
Zostaje zastąpiony; wynik niesie tylko audio, które wysłałeś.
Dlaczego moje zadanie od razu się nie powiodło?
Audio trwało mniej niż 3 sekundy, więcej niż 60 sekund albo nie było plikiem MP3 ani WAV; błąd podaje długość. Do krótkiej kwestii dodaj słowa, a nie ciszę, bo cisza wlicza się w sekundy, za które płacisz.
Czy Lip Sync działa na materiałach NSFW?
Tak, jeśli w kadrze jest jedna osoba dorosła: klip przechodzi w normalnej cenie i wraca bez rozmazywania oraz bez zasłaniania. Model przerysowuje tylko usta, więc potrzebuje twarzy, która mówi do obiektywu.
Czy mogę użyć własnego nagrania głosowego?
Tak. Każdy MP3 lub WAV od 3 do 60 sekund, do którego masz prawa, działa dokładnie tak jak głos wygenerowany.
Następny krok
Masz już ujęcie, które ci się podoba? Lip Sync plus jeden z tych głosów to najtańszy sposób na zmianę tego, co mówi postać: około 0,12 $ na 10 sekund, bez nowego renderu. Spróbuj na własnym klipie na stronie modelu Lip Sync albo przeczytaj recenzję Lip Sync.