
Użyj spicyapi/talking-avatar-v1/talking-avatar, aby zamienić jeden portret i 3–60 sekund mowy w MP3 lub WAV w mówiący plik MP4. Nagranie dostarcza słowa i tempo, a portret twarz i scenę. Koszt to 0,018 $ za każdą zwróconą sekundę, zaokrąglaną w górę, z minimum trzech sekund, a kwestia trwająca 4–5 sekund renderuje się w około minutę (nagranie 60-sekundowe trwa dłużej). Wynik jest kompaktowy, około 0,2 megapiksela przy 25 kl./s, więc nadaje się do karty, feedu lub okna czatu, a nie do prezentera HD na pełnym ekranie. Jeśli potrzebujesz HD lub dłuższego audio, zobacz na końcu opcję Kling Avatar 2.0. Prawdziwy wynik możesz odsłuchać na stronie modelu.
Przygotuj portret i nagranie
Przykład używa Mary, fikcyjnej dorosłej prowadzącej kurs w turkusowej bluzce. Portret powinien być:
- z jedną wyraźną twarzą, mniej więcej na wprost, równo oświetloną, głowa i ramiona;
- bez dłoni, włosów, okularów przeciwsłonecznych czy mikrofonu zasłaniających usta;
- w formacie JPEG, PNG lub WebP, do 10 MB, z zapasem wokół brody i włosów na potrzeby docelowego odtwarzacza.
Nagranie to plik MP3 lub WAV do 90 MB i długości 3–60 sekund, z jednym głosem, bez muzyki i nakładających się mówców. Przytnij przypadkową ciszę, ale nie pierwsze ani ostatnie słowo: cisza wlicza się do długości, za którą płacisz. Pliki spoza zakresu 3–60 sekund są odrzucane przed pobraniem jakiejkolwiek opłaty.
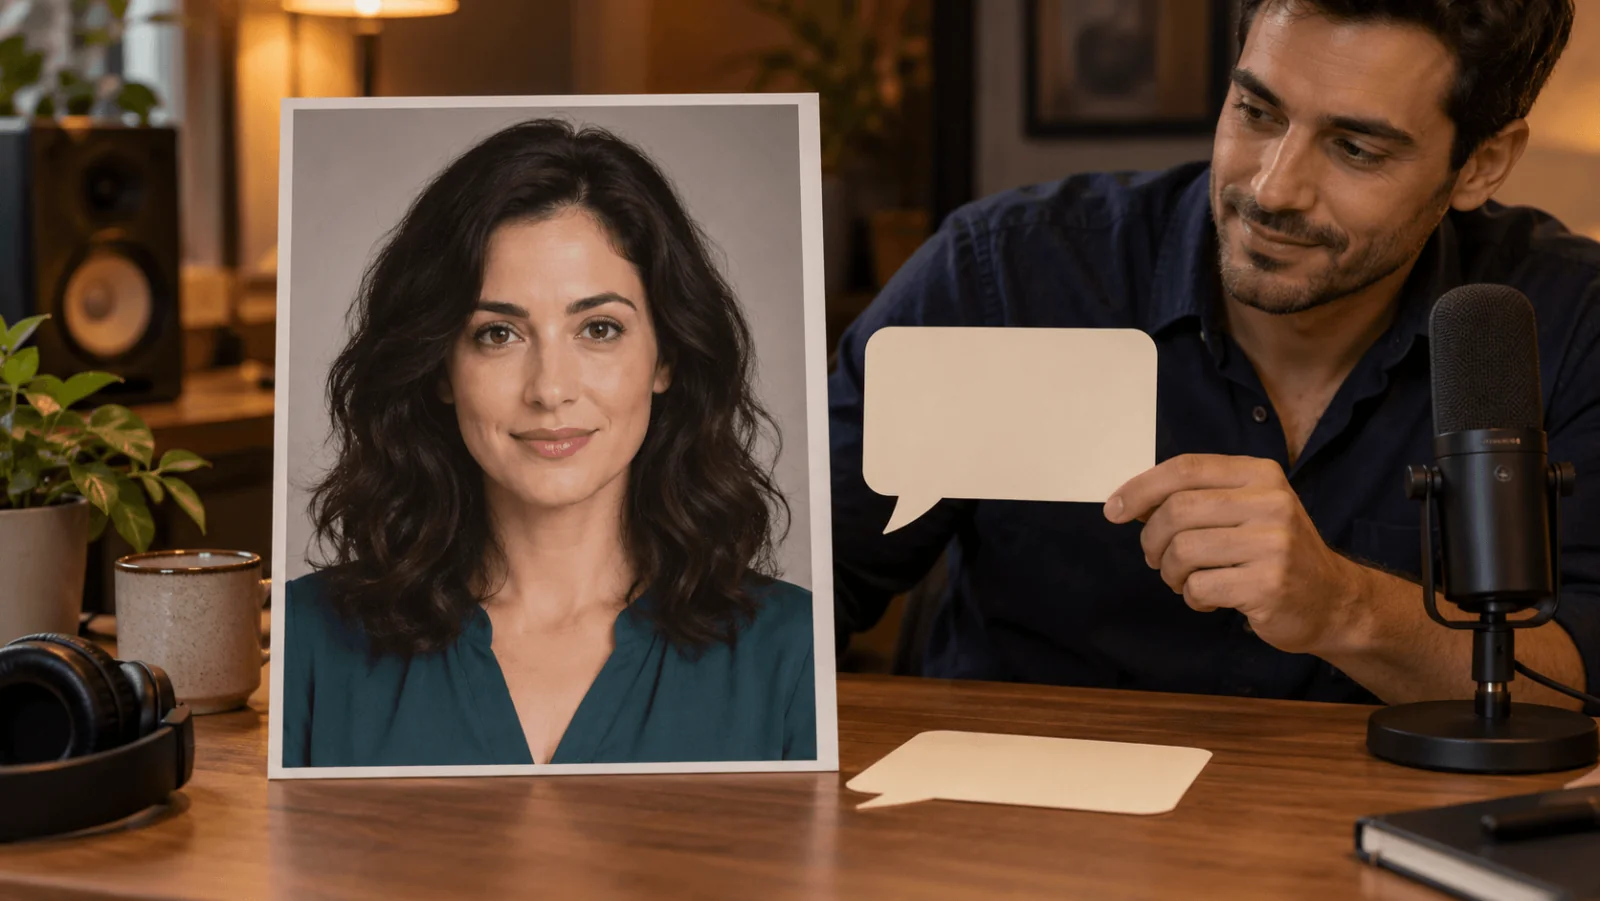
Ilustracja przedstawiająca etap przygotowania, nie klatka z Talking Avatar.
Nie ma pola script, voice_id ani language. Aby uzyskać inny język, nagraj lub wygeneruj inny plik audio i użyj tego samego portretu. Jeśli masz już nagranie poruszającego się prezentera i chcesz tylko wymienić mowę, skorzystaj zamiast tego z procesu synchronizacji ust.
Dane wejściowe
| Pole | Zastosowanie w tym przykładzie |
|---|---|
image_url | Wymagane: zatwierdzony portret Mary |
audio_url | Wymagane: wyeksportowane nagranie |
prompt | Opcjonalne: calm and welcoming; tylko wyraz twarzy, nie zmieni, kto mówi ani gdzie |
mask_url | Pomiń przy jednej osobie. Przy portrecie grupowym czarno-biały obraz tego samego rozmiaru z bielą na osobie mówiącej |
seed | Opcjonalna liczba całkowita 0–2147483647. Ustaw ją, aby porównać dwa nagrania na jednym portrecie; pomiń, aby uzyskać nowe ujęcie |
Nie ma pola na rozdzielczość, liczbę klatek na sekundę, czas trwania ani kamerę. Zdjęcie 16:9 wraca w rozmiarze 640×352, a portret 3:4 w 400×544.
Twoje pliki muszą być dostępne pod bezpośrednim linkiem HTTPS. Przesłanie ich jest pewniejsze niż wskazanie strony lub linku udostępniania; przesłane referencje są krótkotrwałe, więc zachowaj oryginały.
Ile to kosztuje i dlaczego wycena wynosi 1,08 $
Opłata to zwrócony czas zaokrąglony w górę do pełnych sekund, minimum trzy sekundy:
| Zwrócony czas | Sekundy rozliczane | Opłata końcowa |
|---|---|---|
| 3 sekundy | 3 | 0,054 $ |
| 12,2 sekundy | 13 | 0,234 $ |
| 60 sekund | 60 | 1,08 $ |
Wycena oraz rezerwa założona przy tworzeniu zadania dotyczą limitu 60 sekund: 1,08 $, niezależnie od długości Twojego audio. Gdy klip jest gotowy, opłata końcowa jest rozliczana według rzeczywistego czasu, a reszta zostaje zwolniona; nieudane zadanie zwalnia całą rezerwę. Do tego czasu rezerwa liczy się do Twojego salda i limitów wydatków, więc prawie puste saldo lub niski limit mogą zablokować nawet 12-sekundowy klip. Sama wycena niczego nie rezerwuje.
Najpierw wypróbuj w Playground
- Otwórz stronę modelu Talking Avatar i zostań na karcie Playground w widoku Form. Aby uruchomić, zaloguj się na konto z zasilonym saldem; cena pojawia się po zalogowaniu.
- W polu Input image upuść portret Mary lub wklej jego link przez Add URL.
- W polu Input audio dodaj plik MP3 lub WAV w ten sam sposób. Przesłanie pliku jest pewniejsze niż link.
- Opcjonalnie wpisz kilka słów o wyrazie w polu Prompt (
calm and welcoming), dodaj Mask dla portretu grupowego albo ustaw Seed, aby porównać dwa nagrania. - Uruchom, a potem odtwórz wynik z dźwiękiem w rozmiarze, w jakim będzie wyświetlany.
Playground wysyła to samo żądanie co API, więc portret i nagranie, które działają tutaj, zadziałają w kodzie. Jeśli tutaj trudno odczytać ruch ust, popraw pliki źródłowe, zanim napiszesz kod.
Potem wywołaj z kodu
Zainstaluj SDK dla Pythona (pip install spicyapi), ustaw SPICY_API_KEY i uruchom poniższy kod. Utworzenie zadania jest płatne, a rezerwa to opisany wyżej limit 1,08 $.
import shutil
import urllib.request
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

portrait = client.upload_file("./mara.png")      # local files become spicy:// URIs
speech = client.upload_file("./mara-intro.mp3")

task = client.create_task(
    model="spicyapi/talking-avatar-v1/talking-avatar",
    input_data={
        "image_url": portrait["uri"],
        "audio_url": speech["uri"],
        "prompt": "calm and welcoming",
        "seed": 42,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")

url = output_assets(final)[0]["url"]
request = urllib.request.Request(url, headers={"User-Agent": "avatar-example/1.0"})  # default Python clients can get a 403
with urllib.request.urlopen(request, timeout=60) as response, open("avatar.mp4", "wb") as target:
    shutil.copyfileobj(response, target)
print("Saved avatar.mp4")
Wyceny, oczekiwanie, ponowienia i błędy opisuje dokumentacja SDK dla Pythona oraz przewodnik po zadaniach asynchronicznych. Przyjętego zadania nie można anulować, więc sprawdź cenę przed uruchomieniem. Linki do wyników są tymczasowe, więc zachowaj własną kopię, jak opisano w artykule jak trwale przechowywać wygenerowane media.
Albo pozwól uruchomić to agentowi
Jeśli klipy ma tworzyć asystent, daj mu CLI lub serwer MCP. Oba pokazują cenę i proszą o potwierdzenie przed płatnym wywołaniem. Skill dodaje instrukcje na wierzchu jednego i drugiego.
- CLI.
spicyapiuruchamia jedno zadanie z terminala (npx @spicyapi/clidziała bez instalacji):
``bash spicyapi files upload ./mara.png # prints a spicy:// URI; repeat for the audio spicyapi tasks create --model spicyapi/talking-avatar-v1/talking-avatar \ --input-file input.json --wait ``
input.json zawiera ten sam obiekt input co wyżej, z dwoma identyfikatorami URI spicy://.
- Serwer MCP. Dodaj serwer MCP do swojego asystenta, a potem poproś: "Make Mara speak ./mara-intro.mp3 using ./mara.png with Talking Avatar." Wywoła
spicyapi_upload_file, następniespicyapi_task_create(które zatrzymuje się na potwierdzenie ceny), a potemspicyapi_task_wait.
``json { "mcpServers": { "spicyapi": { "command": "npx", "args": ["--yes", "--package=@spicyapi/mcp", "spicyapi-mcp"], "env": { "SPICY_API_KEY": "YOUR_SPICY_API_KEY" } } } } ``
- Skill.
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, który uczy asystenta programisty czytać aktualny schemat i ponownie używać kluczy idempotentności zamiast zgadywać. Sam nie uruchamia zadań, więc używaj go razem z CLI lub MCP.
Naprawiaj problemy u źródła
Odtwórz avatar.mp4 z dźwiękiem w rozmiarze, w jakim będzie wyświetlany, i porównaj oczy, kontur twarzy i linię włosów z portretem źródłowym: samo poruszanie ustami nie dowodzi, że postać pozostała spójna.
| Objaw | Następny krok |
|---|---|
| Twarz jest mała lub trudno odczytać ruch ust | Przytnij źródło do głowy i ramion z widoczną brodą i wyślij ponownie |
| Mowa jest pospieszna lub źle wymawiana | Nagraj ponownie; prompt o nastroju nie naprawi słów ani tempa |
| Muzyka lub kilka głosów zaciera mowę | Wyeksportuj czyste nagranie z jednym głosem i dodaj muzykę po animacji |
| W portrecie grupowym mówi niewłaściwa osoba | Dodaj maskę o dokładnie takim rozmiarze jak portret, z bielą na osobie mówiącej |
| Stałe przesunięcie dźwięku po montażu | Porównaj pobrany oryginał ze swoim eksportem i popraw synchronizację ścieżek w montażu |
| Dziwny ruch ust lub zębów przy jednej frazie | Spróbuj wyraźniejszego portretu lub wolniejszego odczytania tej frazy |
Ilustracja przedstawiająca sprawdzanie tożsamości; wydrukowane portrety to skonstruowana grafika, nie klatki awatara.
Zasady dotyczące treści i kiedy wybrać inny model
SpicyAPI nie dodaje filtra bezpieczeństwa w Talking Avatar v1, a o tym, co wróci, decyduje sam model; twarz, której nie wykryje, albo odrzucony obraz kończy zadanie błędem. Używaj wyłącznie portretów fikcyjnych lub dorosłych osób, które wyraziły zgodę.
Kling Avatar 2.0 również przyjmuje portret i audio, w 720p (0,0512 $ za sekundę) lub 1080p (0,1024 $ za sekundę), z klipami do około pięciu minut. To model filtrowany: portrety o treści dla dorosłych są odrzucane, więc pasuje do klipów prezentera i marki, a nie do postaci kierowanych do dorosłych odbiorców. Wybierz Talking Avatar v1 do krótkich, tanich klipów w rozmiarze karty, a Kling Avatar 2.0, gdy klip ma być ostry na pełnym ekranie lub trwać dłużej niż minutę.






