Wprowadzenie
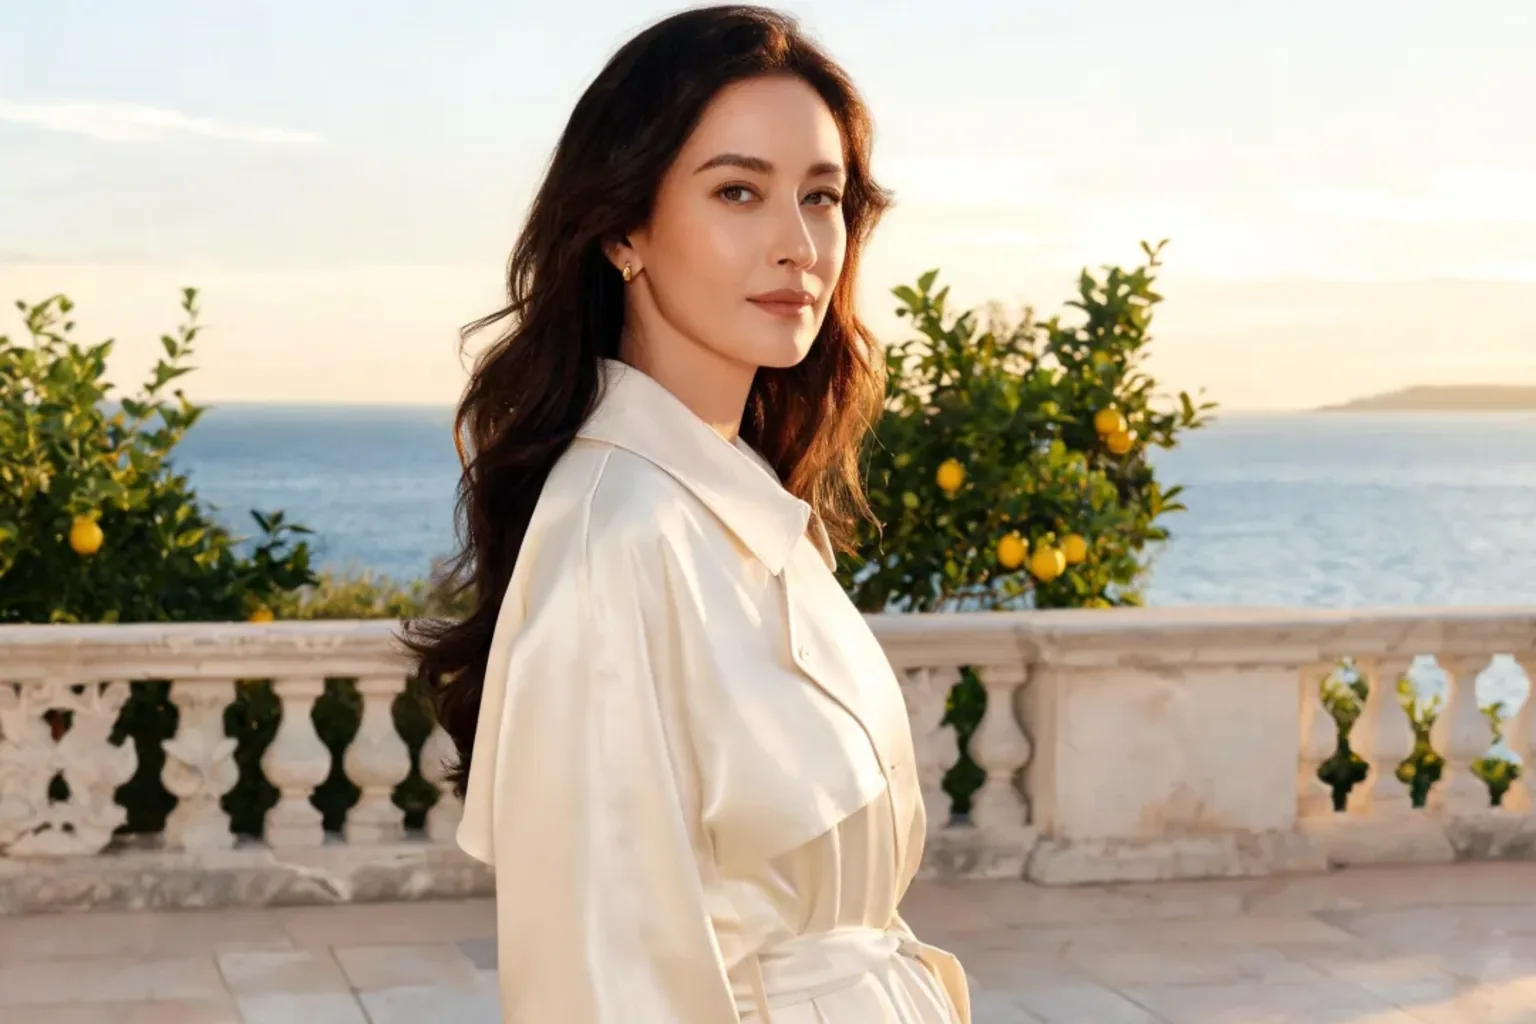
Talking Avatar zamienia jeden portret w mówiący klip. Wysyłasz twarz w image_url i nagranie głosu w audio_url; usta, szczęka i drobne ruchy głowy zostają animowane tak, że osoba wydaje się mówić dokładnie to, co jest w nagraniu. Klip trwa tyle, co audio, od trzech do sześćdziesięciu sekund, i wraca już z twoim nagraniem na ścieżce, gotowy do publikacji albo do montażu.
Najważniejsze funkcje
Rytm wyznacza dźwięk
Każdy kształt ust powstaje z samego dźwięku, więc pauzy, szybkie frazy i akcenty wypadają tam, gdzie postawił je mówiący. Nie ma pola na scenariusz ani ustawień czasu: nagraj kwestię tak, jak ma brzmieć, a twarz pójdzie za nią sekunda po sekundzie.
Portret pozostaje sceną
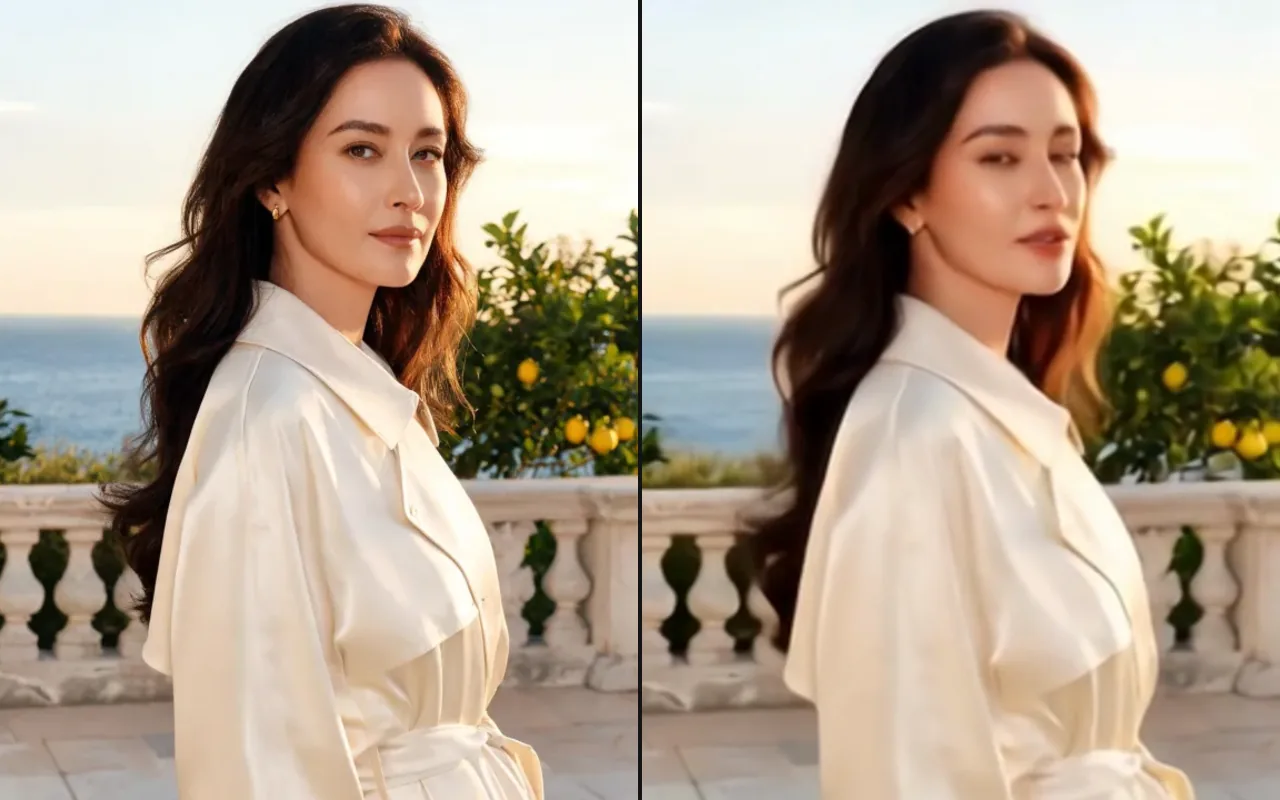
Ubranie, włosy, tło i kadr pochodzą wprost z obrazu. Wokół twarzy nic nie jest generowane od nowa, dlatego prezenter, postać czy twarz marki pozostaje rozpoznawalnie tą samą osobą w kolejnych klipach. Wynik jest niewielki, około 0,2 megapiksela przy 25 klatkach na sekundę (zdjęcie 16:9 wróciło w 640×352, portret 3:4 w 400×544), więc planuj pod feedy i okna czatu, a nie pełny ekran.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
image_url | Tak | Twarz, która będzie mówić. Jedna osoba, patrząca mniej więcej w obiektyw, przy równym świetle; najlepiej sprawdza się kadr do ramion. od 1 znaków |
audio_url | Tak | Mowa do synchronizacji ust, od 3 do 60 sekund, MP3 lub WAV. Musi to być bezpośredni link do pliku audio; najpewniej jest go przesłać. od 1 znaków |
prompt | Nie | Opcjonalnie. Kilka słów o mimice lub nastroju: spokojnie, pogodnie, poważnie. do 1000 znaków |
mask_url | Nie | Opcjonalnie. Potrzebna tylko wtedy, gdy na portrecie jest kilka osób: czarno-biały obraz tej samej wielkości, biały na osobie, która ma mówić. od 1 znaków |
seed | Nie | Ustal go, by porównać dwa przebiegi z tym samym portretem i audio; zostaw pusty, by za każdym razem dostać nową wersję. |
Cennik
$0.018 / sekundę wyniku
Opłata za sekundę gotowego wideo, które trwa tyle co twoje audio, w górę do pełnej sekundy, minimum 3 sekundy.
Zastosowania
Klipy z prezenterem z jednego zdjęcia
Wstępy do kursów, prezentacje produktów i cotygodniowe komunikaty mogą raz po raz korzystać z jednego zatwierdzonego portretu, za każdym razem z nowym nagraniem. Zmiana języka to tylko wysłanie innego pliku audio z tym samym obrazem, więc jeden prezenter obsługuje kilka rynków.
Postacie, które odpowiadają na głos
Aplikacje z towarzyszem i gry fabularne mogą pozwolić postaci wypowiedzieć odpowiedź do kamery: zachowaj jeden portret postaci, zamień odpowiedź na mowę i wyślij parę. Nawet krótka odpowiedź renderuje się minutę lub dwie, więc uruchom zadanie, gdy odpowiedź tekstowa jest już na ekranie.
Wskazówki
Dobierz portret pod usta
Ruszają się usta, więc daj im piksele: kadr do ramion, twarz mniej więcej do kamery, równe światło i nic przed wargami. Okulary przeciwsłoneczne, mocny profil i małe twarze w szerokim planie to typowe powody dziwnego wyniku.
Czysty dźwięk ważniejszy niż głośny
Eksportuj mowę bez muzyki w tle, pogłosu dużych pomieszczeń i nakładających się głosów. Wytnij ciszę na początku i na końcu, bo cisza też wlicza się do płatnej długości. Trzymaj każdy plik w przedziale od trzech do sześćdziesięciu sekund, a dłuższe scenariusze dziel w naturalnych pauzach.
Prompt na nastrój, maska na mówiącego
Pole prompt lekko kieruje mimiką — spokojnie, pogodnie, poważnie — ale nie zmienia tego, kto i gdzie mówi. Jeśli na portrecie jest kilka osób, przekaż mask_url z mówiącą osobą na biało na czarnym tle, w tym samym rozmiarze co obraz. Ustal seed, aby porównać dwa nagrania na tym samym portrecie.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.