Wprowadzenie
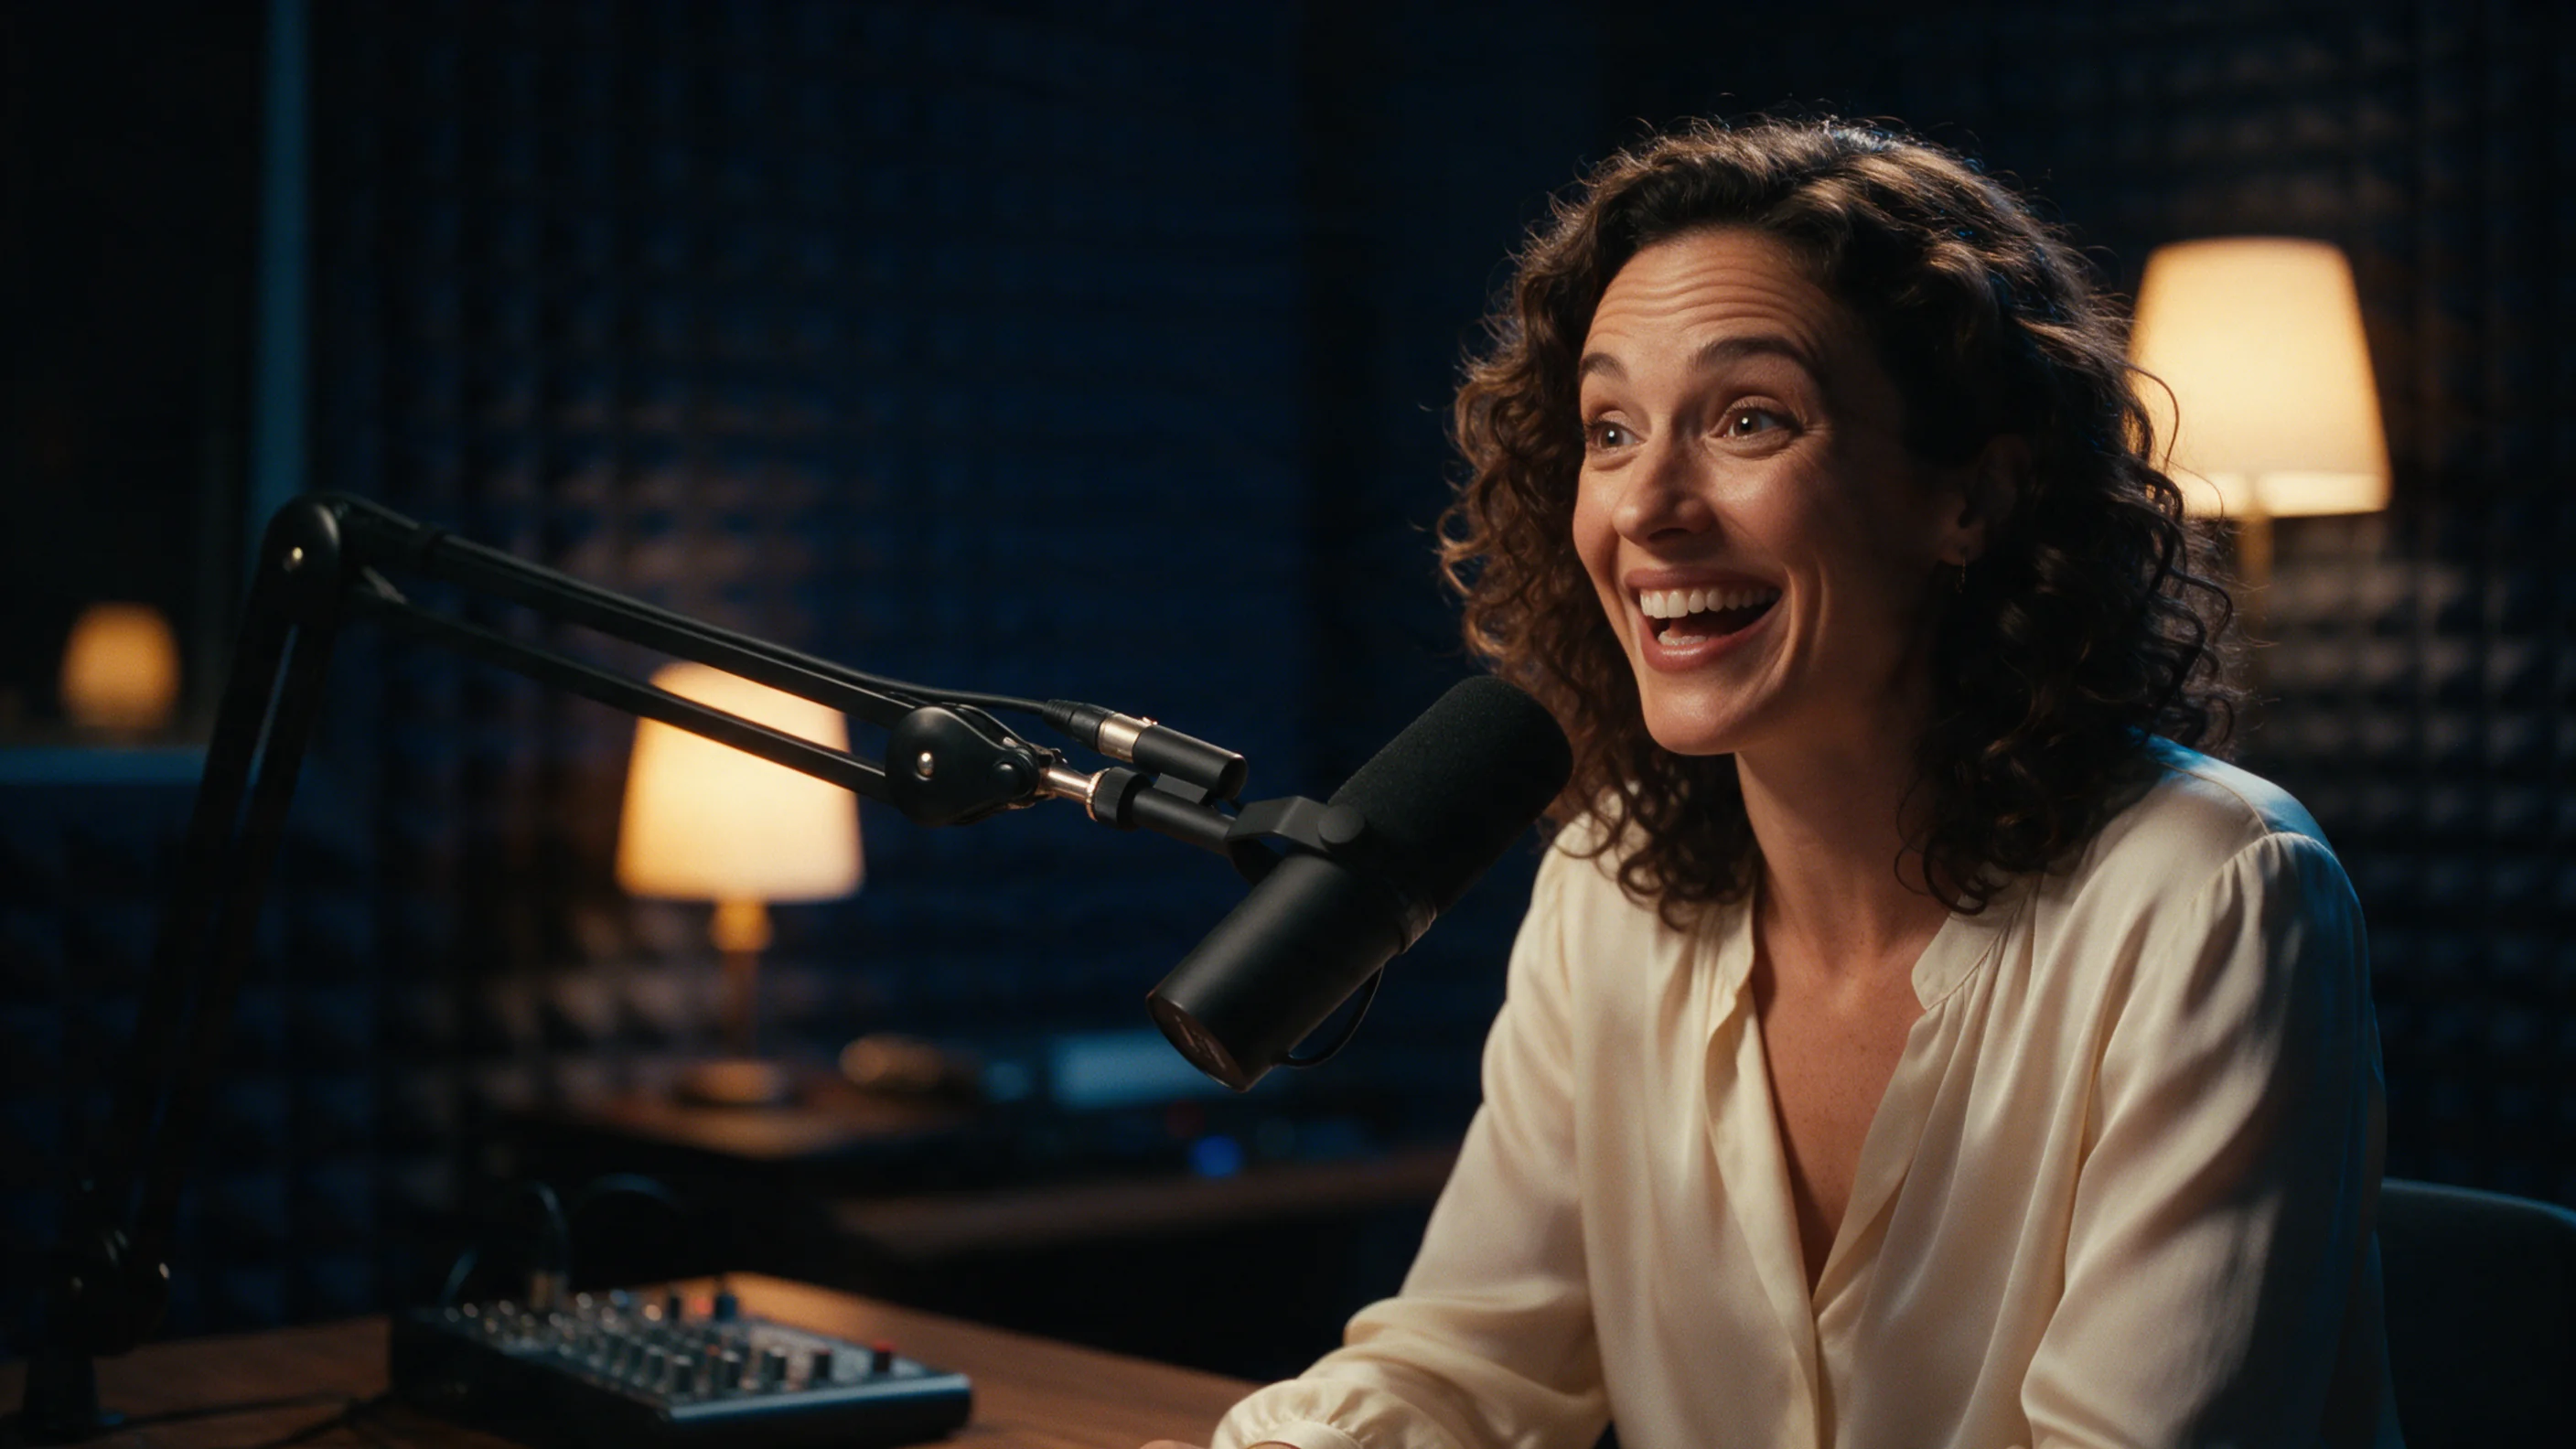
Mówiący awatar OmniHuman 2.0 to model awatarów sterowanych dźwiękiem od ByteDance. Wysyłasz portret (image_url) i plik audio z mową lub śpiewem (audio_url), a model zwraca wideo 720p tej osoby wykonującej to audio – twarz, usta, głowa i górna część ciała poruszają się razem z nim, zamiast pozostawiać tułów nieruchomy. Klip ma długość audio, od 4 do 300 sekund. Nie ma pola czasu trwania, rozdzielczości ani proporcji obrazu. Opcjonalny prompt, do 300 znaków, kieruje nastrojem, gestami, kierunkiem wzroku oraz – według wydawcy – ruchem kamery.
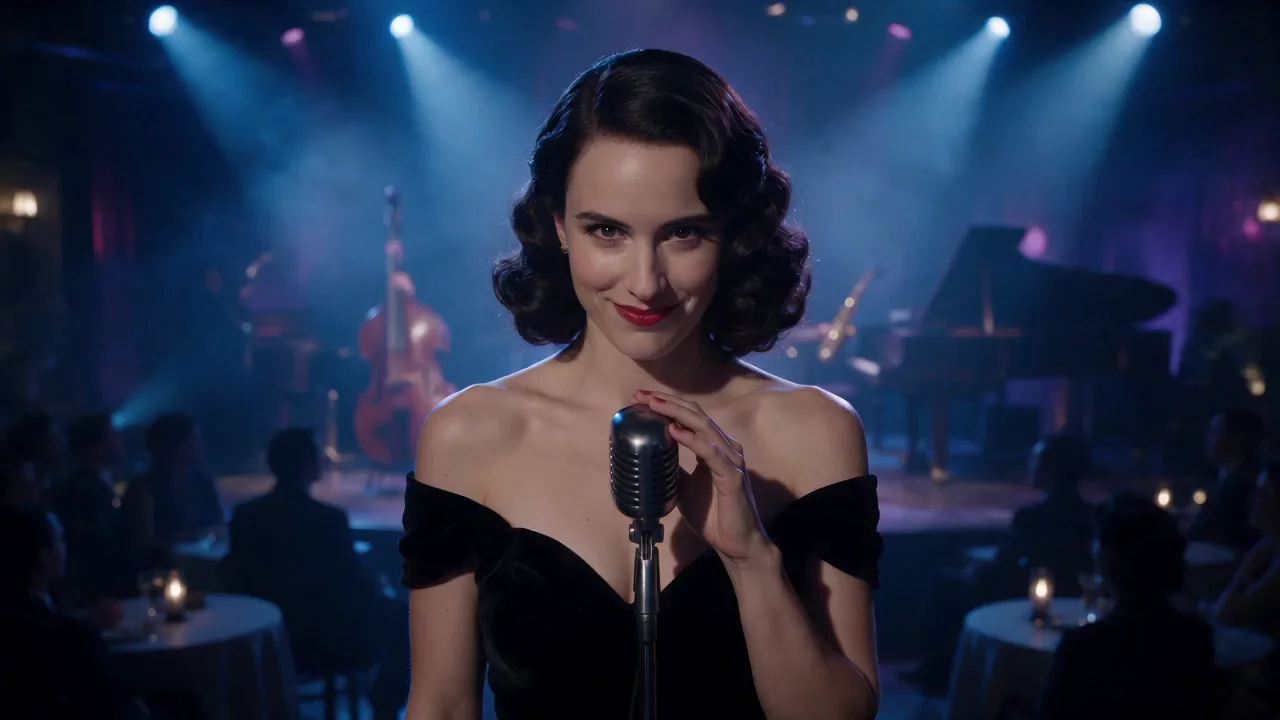
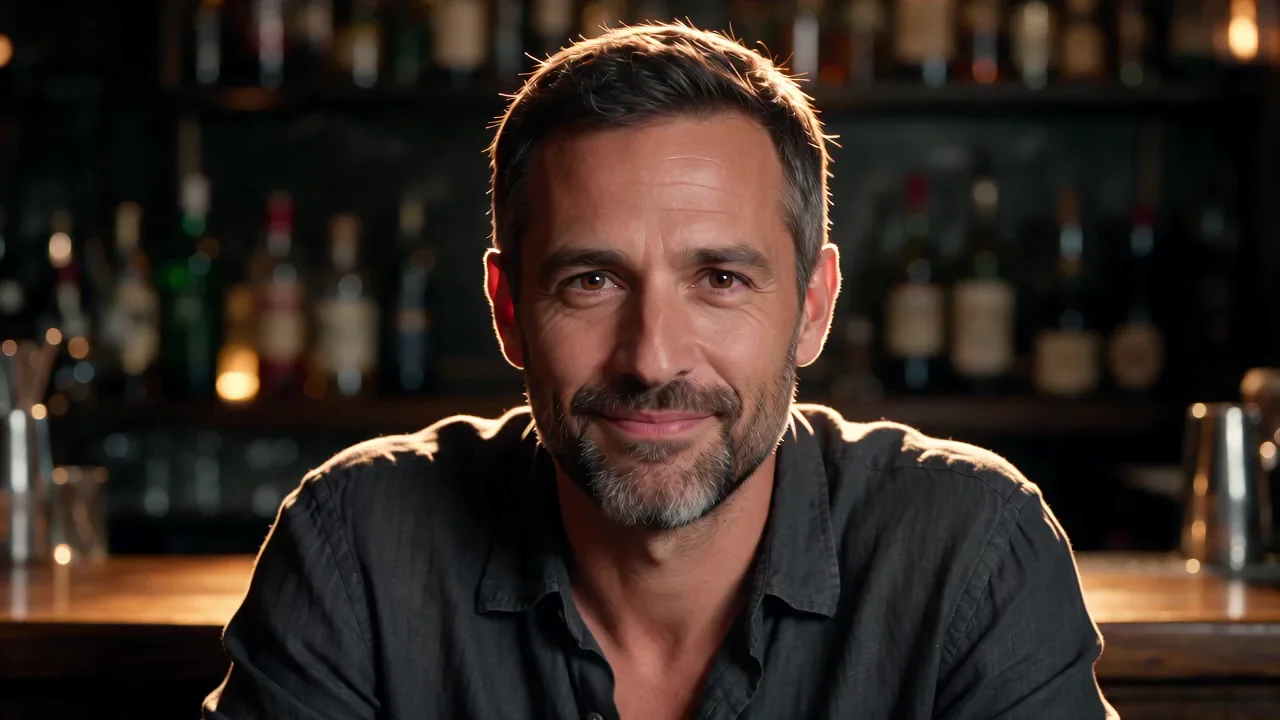
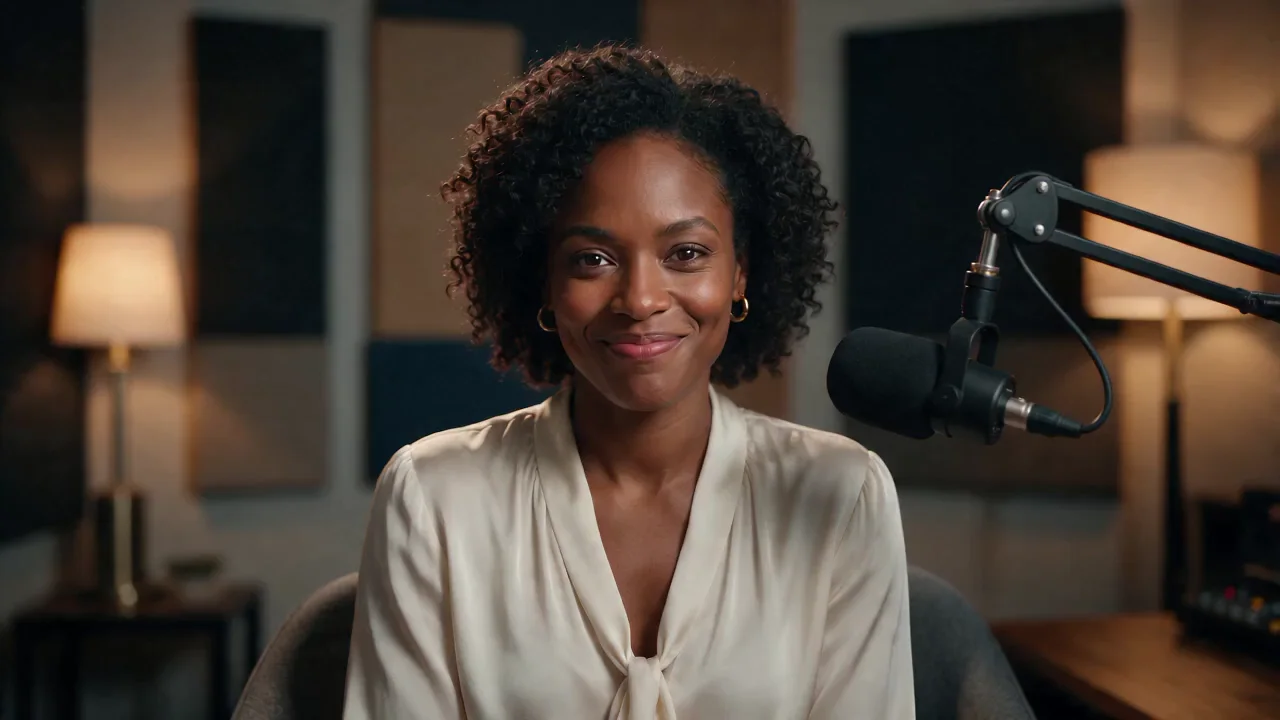
Trzy z czterech przykładów na tej stronie (wokalistka z supper clubu, scena przy barze i nocny talk show) używają tych samych portretów i audio co Kling Avatar 2.0, przycięte do około pięciu sekund, więc możesz porównać obie strony obok siebie.
Najważniejsze funkcje
Audio ustala długość
Przytnij audio do długości, jaką ma mieć klip, zanim je wyślesz. Audio krótsze niż 4 sekundy albo dłuższe niż 300 sekund jest odrzucane, zanim cokolwiek zostanie rozliczone. W naszych testach klip wychodził od 0,2 do 1 sekundy dłuższy niż audio, zawsze na pełnej liczbie sekund: 4,55 sekundy audio dało klip 5-sekundowy, a 5,2 sekundy – klip 6-sekundowy. Rozliczenie idzie za długością audio, nie za gotowym klipem.
Co zmierzyliśmy
Sprawdziliśmy cztery portrety, każdy z własnym audio o długości 4,55 do 5,2 sekundy i własnym jednolinijkowym promptem. Wszystkie cztery portrety były w proporcji 16:9. Każdy klip miał rozdzielczość 1280×720, 24 fps i ścieżkę audio, a przetwarzanie trwało około dwóch minut na klip – od 110 do 133 sekund od wysłania do gotowego pliku. Porównując klatki z portretem wejściowym, twarz pozostała rozpoznawalnie tą samą osobą we wszystkich czterech klipach.
Usta, mimika i gest
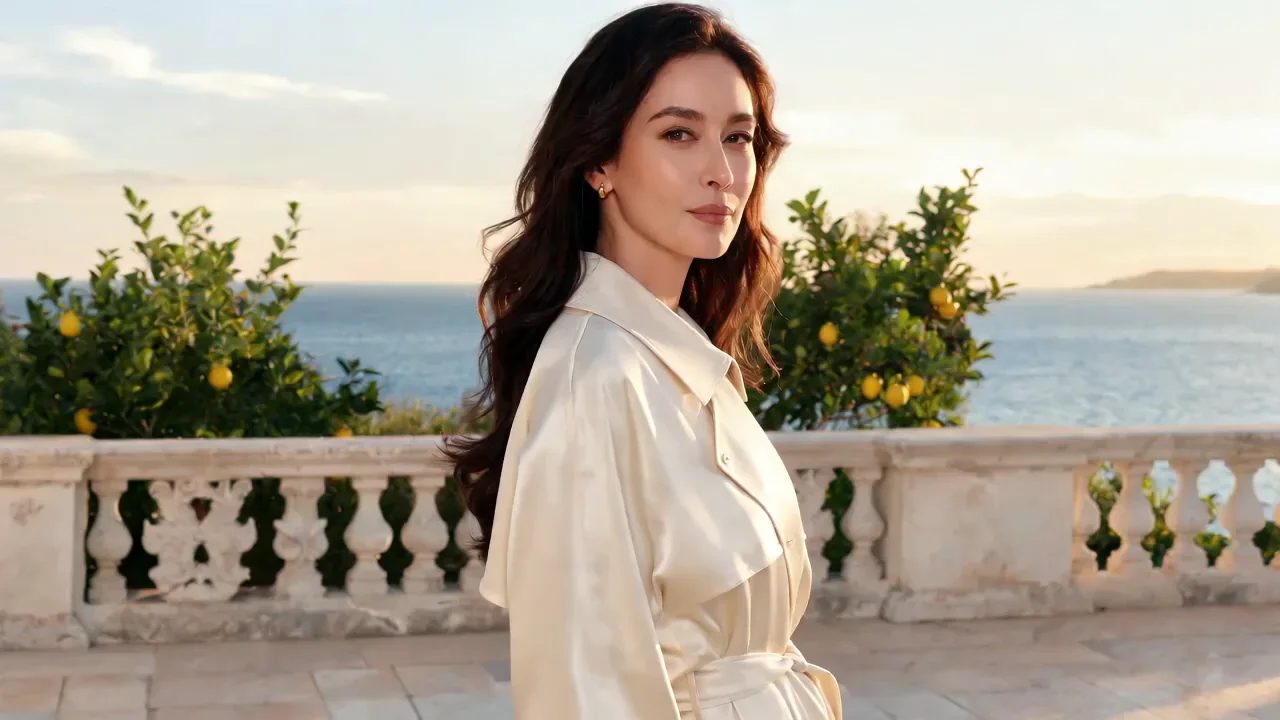
We wszystkich czterech klipach usta podążały za audio. Prompty prosiły o małe, konkretne akcenty i większość się pojawiła: uśmiech i lekki przechył głowy na ostatnim słowie, przy dłoni pozostającej na mikrofonie; półuśmiech i uniesiona brew, gdy butelki za barem pozostały stabilne; głowa odwracająca się ku morzu w ostatniej sekundzie; oraz krótki śmiech z szerokimi brwiami na ostatnim słowie. Jedna instrukcja nie zadziałała widocznie: pochylenie w stronę mikrofonu w klipie z programu nocnego.
Prompt jest opcjonalny
Jeśli zostawisz prompt puste, model podąża za samym audio. Wydawca wymienia jako języki promptu: chiński, angielski, japoński, koreański, hiszpański (meksykański) i indonezyjski. Nasze cztery prompty były po angielsku i kierowały mimiką, gestami i kierunkiem wzroku; nie testowaliśmy instrukcji dotyczących ruchu kamery.
Czego nie testowaliśmy
Wydawca podaje sceny z więcej niż jedną osobą; nie testowaliśmy ich. Nasze klipy miały około pięciu sekund audio, więc nie sprawdziliśmy długiego klipu w okolicach maksimum 300 sekund, pełnej piosenki ani portretów w proporcjach innych niż 16:9.
Moderacja treści
Portrety, które nie przechodzą weryfikacji treści w ByteDance, są odrzucane i nie są rozliczane. Jeden z naszych testowych portretów został tak odrzucony: bez klipu i bez opłaty. Przyjmij, że każde żądanie przechodzi tę weryfikację.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
prompt | Nie | Opcjonalny, do 300 znaków. Kieruj nastrojem, gestami, kierunkiem wzroku i ruchem kamery. do 300 znaków |
image_url | Tak | Portret do animacji. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC lub HEIF, poniżej 30 MB, od 300 do 6000 px po każdym boku, proporcja szerokości do wysokości między 0,4 a 2,5. |
audio_url | Tak | Mowa lub śpiew, WAV lub MP3, poniżej 15 MB, od 4 do 300 sekund. Klip ma długość tego audio; audio poza tym zakresem jest odrzucane, zanim cokolwiek zostanie rozliczone. |
Cennik
$0.108 / sekunda
Rozliczane za sekundę wysłanego audio, z minimum 4 sekund i maksimum 300 sekund; rezerwacja podąża za długością audio (albo maksimum 300 sekund, gdy nie da się jej odczytać), a różnica zostaje zwolniona po dostarczeniu. Żądania nieudane lub odrzucone nie są rozliczane.
Zastosowania
Daj nagranej kwestii twarz
Połącz nagraną lub wygenerowaną kwestię z portretem, by uzyskać klip tej osoby, która ją wygłasza – narracyjne wstępy, referencje lub dialogi postaci, której twarz już ustaliłeś.
Krótkie wstępy prowadzących i mocne otwarcia
Jasna, zabawna linia otwierająca oraz prompt, który nazywa nastrój i akcent na ostatnim słowie, dały nam wyraziste miny, żywe brwi i śmiech – jak w przykładzie nocnego talk show na tej stronie.
Zaśpiewana linia ze zdjęcia
Wydawca podaje śpiew obok mowy. Nasz test to jedna powolna linia śpiewana/mówiona przy zabytkowym mikrofonie, około pięciu sekund; pełnej piosenki jeszcze nie sprawdzaliśmy.
Zdjęcia z telefonu bez zmian
Portret może być w formacie JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC lub HEIF, poniżej 30 MB, więc zdjęcie prosto z telefonu można wysłać bez wcześniejszej konwersji.
Wskazówki
Powiąż mimikę z momentem w kwestii
„Leniwy uśmiech na ostatnim słowie” i „odwraca wzrok na końcu” zadziałały dokładnie tam, gdzie je umieściliśmy: uśmiech i przechył głowy pojawiły się na końcu klipu z wokalistką, a głowa odwróciła się ku morzu w ostatniej sekundzie klipu z tarasem. Wskazanie, w którym miejscu kwestii ma nastąpić akcent, daje modelowi coś, do czego może dopasować czas.
Trzymaj się kilku akcentów
Każdy z naszych promptów prosił o nastrój, jeden lub dwa akcenty mimiczne i czasem postawę. To wystarcza, by ukształtować klip 5-sekundowy. W naszych testach akcenty mimiczne podążały za promptem pewniej niż ruch ciała.
Nie licz wyłącznie na ruch ciała
„Pochylenie w stronę mikrofonu” w prompcie programu nocnego nie pojawiło się widocznie, podczas gdy śmiech i brwi obok – tak. To jedna obserwacja z jednego testu, ale jeśli ruch ciała jest dla Ciebie ważny, wygeneruj klip raz i sprawdź go, zanim na nim oprzesz dalszą pracę.
Wybierz portret z uwzględnieniem ograniczeń
Szerokość i wysokość muszą mieścić się w zakresie od 300 do 6000 pikseli, a proporcja szerokości do wysokości musi wynosić od 0,4 do 2,5. Testowaliśmy tylko portrety w proporcji 16:9.
Przytnij audio do występu
Klip trwa tyle co audio, a rozliczenie idzie za długością audio, więc utnij plik do mowy lub śpiewu, który faktycznie chcesz. WAV lub MP3, poniżej 15 MB.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.