Kurz gesagt: Lip Sync nimmt einen Clip, den Sie bereits haben, plus eine Sprachdatei von 3 bis 60 Sekunden und zeichnet nur den Mund neu, sodass die Person auf dem Bild Ihren Satz sagt. Das Video läuft so lange wie das Audio, nicht so lange wie der Clip. Die Pipeline: die Zeile schreiben, sie mit einem Sprachsynthese-Modell einsprechen, Clip und Audio als einen asynchronen Task senden und dann die wenigen Zeitpunkte prüfen, an denen die Synchronisation bricht. Die Stimme kostet den Bruchteil eines Cents; die Synchronisation kostet $0.012 pro Audiosekunde, eine 10-sekündige Zeile kostet also etwa $0.12.
Die Tonspur mit ffmpeg zu tauschen lässt den Mund etwas anderes sagen, wie in einem schlecht synchronisierten Film. Den Mund neu zu zeichnen ist Aufgabe des Lip-Sync-Modells.
In unseren Tests vom Oktober 2026 wurden erwachsene Clips von bekleideten Umarmungen bis hin zu deutlich erwachsenem Material zum normalen Preis akzeptiert, ohne dass etwas weichgezeichnet oder beschnitten wurde. Lip Sync zeichnet nur den Mund neu, deshalb funktioniert es am besten auf einem Clip, in dem die Person zur Kamera spricht; Küsse oder stark beschnittene Einstellungen geben ihm nichts zu synchronisieren.
Auf einen Blick
- Zwei Dateien hinein, kein Prompt.
video_urlist der Clip undaudio_urlist die neue Sprache; es gibt nichts sonst einzustellen. - Das Audio legt die Länge fest. Ein längerer Clip wird auf die Zeile gekürzt; ein kürzerer Clip loopt, bis die Zeile endet. Die beiden Dateilängen sind Ihre einzige Kontrolle.
- Das Audio muss 3 bis 60 Sekunden lang sein, MP3 oder WAV. Alles außerhalb dieses Bereichs scheitert binnen Sekunden und kostet nichts.
- Sie zahlen für das Audio, pro Sekunde, aufgerundet, mit einem Minimum von 3 Sekunden. Das zurückgegebene Video läuft etwa eine halbe Sekunde über das Audio hinaus, und dieser Schwanz ist kostenlos.
- Es dauert Minuten, nicht Sekunden. Reichen Sie es ein und lassen Sie es laufen; eine 10 Sekunden lange Zeile dauert etwa vier Minuten.
Vorher und nachher
Abgesehen von der Länge, die jetzt der Zeile folgt, ändert sich nur der Mund. Mimik, Kopfbewegung, Licht und Bildaufteilung stammen aus den Originalframes, deshalb passt Lip Sync zu einem Take, den Sie bereits mögen, und kann eine flache Darbietung nicht lebendiger machen.
Schritt 1: Mit einem Clip starten, der eine Zeile tragen kann
Das Modell malt den Mund neu und lässt alles andere unangetastet, deshalb entscheidet das Material überwiegend über das Ergebnis. Was funktioniert:
- Eine Person, Gesicht halbwegs groß im Bild, überwiegend zur Kamera gewandt. Eine mittlere Nahaufnahme ist die sichere Wahl; ein Gesicht im weitesten Hintergrund nicht.
- Eine einzige durchgehende Einstellung. Ein harter Schnitt in der Mitte des Clips bricht die Synchronisation am Schnittpunkt.
- Ein klarer Mund. Eine Hand, ein Glas, ein Mikrofon oder eine Strähne Haar vor den Lippen ist der Ort, an dem die Synchronisation verrutscht.
- Eine Darbietung, die zur Zeile passt. Weil der Rest des Gesichts unberührt bleibt, liest sich ein ruhiges Gesicht mit einer geschrienen Zeile weiterhin als ruhig.
Die Auflösung endet bei etwa 720p: ein 1920×1080-Clip kommt als 1280×720 zurück, und 1080p zu senden kostet nicht mehr.
Wenn Sie den Quellclip generieren
Bitten Sie das Videomodell um einen Take, in dem bereits gesprochen wird: die Kiefer- und Kopfbewegung, die Sprache echt wirken lässt, muss im Clip sein. Das ist der Bewegungs-Prompt, den wir bei Seedance 2.0 Mini Spicy verwendet haben, ausgehend von einem Standbild des Mannes an der Bar:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Setzen Sie die Clip-Länge mindestens auf die Länge Ihrer Zeile: Seedance 2.0 Mini Spicy nimmt 4 bis 15 Sekunden. Lassen Sie natives Audio aus, weil Lip Sync die Tonspur ersetzt.
Zwei Prüfungen, bevor Sie für die Synchronisation bezahlen:
- Die Kamera fixieren. Eine langsame Fahrt hinein lässt den Loop-Schnitt von der Nahaufnahme zurück auf das weitere erste Frame springen, also achten Sie auf einen solchen Schnitt.
- Vergleichen Sie das Gesicht mit Ihrem Standbild. Bild-zu-Video kann ein Gesicht über einige Sekunden driften lassen, und Lip Sync behält das Gesicht, das der Clip hat. Verwerfen Sie einen gedrifteten Clip vor der Synchronisation.
Warum nicht das Videomodell den Ton machen lassen?
Videomodelle wie Seedance 2.x, Wan 3.0 und Kling 3.0 können Ton mit dem Bild erzeugen. Das ist in Ordnung für Ambiente oder lockere Dialoge, aber der Ton ist in ein vollständiges Rendering eingebacken: ein einziges Wort zu ändern bedeutet, den ganzen Clip erneut zu bezahlen. Eine neue 10 Sekunden lange Zeile kostet etwa $0.12 zu synchronisieren, während ein 10 Sekunden langer 720p-Clip auf Seedance 2.0 Mini Spicy neu zu rendern $0.82 kostet.
Schritt 2: Die Zeile schreiben und einsprechen
Jedes MP3 oder WAV zwischen 3 und 60 Sekunden funktioniert, auch Ihre eigene Aufnahme. Wenn Sie keinen Sprecher haben, ist ein Sprachsynthese-Modell der schnellste Weg. Diese vier eignen sich für Lippen-Synchronisation:
| Modell | Wie Sie die Sprechweise steuern | Listenpreis | Eine 10 Sekunden lange Zeile kostet etwa |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Text plus einer von 30 Stimmen, mit optionalem style, accent, pace und einer Sprechnotiz. Hinweise in eckigen Klammern wie [laughs] werden meistens ausgeführt statt vorgelesen | $0.00032 pro Audiosekunde | $0.0032 |
| Gemini 2.5 Pro TTS | Dieselben Steuerungen wie Flash; älteres Modell, etwas höherer Preis | $0.00045 pro Audiosekunde | $0.0045 |
| MiniMax Speech 2.8 HD | Eine emotion-Einstellung. Hinweise stehen in Klammern, etwa (sighs) | $0.12 pro 1.000 Zeichen | $0.018 |
| Seed Speech 2.0 | 41 Stimmen, 10 Sprachen und eine separate Notiz, die die Sprechweise steuert, ohne vorgelesen zu werden | $0.072 pro 1.000 Zeichen | $0.011 |
Ganz gleich, welche Sie wählen, die Stimme kostet neben der Synchronisation praktisch nichts. Für Lippen-Synchronisation starten Sie mit Gemini 3.8 Flash TTS: es hat dieselben Steuerungen wie 2.5 Pro und ist günstiger. Wechseln Sie zu MiniMax für die emotion-Einstellung oder zu Seed Speech 2.0, wenn Sie dessen Sprechnotiz in normaler Sprache möchten.
Vier Regeln verhindern, dass das Audio das Bild untergräbt:
- Bleiben Sie innerhalb von 3 bis 60 Sekunden. Erzeugtes Englisch läuft mit 12 bis 19 Zeichen pro Sekunde, schreiben Sie also mindestens 60 Zeichen (etwa ein Dutzend Wörter); 700 bis 1.100 Zeichen füllen 60 Sekunden. Messen Sie die Datei, nicht das Skript: ein nur 10 Zeichen langes "Come here." kam bei 1.76 Sekunden heraus und wurde abgelehnt (sehr kurze Zeilen laufen pro Zeichen langsamer).
- Schneiden Sie die Stille an beiden Enden ab. Gemini-Stimmen fügen vor dem ersten Wort 0.1 bis 0.3 Sekunden und nach dem letzten bis zu 0.45 hinzu. Die Abrechnung rundet auf, also wird eine 4.04-Sekunden-Zeile als 5 Sekunden berechnet und dieselbe, auf unter 4 gekürzte Zeile als 4.
- Passen Sie die Sprechweise an das Gesicht an. Ein hauchendes Flüstern über einem lachenden Gesicht sieht falsch aus, egal wie gut die Synchronisation ist. Wählen Sie die Emotion oder den Stil, der zu Ihrem Material passt.
- Senden Sie trockene Sprache. Keine Musik darunter. Wenn Sie eine Vertonung wollen, geben Sie sie nach der Synchronisation dazu.
Die Stimme verändert den Mund genauso wie die Wörter. Derselbe Clip und dieselben Wörter, eingesprochen von MiniMax Speech 2.8 HD, ergeben andere Mundformen:
Alle vier lesen Skripte für Erwachsene; die Details pro Modell stehen auf den Seiten der Text-zu-Sprache-Modelle.
Schritt 3: Erst im Playground, dann über die API
Probieren Sie es zuerst im Playground aus, mit Ihrem eigenen Clip und einer Zeile:
- Öffnen Sie die Gemini 3.8 Flash TTS Seite, fügen Sie Ihre Zeile in Text ein, wählen Sie eine Voice und führen Sie aus. Laden Sie die WAV herunter, oder überspringen Sie diesen Schritt, wenn Sie eine eigene Aufnahme haben.
- Öffnen Sie die Lip Sync Seite, fügen Sie Ihren Clip unter Input video und das Audio unter Input audio ein, prüfen Sie die Preisschätzung und führen Sie aus. Rechnen Sie mit einer Wartezeit von Minuten: etwa vier für eine 10 Sekunden lange Zeile.
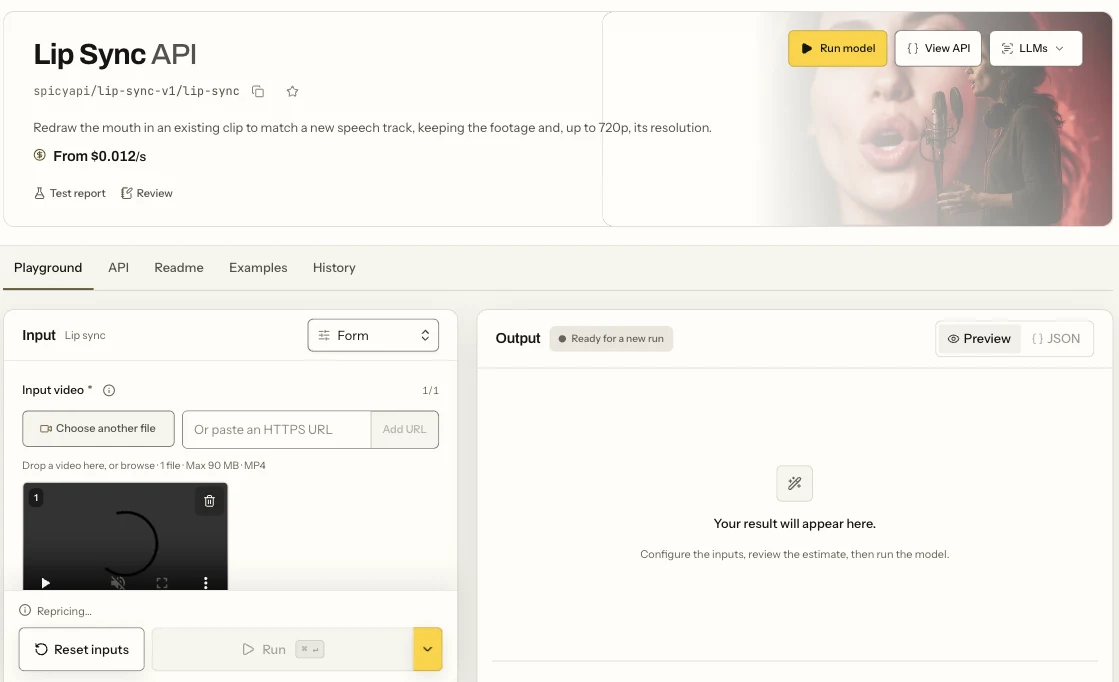
Die Lip Sync Seite im Playground: die Form-Ansicht, das Feld Input video, in dem Sie Ihren Clip hinzufügen, und der Run-Knopf.
Grenzen, auf die es ankommt: ein MP4-Clip und eine MP3- oder WAV-Datei, jede bis zu 90 MB.
Für Ihre eigene App senden Sie dieselben zwei Eingaben als einen Task (laden Sie Clip und Audio zuerst hoch, wie im Media-Leitfaden beschrieben):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Vollständige Anfrage, Abfrage und Callbacks: tasks-Leitfaden.
Lassen Sie einen Agenten das ausführen
Nutzen Sie den Playground für eine einzelne Zeile. Wenn Stimme, Synchronisation und Schnitt eine wiederholte Pipeline sind, übergeben Sie sie an einen Agenten; alle drei Tools zeigen den Preis und fragen vor einem kostenpflichtigen Aufruf nach.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, wobeiinput.jsondas obigeinput-Objekt enthält (CLI-Doku). - MCP: Fügen Sie den MCP-Server hinzu und fragen Sie dann: "Lip-sync ./take.mp4 with ./line.wav." Er ruft
spicyapi_upload_file,spicyapi_task_createundspicyapi_task_waitauf. - Skill:
npx skills add spicyapi-ai/spicy-skillinstalliert den Agent Skill, der den Assistenten das aktuelle Modell-Schema lesen lässt, bevor er die Eingabe baut.
Schritt 4: Das Ergebnis dort prüfen, wo es bricht
Ein lippen-synchronisiertes Video kann 90 % seiner Länge gut aussehen und an einem Moment auseinanderfallen. Springen Sie an diese Stellen:
- Die erste halbe Sekunde. Bleibt der Mund bis zum ersten Wort still?
- Laute wie P, B und M. Die Lippen sollten sich vollständig schließen. Weiche oder fehlende Schlüsse sind das schnellste Anzeichen für eine schwache Synchronisation.
- Jedes Vielfache der Clip-Länge, wenn die Zeile länger ist als der Clip. Ein 5-Sekunden-Clip unter einer 10-Sekunden-Zeile wiederholt sich bei 0:05 und 0:10. Dort zeigt sich die Naht.
- Die letzte halbe Sekunde. Die Datei läuft etwa 0.5 Sekunden über das Audio hinaus, und der Mund sollte dort ruhen.
- Jedes Frame, in dem eine Hand, ein Glas oder eine Kopfwendung über den Mund geht.
Wenn die Zeile länger ist als der Clip
Der Loop ist ein gerader Schnitt zurück auf das erste Frame des Clips, und keine Einstellung ändert das. Beheben Sie es mit den Dateien, die Sie senden:
- Machen Sie den Clip länger. Einen Quellclip zu generieren, der so lang ist wie die Zeile, ist der saubere Fix und meist der billigste, wenn Sie ohnehin generieren.
- Teilen Sie die Zeile. Zerlegen Sie das Skript an natürlichen Pausen in Stücke, die nicht länger als der Clip sind, synchronisieren Sie jedes Stück einzeln und fügen Sie die Ergebnisse in Ihrem Editor zusammen. Jedes Stück muss weiterhin mindestens 3 Sekunden lang sein.
- Wählen Sie einen ruhigen Take. Wenn Sie loopen müssen, verdeckt ein Clip mit wenig Kopfbewegung den Sprung besser als einer mit einer großen Geste.
Was es kostet
Lip Sync rechnet pro Audiosekunde ab, aufgerundet, mit einem Minimum von 3 Sekunden. Mit Gemini 3.8 Flash TTS für die Stimme:
| Zeilenlänge | Stimme (Gemini 3.8 Flash TTS) | Lip Sync | Gesamt |
|---|---|---|---|
| 5 Sekunden | $0.0016 | $0.06 | etwa $0.06 |
| 10 Sekunden | $0.0032 | $0.12 | etwa $0.12 |
| 30 Sekunden | $0.0096 | $0.36 | etwa $0.37 |
| 60 Sekunden | $0.0192 | $0.72 | etwa $0.74 |
Während der Task läuft, hält das Angebot das 60-Sekunden-Maximum ($0.72) vor; der nicht genutzte Teil wird freigegeben, sobald die Audiolänge feststeht. Eine Datei außerhalb von 3 bis 60 Sekunden scheitert binnen Sekunden mit invalid_request und kostet nichts, und jeder fehlgeschlagene Task gibt seine Vorreservierung vollständig frei. Der Quellclip ist, wenn Sie ihn generieren, meist der größte Kostenposten, weshalb erneutes Einsprechen billig ist: jede neue Zeile kostet etwa $0.12 pro 10 Sekunden statt eines neuen Renderings.
Lip Sync, Talking Avatar oder Kling Avatar 2.0?
Alle drei bringen Ihr Audio in den Mund einer Person. Was zwischen ihnen entscheidet, ist Ihr Ausgangsmaterial:
| Sie haben | Verwenden Sie | Preis | Ausgabe | Gut zu wissen |
|---|---|---|---|---|
| Einen Clip mit der Person bereits darin | Lip Sync | $0.012 pro Audiosekunde | Bis etwa 720p, ursprüngliche Darbietung bleibt | Audio 3 bis 60 Sekunden |
| Nur ein Porträtfoto | Talking Avatar | $0.018 pro Sekunde | Etwa 0.2 Megapixel (640×352 aus einem 16:9-Foto) | Fügt Blinzeln und kleine Kopfbewegungen hinzu; Audio 3 bis 60 Sekunden |
| Nur ein Porträt, und Sie brauchen 720p oder 1080p oder einen längeren Take | Kling Avatar 2.0 | $0.0512 pro Sekunde bei 720p, $0.1024 bei 1080p | 720p oder 1080p | Audio bis etwa 5 Minuten. Kling moderiert Eingaben: ein Porträt mit starker Freizügigkeit wurde abgelehnt, und eine abgelehnte Anfrage wird nicht berechnet |
Wenn Sie Material haben, starten Sie mit Lip Sync: es ist pro Sekunde am günstigsten und das einzige, das eine echte Darbietung erhält. Gehen Sie erst dann zu einem Porträt-Tool, wenn es kein Material gibt, mit dem Sie arbeiten können.
FAQ
Kann Lip Sync mein Video übersetzen?
Nein. Es synchronisiert das Audio, das Sie ihm geben. Um eine andere Sprachversion zu erstellen, übersetzen Sie die Zeile selbst, sprechen Sie sie mit einem Modell ein, das diese Sprache spricht (Gemini 3.8 Flash TTS deckt 130+ Sprachen ab), und synchronisieren Sie die neue Datei auf denselben Clip.
Was passiert mit dem Originalton?
Er wird ersetzt; die Ausgabe trägt nur das Audio, das Sie gesendet haben.
Warum ist mein Task sofort fehlgeschlagen?
Das Audio war kürzer als 3 Sekunden, länger als 60 Sekunden oder kein MP3 oder WAV; der Fehler nennt die Länge. Für eine kurze Zeile fügen Sie Wörter statt Stille hinzu, denn Stille zählt zu den Sekunden, für die Sie bezahlen.
Funktioniert Lip Sync bei NSFW-Material?
Ja für einen einzelnen Erwachsenen auf dem Bild: Der Clip wird zum normalen Preis verarbeitet und kommt zurück, ohne dass etwas weichgezeichnet oder verdeckt wäre. Das Modell zeichnet nur den Mund neu, deshalb braucht es ein Gesicht, das zur Kamera spricht.
Kann ich meine eigene Sprachaufnahme verwenden?
Ja. Jedes MP3 oder WAV zwischen 3 und 60 Sekunden, für das Sie die Rechte haben, funktioniert genau wie eine generierte Stimme.
Wie es weitergeht
Haben Sie bereits einen Take, der Ihnen gefällt? Lip Sync plus eine dieser Stimmen ist der billigste Weg, zu ändern, was ein Charakter sagt: etwa $0.12 pro 10 Sekunden, ohne neues Rendering. Probieren Sie es an Ihrem eigenen Clip auf der Lip Sync Modellseite, oder lesen Sie die Lip Sync Rezension.