Коротко: Lip Sync берёт ролик, который у вас уже есть, плюс речевой файл от 3 до 60 секунд и перерисовывает только рот, чтобы человек в кадре произнёс вашу реплику. Видео длится столько, сколько длится аудио, а не столько, сколько сам ролик. Порядок шагов: написать реплику, озвучить её моделью синтеза речи, отправить ролик и аудио одной асинхронной задачей, а затем проверить те несколько моментов, где синхронизация сбивается. Голос стоит доли цента; синхронизация стоит $0.012 за секунду аудио, поэтому реплика длиной 10 секунд обходится примерно в $0.12.
Если заменить звуковую дорожку через ffmpeg, рот начинает говорить другое — как в плохо озвученном фильме. Перерисовка рта — это работа модели синхронизации губ.
В наших тестах октября 2026 года взрослые ролики — от объятий в одежде до откровенно взрослого материала — принимались по обычной цене, без размытия и обрезки. Lip Sync перерисовывает только рот, поэтому лучше всего он работает на ролике, где человек смотрит в камеру и говорит; поцелуи или слишком плотные планы не дают ему ничего для синхронизации.
Коротко о главном
- Два файла на входе, без промпта.
video_url— это ролик, аaudio_url— новая речь; больше настраивать нечего. - Длину задаёт аудио. Более длинный ролик обрезается по длине реплики; более короткий зацикливается, пока реплика не закончится. Длины двух файлов — единственный элемент управления.
- Аудио должно длиться от 3 до 60 секунд, в формате MP3 или WAV. Всё вне этого диапазона отклоняется за секунды и ничего не стоит.
- Вы платите за аудио, по секундам с округлением вверх, минимум 3 секунды. Возвращённое видео длится примерно на полсекунды дольше аудио, и этот хвост бесплатный.
- Это занимает минуты, а не секунды. Отправьте и дайте выполниться; реплика длиной 10 секунд идёт около четырёх минут.
До и после
Кроме длины, которая теперь следует за репликой, меняется только рот. Мимика, движение головы, свет и кадрирование берутся из исходных кадров, поэтому Lip Sync подходит для дубля, который вам уже нравится, и не способен оживить вялую игру.
Шаг 1: начните с ролика, который выдержит реплику
Модель перерисовывает рот и не трогает всё остальное, поэтому результат в основном определяет материал. Что работает:
- Один человек, лицо достаточно крупное в кадре, повёрнутое в основном к камере. Средний план — безопасный выбор; лицо на далёком фоне — нет.
- Один непрерывный план. Жёсткая склейка в середине ролика разрывает синхронизацию в месте склейки.
- Рот ничем не закрыт. Рука, стакан, микрофон или прядь волос поверх губ — это место, где синхронизация сползает.
- Игра, подходящая к реплике. Поскольку остальная часть лица не меняется, спокойное лицо с кричащей репликой всё равно читается как спокойное.
Разрешение ограничено примерно 720p: ролик 1920×1080 возвращается в 1280×720, а отправка 1080p стоит не дороже.
Если вы генерируете исходный ролик
Попросите видеомодель дать дубль, в котором человек уже говорит: движение челюсти и головы, из-за которого речь выглядит настоящей, должно быть в ролике. Вот промпт движения, который мы использовали в Seedance 2.0 Mini Spicy, начиная со стоп-кадра мужчины у стойки:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.
Задайте длину ролика не меньше длины вашей реплики: Seedance 2.0 Mini Spicy принимает от 4 до 15 секунд. Оставьте штатный звук выключенным, потому что Lip Sync заменяет звуковую дорожку.
Две проверки до оплаты синхронизации:
- Зафиксируйте камеру. Медленный наезд приводит к тому, что склейка петли прыгает с крупного плана обратно на более широкий первый кадр, поэтому присмотритесь, нет ли такого.
- Сравните лицо со стоп-кадром. Превращение изображения в видео может за несколько секунд увести лицо (дрифт), а Lip Sync сохраняет то лицо, которое есть в ролике. Отбросьте ролик с уехавшим лицом до синхронизации.
Почему не поручить звук видеомодели
Видеомодели вроде Seedance 2.x, Wan 3.0 и Kling 3.0 умеют создавать звук вместе с изображением. Для фоновой атмосферы или приблизительных диалогов это нормально, но звук впечатывается в полный рендер: изменить одно слово — значит снова оплатить весь ролик. Новая реплика длиной 10 секунд стоит около $0.12 за синхронизацию, тогда как повторный рендер 10-секундного ролика 720p в Seedance 2.0 Mini Spicy стоит $0.82.
Шаг 2: напишите реплику и озвучьте её
Подойдёт любой MP3 или WAV длиной от 3 до 60 секунд, включая вашу собственную запись. Если у вас нет диктора, модель синтеза речи — самый быстрый путь. Эти четыре подходят для синхронизации губ:
| Модель | Как вы управляете подачей | Публичная цена | Реплика длиной 10 секунд стоит примерно |
|---|---|---|---|
| Gemini 3.8 Flash TTS | Текст плюс один из 30 голосов, с необязательными style, accent, pace и заметкой о подаче. Указания в квадратных скобках, например [laughs], обычно исполняются, а не читаются | $0.00032 за секунду аудио | $0.0032 |
| Gemini 2.5 Pro TTS | Те же настройки, что и у Flash; более старая модель, цена чуть выше | $0.00045 за секунду аудио | $0.0045 |
| MiniMax Speech 2.8 HD | Настройка emotion. Указания пишутся в круглых скобках, например (sighs) | $0.12 за 1 000 символов | $0.018 |
| Seed Speech 2.0 | 41 голос, 10 языков и отдельная заметка, которая направляет подачу, но не читается вслух | $0.072 за 1 000 символов | $0.011 |
Что бы вы ни выбрали, голос рядом с синхронизацией стоит почти ноль. Для синхронизации губ начните с Gemini 3.8 Flash TTS: у неё те же настройки, что у 2.5 Pro, и она дешевле. Переходите на MiniMax ради настройки emotion или на Seed Speech 2.0, если нужна её заметка о подаче простым языком.
Четыре правила не дают аудио испортить картинку:
- Держитесь от 3 до 60 секунд. Сгенерированный английский идёт со скоростью 12–19 символов в секунду, поэтому напишите хотя бы 60 символов (примерно дюжину слов); от 700 до 1 100 символов заполняют 60 секунд. Измеряйте файл, а не сценарий: реплика из 10 символов «Come here.» получилась длиной 1.76 секунды и была отклонена (очень короткие реплики читаются медленнее на символ).
- Обрезайте тишину с обоих концов. Голоса Gemini добавляют от 0.1 до 0.3 секунды перед первым словом и до 0.45 после последнего. Тарификация округляет вверх, поэтому реплика длиной 4.04 секунды оплачивается как 5 секунд, а та же реплика, обрезанная ниже 4 секунд, — как 4.
- Подбирайте подачу под лицо. Шёпот с дыханием поверх смеющегося лица выглядит неверно, как бы хороша ни была синхронизация. Выберите эмоцию или стиль, подходящий вашему материалу.
- Присылайте «сухую» речь. Без музыки под ней. Если нужна подложка, добавьте её после синхронизации.
Голос меняет рот так же, как слова. Тот же ролик и те же слова голосом MiniMax Speech 2.8 HD дают другую форму рта:
Все четыре читают сценарии для взрослых; подробности по каждой модели — на страницах моделей синтеза речи.
Шаг 3: сначала Playground, потом API
Сначала попробуйте в Playground со своим роликом и одной репликой:
- Откройте страницу Gemini 3.8 Flash TTS, вставьте реплику в Text, выберите Voice и запустите. Скачайте WAV или пропустите этот шаг, если своя запись уже есть.
- Откройте страницу Lip Sync, добавьте ролик в Input video, а аудио — в Input audio, проверьте оценку цены и запустите. Ожидайте несколько минут: около четырёх для реплики длиной 10 секунд.
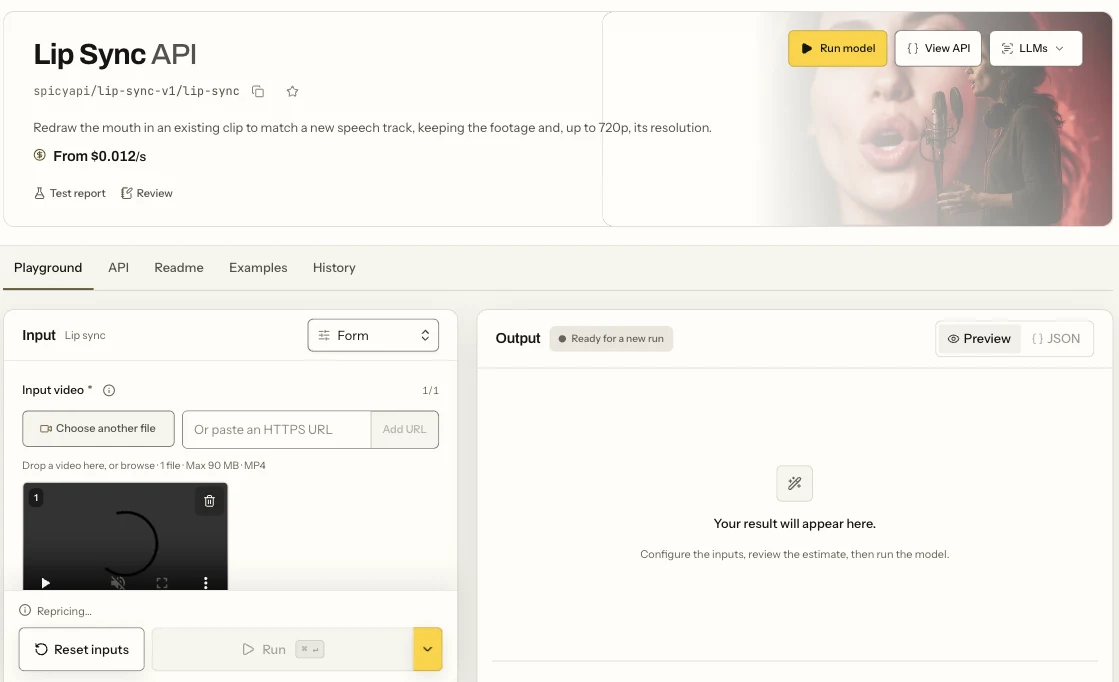
Страница Lip Sync в Playground: представление Form, поле Input video, куда вы добавляете ролик, и кнопка Run.
Ограничения, которые важны: ролик MP4 и файл MP3 или WAV, каждый до 90 МБ.
Для собственного приложения отправьте те же два входа одной задачей (сначала загрузите ролик и аудио, как описано в руководстве по медиа):
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
  }'
Полный запрос, опрос и обратные вызовы: руководство по задачам.
Пусть это выполнит Agent
Для разовой реплики хватит Playground. Когда голос, синхронизация и обрезка становятся повторяющимся процессом, передайте это Agent; все три инструмента показывают цену и спрашивают перед платным вызовом.
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait, где вinput.jsonлежит объектinputвыше (документация по CLI). - MCP: добавьте MCP-сервер и затем спросите: «Lip-sync ./take.mp4 with ./line.wav.» Он вызывает
spicyapi_upload_file,spicyapi_task_createиspicyapi_task_wait. - Skill:
npx skills add spicyapi-ai/spicy-skillустанавливает Agent Skill, благодаря которому ассистент читает актуальную схему модели, прежде чем собрать входные данные.
Шаг 4: проверяйте результат там, где он сбоит
Видео с синхронизацией губ может выглядеть хорошо на протяжении 90% длины и развалиться в один момент. Перейдите к этим точкам:
- Первая полсекунда. Рот остаётся неподвижным до первого слова?
- Звуки P, B и M. Губы должны смыкаться полностью. Неполное или отсутствующее смыкание — самый быстрый признак слабой синхронизации.
- Каждое кратное длины ролика, если реплика длиннее ролика. 5-секундный ролик под 10-секундной репликой повторяется на 0:05 и 0:10. Именно там виден шов.
- Последняя полсекунда. Файл длится примерно на 0.5 секунды дольше аудио, и рот должен там покоиться.
- Любой кадр, где рука, стакан или поворот головы проходят через рот.
Когда реплика длиннее ролика
Петля — это прямая склейка обратно к первому кадру ролика, и никакая настройка это не меняет. Исправьте это теми файлами, которые отправляете:
- Сделайте ролик длиннее. Сгенерировать исходный ролик той же длины, что и реплика, — чистое решение и обычно самое дешёвое, если вы всё равно генерируете.
- Разбейте реплику. Разрежьте сценарий на естественных паузах на части не длиннее ролика, синхронизируйте каждую отдельно и соедините результаты в своём редакторе. Каждая часть всё равно должна быть не короче 3 секунд.
- Выберите устойчивый дубль. Если петля неизбежна, ролик с небольшим движением головы лучше скрывает скачок, чем ролик с крупным жестом.
Сколько это стоит
Lip Sync тарифицируется по секундам аудио с округлением вверх, минимум 3 секунды. С голосом Gemini 3.8 Flash TTS:
| Длина реплики | Голос (Gemini 3.8 Flash TTS) | Lip Sync | Итого |
|---|---|---|---|
| 5 секунд | $0.0016 | $0.06 | около $0.06 |
| 10 секунд | $0.0032 | $0.12 | около $0.12 |
| 30 секунд | $0.0096 | $0.36 | около $0.37 |
| 60 секунд | $0.0192 | $0.72 | около $0.74 |
Пока задача выполняется, расчёт удерживает максимум в 60 секунд ($0.72); неиспользованная часть освобождается, как только определена длина аудио. Файл вне диапазона от 3 до 60 секунд отклоняется за секунды с invalid_request и ничего не стоит, а любая неудачная задача полностью освобождает своё удержание. Исходный ролик, если вы его генерируете, обычно самая крупная статья расходов — поэтому переозвучка дёшева: каждая новая реплика стоит около $0.12 за 10 секунд вместо нового рендера.
Lip Sync, Talking Avatar или Kling Avatar 2.0?
Все три заставляют человека произносить ваше аудио. Что решит выбор — это то, с чего вы начинаете:
| У вас есть | Используйте | Цена | Результат | Что стоит знать |
|---|---|---|---|---|
| Ролик, где человек уже есть | Lip Sync | $0.012 за секунду аудио | До примерно 720p, исходная игра сохранена | Аудио от 3 до 60 секунд |
| Только портретная фотография | Talking Avatar | $0.018 за секунду | Примерно 0.2 мегапикселя (640×352 из фото 16:9) | Добавляет моргание и небольшие движения головы; аудио от 3 до 60 секунд |
| Только портрет, и нужен 720p или 1080p или более длинный дубль | Kling Avatar 2.0 | $0.0512 за секунду в 720p, $0.1024 в 1080p | 720p или 1080p | Аудио примерно до 5 минут. Kling модерирует входные данные: портрет с высокой откровенностью отклонили, а отклонённый запрос не тарифицируется |
Если у вас есть материал, начинайте с Lip Sync: он дешевле всего в секунду и единственный сохраняет настоящую игру. Переходите к инструменту для портретов только тогда, когда работать не над чем.
FAQ
Может ли Lip Sync перевести моё видео?
Нет. Он синхронизирует аудио, которое вы ему даёте. Чтобы сделать версию на другом языке, переведите реплику сами, озвучьте её моделью, которая говорит на этом языке (Gemini 3.8 Flash TTS охватывает 130+ языков), и синхронизируйте новый файл с тем же роликом.
Что происходит с исходным звуком?
Он заменяется; результат несёт только аудио, которое вы отправили.
Почему моя задача сразу завершилась ошибкой?
Аудио длилось меньше 3 секунд, больше 60 секунд или не было файлом MP3 или WAV; ошибка называет длину. Для короткой реплики добавляйте слова, а не тишину, потому что тишина тоже входит в оплачиваемые секунды.
Работает ли Lip Sync с материалами NSFW?
Да, если в кадре один взрослый: ролик проходит по обычной цене и возвращается без размытия и без закрытия. Модель перерисовывает только рот, поэтому ей нужно лицо, которое говорит в камеру.
Можно ли использовать свою запись голоса?
Да. Любой MP3 или WAV длиной от 3 до 60 секунд, на который у вас есть права, работает точно так же, как сгенерированный голос.
Что дальше
Уже есть дубль, который вам нравится? Lip Sync плюс один из этих голосов — самый дешёвый способ изменить то, что говорит персонаж: около $0.12 за 10 секунд, без нового рендера. Попробуйте на своём ролике на странице модели Lip Sync или прочитайте обзор Lip Sync.