結論から: Lip Syncは手持ちのクリップと3〜60秒の音声ファイルを受け取り、口元だけを描き直して、画面の中の人物があなたのセリフを言います。動画の長さはクリップではなく音声に追従します。手順は、セリフを書いて、テキスト読み上げモデルで音声化し、クリップと音声をひとつの非同期タスクとして送り、同期が崩れる数か所のタイムコードを確認するという流れです。音声の費用は1セントに満たない端数で、同期は音声1秒あたり$0.012、したがって10秒のセリフは約$0.12です。
ffmpegで音声トラックを差し替えると、口は別のことを言ってしまいます。下手な吹き替えの映画と同じです。口元を描き直すのはリップシンクモデルの仕事です。
2026年10月のテストでは、衣服を着たままの抱擁から明らかな成人向け素材まで、通常価格で受け付けられ、ぼかしも切り落としもありませんでした。Lip Syncが描き直すのは口元だけなので、カメラに向かって話す人物のクリップで最もよく働きます。キスやきわめて狭い画角では、同期の手がかりがありません。
30秒でわかる要点
- 入力は2つのファイル、プロンプトなし。
video_urlがクリップ、audio_urlが新しい音声で、ほかに調整する項目はありません。 - 長さは音声が決める。 長いクリップはセリフの長さで切り詰められ、短いクリップはセリフが終わるまでループします。2つのファイルの長さだけが操作手段です。
- 音声は3〜60秒のMP3またはWAV。 この範囲から外れると数秒で失敗し、費用はかかりません。
- 料金は音声の長さに対して秒単位、切り上げ計算、最低3秒。 返される動画は音声より約半秒長く、その末尾分は無料です。
- 所要は数秒ではなく数分。 送信して実行を待つと、10秒のセリフで約4分かかります。
前と後
長さがセリフに従うようになったこと以外で、変わるのは口元だけです。表情、頭の動き、光、フレーミングは元フレーム由来なので、Lip Syncはすでに気に入っているテイクに向いています。平板な演技を活き活きさせることはできません。
ステップ1: セリフを運べるクリップから始める
モデルは口元を描き直し、それ以外には手を触れないため、結果の大部分は素材で決まります。うまくいく条件:
- 1人だけ、顔がフレーム内で十分大きく、おおむねカメラ向き。 ミディアムクローズアップが安全な選択で、遠い背景の顔は使えません。
- 連続した1つのカットのシーン。 途中でハードカットがあると、カットの位置で同期が崩れます。
- 口元がはっきりと見えること。 手、グラス、マイク、唇にかかる前髪は同期が滑る場所です。
- セリフに合う演技。 顔の他の部分は触らないため、落ち着いた顔に叫んだセリフを当てても、落ち着いているように見えます。
解像度は最大720pです。1920×1080のクリップは1280×720で返り、1080pを送っても安くはなりません。
ソースクリップを生成する場合
動画モデルに、すでに話しているテイクを依頼してください。顎と頭の動き、すなわち発話が本当らしく見えるようにするものがクリップに入っていないと同期しません。Seedance 2.0 Mini Spicyで使用したモーションプロンプトです。バーにいる男性のスチル画像から始めます:
Medium close-up. He faces the camera and talks to someone just off-screen,
lips moving naturally as if mid-sentence, a small tilt of the head.
Steady camera, one continuous shot, hands stay on the counter.クリップの長さはセリフの長さ以上に設定してください。Seedance 2.0 Mini Spicyは4〜15秒を受け付けます。Lip Syncが音声トラックを置き換えるので、ネイティブ音声はオフのままにしてください。
同期の代金を支払う前に2つの確認:
- カメラを固定する。 ゆっくりしたドリーインでは、ループのカットがクローズアップから広い方の最初のフレームへ飛んでしまうため、それがないか見ます。
- 顔をスチル画像と比較する。 画像から動画への変換は数秒かけて顔をドリフトさせることがあり、Lip Syncはクリップが持っている顔をそのまま保ちます。同期の前に、ドリフトしたクリップは捨ててください。
なぜ動画モデルに音を作らせないのか
Seedance 2.x、Wan 3.0、Kling 3.0などの動画モデルは、画像と同時に音を生成できます。環境音や大雑把なダイアログには問題ありませんが、音は完全なレンダリングに焼き込みます。単語を一つ変えるたびに、クリップ全体をもう一度支払うことになります。新しい10秒のセリフを同期するコストは約$0.12であるのに対し、Seedance 2.0 Mini Spicyで10秒の720pクリップを再レンダリングすると$0.82かかります。
ステップ2: セリフを書いて音声化する
3〜60秒のMP3またはWAVなら何でも、自分の録音でも構いません。声優がいなければ、テキスト読み上げモデルがもっとも早い道です。以下の4モデルはリップシンクに適しています:
| モデル | 読み方の指定方法 | 標準価格 | 10秒のセリフの費用目安 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | テキストに加えて30種類の音声から1つ、任意で style、accent、pace と読み方の注記。[laughs] のような角括弧の合図はたいてい読み上げられず演技されます | 音声1秒あたり$0.00032 | $0.0032 |
| Gemini 2.5 Pro TTS | Flashと同じコントロール。古いモデルのため、価格はやや高くなります | 音声1秒あたり$0.00045 | $0.0045 |
| MiniMax Speech 2.8 HD | emotion の設定。合図は (sighs) のように丸括弧で書きます | 1,000文字あたり$0.12 | $0.018 |
| Seed Speech 2.0 | 41音声、10言語、および読み上げずに読み方を導く独立した注記 | 1,000文字あたり$0.072 | $0.011 |
どれを選んでも、同期と比べてみれば、音声の費用はほぼゼロです。リップシンクなら、まずGemini 3.8 Flash TTSから始めてください。2.5 Proと同じコントロールを持つ一方で、安価です。emotion 設定が必要ならMiniMaxへ、平易な言語での読み方の注記が欲しいならSeed Speech 2.0へ切り替えます。
音声が画像を損なうことを防ぐ四つのルール:
- 3〜60秒の範囲内に収める。 生成された英語は1秒あたり12〜19文字で進むため、少なくとも60文字(およそ12語)を書いてください。700〜1,100文字で60秒が埋まります。測るのは台本ではなくファイルです。10文字の "Come here." は1.76秒で出力されて却下されました(ごく短いセリフは文字あたりの速度が遅くなります)。
- 両端の無音を切り落とす。 Geminiの声は最初の語の前に0.1〜0.3秒、最後の語のあとに最大0.45秒を追加します。課金は切り上げなので、4.04秒のセリフは5秒として請求され、同じセリフを4秒以下に切り詰めると4秒として請求されます。
- 読み方を顔に合わせる。 笑っている顔に息混じりの囁きを重ねると、同期がどれほど良くても不自然に見えます。手元の素材に合う感情(emotion)またはスタイルを選んでください。
- BGMなしの音声を送る。 下に音楽は入れません。音楽が欲しければ、同期のあとで足してください。
音声は、単語と同じだけ口を変えます。同じクリップと同じ言葉をMiniMax Speech 2.8 HDで音声化すると、口の形が変わります:
4モデルいずれも成人向け台本を読み上げます。モデルごとの詳細はテキスト読み上げモデルの一覧の各ページで確認できます。
ステップ3: まずPlaygroundで、次にAPIで
まず手持ちのクリップと1セリフでPlaygroundを試してください。
- Gemini 3.8 Flash TTSのページを開き、Textにセリフを貼り付け、Voiceを選んで実行します。WAVをダウンロードするか、自分の録音があるならこの手順を飛ばしてください。
- Lip Syncのページを開き、Input videoにクリップ、Input audioに音声を追加して、価格の概算を確認してから実行します。待ち時間は数分です。10秒のセリフで約4分。
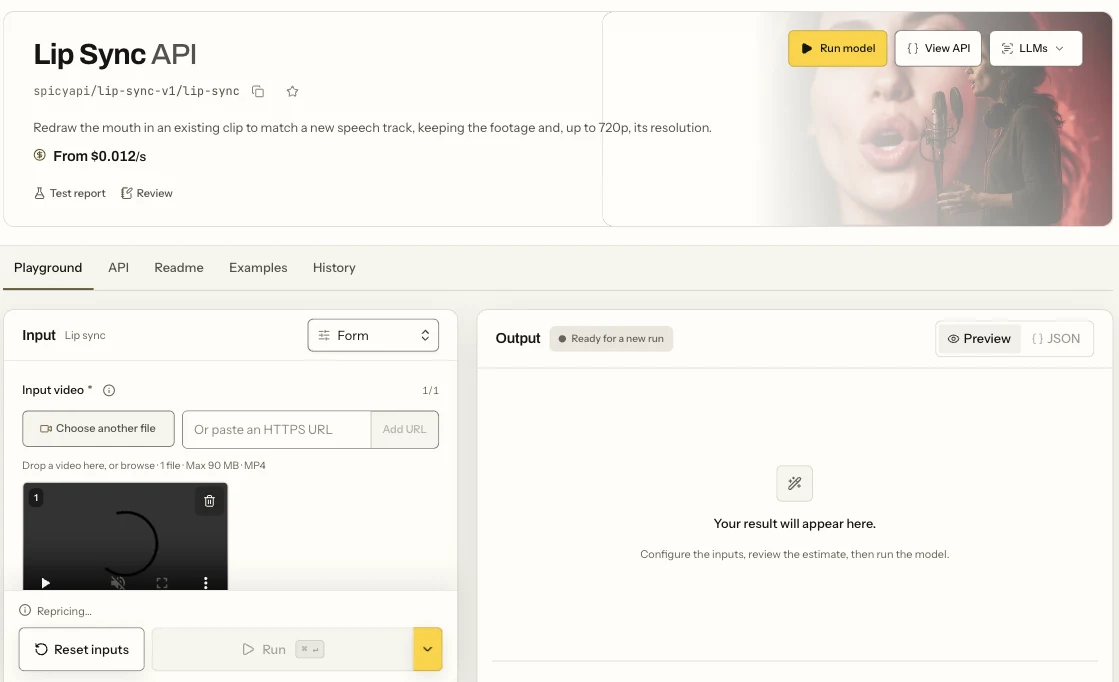
PlaygroundのLip Syncページ。Formビュー、クリップを追加するInput videoフィールド、Runボタン。
効いてくる制限: MP4のクリップとMP3またはWAVのファイルが、それぞれ90 MBまで。
自分のアプリでは、同じ2つの入力を1つのタスクとして送ります。クリップと音声は先にアップロードします(mediaガイド参照)。
curl -s "https://api.spicyapi.ai/api/v1/jobs/createTask" \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spicyapi/lip-sync-v1/lip-sync",
    "input": {
      "video_url": "spicy://f/<your-uploaded-clip>",
      "audio_url": "spicy://f/<your-uploaded-audio>"
    }
}'リクエスト全体、ポーリング、コールバックはtasks ガイドを参照してください。
Agentに実行させる
1回限りのセリフならPlaygroundで十分です。音声・同期・切り取りが繰り返しになるワークフローなら、Agentに任せてください。3つのツールはいずれも価格を表示し、有料呼び出しの前に確認を求めます。
- CLI:
spicyapi tasks create --model spicyapi/lip-sync-v1/lip-sync --input-file input.json --wait。input.jsonには上記のinputオブジェクトを入れます(CLI ドキュメント)。 - MCP: MCPサーバー を追加して、"Lip-sync ./take.mp4 with ./line.wav." と依頼します。
spicyapi_upload_file、spicyapi_task_create、spicyapi_task_waitを呼び出します。 - Skill:
npx skills add spicyapi-ai/spicy-skillで Agent Skill を入れると、入力を作る前に現在のモデルスキーマを読ませることができます。
ステップ4: 崩れる場所で結果を確認する
リップシンク済みの動画は長さの90%は問題なく、ある瞬間に崩れることがあります。次の場所に移動してください。
- 最初の半秒。 最初の語まで口が静止していますか。
- P、B、Mの音。 唇は完全に閉じるべきです。閉じ方が弱い、あるいは欠けている場合は、同期が弱いことを示す最も早い兆候です。
- セリフがクリップより長い場合、クリップ長のすべての整数倍。 5秒のクリップに10秒のセリフを重ねると、0:05 と 0:10 で繰り返されます。継ぎ目が見えるのはそこです。
- 最後の0.5秒。 ファイルは音声より約0.5秒長く、口はその場で静止しているはずです。
- 手やグラス、あるいは頭の動きが口を横切るすべてのフレーム。
セリフがクリップより長い場合
ループはクリップの最初のフレームへのまっすぐなカットで、設定で変えることはできません。送るファイルで対策します。
- クリップを長くする。 セリフと同じ長さのソースクリップを生成することがもっとも素直な対策で、生成するなら最安です。
- セリフを分割する。 台本を自然な切れ目で、クリップ以下の長さの部分に分け、それぞれを別々に同期し、編集ソフトで結果を継ぎ合わせます。各パートは3秒以上に収める必要があります。
- 安定したテイクを選ぶ。 ループさせてよいなら、頭の動きが少ないクリップのほうが、大きなジェスチャーがあるものよりジャンプを隠せます。
費用
Lip Syncは音声の秒数に対して、切り上げ、最低3秒で課金します。音声にGemini 3.8 Flash TTSを使う場合:
| セリフの長さ | 音声(Gemini 3.8 Flash TTS) | Lip Sync | 合計 |
|---|---|---|---|
| 5秒 | $0.0016 | $0.06 | 約$0.06 |
| 10秒 | $0.0032 | $0.12 | 約$0.12 |
| 30秒 | $0.0096 | $0.36 | 約$0.37 |
| 60秒 | $0.0192 | $0.72 | 約$0.74 |
タスクの実行中、見積りでは60秒の上限($0.72)が確保されます。使用しない部分は音声の長さが確定した時点で解放されます。3〜60秒の範囲外のファイルは数秒で invalid_request となって失敗し、費用はかかりません。失敗したタスクは確保額をすべて解放します。生成する場合のソースクリップが通常最大の費用になるため、吹き替えが安価なのはそのためです。新しいセリフ1本は、新しいレンダリングの代わりに10秒あたり約$0.12です。
Lip Sync、Talking Avatar、Kling Avatar 2.0のどれか
3つともあなたの音声を誰かの口に入れます。どれを選ぶかは、出発点によって決まります。
| 手持ち | 使用 | 価格 | 出力 | 注意点 |
|---|---|---|---|---|
| 人物が映っているクリップ | Lip Sync | 音声1秒あたり$0.012 | 最大約720p、元の演技を保持 | 音声3〜60秒 |
| ポートレート写真のみ | Talking Avatar | 1秒あたり$0.018 | 約0.2メガピクセル(16:9の写真から640×352) | まばたきとわずかな頭の動きを追加。音声3〜60秒 |
| ポートレートのみで、720pか1080p、または長いテイクが必要 | Kling Avatar 2.0 | 720pで1秒あたり$0.0512、1080pで$0.1024 | 720pまたは1080p | 音声は最大約5分。Klingは入力を審査します。強めの内容のポートレートは拒否され、拒否されたリクエストは課金されません |
素材があれば、まずLip Syncから始めてください。1秒あたりの費用が最も安く、本物の演技を保持できるのもこれです。扱える素材がない場合にのみ、ポートレート用のツールへ移ってください。
FAQ
Lip Syncは動画を翻訳できますか。
いいえ。渡した音声を同期するだけです。別の言語版を作るには、セリフを自分で翻訳し、その言語を話すモデル(Gemini 3.8 Flash TTSは130以上の言語に対応)で音声化し、新しいファイルを同じクリップに同期してください。
元の音声はどうなりますか。
置き換えられます。出力に含まれるのは送った音声だけです。
タスクがすぐに失敗したのはなぜですか。
音声が3秒未満か、60秒を超えるか、MP3またはWAVでなかったためです。エラーは長さを示します。短いセリフでは、無音ではなく言葉を足してください。無音も支払う秒数に含まれます。
Lip SyncはNSFW映像で動作しますか。
画面に大人1人だけなら動作します。クリップは通常価格で処理され、ぼかしもカバーもなく返ります。モデルは口元だけを描き直すため、カメラに向かって話す顔が必要です。
自分の音声録音を使えますか。
はい。3〜60秒のMP3またはWAVで、権利があるものなら、生成された音声とまったく同じように動作します。
次のステップ
気に入ったテイクはすでにお持ちですか。Lip Syncとこれらの音声の組み合わせは、キャラクターのセリフを変える最も安い方法です。10秒あたり約$0.12で、新しいレンダリングは不要です。Lip Syncのモデルページで手持ちのクリップを試すか、Lip Syncのレビューを読んでください。