はじめに
トーキングアバターは、1枚の人物写真を話す動画に変えます。image_url に顔を、audio_url に音声を送ると、口・あご・頭の小さな動きが付き、その人が録音の内容をそのまま話しているように見えます。動画の長さは音声と同じ3〜60秒で、録音が乗った状態で返ってくるので、そのまま投稿することも編集に組み込むこともできます。
主な機能とハイライト
タイミングは音声が決める
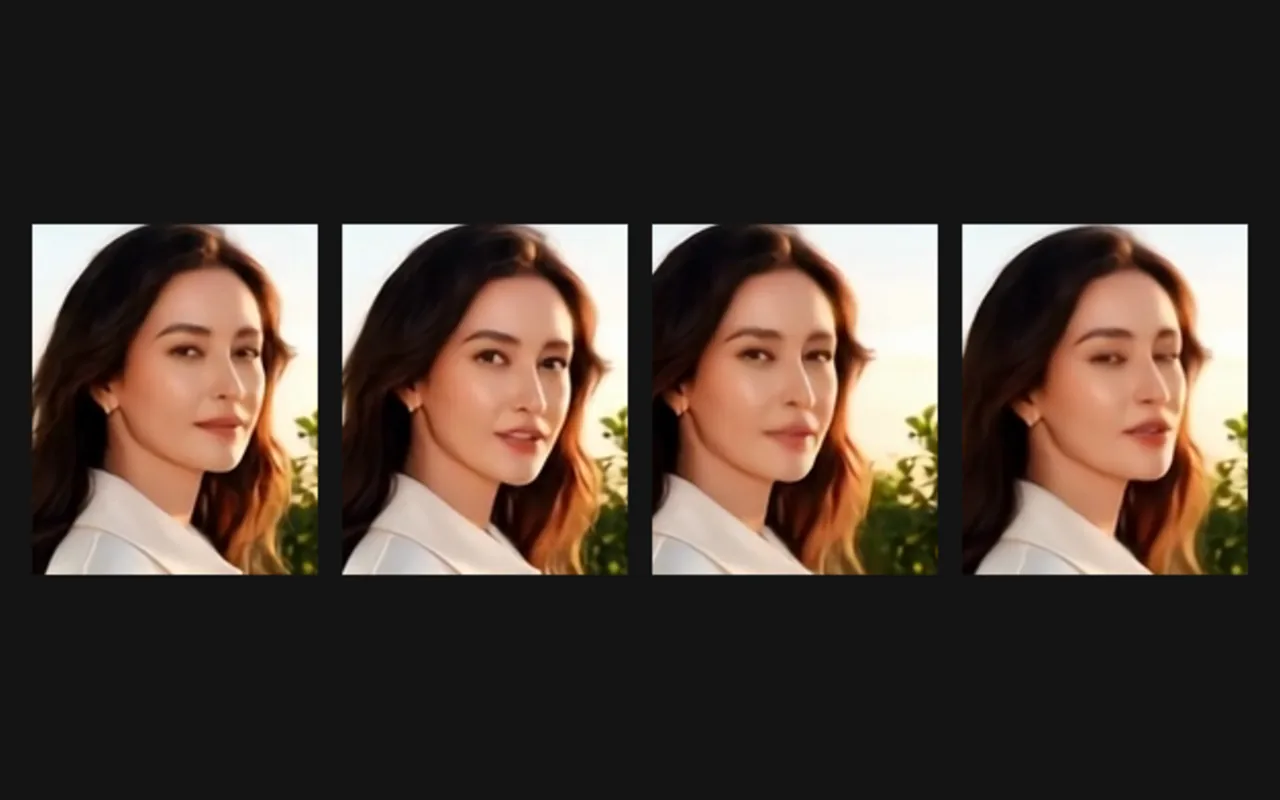
口の形はすべて音そのものから作られるため、間や早口、強調が話し手の置いた位置にぴったり合います。台本の欄もタイミングの調整もありません。届けたい言い方で録音すれば、顔が1秒ずつそれに付いてきます。
写真がそのままシーンになる
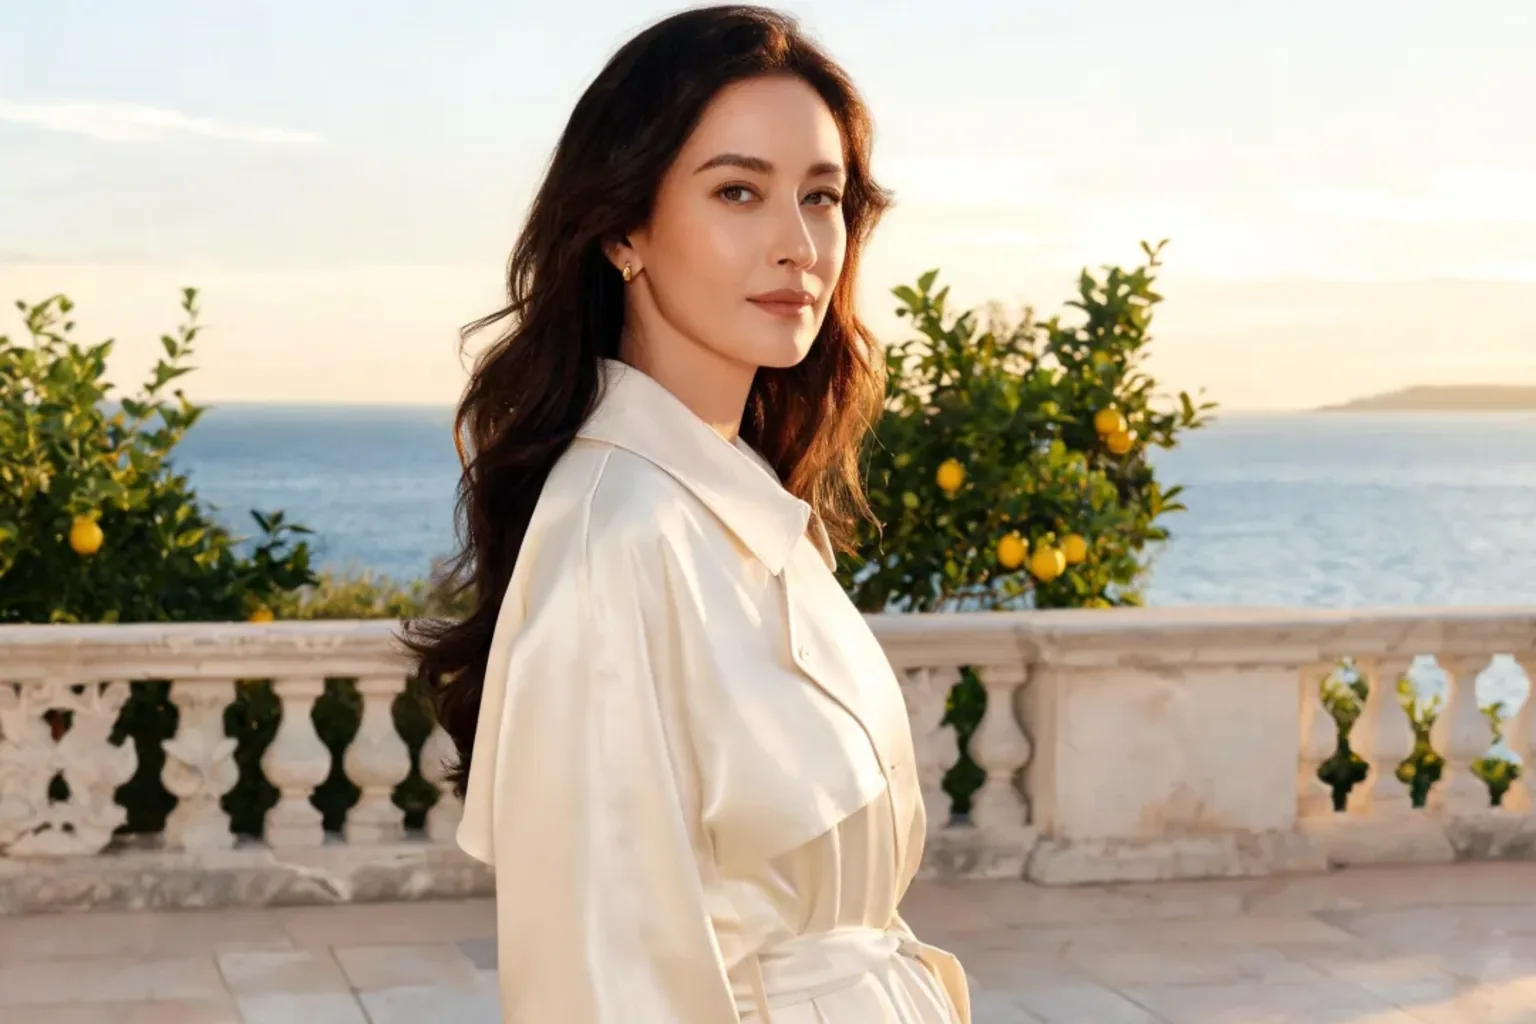
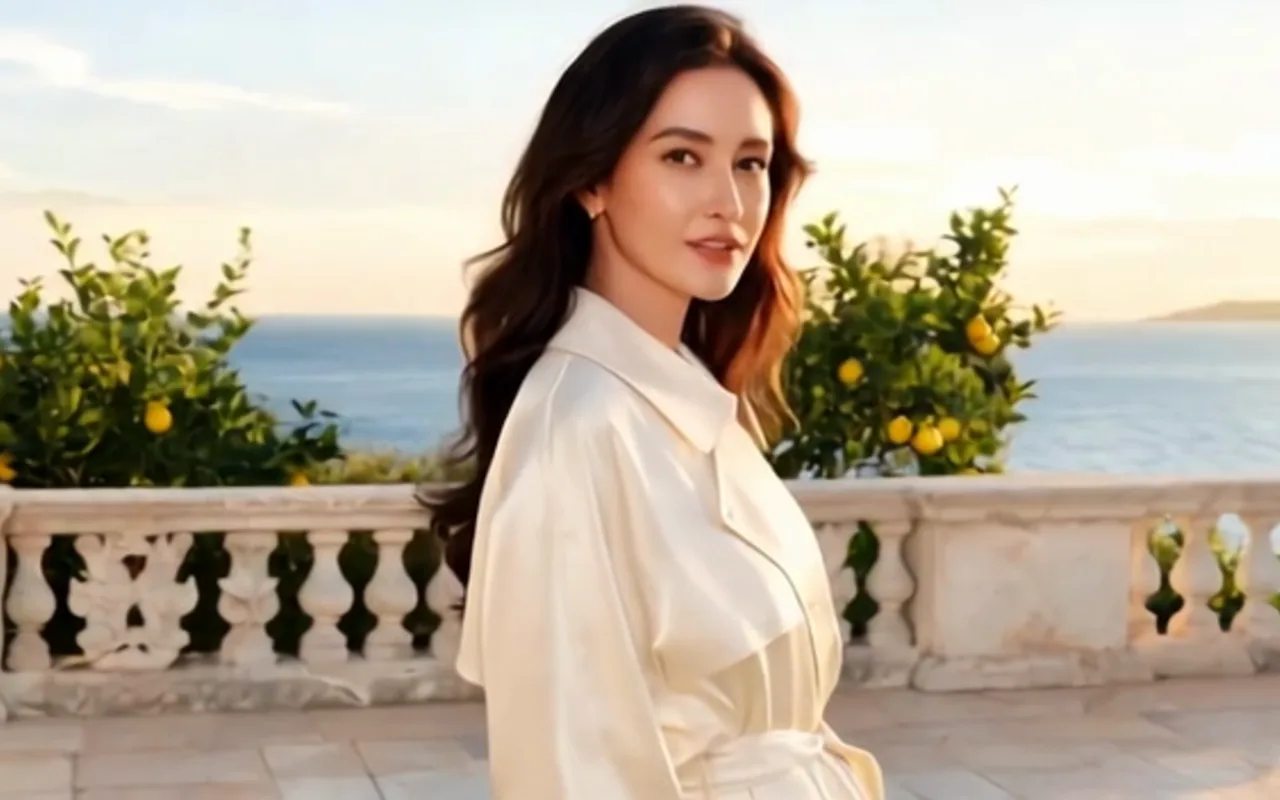
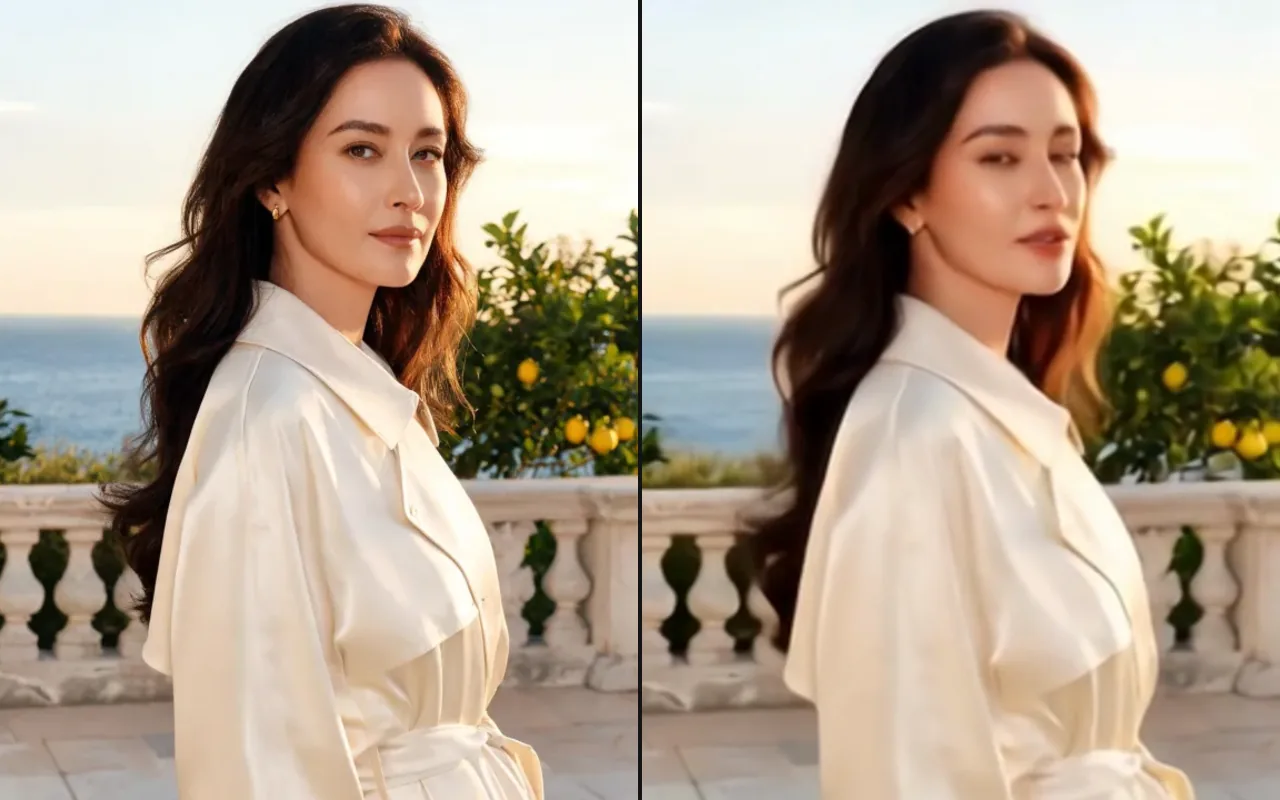
服装、髪、背景、構図は画像からそのまま使われます。顔のまわりを作り直さないので、プレゼンターやキャラクター、スポークスパーソンが動画ごとに別人に見えることはありません。出力は約0.2メガピクセル、25fps とコンパクト(16:9 の写真で 640×352、3:4 の縦長ポートレートで 400×544)なので、全画面再生よりもフィードやチャット画面での利用を想定してください。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
image_url | はい | 話させる顔です。写っているのは1人、ほぼカメラ目線で均一に光が当たったもの。 1 文字以上 |
audio_url | はい | リップシンクさせる話し声。3〜60秒の MP3 か WAV です。 1 文字以上 |
prompt | いいえ | 任意。「落ち着いた」「明るい」「真剣な」など、表情や雰囲気を数語で。 1000 文字以内 |
mask_url | いいえ | 任意。写真に複数人が写っているときだけ必要です。 1 文字以上 |
seed | いいえ | 同じ写真と音声で2回の結果を比べたいときに固定します。省略すると毎回新しい結果になります。 |
料金
$0.018 / 出力秒
返ってきた動画の秒数(音声と同じ長さ)ごとに、切り上げ・最低3秒で課金されます。
ユースケース
静止画からプレゼンター動画
講座のイントロ、製品紹介、週次のお知らせで、承認済みの人物写真1枚を使い回し、毎回新しい録音だけを用意します。言語を切り替えるときも同じ画像に別の音声ファイルを送るだけなので、1人のプレゼンターで複数の市場をカバーできます。
声で答えるキャラクター
コンパニオンやロールプレイのアプリで、キャラクターが返答をカメラの前で話せます。キャラクター画像は1枚のまま、返答を音声にしてペアで送るだけです。短い返答でも生成に1〜2分かかるので、テキストの返答を表示している間にジョブを始めておきましょう。
プロンプトガイドと実践のヒント
口元が映える写真を選ぶ
動くのは口なので、そこに画素を割きましょう。バストアップの構図、ほぼカメラを向いた顔、均一な光、唇を隠すもののない写真が理想です。サングラス、横向きに近い角度、引きの画に写った小さな顔は、仕上がりが不自然になる典型的な原因です。
大きさより、きれいな音声
BGM や響きの強い部屋、重なった声のない話し声を書き出してください。冒頭と末尾の無音は削りましょう。無音も課金される長さに含まれます。1ファイル3〜60秒に収め、長い台本は自然な区切りで分けます。
雰囲気はプロンプト、話者はマスク
prompt は「落ち着いた」「明るい」「真剣な」など表情を少し寄せるだけで、誰がどこで話すかは変えられません。写真に複数人が写っている場合は、黒地に話者を白く塗った画像を、写真と同じサイズで mask_url に渡します。同じ写真で2つの録音を比べたいときは seed を固定します。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。