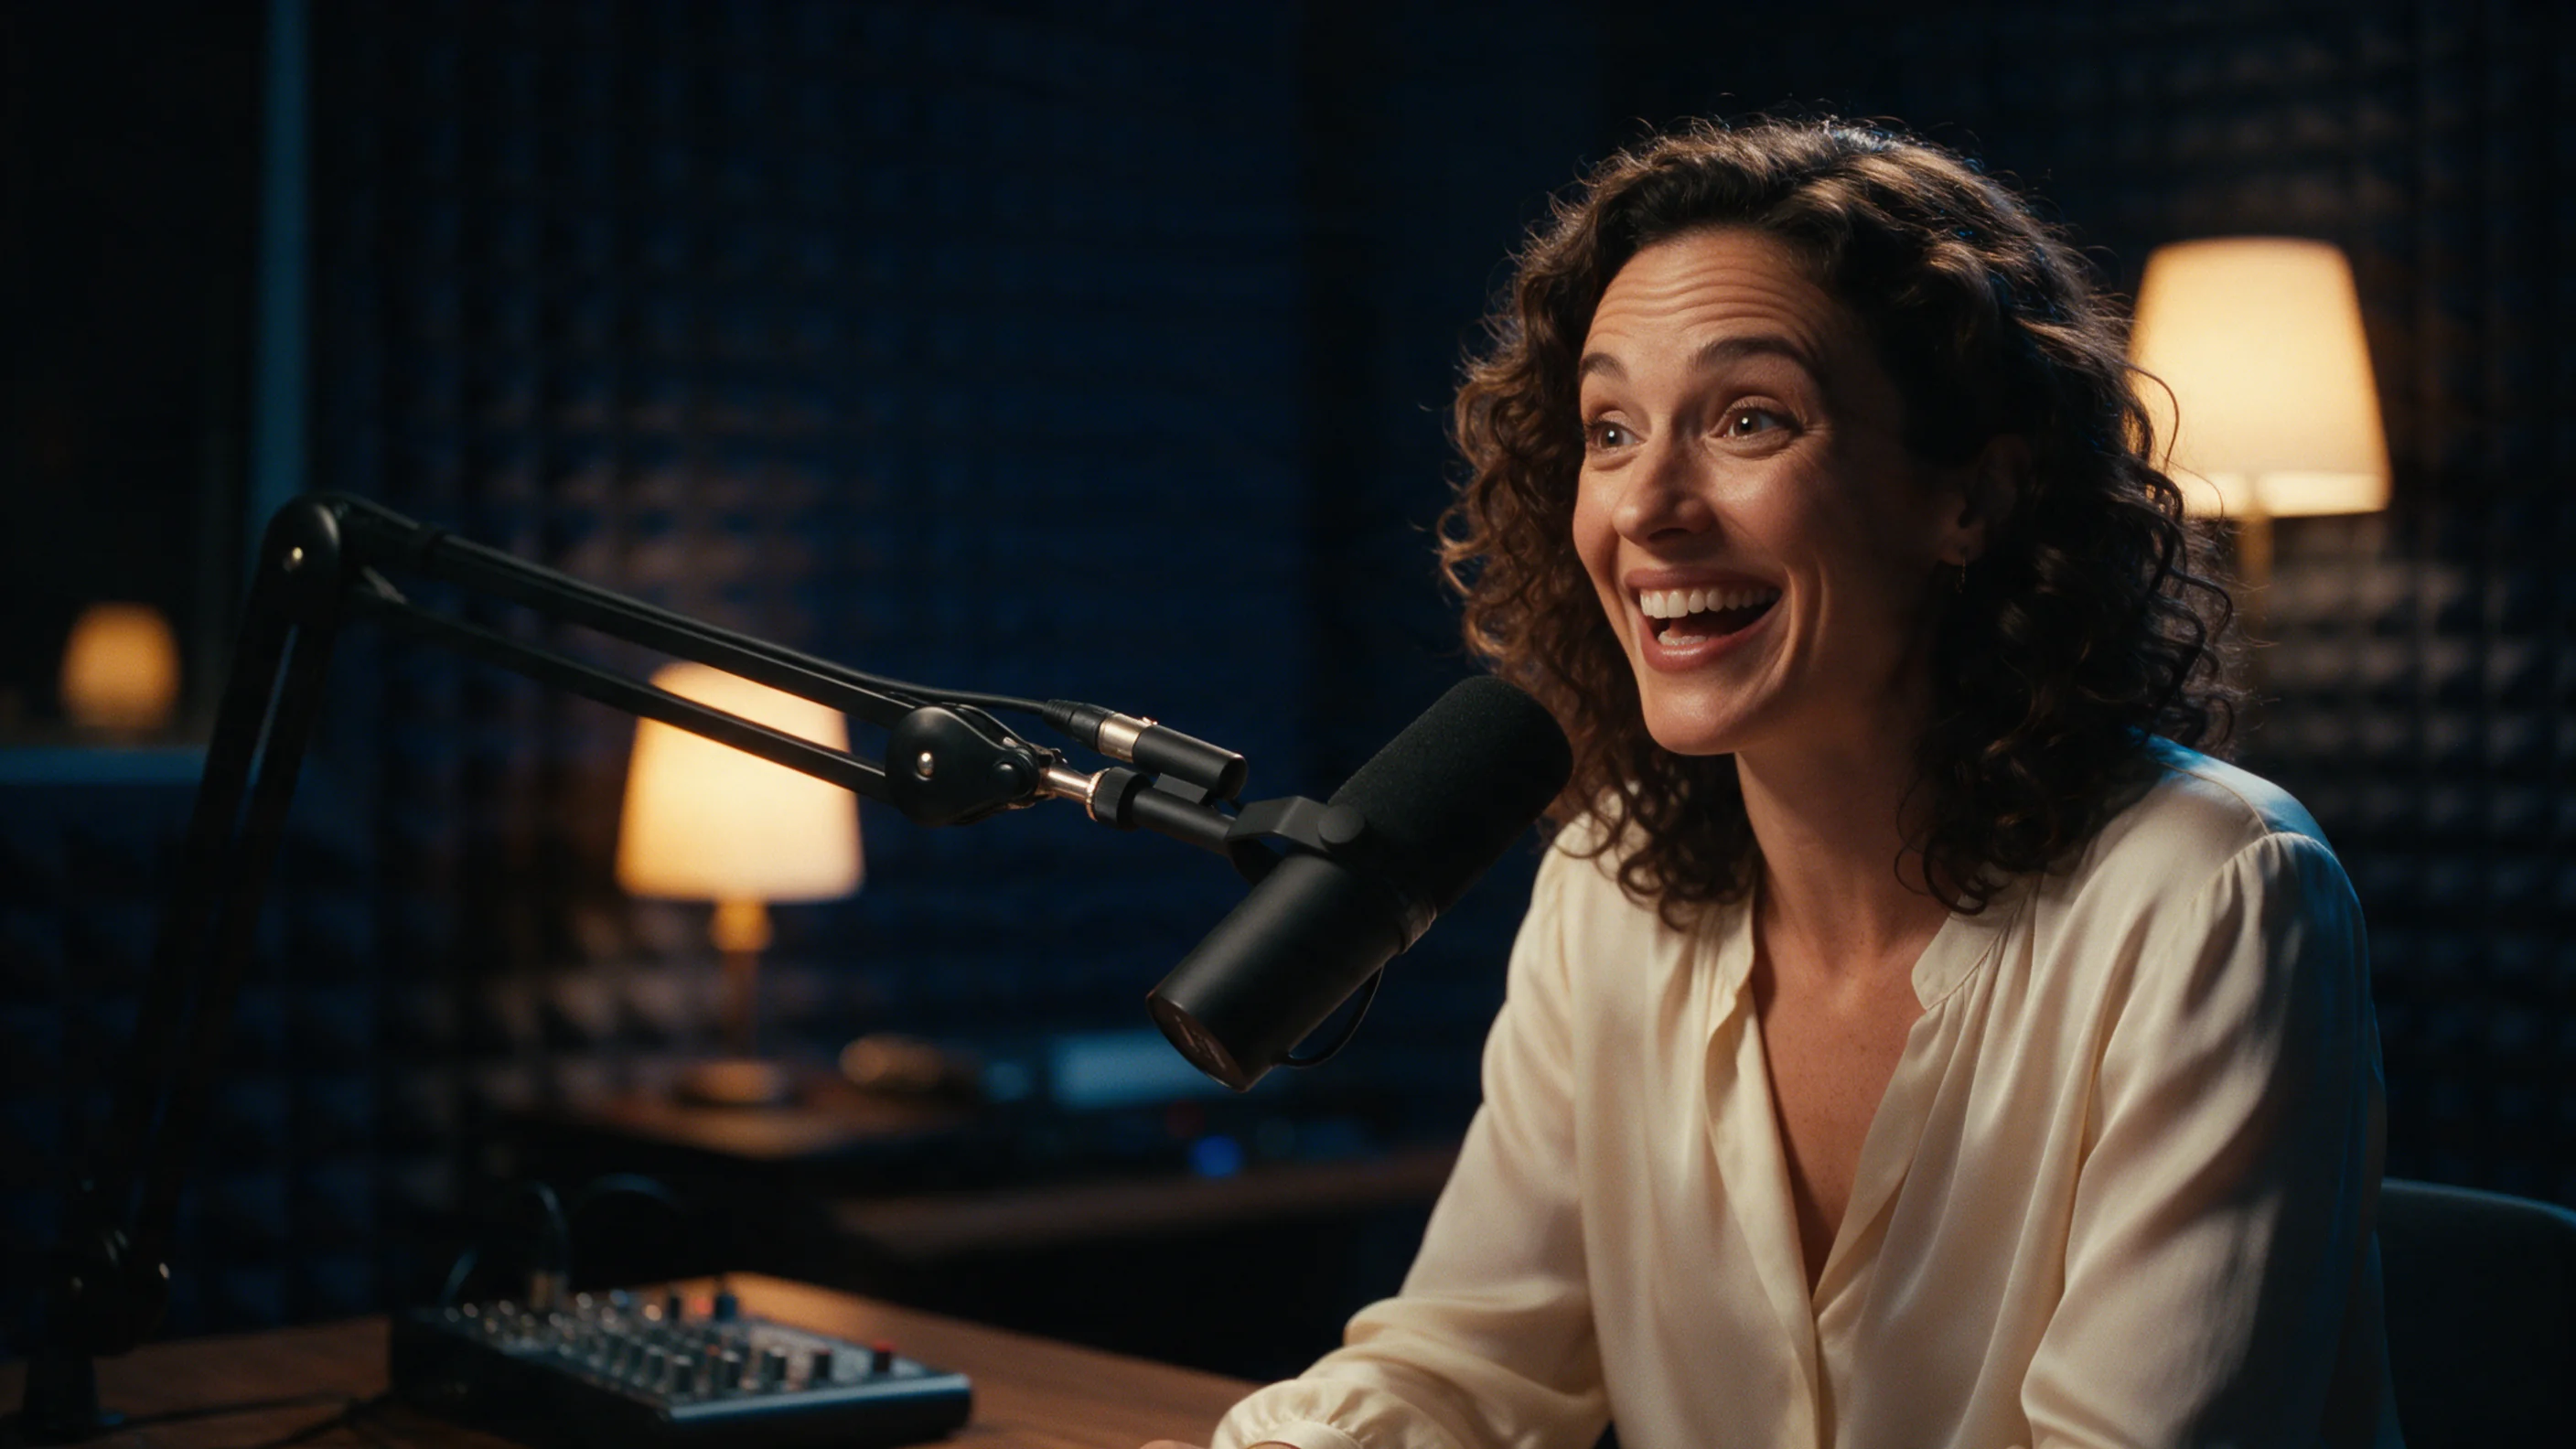
はじめに
OmniHuman 2.0 のトーキングアバターは、ByteDance の音声駆動型アバターモデルです。ポートレート(image_url)と、話し声または歌の音声ファイル(audio_url)を送ると、その人物が音声を演じる 720p の動画が返ります。顔、唇、頭、上半身が音声に合わせて動き、胴体が固まったままになることはありません。クリップは音声と同じ長さで、4〜300 秒です。duration、解像度、アスペクト比のフィールドはありません。最大 300 文字の任意の prompt で、雰囲気、ジェスチャー、視線の向き、そして出品元によればカメラの動きを指示できます。
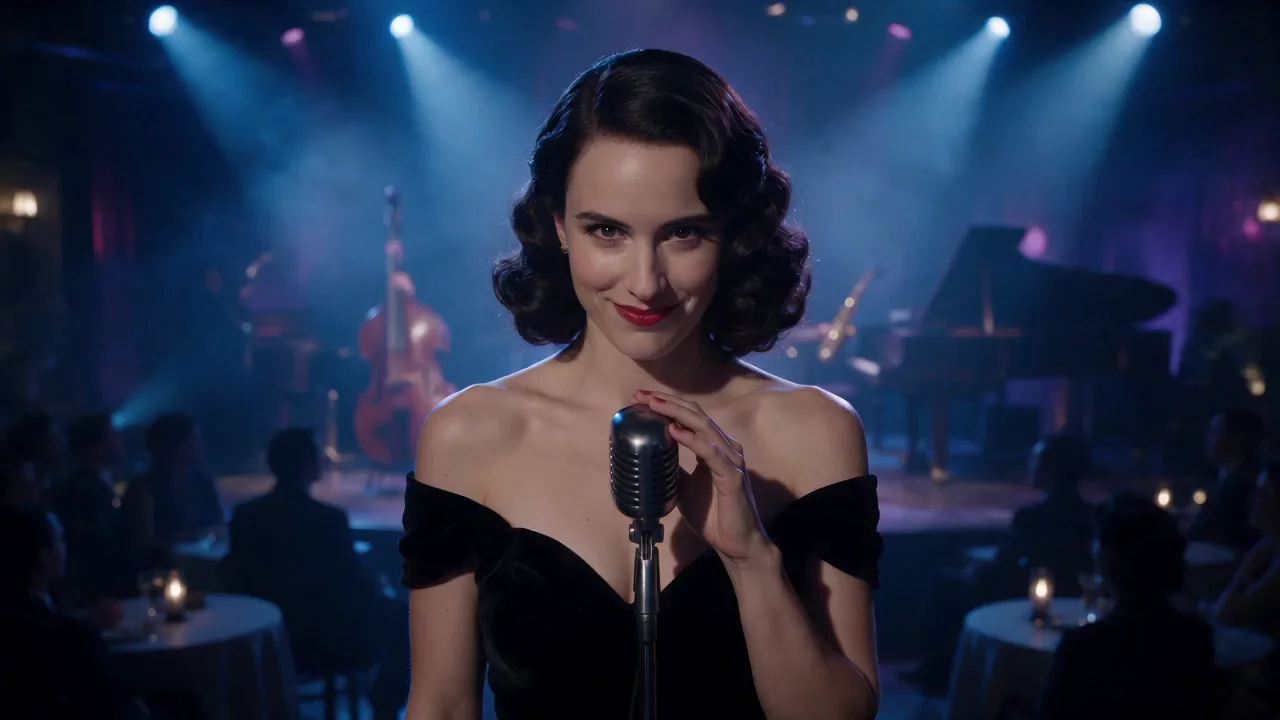
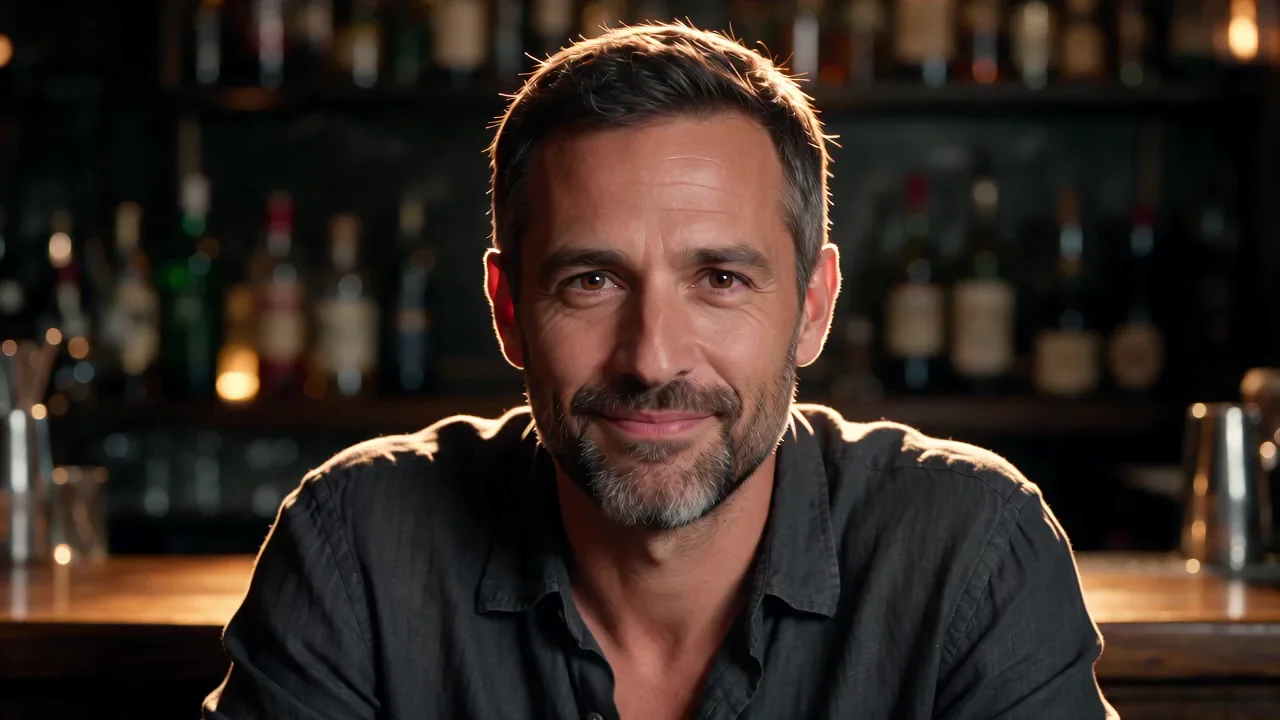
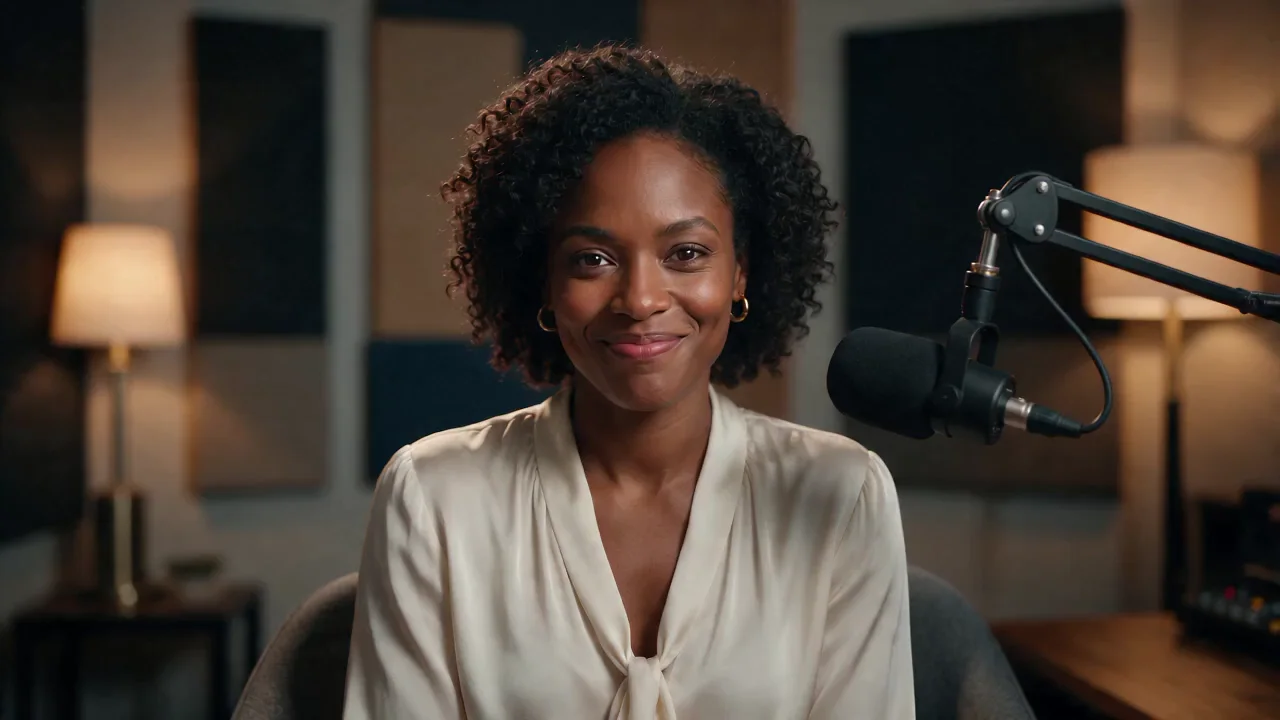
このページの 4 つの例のうち 3 つ(サパークラブの歌手、バーのカウンター、レイトショー)は、Kling Avatar 2.0 と同じポートレートと音声を、約 5 秒に切り詰めて使っています。2 つのページを並べて比べられます。
主な機能とハイライト
音声が長さを決める
送る前に、クリップを走らせたい長さに音声をトリミングしてください。4 秒未満または 300 秒を超える音声は、課金される前に拒否されます。当社の試行では、クリップは音声より 0.2〜1 秒長く、整数秒で返ってきました。4.55 秒の音声は 5 秒のクリップに、5.2 秒の音声は 6 秒のクリップになりました。課金は完成したクリップではなく、音声の長さに従います。
当社が測定したこと
4 つのポートレートを使い、それぞれに 4.55〜5.2 秒の音声と 1 行のプロンプトを用意しました。4 枚のポートレートはすべて 16:9 でした。すべてのクリップは、音声トラック付きの 1280×720、24 fps で返りました。処理時間は、クリップ 1 本あたり約 2 分です。送信から完成ファイルまでは 110〜133 秒でした。入力ポートレートとフレームを比べると、4 本すべてで顔は同じ人物だと分かる状態でした。
唇、表情、ジェスチャー
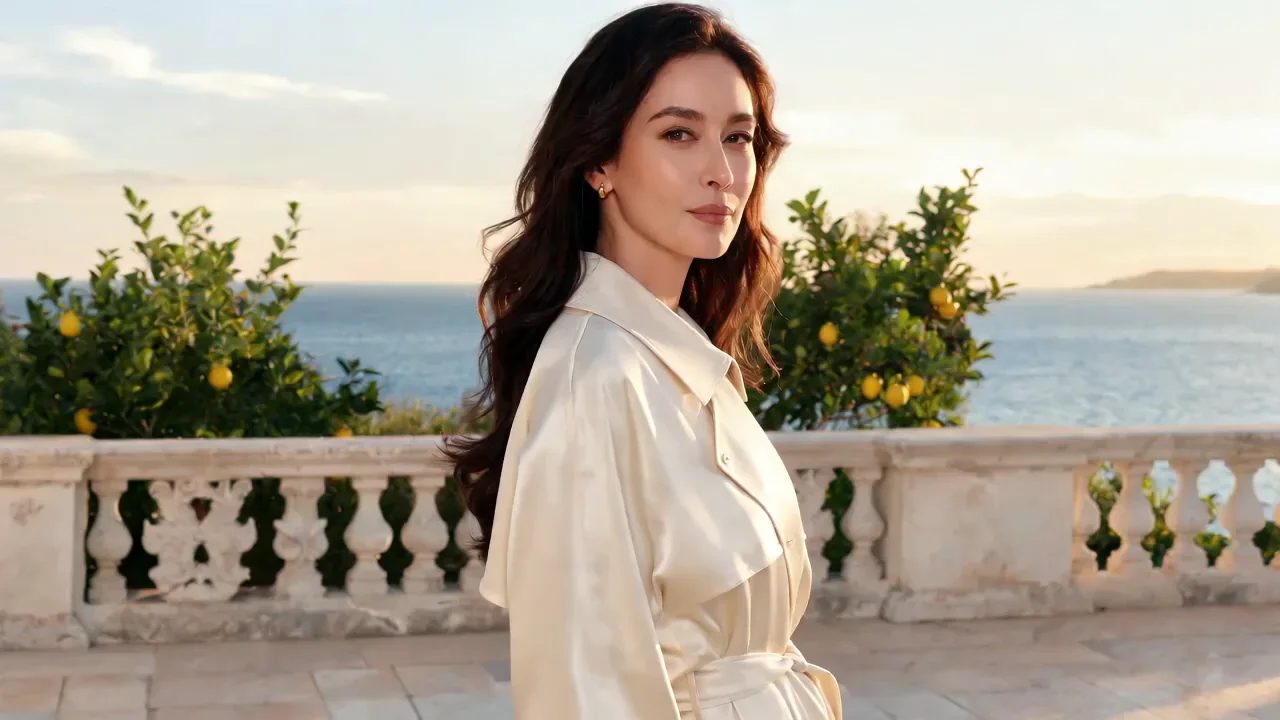
4 本すべてで、唇は音声に合わせて動きました。プロンプトは小さく具体的な動きを求めており、その大半が現れました。最後の語で小さく頭を傾けて微笑み、手をマイクに添えたままだったクリップ。バーの背後のボトルが安定したまま、わずかな笑みと眉の動きがセリフに従ったクリップ。最後の 1 秒で頭が海の方へ向いたクリップ。最後の語で眉を上げて笑ったクリップです。1 つだけ、レイトショーのクリップでマイクの方へ体を傾ける指示は、目に見える形では現れませんでした。
プロンプトは任意です
prompt を空にすると、モデルは音声だけに従って動きます。出品元は、プロンプトの言語として中国語、英語、日本語、韓国語、スペイン語(メキシコ)、インドネシア語を挙げています。当社の 4 つのプロンプトはすべて英語で、表情、ジェスチャー、視線の向きを指示しました。カメラの動きの指示はテストしていません。
テストしていないこと
出品元は複数人の場面も挙げていますが、当社はまだ試していません。当社のクリップはすべて約 5 秒の音声によるもので、300 秒の上限に近い長いクリップ、曲全体、16:9 以外のポートレートは試していません。
コンテンツ審査
ByteDance のコンテンツ審査に通らないポートレートは処理を断られ、課金されません。当社のテストポートレートの 1 枚も、この理由で断られ、クリップも課金もありませんでした。すべてのリクエストがこの審査を通る前提で計画してください。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | いいえ | 任意、300 文字まで。雰囲気、ジェスチャー、視線の向き、カメラの動きを指示できます。 300 文字以内 |
image_url | はい | アニメーションするポートレート。JPEG、PNG、WebP、BMP、TIFF、GIF、HEIC、HEIF のいずれかで、30 MB 未満、各辺 300〜6000 px、幅対高さの比は 0.4〜2.5。 |
audio_url | はい | 話し声または歌。WAV または MP3、15 MB 未満、4〜300 秒。 |
料金
$0.108 / 秒
入力音声の秒数ごとに課金され、最短 4 秒、最長 300 秒です。確保額は音声の長さに従い(読み取れない場合は 300 秒の上限)、差額は配信時に解放されます。失敗または拒否されたリクエストには課金されません。
ユースケース
録音したセリフに顔を与える
録音または生成したセリフをポートレートと組み合わせると、その人物がそれを届けるクリップが得られます。ナレーション付きのイントロ、証言、すでに顔を決めたキャラクターのセリフに役立ちます。
ホストの短い導入と冒頭の一言
明るく遊び心のある冒頭のセリフに、雰囲気と最後の語での間を指定したプロンプトを組み合わせると、大きな表情、生き生きとした眉、笑い声が得られました。このページのレイトショーの例がそうです。
静止画から歌のセリフを届ける
出品元は歌唱も話し声と並べて挙げています。当社のテストは、ヴィンテージマイクの前でのゆっくりした歌と話しの中間の 1 本、約 5 秒でした。曲全体はまだ試していません。
スマホの写真をそのまま使う
ポートレートは JPEG、PNG、WebP、BMP、TIFF、GIF、HEIC、HEIF のいずれでも、30 MB 未満であれば使えます。スマートフォンで撮った写真を、変換せずにそのまま入れられます。
プロンプトガイドと実践のヒント
表情をセリフ中の瞬間に結びつける
「最後の語でけだるげな笑み」と「最後に視線を外す」は、どちらも当社が指定した位置に現れました。サパークラブのクリップでは笑みと頭の傾きが最後に来て、テラスのクリップでは最後の 1 秒で頭が海の方を向きました。セリフのどこで動きを起こしてほしいかを書くと、モデルがタイミングを合わせる手がかりになります。
動きは数個に絞る
当社のプロンプトはそれぞれ、雰囲気、1〜2 個の表情の動き、ときに姿勢を求めていました。5 秒のクリップを形づくるには、それで十分です。当社の試行では、表情の動きの方が体の動きよりもプロンプトに確実に従いました。
体の動きだけに頼らない
レイトショーのプロンプトにあった「マイクの方へ体を傾ける」は、目に見える形では起こりませんでした。一方、その隣にあった笑いと眉の動きは起こりました。これは 1 回の試行による 1 つの観察ですが、体の動きが重要なら、一度生成して確認してから次に進んでください。
制限を考えてポートレートを選ぶ
幅と高さはそれぞれ 300〜6000 ピクセルで、幅対高さの比は 0.4〜2.5 である必要があります。テストしたのは 16:9 のポートレートだけです。
音声を演技の長さに合わせて切る
クリップは音声と同じ長さで走り、課金も音声の長さに従います。話すまたは歌う部分だけが残るようにファイルを切ってください。WAV または MP3、15 MB 未満です。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。