Einführung
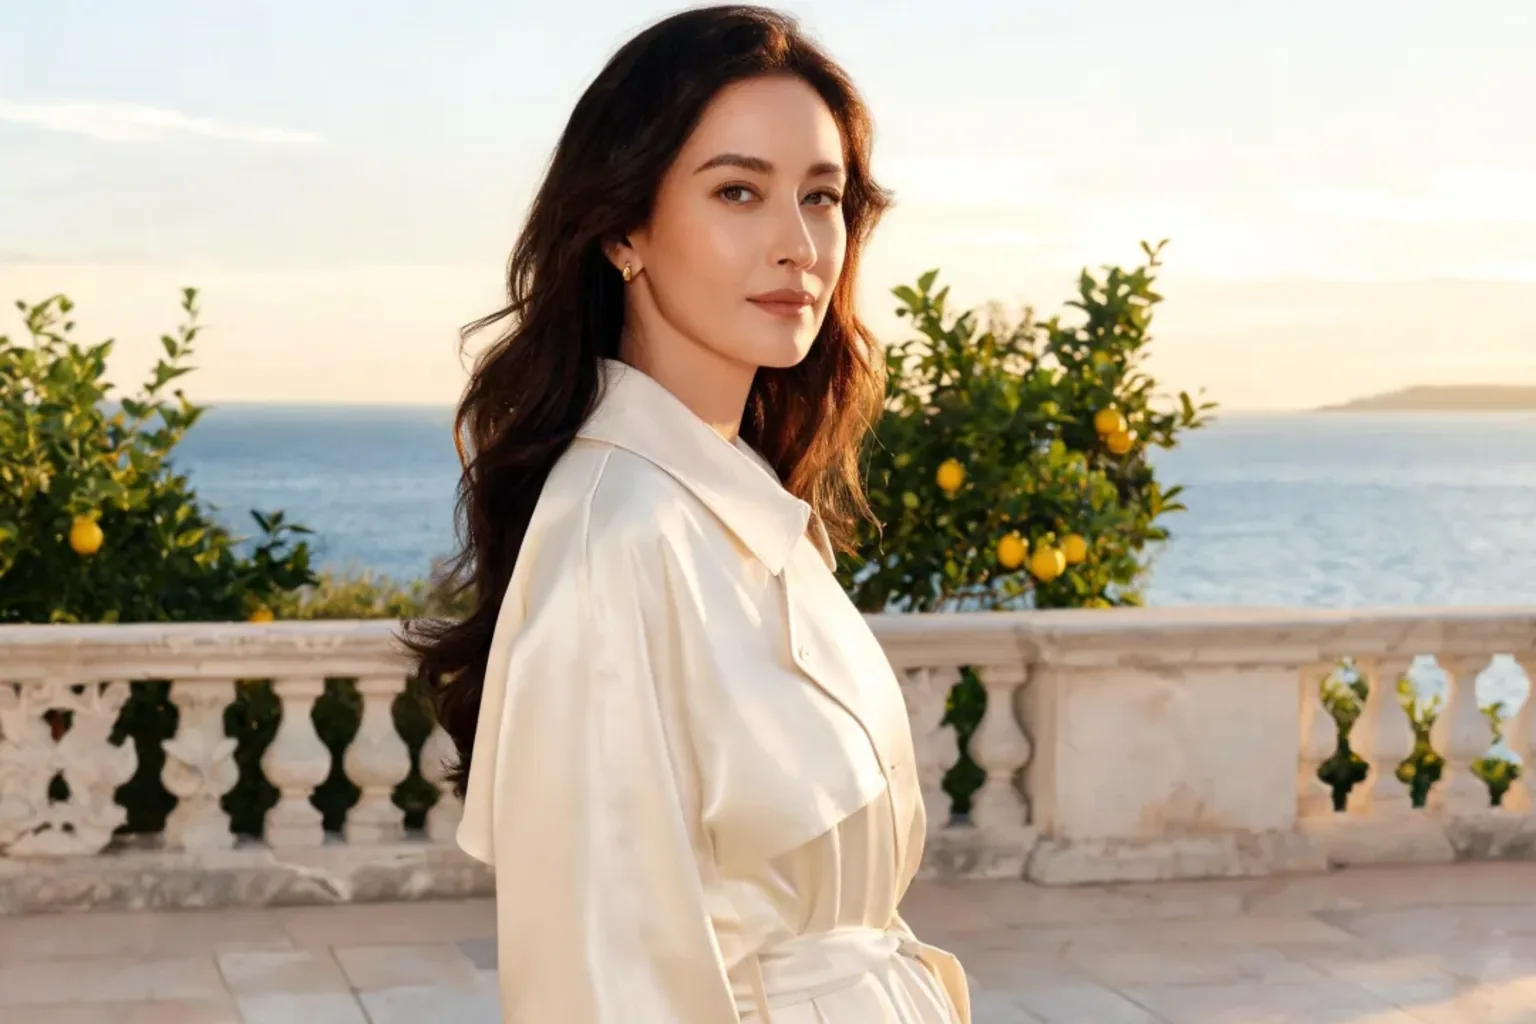
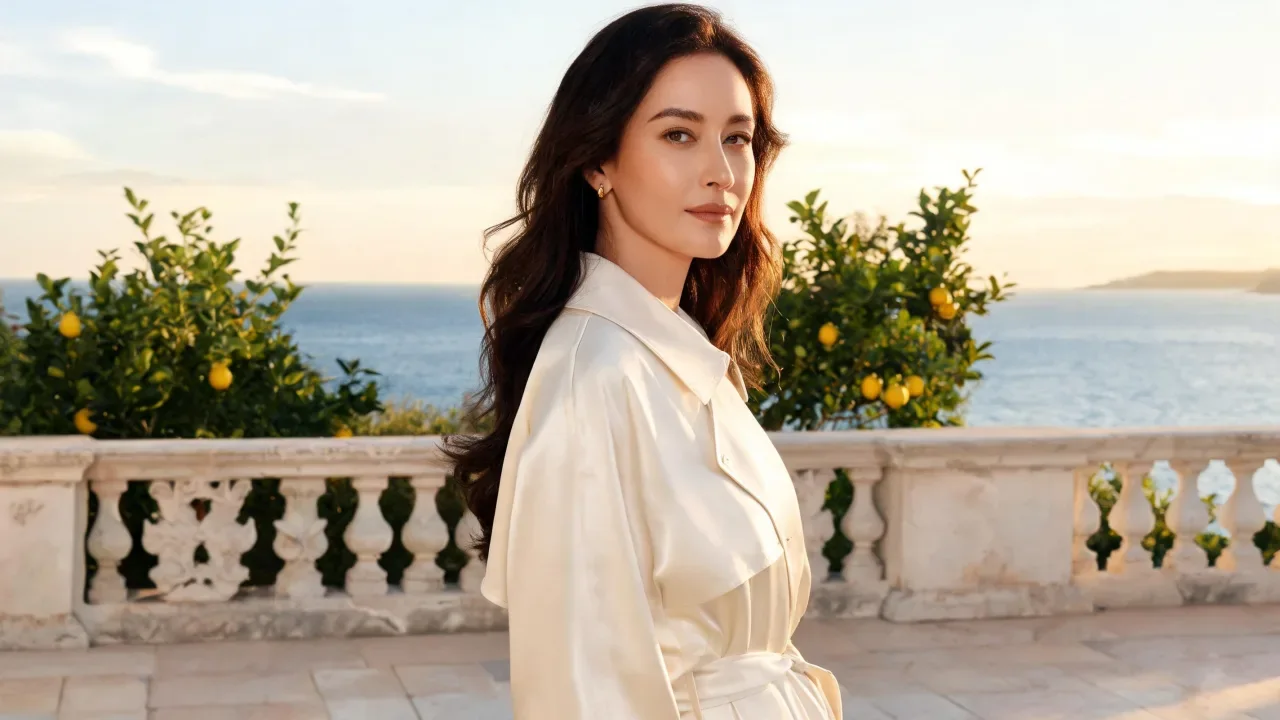
Talking Avatar macht aus einem einzelnen Porträt einen sprechenden Clip. Sie schicken das Gesicht in image_url und eine Sprachaufnahme in audio_url; Mund, Kiefer und kleine Kopfbewegungen werden animiert, sodass die Person genau das zu sagen scheint, was in der Aufnahme steht. Der Clip ist so lang wie das Audio, drei bis sechzig Sekunden, und kommt mit Ihrer Aufnahme als Tonspur zurück, bereit zum Posten oder für den Schnitt.
Wichtige Funktionen und Highlights
Das Audio bestimmt das Timing
Jede Mundform entsteht aus dem Ton selbst, deshalb sitzen Pausen, schnelle Passagen und Betonungen genau dort, wo die sprechende Person sie gesetzt hat. Es gibt kein Skriptfeld und kein Timing zum Einstellen: Nehmen Sie den Satz so auf, wie er klingen soll, und das Gesicht folgt ihm Sekunde für Sekunde.
Das Porträt bleibt die Szene
Kleidung, Haare, Hintergrund und Bildausschnitt kommen direkt aus dem Bild. Um das Gesicht herum wird nichts neu erzeugt, darum bleibt eine Moderatorin, eine Figur oder ein Markengesicht von Clip zu Clip erkennbar dieselbe Person. Das Ergebnis ist kompakt, etwa 0,2 Megapixel bei 25 Bildern pro Sekunde (ein 16:9-Foto kam mit 640×352 zurück, ein 3:4-Porträt mit 400×544); planen Sie also für Feeds und Chatfenster statt für Vollbild.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
image_url | Ja | Das Gesicht, das sprechen soll. Eine Person, ungefähr in die Kamera blickend, gleichmäßig ausgeleuchtet; ein Brustbild funktioniert am besten. mindestens 1 Zeichen |
audio_url | Ja | Die Sprache für die Lippensynchronisation, 3 bis 60 Sekunden, MP3 oder WAV. Es muss ein direkter Link auf die Audiodatei sein; Hochladen ist der zuverlässigste Weg. mindestens 1 Zeichen |
prompt | Nein | Optional. Ein paar Worte zu Mimik oder Stimmung, etwa ruhig, fröhlich oder ernst. höchstens 1000 Zeichen |
mask_url | Nein | Optional. Nur nötig, wenn das Porträt mehrere Personen zeigt: ein Schwarz-Weiß-Bild in derselben Größe, weiß über der Person, die sprechen soll. mindestens 1 Zeichen |
seed | Nein | Festlegen, um zwei Läufe mit demselben Porträt und Audio zu vergleichen; weglassen für jedes Mal eine neue Version. |
Preis
$0.018 / Ausgabesekunde
Abgerechnet pro Sekunde des gelieferten Videos, das so lang ist wie Ihr Audio, aufgerundet und mindestens 3 Sekunden.
Anwendungsfälle
Moderationsclips aus einem Standbild
Kurs-Intros, Produktvorstellungen und wöchentliche Updates können immer wieder dasselbe freigegebene Porträt nutzen, jeweils mit einer neuen Aufnahme. Für eine andere Sprache schicken Sie einfach eine andere Audiodatei mit demselben Bild, so deckt eine Moderatorin mehrere Märkte ab.
Figuren, die laut antworten
Companion- und Rollenspiel-Apps können eine Figur ihre Antwort vor der Kamera sprechen lassen: ein Figurenporträt behalten, die Antwort in Sprache umwandeln und beides senden. Auch eine kurze Antwort braucht ein bis zwei Minuten, starten Sie den Auftrag also schon, während die Textantwort angezeigt wird.
Prompt-Leitfaden und Praxistipps
Das Porträt nach dem Mund auswählen
Bewegt wird der Mund, also geben Sie ihm Pixel: Brustbild, Gesicht ungefähr zur Kamera, gleichmäßiges Licht und nichts vor den Lippen. Sonnenbrillen, starke Profilwinkel und kleine Gesichter in einer Totalen sind die üblichen Gründe, wenn ein Ergebnis seltsam wirkt.
Sauberes Audio schlägt lautes Audio
Exportieren Sie Sprache ohne Hintergrundmusik, hallige Räume oder überlappende Stimmen. Schneiden Sie Stille am Anfang und am Ende weg, denn auch Stille zählt zur abgerechneten Länge. Halten Sie jede Datei zwischen drei und sechzig Sekunden und teilen Sie längere Skripte an natürlichen Pausen.
Prompt für die Stimmung, Maske für die Person
Das Feld prompt lenkt die Mimik etwas, etwa ruhig, fröhlich oder ernst, kann aber nicht ändern, wer spricht oder wo. Zeigt das Porträt mehrere Personen, übergeben Sie mask_url mit der sprechenden Person weiß auf Schwarz, in derselben Größe wie das Bild. Legen Sie seed fest, um zwei Aufnahmen auf demselben Porträt zu vergleichen.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "spicyapi/talking-avatar-v1/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.