Einführung
OmniHuman 2.0 Talking Avatar ist ByteDances audiogesteuertes Avatar-Modell. Sie senden ein Porträt (image_url) und eine Audiodatei mit Sprache oder Gesang (audio_url), und Sie erhalten ein 720p-Video dieser Person, die das Audio vorträgt – Gesicht, Lippen, Kopf und Oberkörper bewegen sich mit, statt den Oberkörper eingefroren zu lassen. Der Clip ist so lang wie das Audio, von 4 bis 300 Sekunden. Es gibt kein Feld für Dauer, Auflösung oder Seitenverhältnis. Ein optionaler prompt mit bis zu 300 Zeichen steuert Stimmung, Gesten, wohin die Augen blicken und laut Hersteller auch die Kamerabewegung.
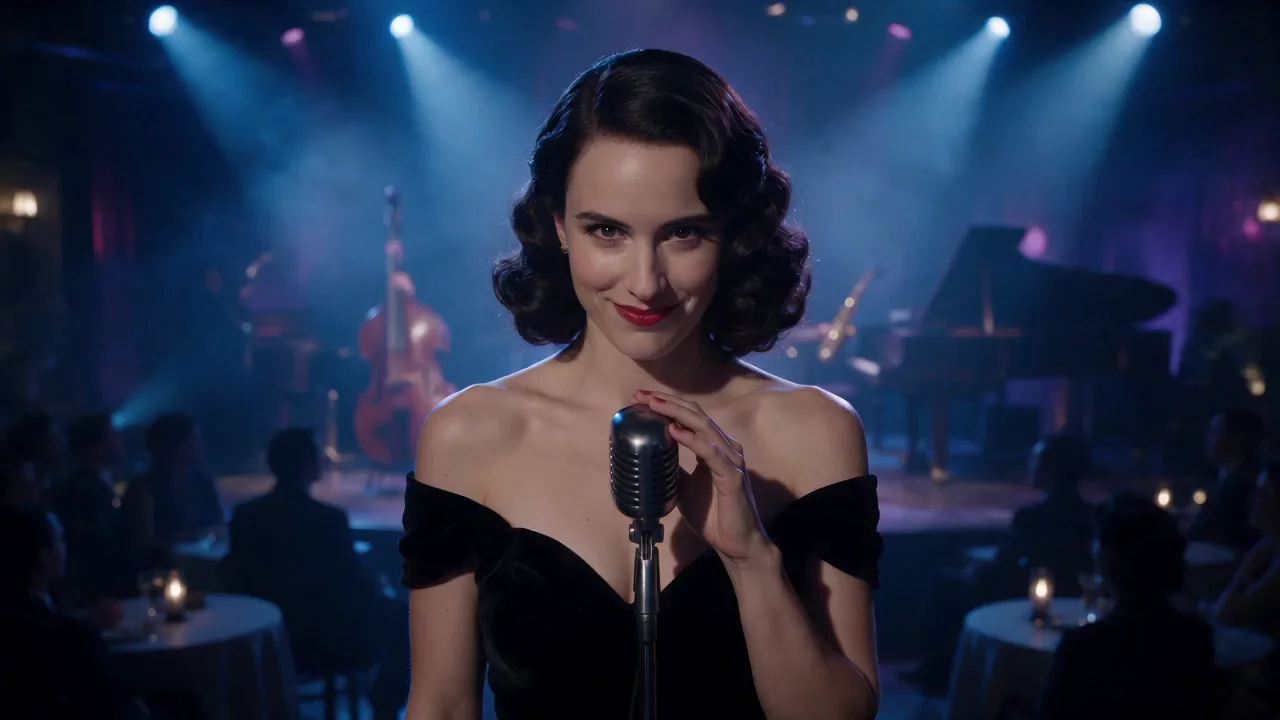
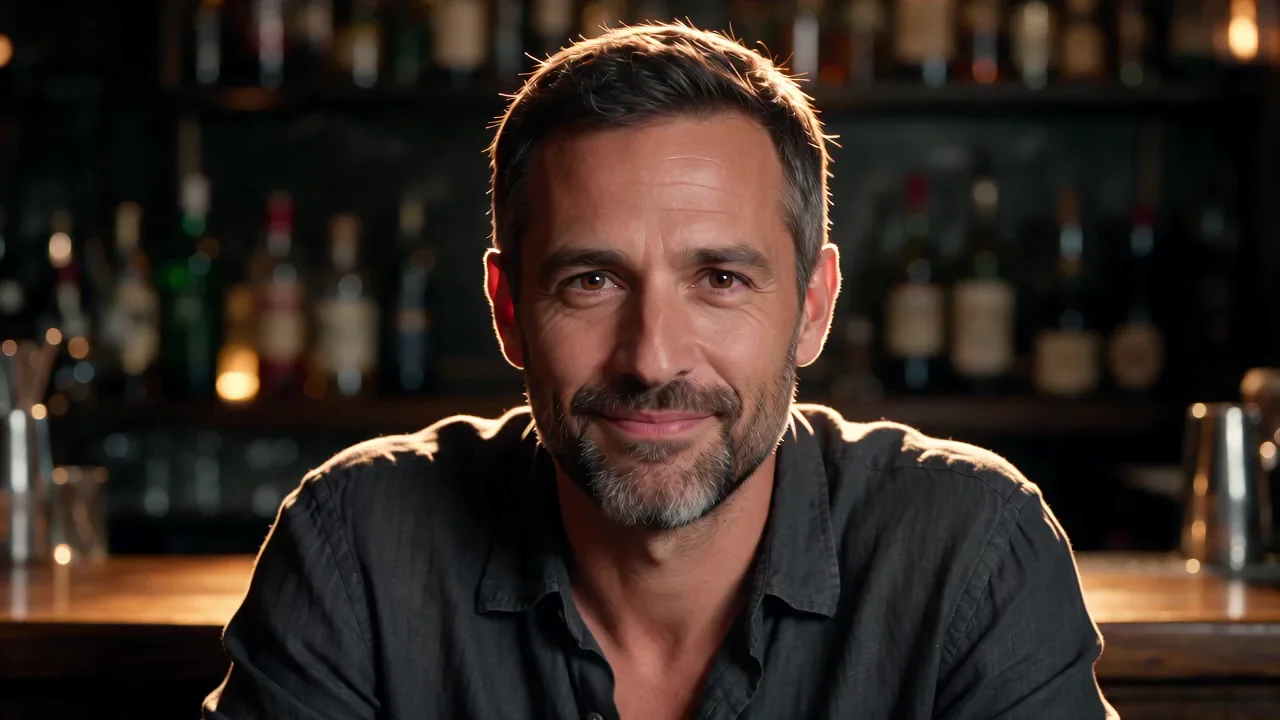
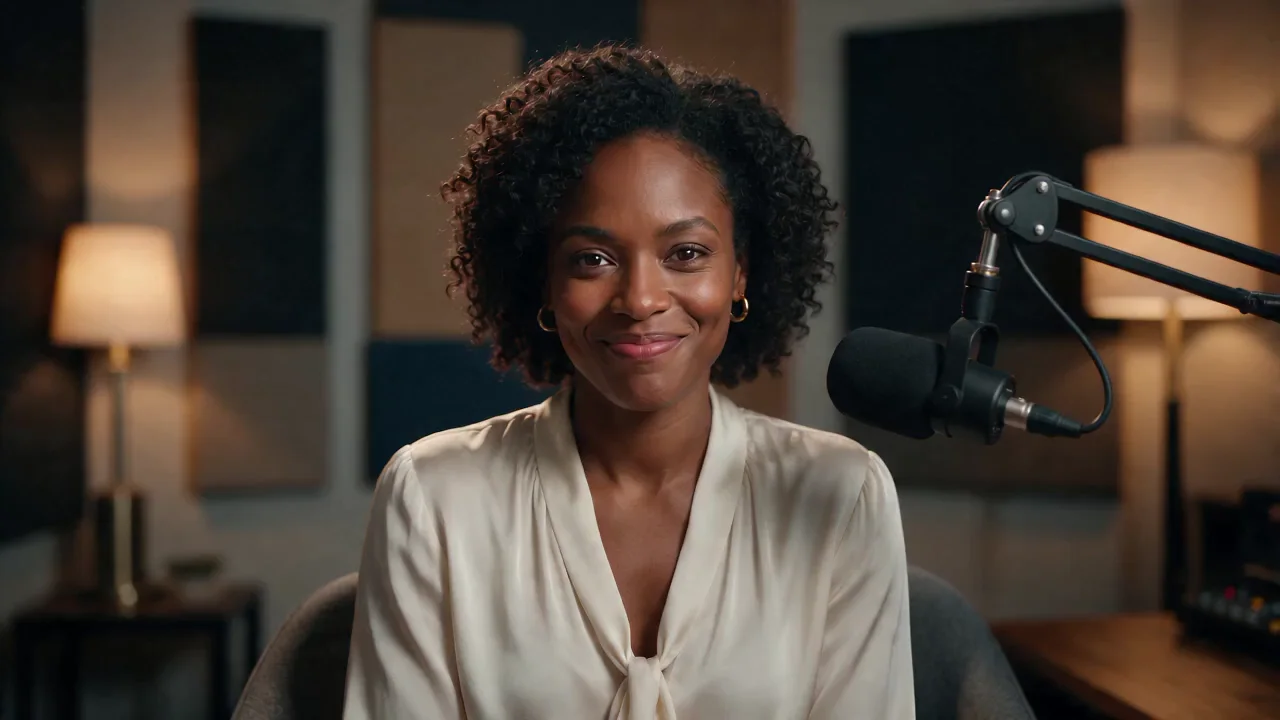
Drei der vier Beispiele auf dieser Seite (die Sängerin im Supperclub, die Bar und die Late-Night-Show) verwenden dieselben Porträts und dasselbe Audio wie Kling Avatar 2.0, hier auf etwa fünf Sekunden gekürzt, damit Sie die beiden Seiten direkt nebeneinander vergleichen können.
Wichtige Funktionen und Highlights
Das Audio bestimmt die Länge
Kürzen Sie Ihr Audio auf die gewünschte Clip-Länge, bevor Sie es senden. Audio, das kürzer als 4 Sekunden oder länger als 300 Sekunden ist, wird abgelehnt, bevor etwas berechnet wird. In unseren Läufen kam der Clip zwischen 0,2 und 1 Sekunde länger zurück als das Audio und landete auf ganzen Sekunden: 4,55 Sekunden Audio ergaben einen 5-Sekunden-Clip, 5,2 Sekunden einen 6-Sekunden-Clip. Die Abrechnung richtet sich nach der Audiolänge, nicht nach dem fertigen Clip.
Was wir gemessen haben
Wir haben vier Porträts getestet, jedes mit eigenem Audio von 4,55 bis 5,2 Sekunden und einem eigenen einzeiligen Prompt. Alle vier Porträts waren 16:9. Jeder Clip kam mit 1280×720 und 24 fps inklusive Tonspur zurück, und die Verarbeitung dauerte etwa zwei Minuten pro Clip – 110 bis 133 Sekunden vom Absenden bis zur fertigen Datei. Beim Vergleich von Einzelbildern mit dem Eingabe-Porträt blieb das Gesicht in allen vier Clips eindeutig dieselbe Person.
Lippen, Mimik und Gesten
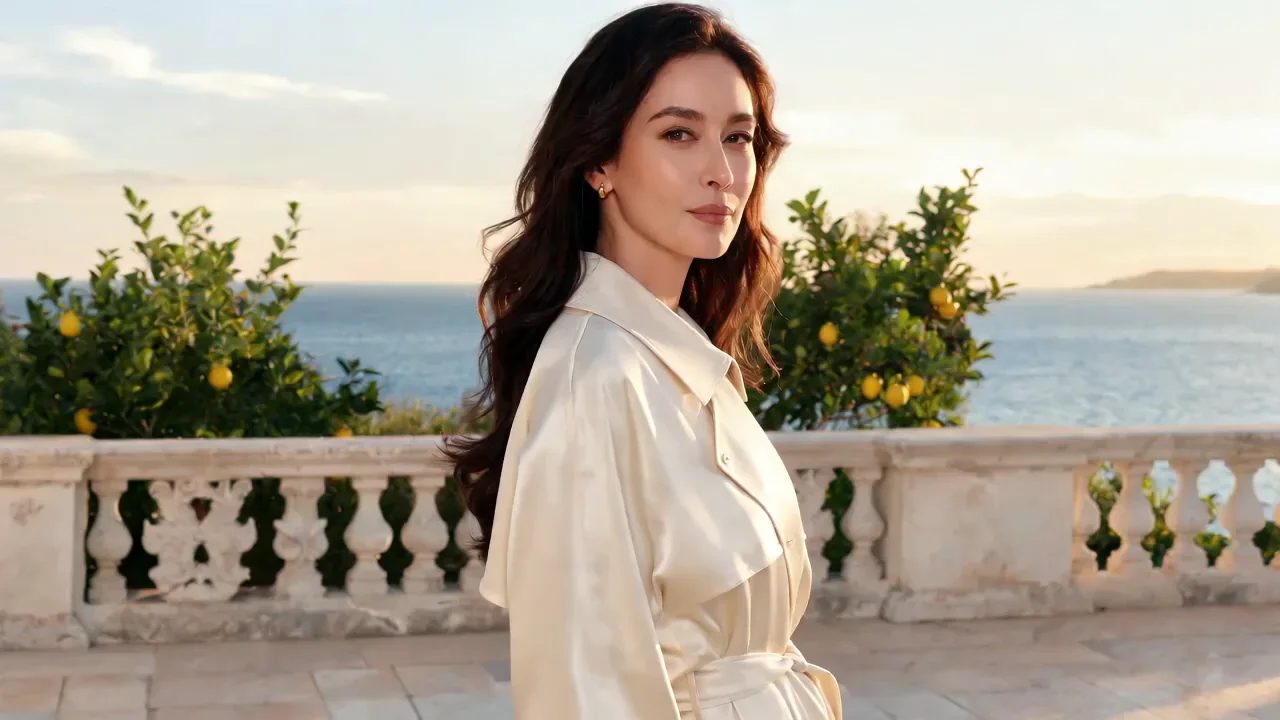
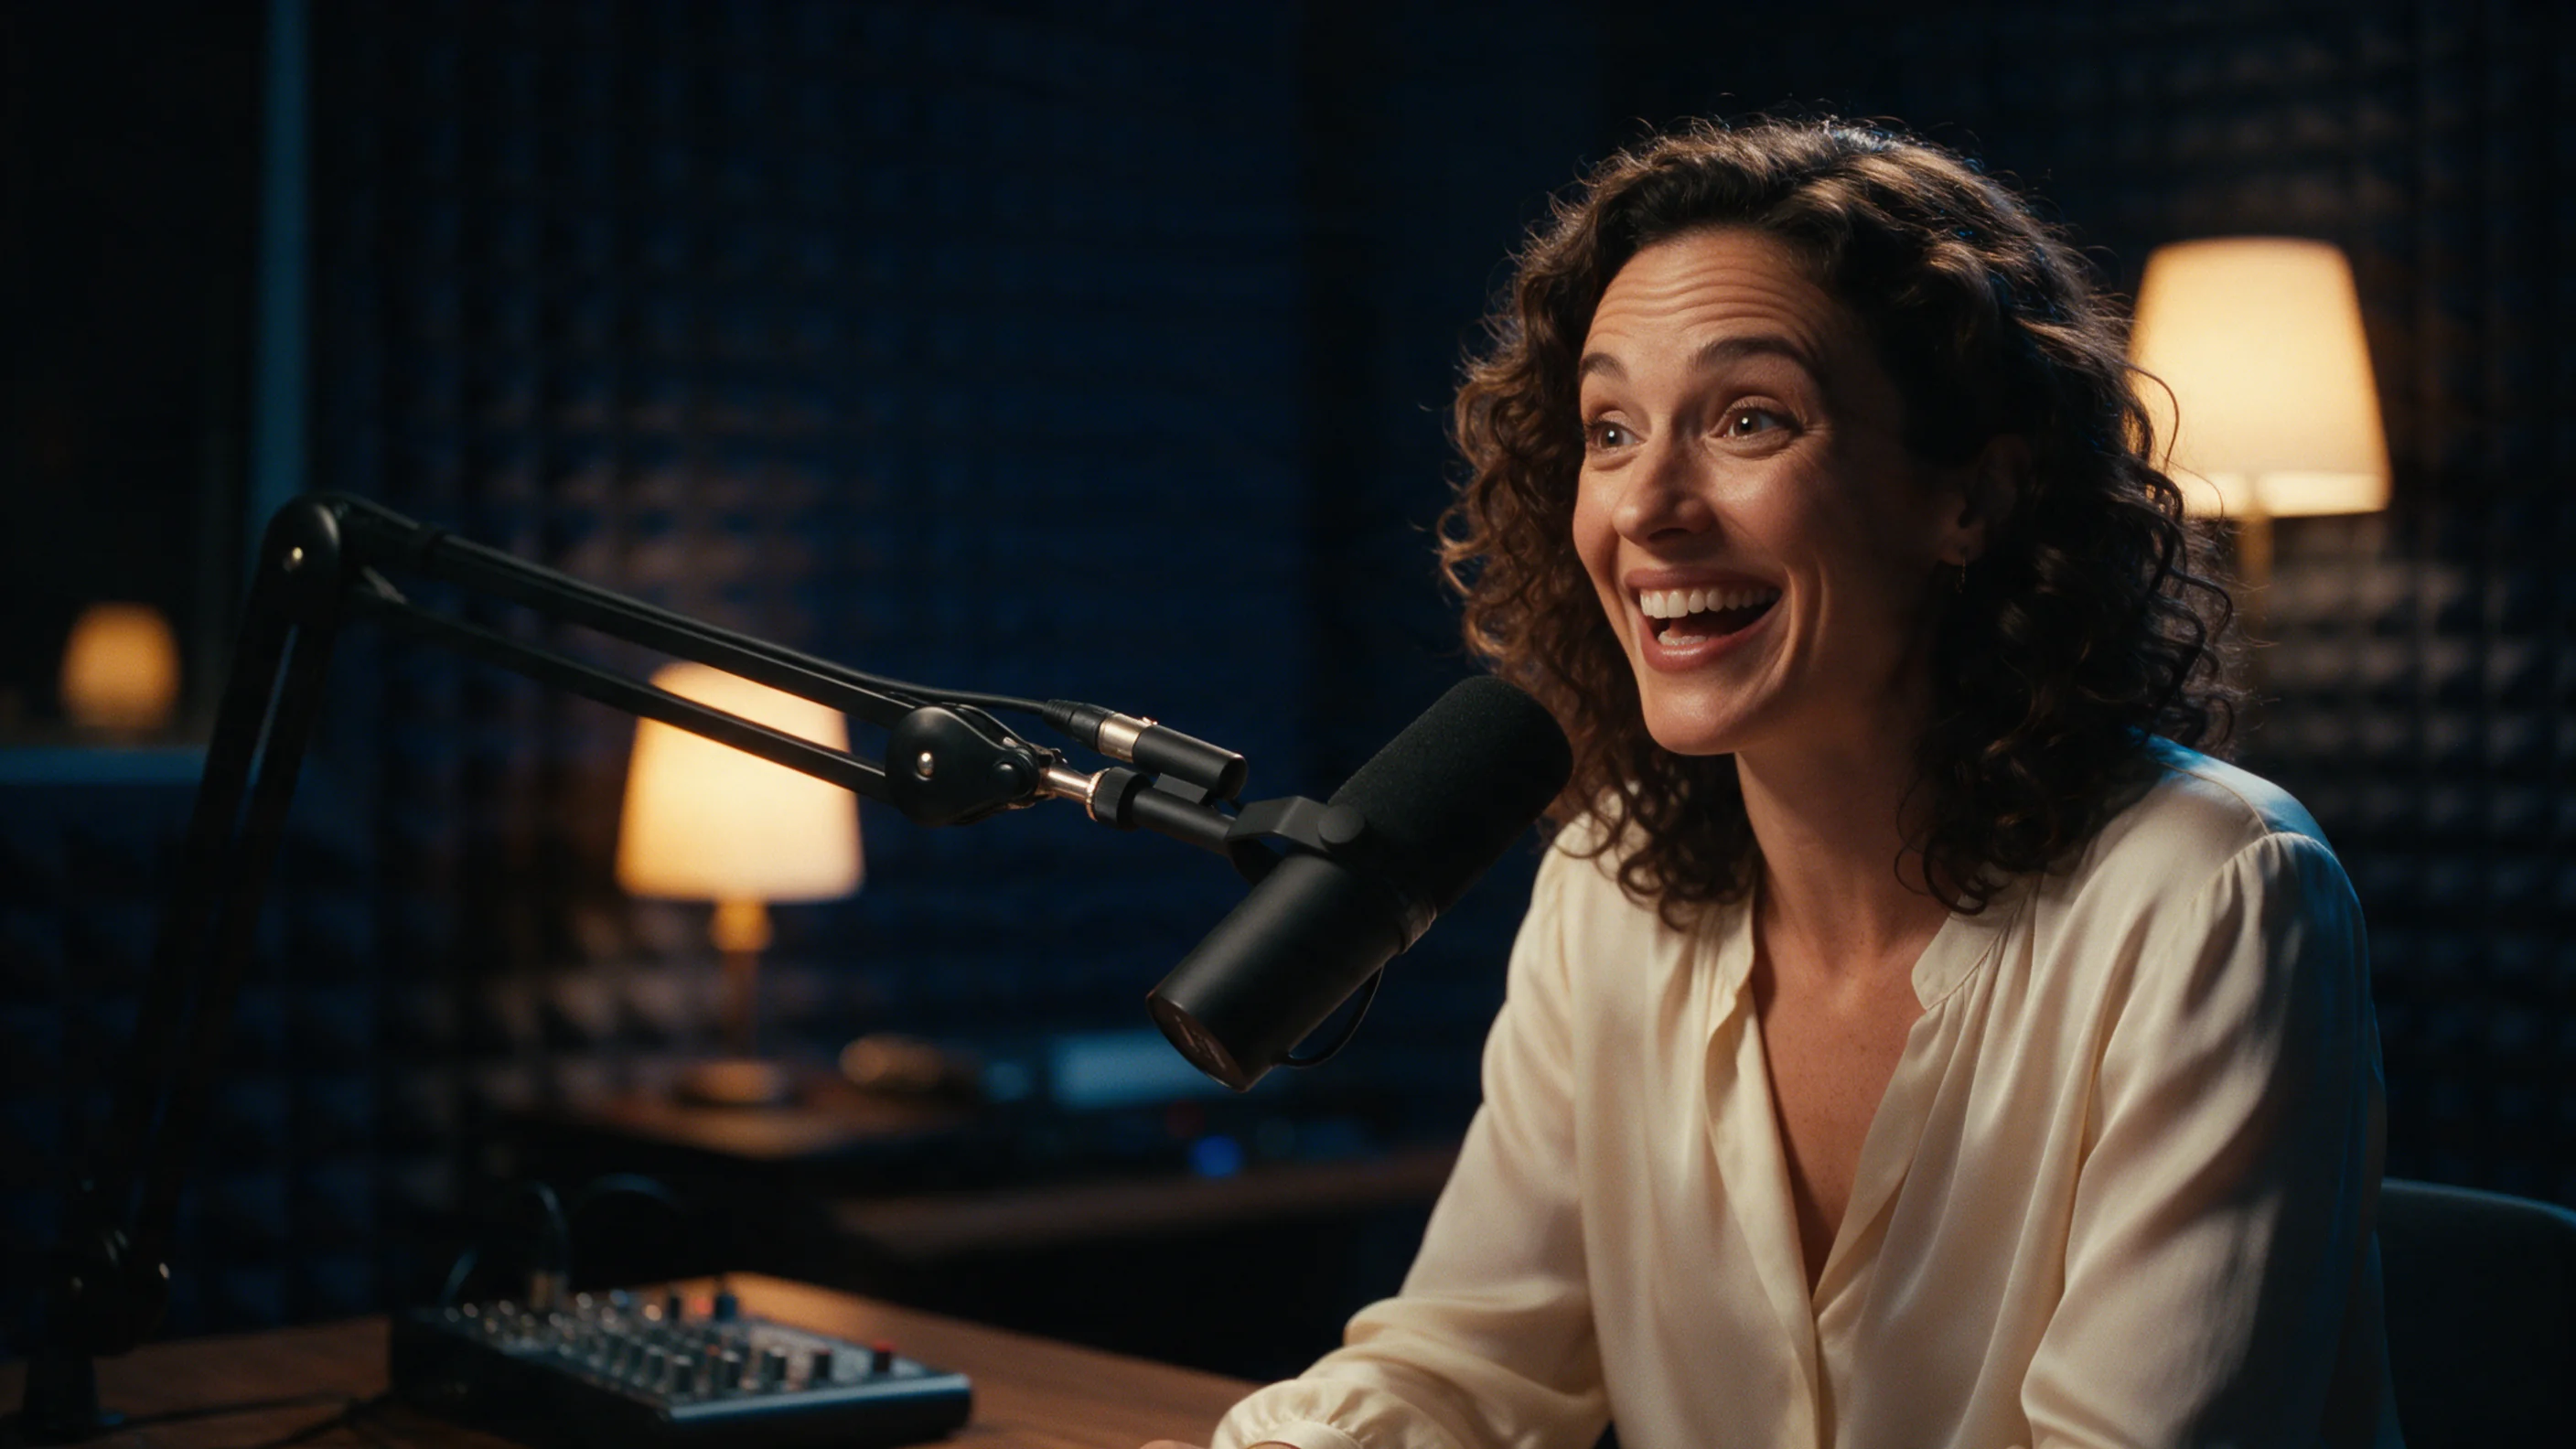
In allen vier Clips folgten die Lippen dem Audio. Die Prompts verlangten kleine, konkrete Akzente, und die Mehrzahl davon zeigte sich: ein Lächeln und eine leichte Kopfneigung am letzten Wort, während die Hand am Mikrofon blieb; ein halbes Lächeln und eine hochgezogene Augenbraue, während die Flaschen hinter der Bar stabil blieben; eine Kopfdrehung zum Meer in der letzten Sekunde; und ein kurzes Lachen mit weiten Augenbrauen am letzten Wort. Eine Anweisung kam nicht sichtbar an: das Sich-Hinlehnen zum Mikrofon im Late-Night-Show-Clip.
Der Prompt ist optional
Lassen Sie prompt leer, folgt das Modell selbst dem Audio. Der Hersteller nennt Chinesisch, Englisch, Japanisch, Koreanisch, Spanisch (mexikanisch) und Indonesisch als Prompt-Sprachen. Unsere vier Prompts waren auf Englisch und steuerten Mimik, Gesten und wohin die Augen blicken; Anweisungen zur Kamerabewegung haben wir nicht getestet.
Was wir nicht getestet haben
Der Hersteller nennt Szenen mit mehreren Personen; wir haben sie nicht getestet. Unsere Clips hatten alle etwa fünf Sekunden Audio, daher haben wir keinen langen Clip nahe dem Maximum von 300 Sekunden, keinen vollständigen Song und keine Porträts außerhalb von 16:9 getestet.
Inhaltsprüfung
Porträts, die ByteDances Inhaltsprüfung nicht bestehen, werden abgelehnt, und es wird nichts berechnet. Eines unserer Test-Porträts wurde auf diese Weise abgelehnt: kein Clip, keine Berechnung. Rechnen Sie damit, dass jede Anfrage diese Prüfung durchläuft.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
prompt | Nein | Optional, bis zu 300 Zeichen. Steuert Stimmung, Gesten, wohin die Augen blicken und Kamerabewegung. höchstens 300 Zeichen |
image_url | Ja | Zu animierendes Porträt. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC oder HEIF, unter 30 MB, 300 bis 6000 px an jeder Seite, Seitenverhältnis von Breite zu Höhe zwischen 0,4 und 2,5. |
audio_url | Ja | Sprache oder Gesang, WAV oder MP3, unter 15 MB, 4 bis 300 Sekunden. |
Preis
$0.108 / Sekunde
Abrechnung pro Sekunde des Eingabe-Audios, mit einem Minimum von 4 Sekunden und einem Maximum von 300 Sekunden. Die Reservierung richtet sich nach der Audiolänge (oder nach dem Maximum von 300 Sekunden, wenn sie nicht gelesen werden kann), und die Differenz wird bei der Lieferung freigegeben. Fehlgeschlagene oder abgelehnte Anfragen werden nicht berechnet.
Anwendungsfälle
Einer aufgenommenen Zeile ein Gesicht geben
Kombinieren Sie eine aufgenommene oder erzeugte Zeile mit einem Porträt, um einen Clip dieser Person zu erhalten, die sie vorträgt – für erzählte Intros, Testimonials oder Dialoge einer Figur, deren Gesicht Sie bereits festgelegt haben.
Kurze Moderations-Intros und Cold Openings
Eine helle, verspielte Eröffnungszeile mit einem Prompt, der die Stimmung benennt und einen Akzent auf das letzte Wort setzt, brachte uns ausgeprägte Mimik, lebhafte Augenbrauen und ein Lachen, wie im Late-Night-Show-Beispiel auf dieser Seite.
Ein gesungener Part aus einem Standbild
Der Hersteller nennt Gesang neben Sprache. Unser Test umfasste eine langsame gesungene/gesprochene Zeile von etwa fünf Sekunden an einem Vintage-Mikrofon; einen ganzen Song haben wir noch nicht ausprobiert.
Handyfotos, so wie sie sind
Das Porträt kann JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC oder HEIF sein, unter 30 MB, sodass ein Foto direkt vom Handy ohne Umwandlung verwendet werden kann.
Prompt-Leitfaden und Praxistipps
Binden Sie einen Ausdruck an einen Moment in der Zeile
„A lazy smile on the last word“ und „glances away at the end“ kamen beide dort an, wo wir sie platziert hatten: Das Lächeln und die Kopfneigung erschienen am Ende des Supperclub-Clips, und der Kopf drehte sich in der letzten Sekunde des Terrassen-Clips zum Meer. Wenn Sie benennen, an welcher Stelle der Zeile der Akzent passieren soll, hat das Modell etwas, woran es sich zeitlich ausrichten kann.
Bei wenigen Akzenten bleiben
Jeder unserer Prompts verlangte eine Stimmung, ein oder zwei mimische Akzente und manchmal eine Haltung. Das reicht, um einen Fünf-Sekunden-Clip zu formen. Mimische Akzente folgten dem Prompt in unseren Läufen verlässlicher als Körperbewegungen.
Verlassen Sie sich nicht auf eine Körperbewegung allein
„A lean toward the mic“ im Prompt der Late-Night-Show kam nicht sichtbar zustande, während das Lachen und die Augenbrauen daneben erschienen. Das ist eine Beobachtung aus einem Lauf. Wenn Ihnen eine Körperbewegung wichtig ist, erzeugen Sie einmal und prüfen Sie das Ergebnis, bevor Sie darauf aufbauen.
Wählen Sie das Porträt mit Blick auf die Grenzen
Breite und Höhe müssen jeweils zwischen 300 und 6000 Pixeln liegen, und das Verhältnis von Breite zu Höhe muss zwischen 0,4 und 2,5 liegen. Wir haben nur 16:9-Porträts getestet.
Schneiden Sie das Audio auf die Darbietung zu
Der Clip läuft so lang wie das Audio, und die Abrechnung folgt der Audiolänge. Schneiden Sie die Datei daher auf die Sprache oder den Gesang zu, den Sie tatsächlich möchten. WAV oder MP3, unter 15 MB.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.