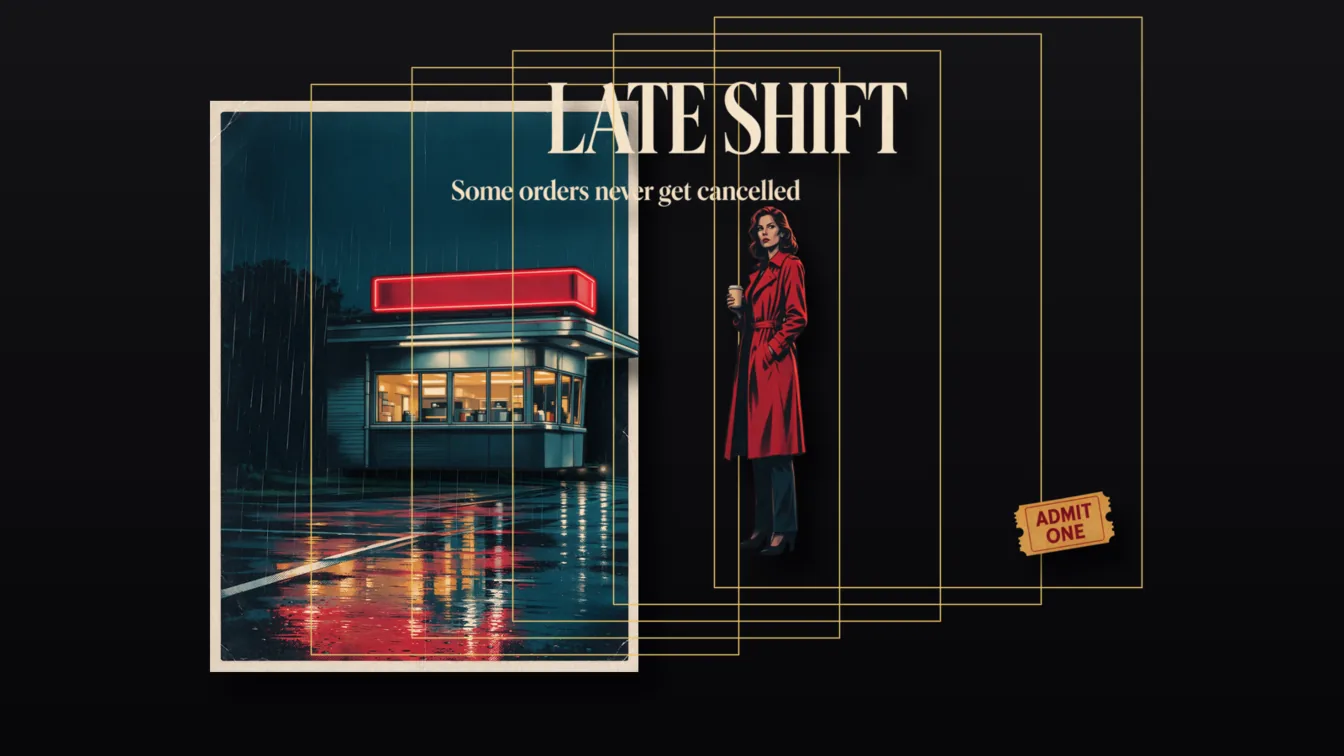
In breve: invia un'immagine e ottieni un'immagine di base riparata (l'immagine con gli elementi estratti rimossi e lo sfondo riempito) più fino a 16 livelli PNG trasparenti, uno per elemento. Ogni livello ha un name e un boundingBox, così i livelli si impilano di nuovo al loro posto. SpicyAPI esegue l'operazione su Seedream 5.0 Flash a $0.026 per immagine di output a qualsiasi risoluzione, e su Seedream 5.0 Pro a $0.042 per immagine (1K, 1.5K) o $0.084 (2K, auto). Inizia da Flash: costa meno e ha completato le categorie di input adulto nei nostri test. Pro costa di più e rifiuta le immagini di una scena intima tra due adulti.
In 30 secondi
- Output: l'immagine di base all'indice 0, poi i livelli. I livelli sono sempre PNG trasparenti;
output_formatcambia solo l'immagine di base (JPEG o PNG). - Tetto e fatturazione: al massimo 17 immagini per esecuzione (immagine di base più 16 livelli), e paghi per le immagini restituite, immagine di base inclusa. Quando l'attività viene accettata tratteniamo il prezzo di 17 e rimborsiamo la differenza appena il conteggio reale è noto.
- Prompt facoltativo. Se lo ometti, il modello sceglie gli elementi principali; se lo scrivi, separa ciò che nomini. Non esiste un'impostazione per il numero di livelli.
- Non è istantaneo: un'esecuzione richiede circa 45-100 secondi su entrambi i modelli.
- Copia i file nel tuo archivio quando l'esecuzione termina.
Come appare
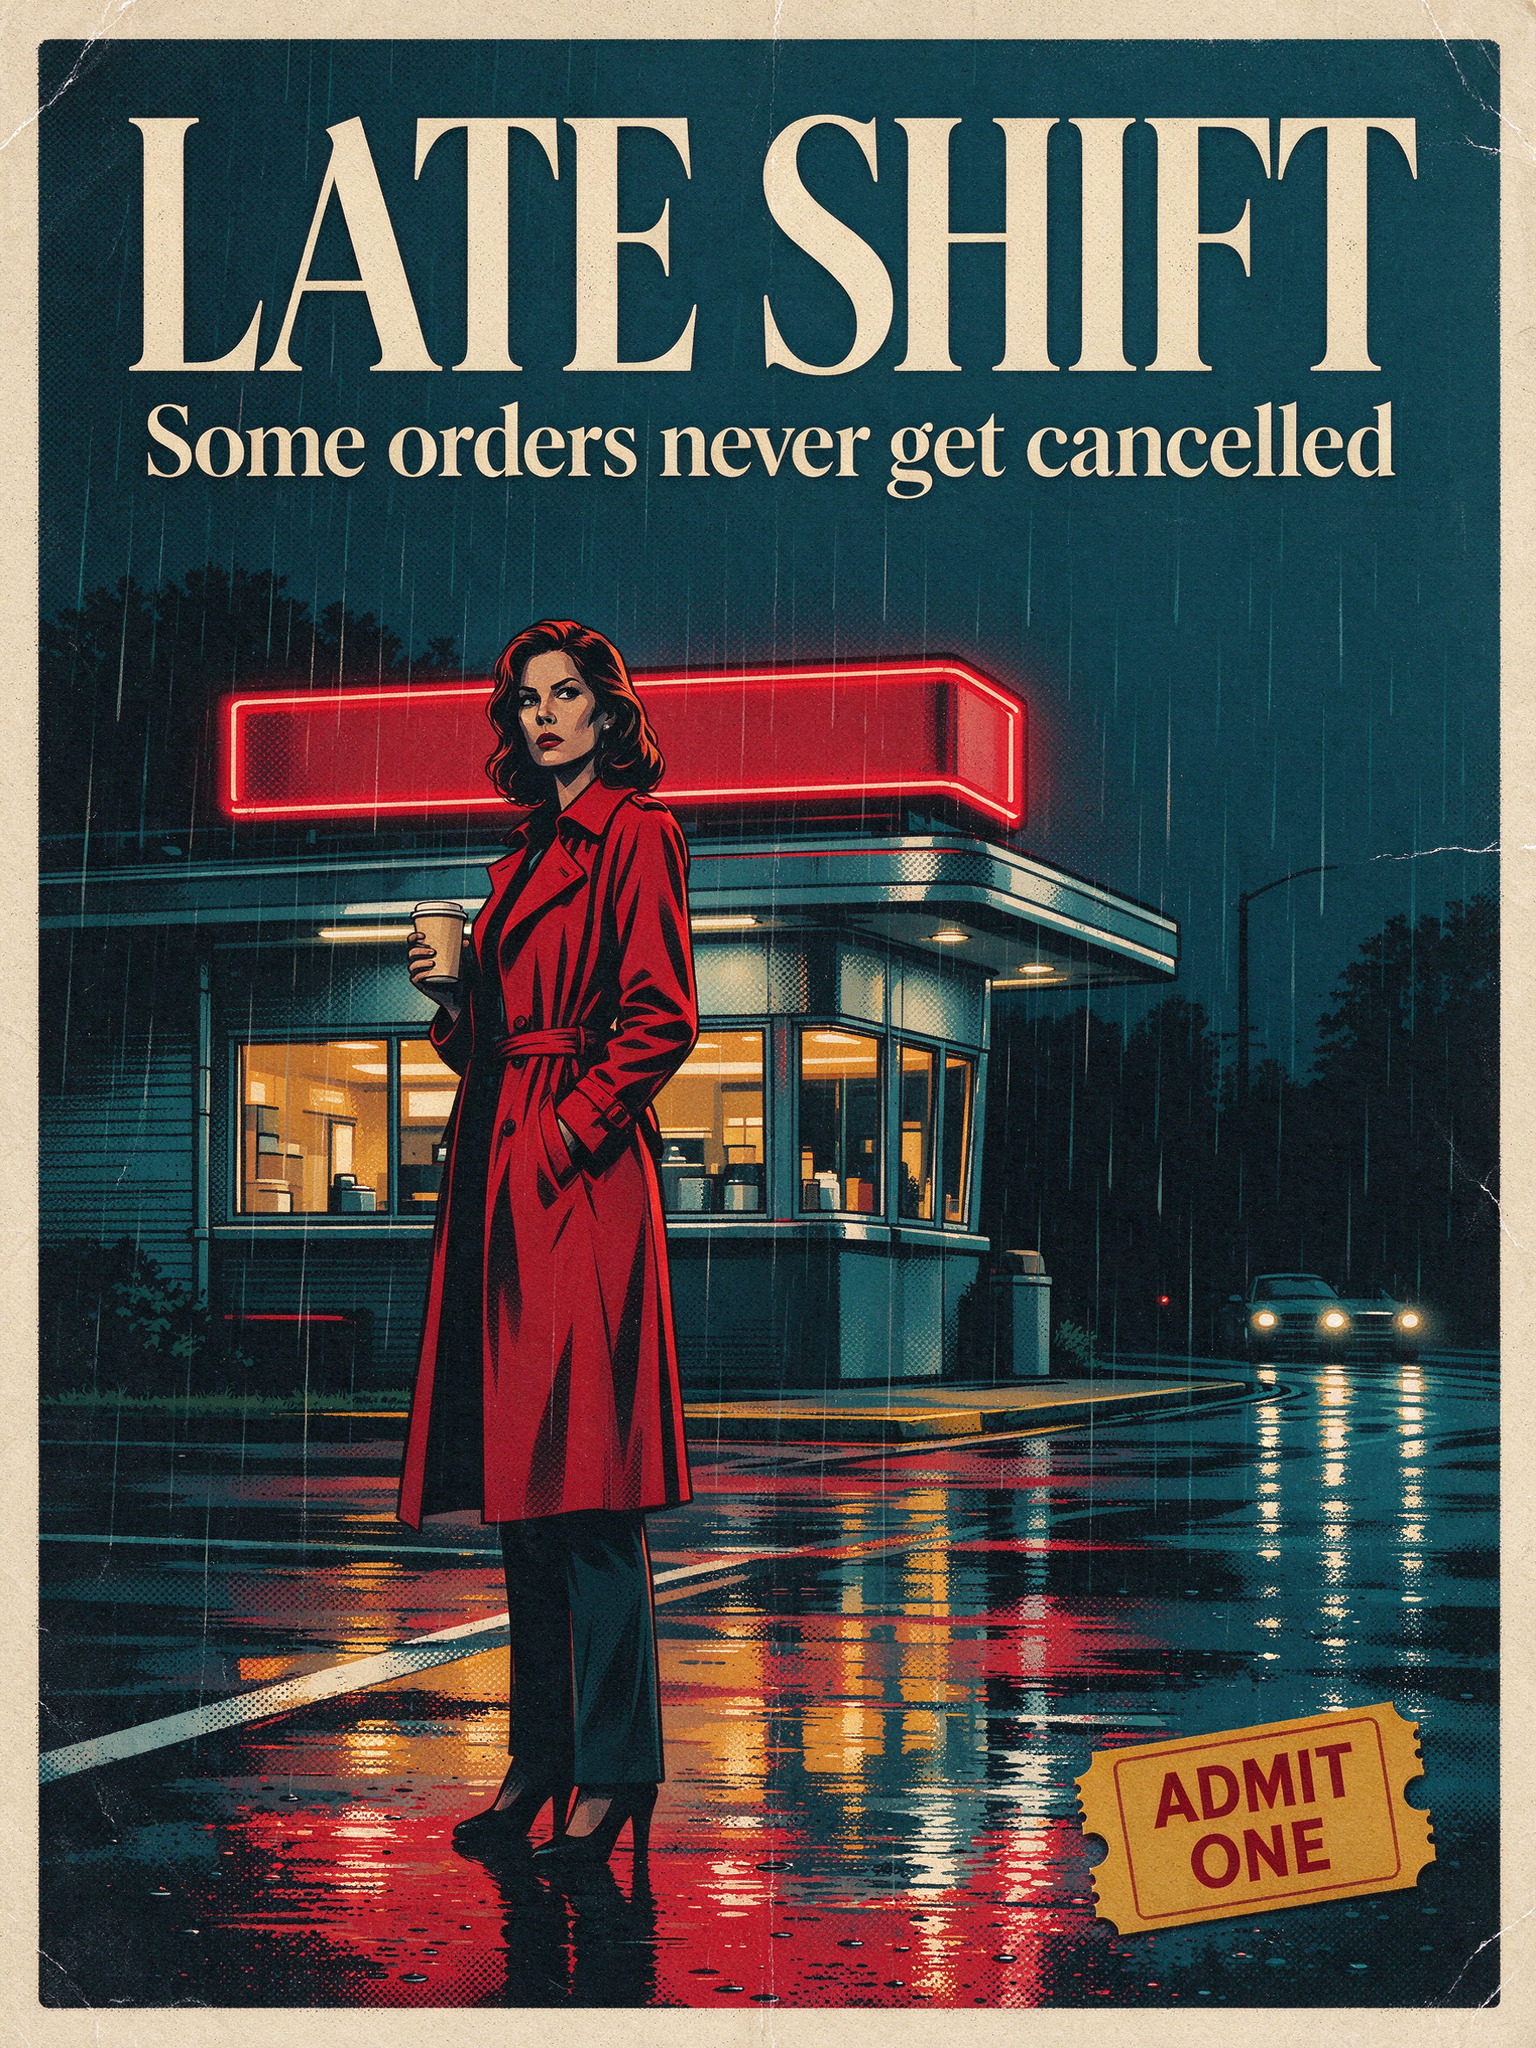
Siamo partiti da un poster generato con Seedream 5.0 Flash.
Flash, senza alcun prompt
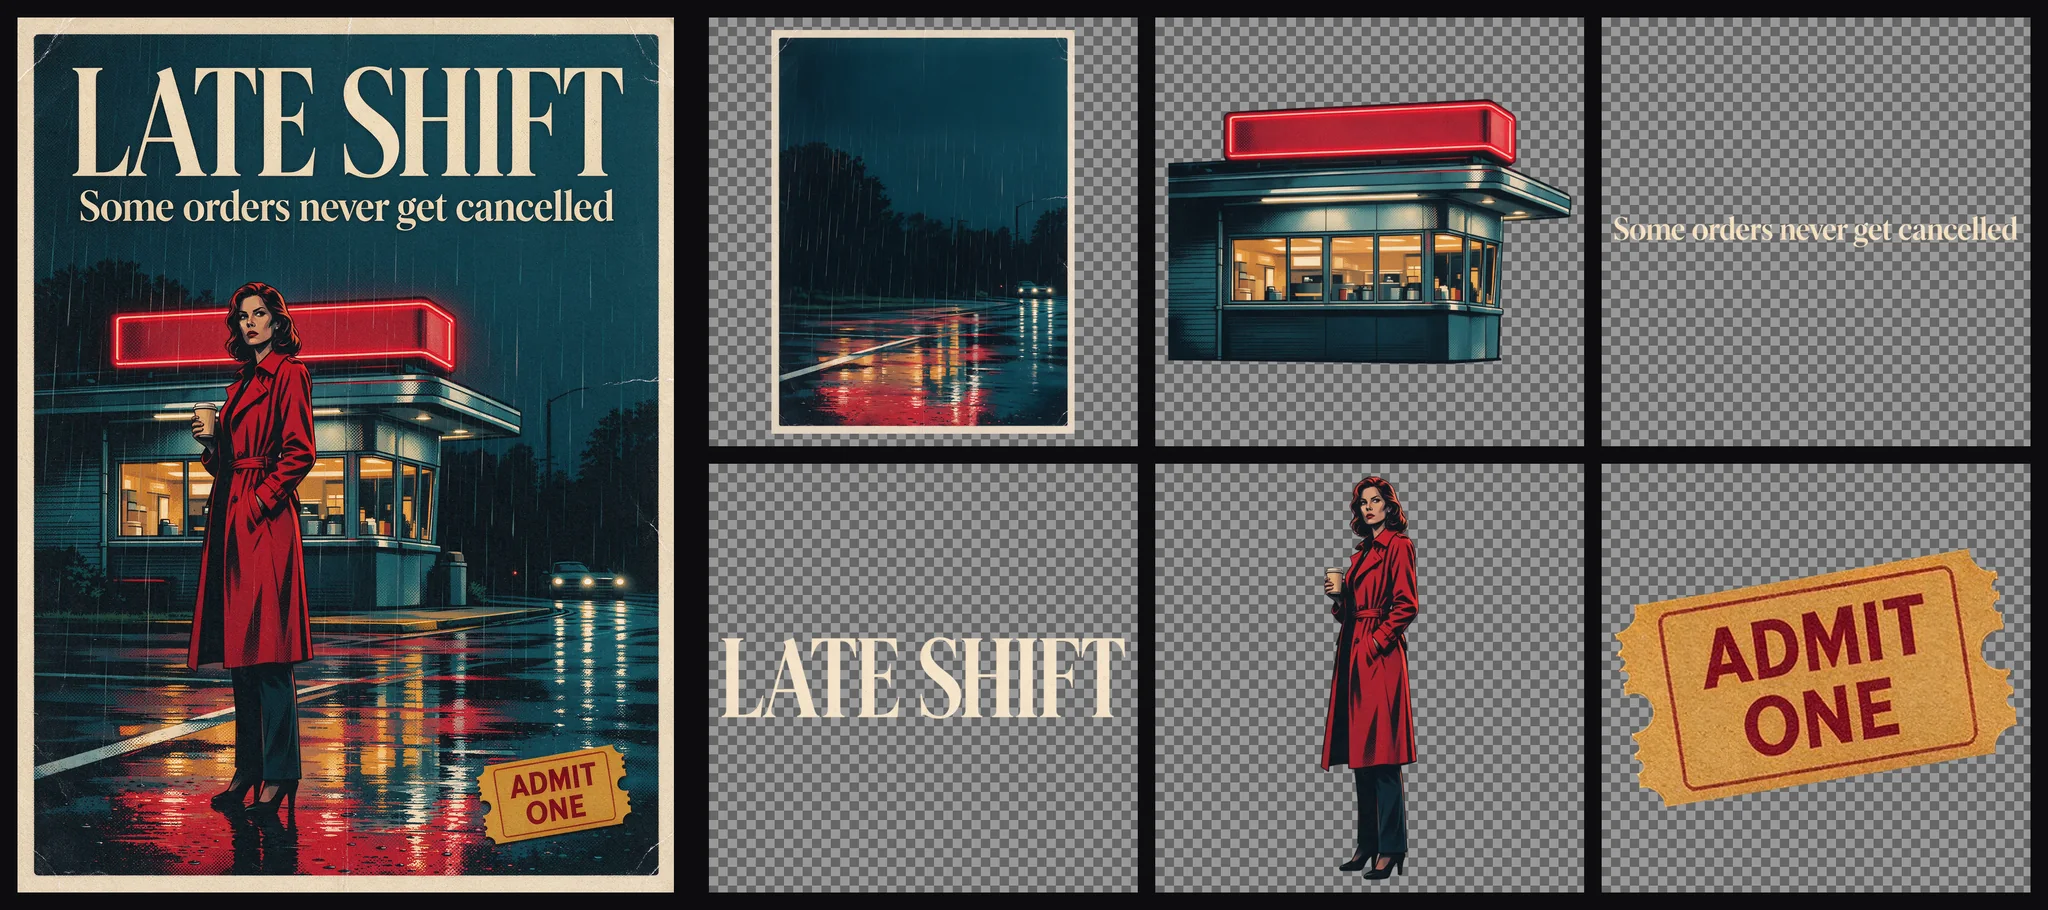
Abbiamo inviato il poster senza prompt e con resolution impostata su auto. Sono tornate 8 immagini: l'immagine di base più sette livelli, ossia il diner, un'auto lontana, il neon rosso, la donna con il trench rosso, la tagline, il titolo LATE SHIFT e il biglietto ADMIT ONE.
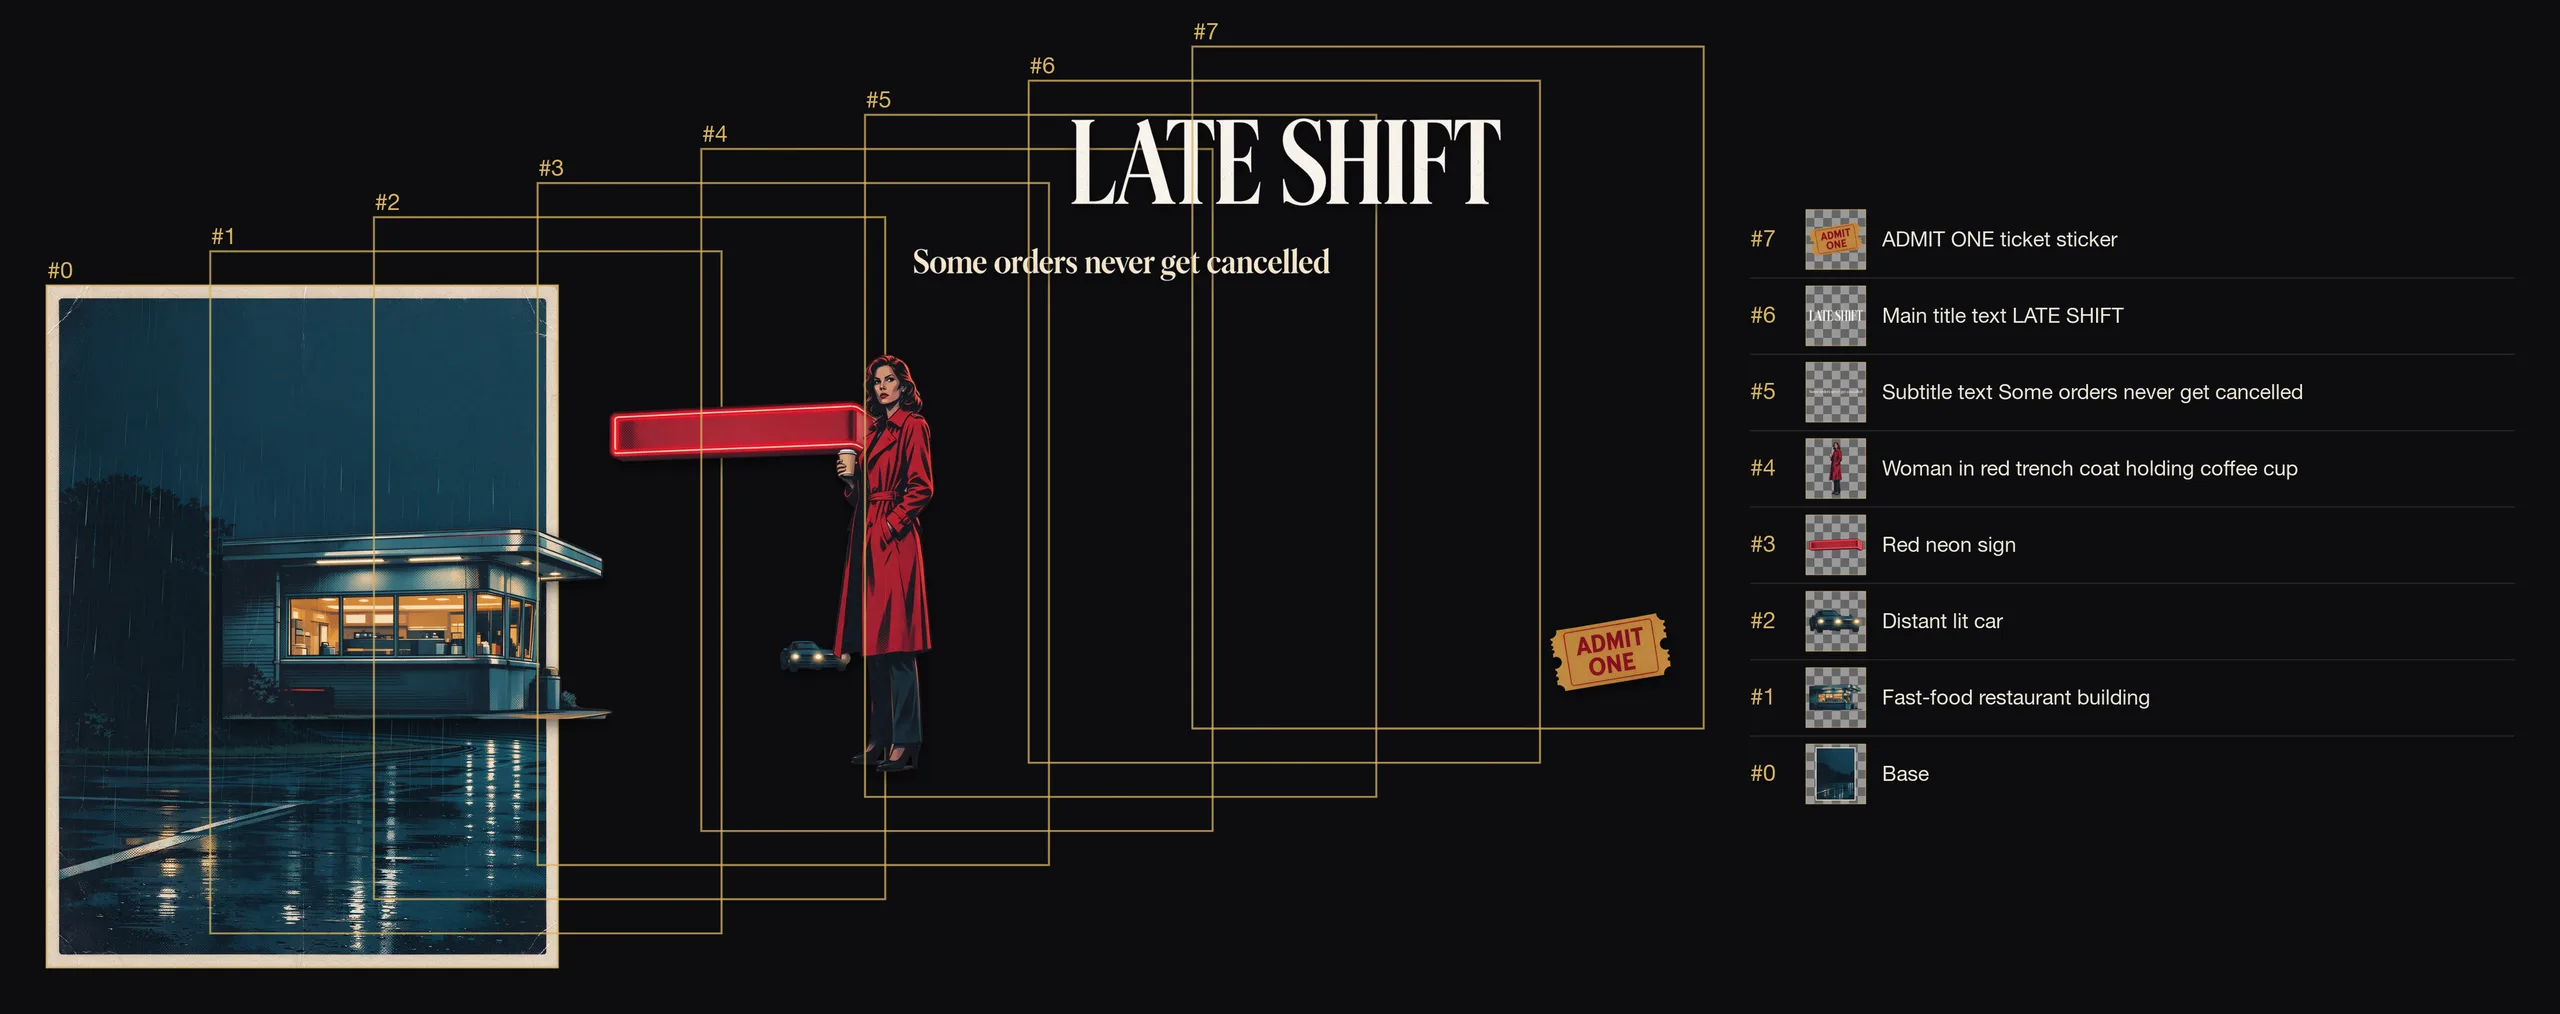
L'immagine di base è una strada piovosa in cui il diner, la donna e tutta la scrittura sono stati rimossi e la strada riempita. Ciò che si trovava dietro un elemento rimosso viene dipinto dal modello, quindi sembra giusto ma non sono i pixel originali.
Due dei livelli di Flash da soli (la scacchiera che vedresti in un editor è solo trasparenza):
Pro, nominando gli elementi
Pro ha ricevuto lo stesso poster, con un prompt che nomina cinque elementi, a 1.5K:
Separate the LATE SHIFT title, the tagline, the woman in the red trench coat,
the diner building and the ADMIT ONE ticket stub into their own layers
Sono tornate sei immagini: l'immagine di base e cinque livelli chiamati Diner building, Tagline text, LATE SHIFT title, Woman in red trench coat e ADMIT ONE ticket stub. Impilandoli in base ai riquadri si ottiene di nuovo il poster originale.
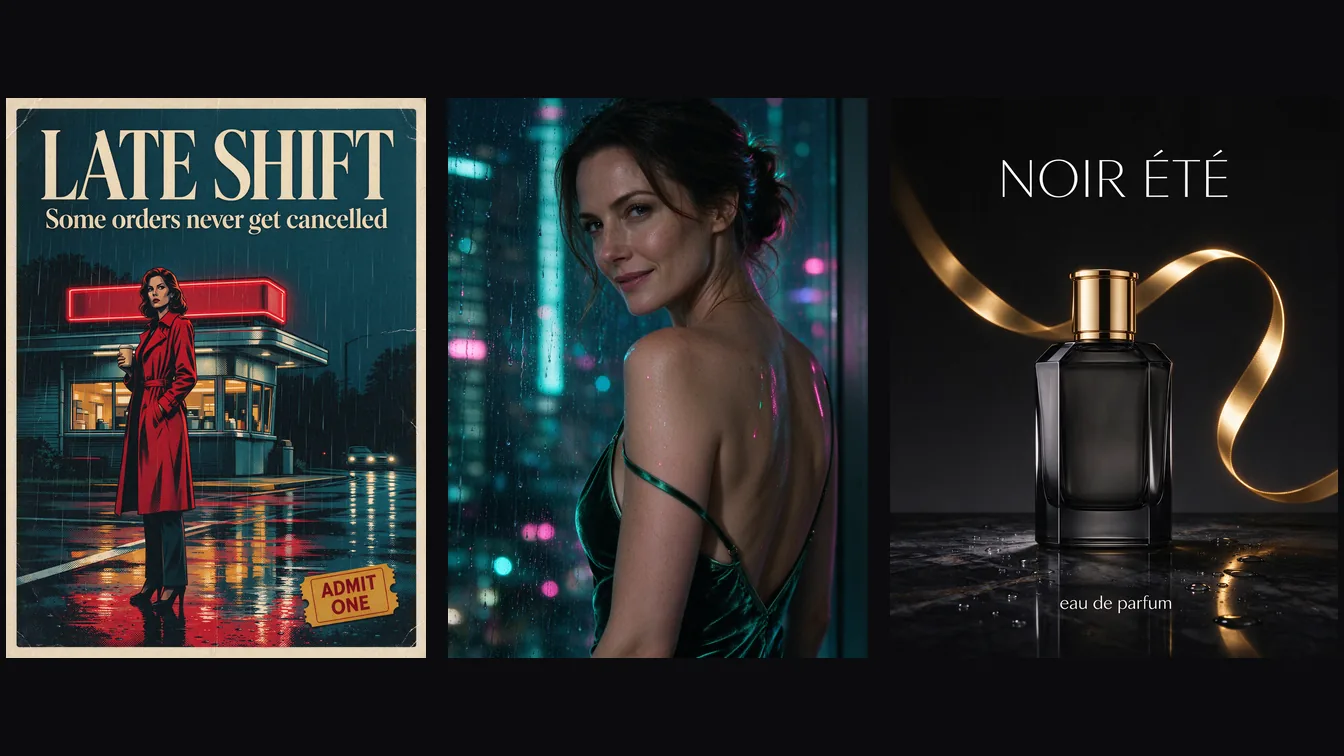
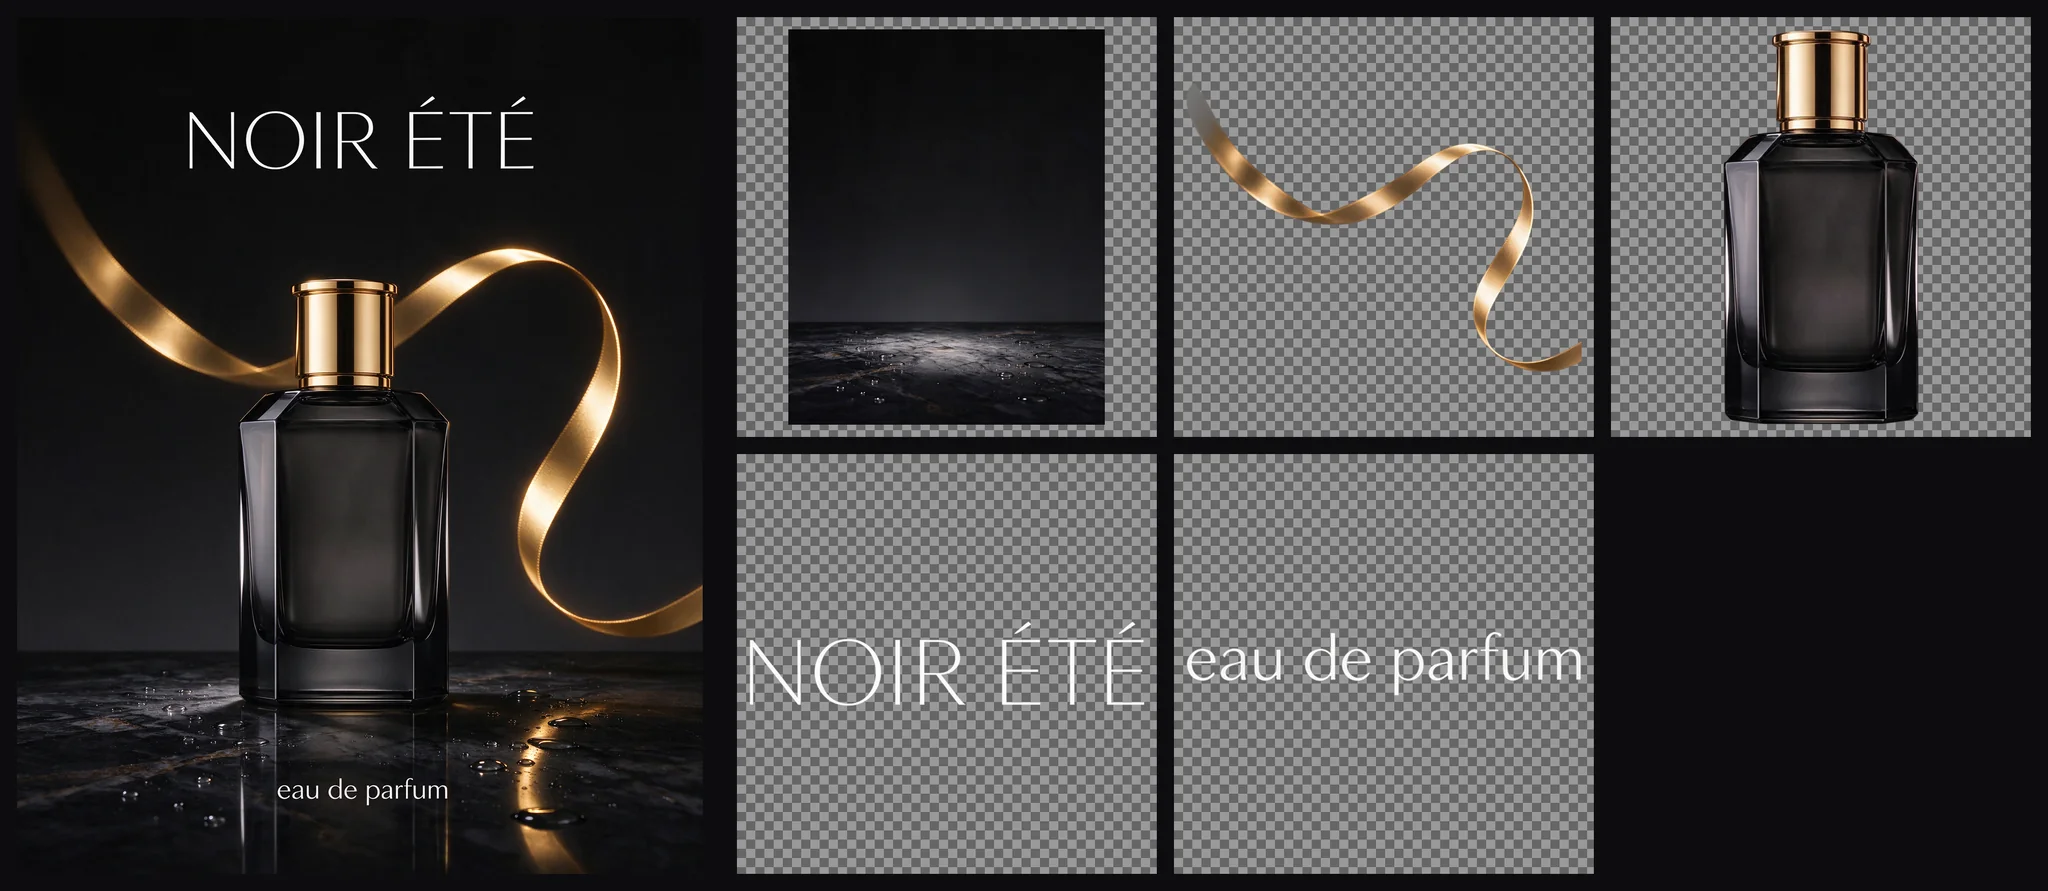
Pro ha gestito anche l'annuncio di profumo che avevamo fatto prima. Abbiamo nominato quattro elementi (il titolo NOIR ÉTÉ, il flacone, il nastro dorato e la piccola riga "eau de parfum") e ottenuto cinque immagini: un basamento vuoto in marmo nero come immagine di base, più i quattro livelli. È una foto di prodotto che puoi rimettere in scena su un nuovo sfondo senza rigenerare nulla.
Flash o Pro?
| Flash | Pro | |
|---|---|---|
| Prezzo per immagine di output | $0.026 a ogni risoluzione | $0.042 (1K, 1.5K), $0.084 (2K e auto) |
resolution predefinita | auto | 1.5k |
| Nomi e riquadri | name e boundingBox su ogni livello | name e boundingBox su ogni livello |
| Stesso poster, divisione automatica | 7 livelli più immagine di base | 8 livelli più immagine di base |
| Immagini di input orientate agli adulti (NSFW, fino a temi intensi) | Accettate | Accettate |
| Una scena intima tra due adulti | Accettata | Rifiutata, non addebitata |
| Prompt | Facoltativo; almeno 3 caratteri se scritto | Facoltativo |
Scegli Flash per impostazione predefinita: è più economico e ha completato tutte le categorie di input adulto testate qui. Scegli Pro quando la divisione di Flash manca un elemento che ti serve e il tuo input non è una scena intima tra due adulti (una versione coperta della stessa scena si divide normalmente). Su Pro un'immagine rifiutata torna come attività fallita con un errore generico e senza addebito; non riprovare la stessa immagine, mandala a Flash. Entrambi forniscono nomi e riquadri, quindi entrambi sono adatti agli stessi lavori:
- modificare il titolo di un poster e rimetterlo al suo posto;
- sostituire solo lo sfondo e tenere un prodotto o una persona;
- trasformare ritagli in adesivi o risorse di design riutilizzabili;
- costruire una scena di parallasse o un rig di animazione da un'unica illustrazione.
Come scrivere un prompt che nomini ciò che vuoi
Senza prompt il modello decide che cosa conta come elemento. Con un prompt separa ciò che elenchi. Due abitudini hanno reso i risultati prevedibili:
- Nomina ogni elemento che ti interessa, con un breve gruppo nominale: "the LATE SHIFT title", "the woman in the red trench coat". Ciò che ometti dipende dal modello, quindi nomina quello che intendi spostare. Se chiedi meno elementi, ottieni meno livelli; il tetto è 16.
- Indica una regione con
<bbox>. Le coordinate sonox1 y1 x2 y2, normalizzate su una griglia da 0 a 1000 con l'origine nell'angolo in alto a sinistra, indipendentemente dalla dimensione dell'immagine:
Separate the title text <bbox>179 58 809 197</bbox> and the parrot
<bbox>330 274 641 991</bbox> into independent layers
Questo risolve il caso in cui due cose si somigliano o si sovrappongono. Su un'immagine 1536×2048, un riquadro da 100 a 900 in orizzontale copre i pixel da 154 a 1382.
Quanto costa
Paghi per ogni immagine restituita, e l'immagine di base conta. Poster e annunci tipici restituiscono da 3 a 11 immagini: da $0.078 a $0.286 su Flash, e un'esecuzione Pro di 6 immagini a 1.5K costa 6 × $0.042 = $0.252. Oltre a questo nulla viene addebitato per livello.
L'importo trattenuto all'accettazione è il prezzo di 17 immagini: $0.442 su Flash, $0.714 su Pro a 1K o 1.5K e $1.428 su Pro a 2K o auto. Viene rilasciato fino al conteggio reale quando l'esecuzione termina. Su Pro imposta resolution su 1k o 1.5k per una divisione che funzioni; auto viene fatturato alla tariffa 2K, quindi una richiesta copiata da un esempio Flash con auto costa il doppio su Pro.
Provalo prima nel Playground
- Apri la pagina di scomposizione in livelli di Flash e resta nella scheda Playground, in vista Form. Accedi con un account con saldo per eseguire.
- Aggiungi il tuo poster o annuncio sotto Input image (un file o un Asset URL).
- Lascia Prompt vuoto perché il modello scelga gli elementi principali, oppure nomina quelli che vuoi spostare, con
<bbox>dove due cose si somigliano. - Lascia Resolution su
autoper Flash, poi esegui il modello. Il risultato si apre come vista a livelli in cui puoi nascondere livelli, scaricare un livello o tutti come zip, o esportare la pila visibile come un unico PNG. Un'immagine generata sul sito può essere inviata direttamente nella scomposizione in livelli. - Se la divisione manca qualcosa, esegui la stessa immagine nella pagina Pro; lì imposta Resolution su
1ko1.5k, perchéautoviene fatturato alla tariffa 2K.
Poi eseguila dal codice
Installa l'SDK Python (pip install spicyapi), imposta SPICY_API_KEY nell'ambiente del tuo server ed esegui:
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="bytedance/seedream-5.0-flash/layer-decomposition",
    input_data={
        "image_url": "https://your-cdn.example/poster.png",
        "prompt": "Separate the LATE SHIFT title, the tagline, the woman in the red trench coat, "
                  "the diner building and the ADMIT ONE ticket stub into their own layers",
        "resolution": "auto",
        "output_format": "png",
    },
    idempotency_key=str(uuid.uuid4()),
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])  # a run takes about 45 to 100 seconds
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
assets = output_assets(final)  # assets[0] is the base plate; copy the files to your own storage now
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
Per Pro usa bytedance/seedream-5.0-pro/layer-decomposition con "resolution": "1.5k". Tieni l'immagine di origine sotto 10 MB. Creazione, attesa, download, nuovi tentativi e il corpo del callback sono nella guida alle attività e nel riferimento dell'SDK Python.
Oppure fai eseguire a un Agent
Quando un assistente deve eseguire la divisione, tutti e tre gli strumenti ufficiali mostrano il prezzo e chiedono conferma prima di una chiamata a pagamento.
- CLI. Metti lo stesso oggetto
inputininput.json, poi:
``bash spicyapi tasks create --model bytedance/seedream-5.0-flash/layer-decomposition --input-file input.json --wait ``
Vedi la documentazione della CLI; npx @spicyapi/cli funziona senza installazione.
- Server MCP. Aggiungi il server MCP al tuo assistente, poi chiedi: "Split this poster into layers with Seedream 5.0 Flash and name the title, the tagline and the woman." Chiama
spicyapi_task_create, che si ferma per la tua conferma del prezzo, poispicyapi_task_wait. - Skill.
npx skills add spicyapi-ai/spicy-skillinstalla l'Agent Skill, che fa leggere a un assistente di programmazione lo schema del modello in tempo reale invece di indovinare i campi.
Rimetti i livelli al loro posto
Un livello PNG di solito ha una risoluzione più alta del riquadro che occupa (per esempio un riquadro 671×139 con un PNG 1233×256), quindi ridimensiona ogni livello dentro il suo riquadro, poi disegnali dal zIndex più basso al più alto. Funziona con l'output sia di Flash sia di Pro.
Python con Pillow:
import io
import requests
from PIL import Image

def fetch(url):
    return Image.open(io.BytesIO(requests.get(url, timeout=60).content)).convert("RGBA")

assets = output_assets(final)                      # from the finished task above
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
canvas = fetch(assets[0]["url"])                   # base plate, zIndex 0

for a in sorted(assets[1:], key=lambda a: a["layer"]["zIndex"]):
    box = a["layer"].get("boundingBox")
    if not box:
        continue                                   # no position: place this one by hand
    x1, y1, x2, y2 = [round(v) for v in box]
    layer = fetch(a["url"]).resize((x2 - x1, y2 - y1), Image.LANCZOS)
    canvas.paste(layer, (x1, y1), layer)           # alpha-aware paste

canvas.convert("RGB").save("recomposed.jpg", quality=95)
La stessa cosa nel browser con canvas:
async function load(url) {
  const img = new Image();
  img.crossOrigin = "anonymous";
  img.src = url;
  await img.decode();
  return img;
}

const assets = task.data.output.assets;           // task: the finished task's JSON
const base = await load(assets[0].url);
const canvas = document.createElement("canvas");
canvas.width = base.naturalWidth;
canvas.height = base.naturalHeight;
const ctx = canvas.getContext("2d");
ctx.drawImage(base, 0, 0);

const layers = assets.slice(1).sort((a, b) => a.layer.zIndex - b.layer.zIndex);
for (const a of layers) {
  const box = a.layer.boundingBox;
  if (!box) continue;                              // no position: place this one by hand
  const [x1, y1, x2, y2] = box;
  ctx.drawImage(await load(a.url), x1, y1, x2 - x1, y2 - y1);
}
Per sostituire il titolo del poster, lascia fuori quel livello dal ciclo, disegna il tuo testo nello stesso riquadro e tieni il resto. Per cambiare solo lo sfondo, sostituisci assets[0] con una tua immagine della stessa dimensione.
Altri modi per dividere un'immagine in livelli
La maggior parte delle pagine che si posiziona per questa ricerca sono strumenti browser con prezzo a crediti e senza API. La principale alternativa open source è Qwen-Image-Layered (Apache 2.0, 20B parametri), che puoi ospitare autonomamente su una GPU o chiamare tramite fal a $0.05 per immagine di output (un'esecuzione predefinita a 4 livelli costa circa $0.20 se ogni livello viene addebitato). Lì imposti il numero di livelli (4 per impostazione predefinita) e ottieni immagini trasparenti a piena tela, senza nomi né posizioni, e il controllo di sicurezza di fal è attivo per impostazione predefinita e restituisce immagini nere per gli input segnalati. Sceglilo quando ti serve un numero di livelli fisso o il tuo hosting. Scegli la scomposizione in livelli di Seedream quando vuoi livelli ritagliati con un nome e una posizione ciascuno, un prompt che nomina gli elementi e immagini di input adulte accettate; a $0.026 per immagine su Flash è anche più economica per immagine.
FAQ
Quanti livelli otterrò?
Tanti quanti ne trova il modello, fino a 16 più l'immagine di base. Non puoi impostare un numero. Nomina gli elementi per controllare il conteggio e, se ne manca uno, nominalo (o dagli il suo <bbox>) ed esegui di nuovo; un rieseguimento viene fatturato come una nuova esecuzione.
Posso dividere un'immagine non creata da SpicyAPI?
Sì, qualsiasi singola immagine entro i limiti della pagina del modello. Per ottenere materiale da poster che si divide in modo pulito, inizia da Seedream 5.0 Flash da testo a immagine.
I risultati sono riproducibili?
No. Non c'è un seed, quindi esegui la divisione una volta, conserva i file e modifica quelli.
Da dove proseguire
Prova un poster che ti piace già con la scomposizione in livelli di Flash; se la sua divisione manca qualcosa, fai passare la stessa immagine da Pro.