Introducción
Crea un MP4 enviando un retrato y una grabación a la tarea talking-avatar. El texto opcional dirige la interpretación visible; resolution permite elegir el nivel de salida y seed facilita comparaciones.
| Campo | Valor |
|---|---|
| Entrada | Imagen y Audio |
| Salida | Video |
| Selección del modelo | ByteDance OmniHuman 1.5; talking-avatar |
| Imagen obligatoria | JPEG / PNG / WebP, hasta 30 MB |
| Audio obligatorio | MP3 / WAV, hasta 15 MB; 1–60 segundos |
| Límite de instrucción | 2.000 caracteres; dirección visual opcional |
| Resolución predeterminada y opciones | 1080p por defecto; también admite 720p; tarifas iguales |
| Valores de semilla | 0–2147483647; ayuda opcional para comparar |
| Cobro por audio | Redondeo hacia arriba a segundos enteros del audio de entrada |
| Finalización y formato | Identificador de tarea, consultas o notificación; MP4 |
| Período de almacenamiento | 14 días antes de eliminar los archivos generados |
Funciones y aspectos destacados
Una palma hacia arriba acompaña la frase
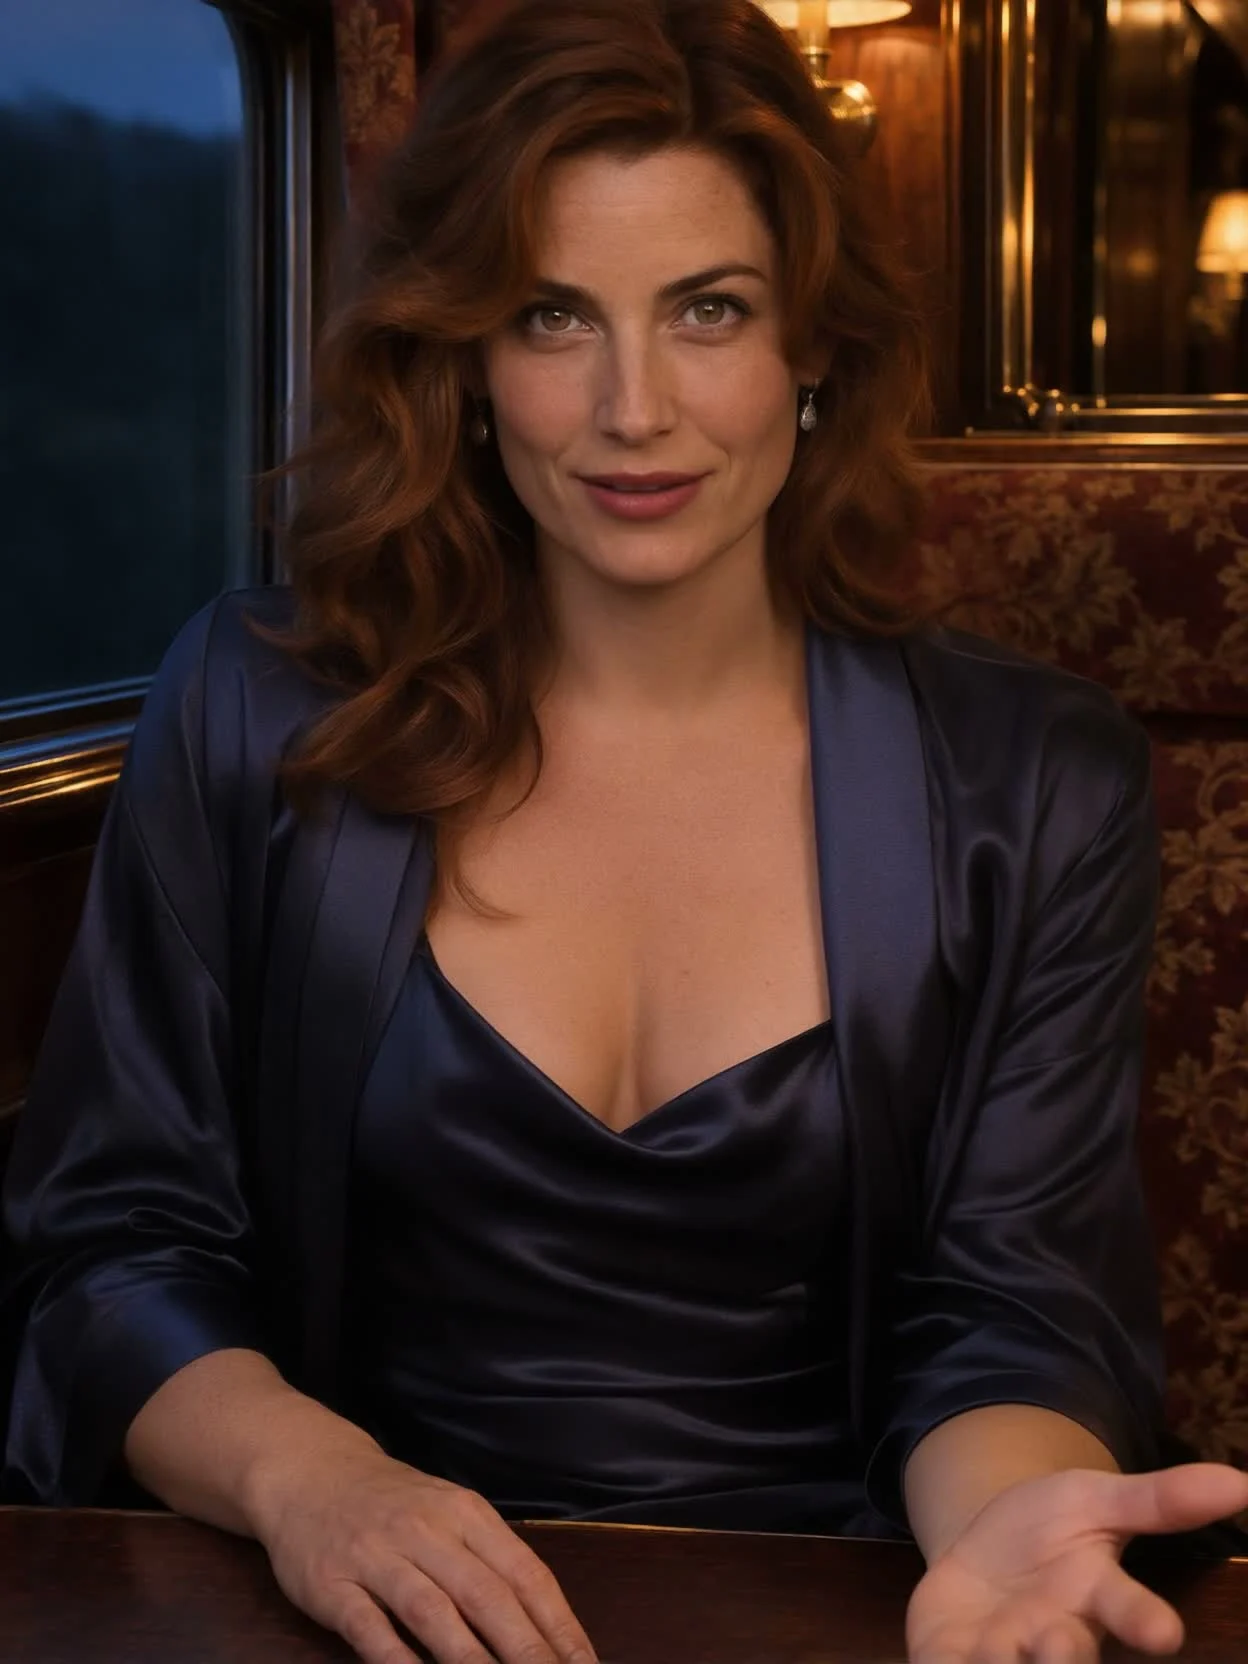
En la prueba del tren nocturno, el retrato fijo se convirtió en una interpretación hablada: ella levantó una mano con la palma hacia arriba, asintió y sonrió. La solicitud en 1080p combinó una grabación de 6,35 segundos con indicaciones escritas de movimiento.
El retrato regresó con encuadre 3:4
El retrato del tren de 1024×1536 produjo un video de 1248×1664 a 25 fps que mostraba a la hablante de la cintura hacia arriba. Aunque la instrucción pedía cámara fija, el encuadre cambió; revisa el resultado antes de colocarlo en un montaje.
Separa las palabras de su expresión visual
El archivo de audio aporta la voz y el diálogo reales. ByteDance afirma que una instrucción puede orientar gestos, ánimo y movimiento de cámara mientras la grabación guía la interpretación; este endpoint no clona la voz del hablante.
La resolución es una decisión de imagen
El endpoint usa 1080p por defecto y también acepta 720p. Ambos tienen el mismo precio por segundo, calculado a partir de la grabación de entrada y redondeado hacia arriba, sin tomar la duración final del video.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
image_url | Sí | Obligatorio para talking-avatar: JPEG, PNG o WebP de hasta 30 MB, con rostro frontal claro. Incluye torso y manos para gestos. mínimo 1 caracteres |
audio_url | Sí | Obligatorio para talking-avatar: MP3 o WAV de hasta 15 MB y 1–60 segundos, con habla o canto. Sin valor predeterminado; su duración se redondea hacia arriba para el cobro. mínimo 1 caracteres |
prompt | No | Dirección opcional de talking-avatar para acción, expresión, escena y cámara, con un límite de 2.000 caracteres. mínimo 1 caracteres · máximo 2000 caracteres |
resolution | No | En talking-avatar, elige 720p o 1080p; al omitir el campo se usa 1080p. Los dos niveles tienen igual tarifa y las dimensiones medidas varían con la composición generada. |
seed | No | Entero opcional de talking-avatar de 0 a 2147483647; no se especifica valor predeterminado. |
Precios
$0.144 / segundo
El cargo cuenta la duración del audio de entrada, redondeada hacia arriba a segundos enteros, para grabaciones de 1–60 segundos. 720p y 1080p comparten tarifa; la imagen, el texto de prompt y seed no la modifican.
Casos de uso
Escenifica una invitación breve de un personaje
Usa un retrato con espacio para las manos y una invitación grabada. El ejemplo del tren nocturno muestra una palma levantada, un asentimiento y una sonrisa que acompañan la voz enviada.
Graba una explicación de un presentador
Combina un retrato autorizado de presentador con una explicación terminada y pide un pequeño asentimiento o gesto de mano abierta. Mantén el rostro claro y revisa el movimiento en las palabras importantes.
Anima un retrato que canta
Envía una grabación cantada en vez de voz hablada para la misma tarea con foto. ByteDance incluye el canto entre los usos admitidos; las ejecuciones documentadas aquí utilizaron frases habladas.
Prueba distintas indicaciones de actuación
Mantén el retrato y la grabación mientras cambias una señal de expresión o movimiento. Reutiliza una semilla para facilitar la comparación y evalúa cada video sin esperar cuadros idénticos.
Prepara un retrato para un montaje vertical
Los dos resultados medidos conservaron composiciones verticales, con dimensiones distintas a las imágenes de origen. Revisa el recorte y el espacio visible para gestos antes de ajustar el clip a tu diseño.
Guía de prompts y consejos prácticos
Valida ambos archivos multimedia
Comprueba el formato y el límite de 30 MB del retrato y verifica audio MP3 o WAV de hasta 15 MB y 1–60 segundos. Confirma el derecho a usar la imagen de la persona y la voz enviada.
Envía las entradas de la tarea de retrato
Usa bytedance/omnihuman-1.5/talking-avatar con
image_urlyaudio_url. Añade dirección de interpretación o una semilla si hace falta y selecciona 720p o el 1080p predeterminado.Compara sonido, gesto y encuadre
Sigue la finalización con el identificador, recupera el MP4 y compáralo con la grabación original y las acciones solicitadas. Guarda el archivo antes de que termine la conservación a los 14 días.
Animación de retratos con movimiento dirigido
OmniHuman 1.5 de ByteDance convierte un retrato y voz o canto grabados en un MP4. ByteDance afirma que expresión, gestos y movimiento corporal responden a la emoción y el significado del audio. Una instrucción textual opcional añade dirección para acciones visibles, expresiones, escena y comportamiento de cámara.
Usa bytedance/omnihuman-1.5/talking-avatar en este proceso con foto. La grabación proporciona voz y palabras; el endpoint no clona voces ni lee un guion de diálogo desde la instrucción. Prepara todo el audio antes de solicitar el video.
Campos de la solicitud
| Campo | Requisito y valor admitido | Valor predeterminado y efecto en el cobro |
|---|---|---|
image_url | Retrato obligatorio; JPEG, PNG o WebP de hasta 30 MB. Prioriza un rostro frontal claro. | Sin imagen predeterminada; se cobra por el audio. |
audio_url | MP3 o WAV obligatorio, de hasta 15 MB y 1–60 segundos. Acepta habla y canto. | Sin grabación predeterminada; se redondea hacia arriba a segundos enteros facturables. |
prompt | Dirección opcional de hasta 2.000 caracteres para movimiento, expresión, escena o cámara. | No se especifica texto predeterminado; añadir indicaciones no cambia la tarifa. |
resolution | 720p o 1080p, opcional. | 1080p al omitirlo; ambas opciones comparten tarifa. |
seed | Entero opcional de 0 a 2147483647 para comparar. | Sin valor predeterminado especificado; no afecta el precio. |
Los cinco campos se aplican a la tarea talking-avatar. Un retrato que incluya torso y manos deja espacio para los gestos pedidos. No hay campo independiente de relación de aspecto entre estos controles; revisa la composición recibida sin suponer un recorte exacto.
Prepara el retrato, la grabación y las indicaciones
Elige el área visible de interpretación
Selecciona un retrato nítido con el rostro orientado al espectador. Incluye las manos si importa una invitación con palma hacia arriba u otro gesto. Verifica por separado los permisos de imagen y voz: toda persona mostrada debe ser adulta y el resultado no debe suplantar a nadie.
Respeta los formatos y tamaños máximos del retrato. Adapta las indicaciones a la imagen para que resulte clara la acción a evaluar: asentir, abrir una palma o sonreír al final de la frase. Revisa el encuadre generado además del movimiento.
Termina el sonido antes de la instrucción textual
Escucha el MP3 o WAV completo y mide su duración. ByteDance recomienda grabaciones de 15 segundos o menos para cuidar la calidad, aunque el rango admitido llega a 60 segundos. El audio determina la duración prevista y la cantidad facturable; elimina los tramos que no quieras usar.
Escribe las indicaciones de interpretación en prompt y deja el diálogo en audio_url. ByteDance enumera chino, inglés, japonés, coreano, español e indonesio para el texto de instrucciones. Son idiomas de dirección escrita, no una lista medida de idiomas hablados probados aquí.
Para una comparación controlada, reutiliza una semilla al revisar una sola indicación y deja iguales las demás entradas. Ayuda a aislar un cambio, sin garantizar videos coincidentes en solicitudes repetidas.
Calcula el cargo por duración del audio
El cobro cuenta los segundos del audio de entrada y redondea hacia arriba al siguiente entero dentro del rango de 1–60 segundos. Seleccionar 720p en vez del 1080p predeterminado no reduce la tarifa. Ni el retrato ni las opciones prompt y seed alteran esa regla por audio. Consulta la ficha de OmniHuman 1.5 para ver el precio vigente.
El ejemplo del tren nocturno utilizó 6,35 segundos de audio, equivalentes a 7 segundos facturables. El video recibido midió 6,44 segundos; el cobro siguió usando la grabación enviada y no la duración renderizada. Distingue esas medidas al revisar una solicitud.
Gestos y encuadre observados
El ejemplo sleeper-train-stay combinó un retrato de 1024×1536 de una mujer de cabello castaño rojizo con ropa de seda azul marino en un compartimiento de tren y una invitación breve. La solicitud seleccionó 1080p y pidió sonrisa, movimiento de mano de invitación, palmas abiertas y asentimiento, manteniendo la cámara estable.
En las pruebas, levantó una mano con la palma hacia arriba, asintió, sonrió y habló en sincronía con la grabación. El resultado midió 1248×1664 a 25 fps y duró 6,44 segundos. La imagen pasó a una composición 3:4 que la mostraba de la cintura hacia arriba. La observación confirma la mano levantada y el asentimiento; no demuestra cumplimiento exacto de cada acción o restricción de encuadre.
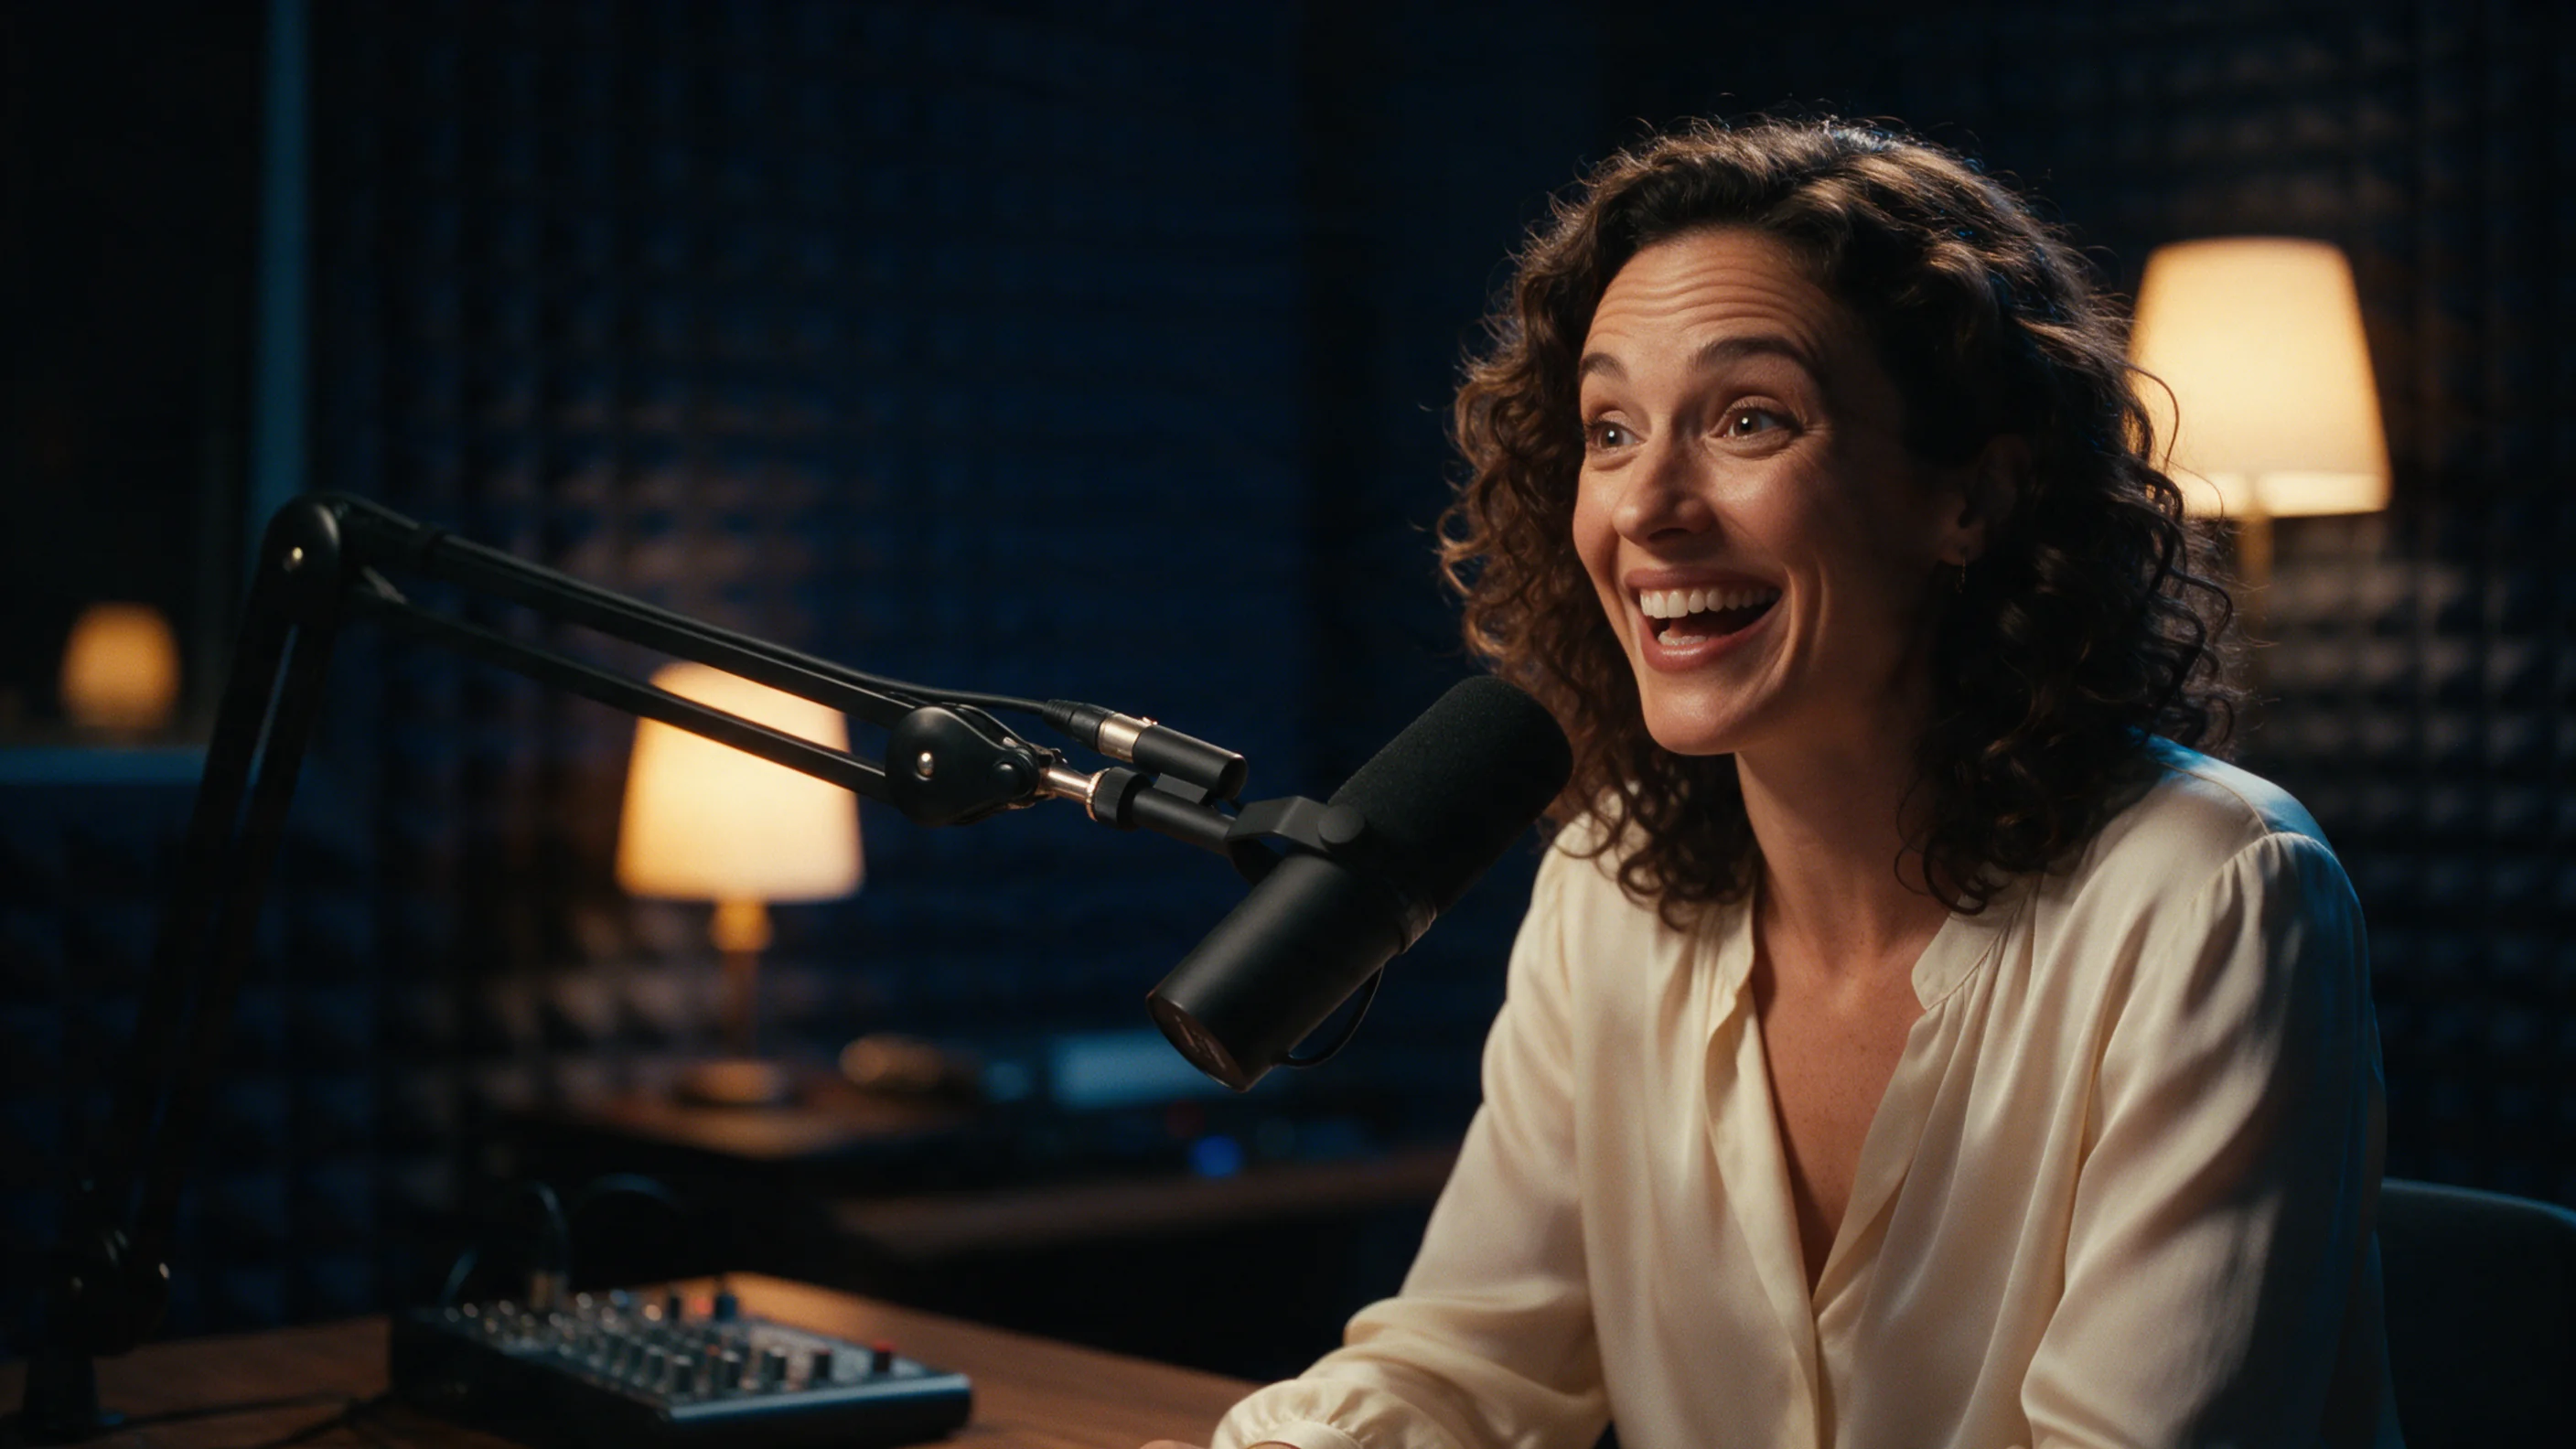
Otra ejecución en 720p combinó un retrato de 832×1248 con 4,55 segundos de voz. El resultado midió 832×1120 a 25 fps y 4,52 segundos, manteniendo una composición vertical. Estas dimensiones corresponden a dos resultados medidos, no a dimensiones fijas prometidas por cada etiqueta de resolución.
Envía, recupera y conserva
Las tareas se ejecutan de forma asíncrona: el envío devuelve un identificador y las consultas o una notificación aportan información de finalización. Recupera el MP4 al terminar y observa manos, rostro, encuadre y momento final junto a la grabación original.
El almacenamiento termina a los 14 días, cuando se eliminan los archivos generados. Descarga el clip aceptado durante ese plazo y guarda sus ajustes de entrada si vas a retomar la interpretación.
Para otra opción de OmniHuman, consulta OmniHuman 2.0. InfiniteTalk y VEED Fabric 1.0 también ofrecen animación de retratos. Revisa sus entradas y límites antes de elegir; las ejecuciones de OmniHuman 1.5 no establecen una clasificación de calidad ni tiempo de procesamiento frente a ellas.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-1.5/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "resolution": "1080p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.