
El text-to-image de Wan 2.7 de Alibaba usa una pasada de razonamiento para planificar la composición antes de dibujar. Devuelve de una a cuatro imágenes por solicitud de cerca de 1 megapíxel en siete proporciones, con semilla para comparar de forma estable.
El filtrado cambia según el endpoint: Edición de imagen — Sin censura, Texto a imagen — Suavizado.
Playground
Estos ejemplos se escribieron para este endpoint. Cambia el prompt y las URL de ejemplo por archivos tuyos accesibles y, antes de enviar, revisa la estimación al día y la disponibilidad del modelo.
 Salida
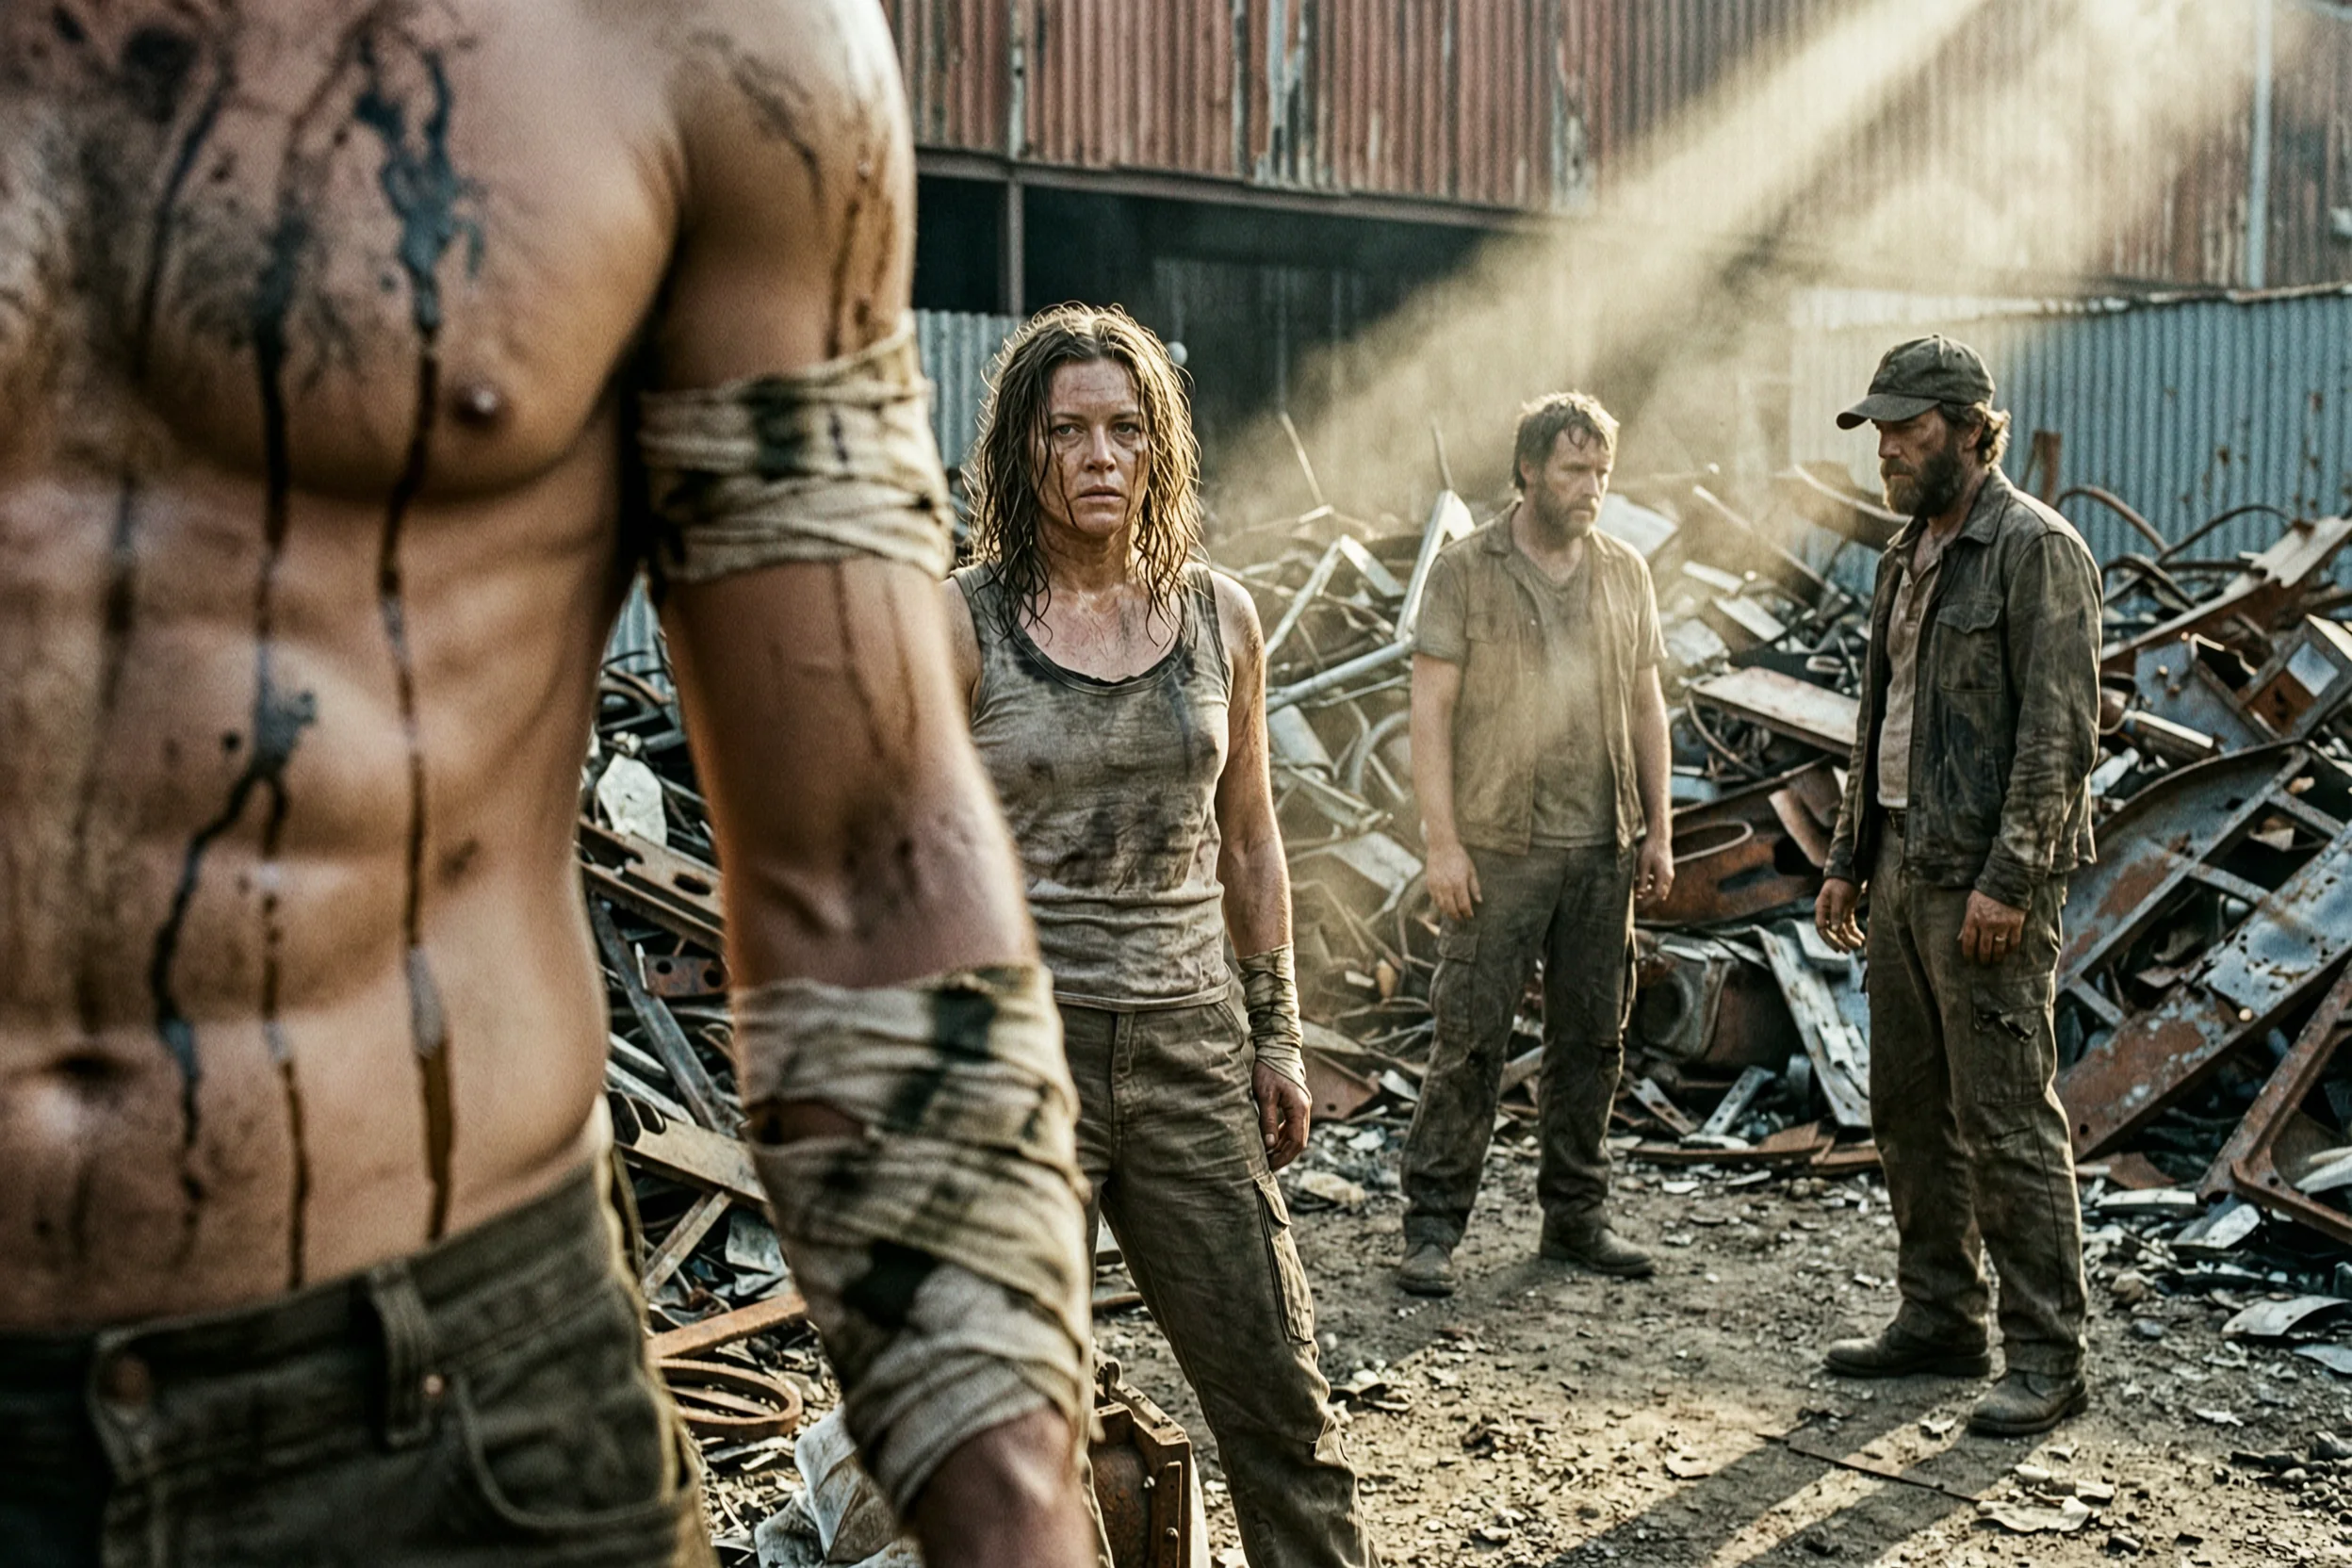
wasteland-three-depths Construido para la pasada de planificación que este endpoint ejecuta antes de dibujar: tres figuras ubicadas en tres planos de profundidad distintos, el foco sostenido sobre la del medio y un haz diagonal cruzando las tres. La puesta en profundidad es lo que se arruina cuando una composición se arma con avidez desde el primer plano hacia adentro: terminan tres sujetos a la misma distancia. `resolution` es `2k` y `aspect_ratio` es `3:2`, lo bastante ancho para que los planos se separen también lateralmente.
- 2k
- 3:2
 Salida
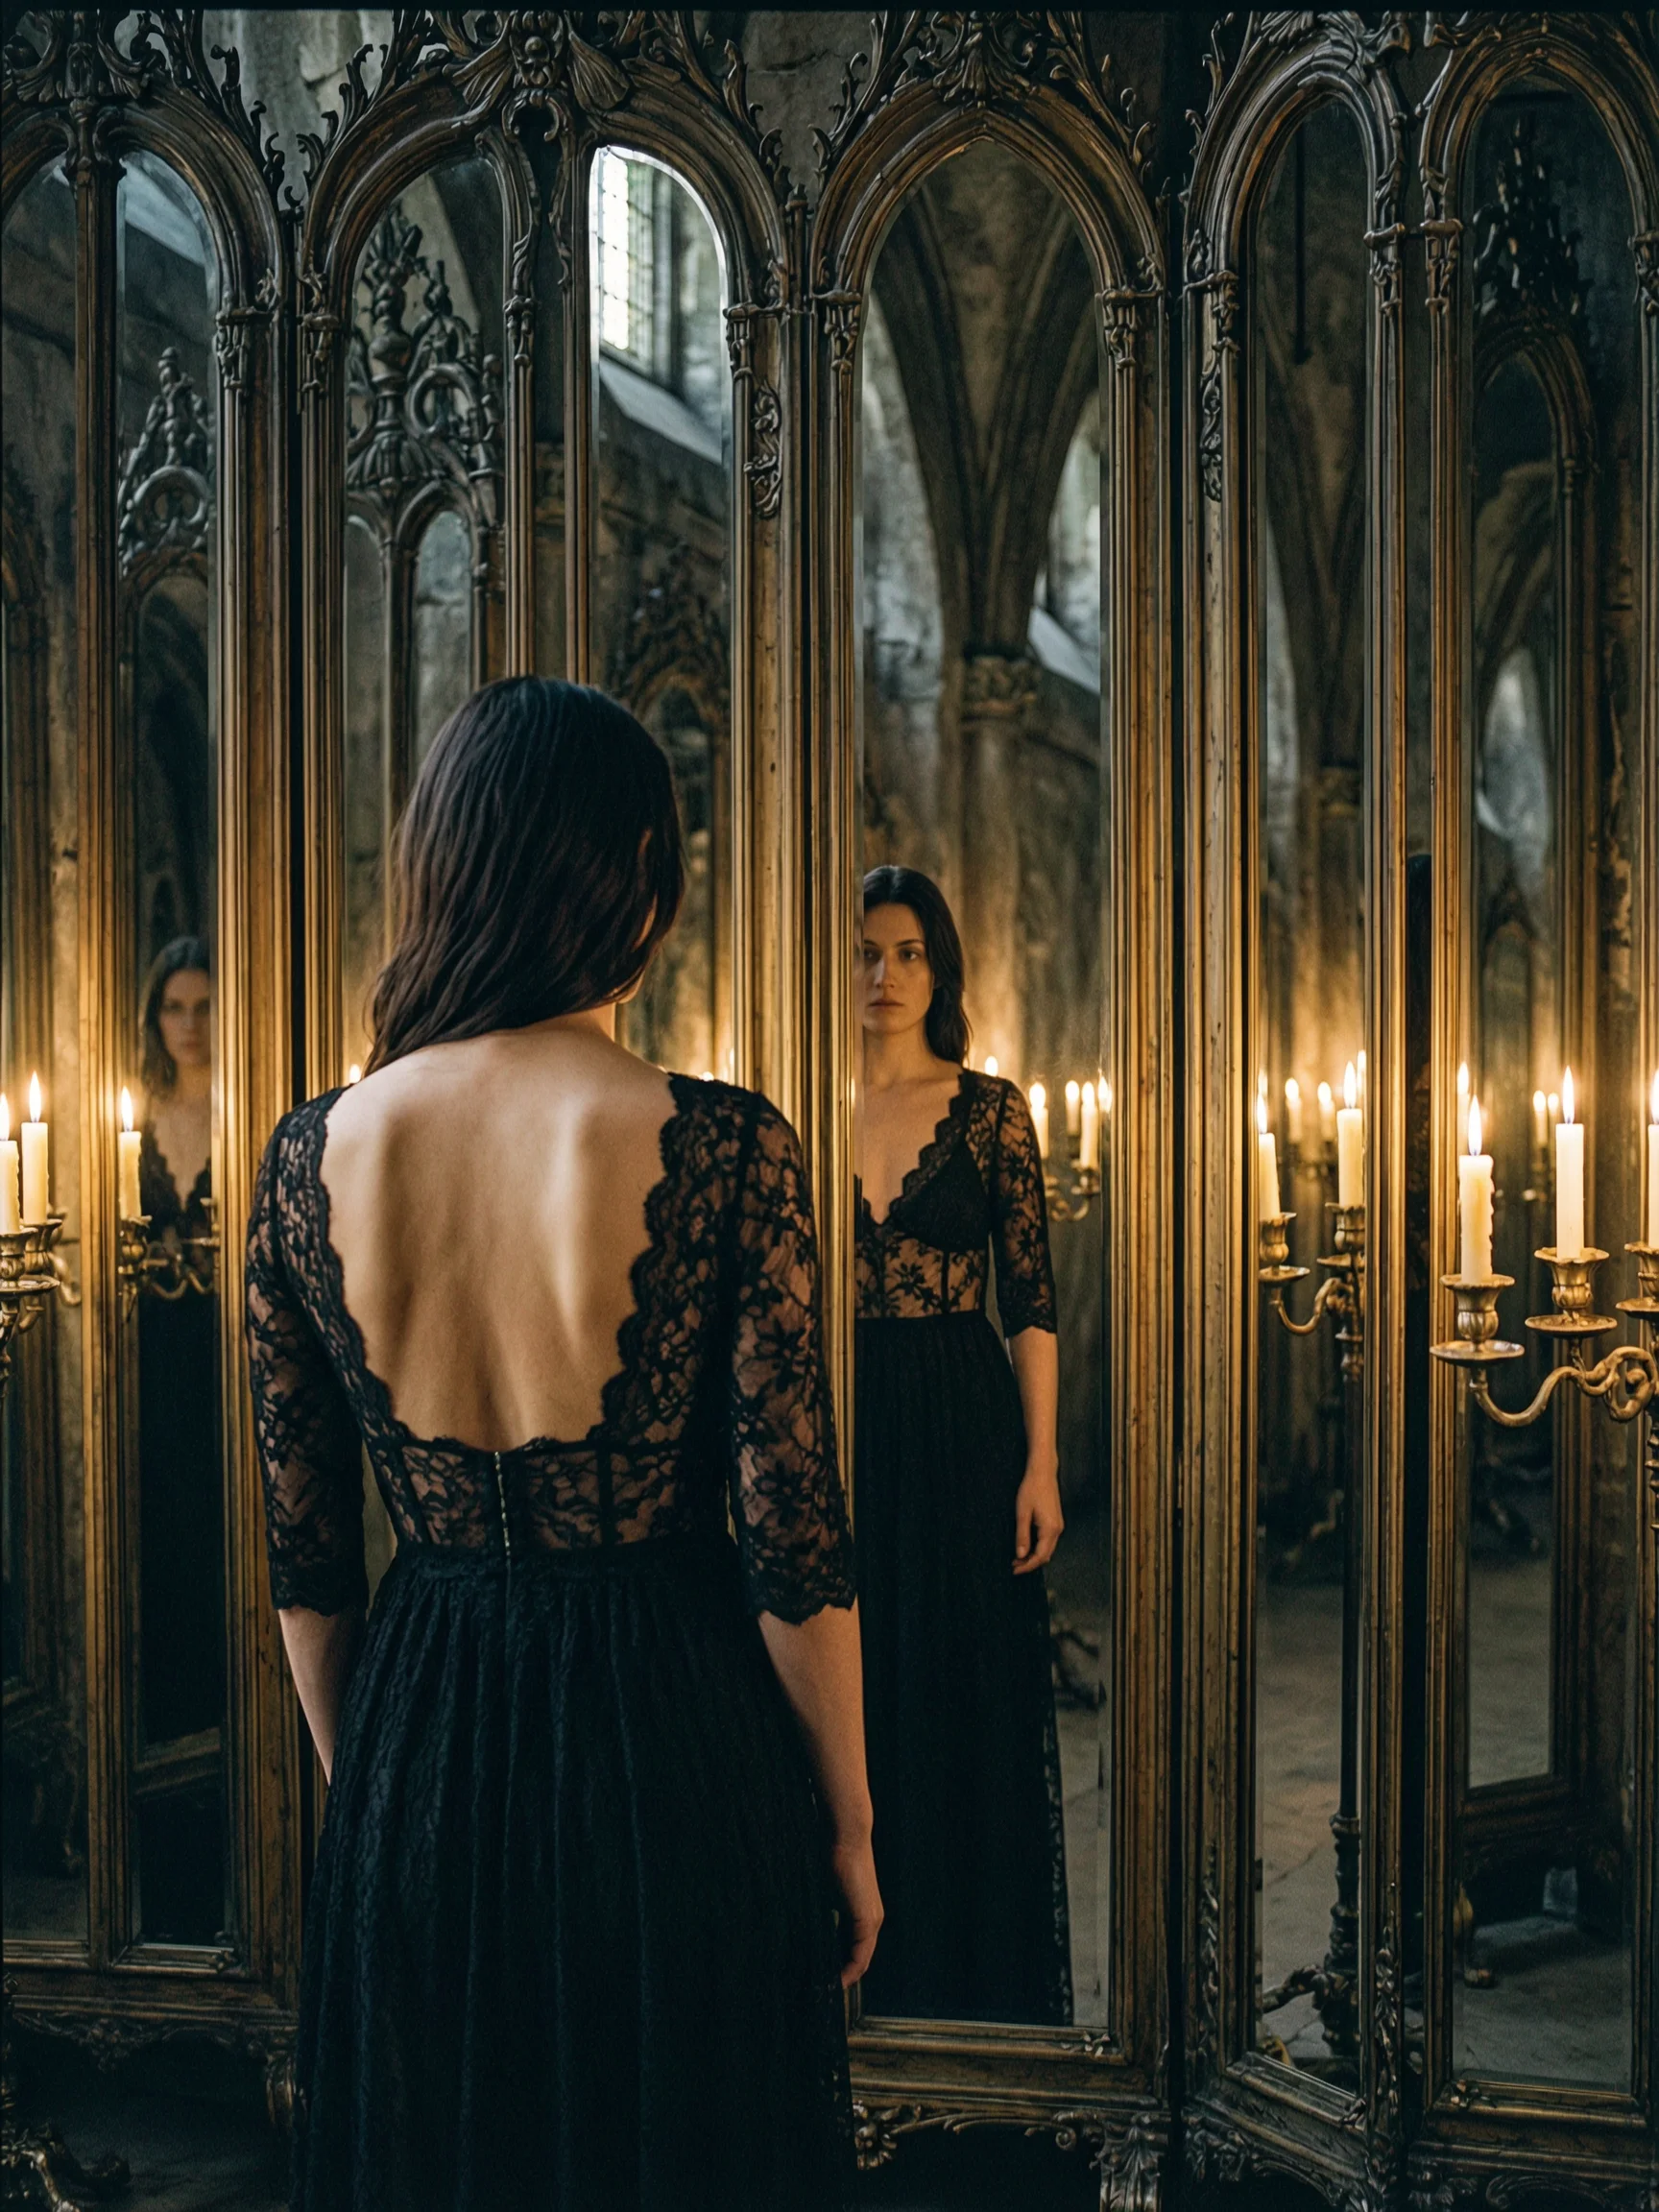
mirror-maze-second-figure Un rompecabezas de reflejos antes que de iluminación: una hilera de espejos en la que la segunda figura debe aparecer solo en el tercer reflejo, con la luz de las velas desplazada de manera distinta en cada hoja. Esa es una restricción que el modelo tiene que sostener en todo el cuadro a la vez, y para eso sirve la pasada de planificación. `resolution` es `2k` y `aspect_ratio` es `3:4` para que la hilera de espejos se aleje en vertical. Cuente las hojas antes de juzgar el resultado.
- 2k
- 3:4
 Salida
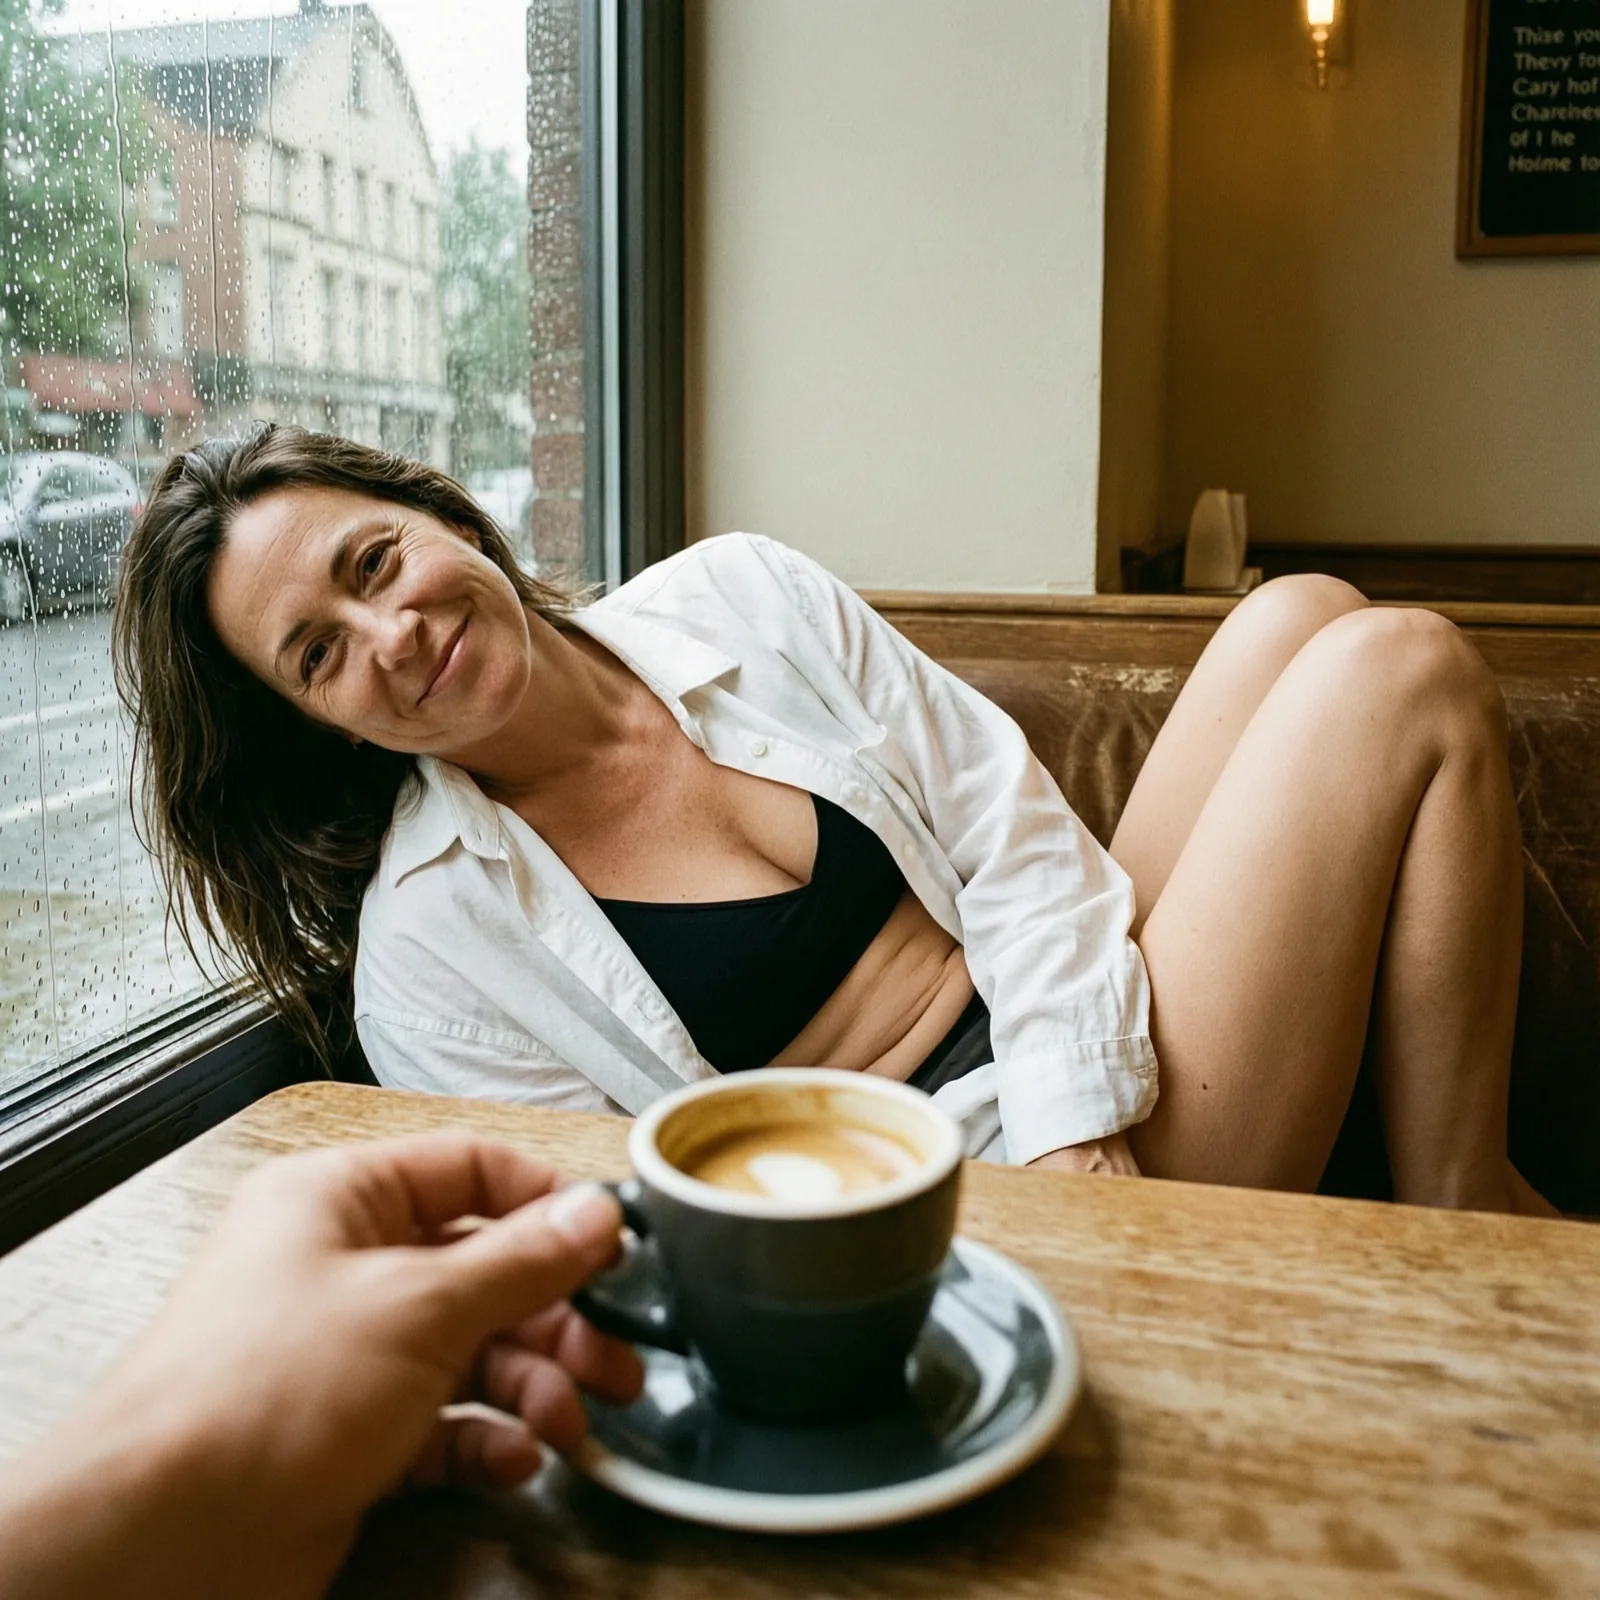
cafe-pov La solicitud exacta detrás de la imagen de esta página: un prompt sencillo en 1:1, sin referencia y sin marca de contenido que activar. Es más o menos hasta donde llega el texto solo.
- 1:1
 Salida
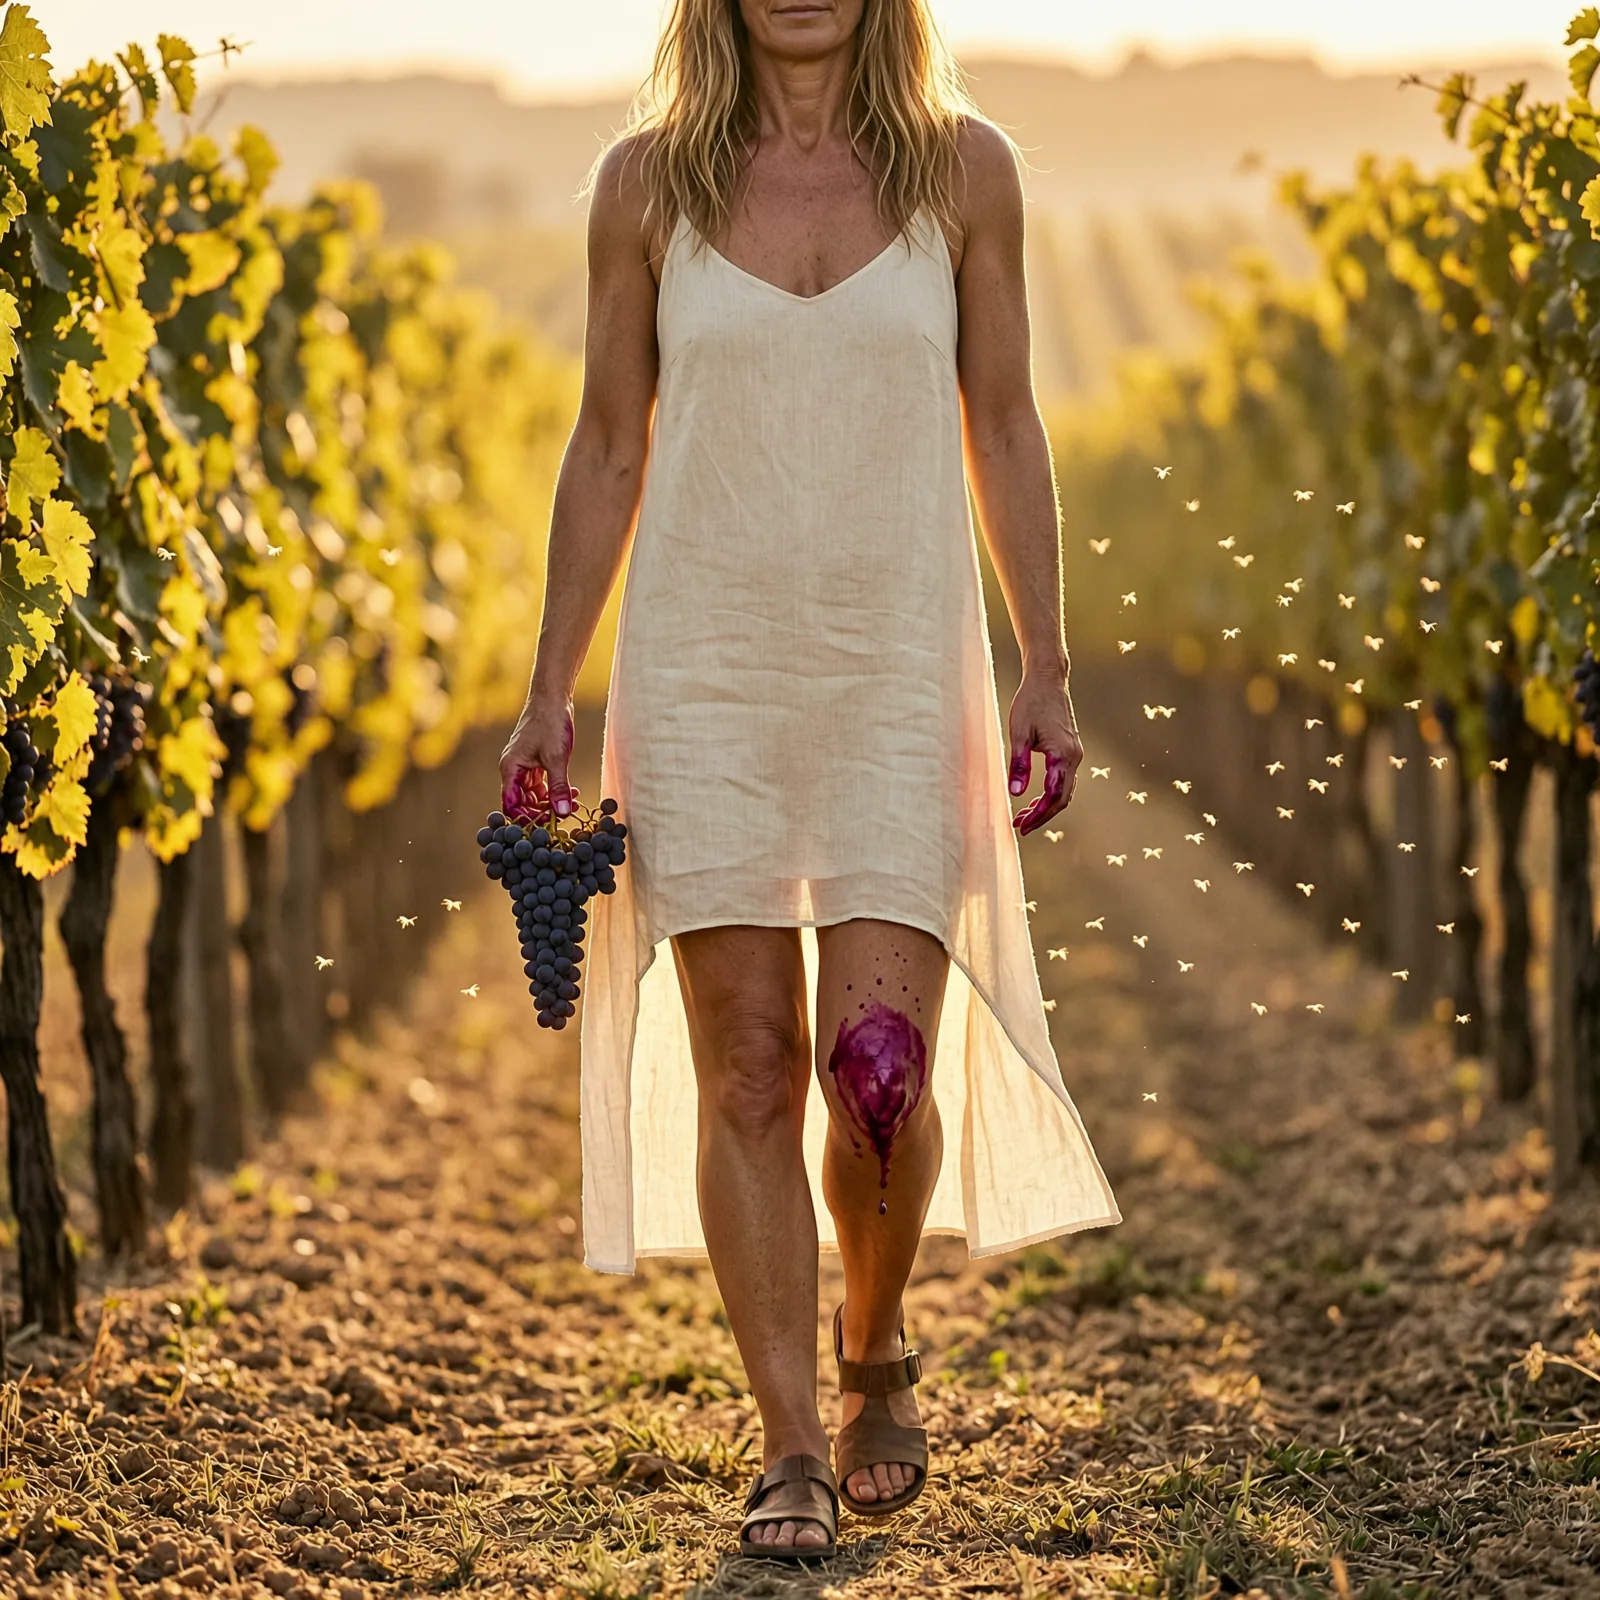
vineyard-backlit Los otros dos encuadres de esta página son interiores nocturnos vistos desde el propio asiento del espectador; este sale al exterior, con un 200 mm en la hora dorada y el sol detrás del sujeto, de modo que la luz atraviesa un lino fino y la silueta se lee a través de la tela. El contraluz a través de un tejido exige mucho más que una lámpara en una habitación.
- 1:1
 Salida
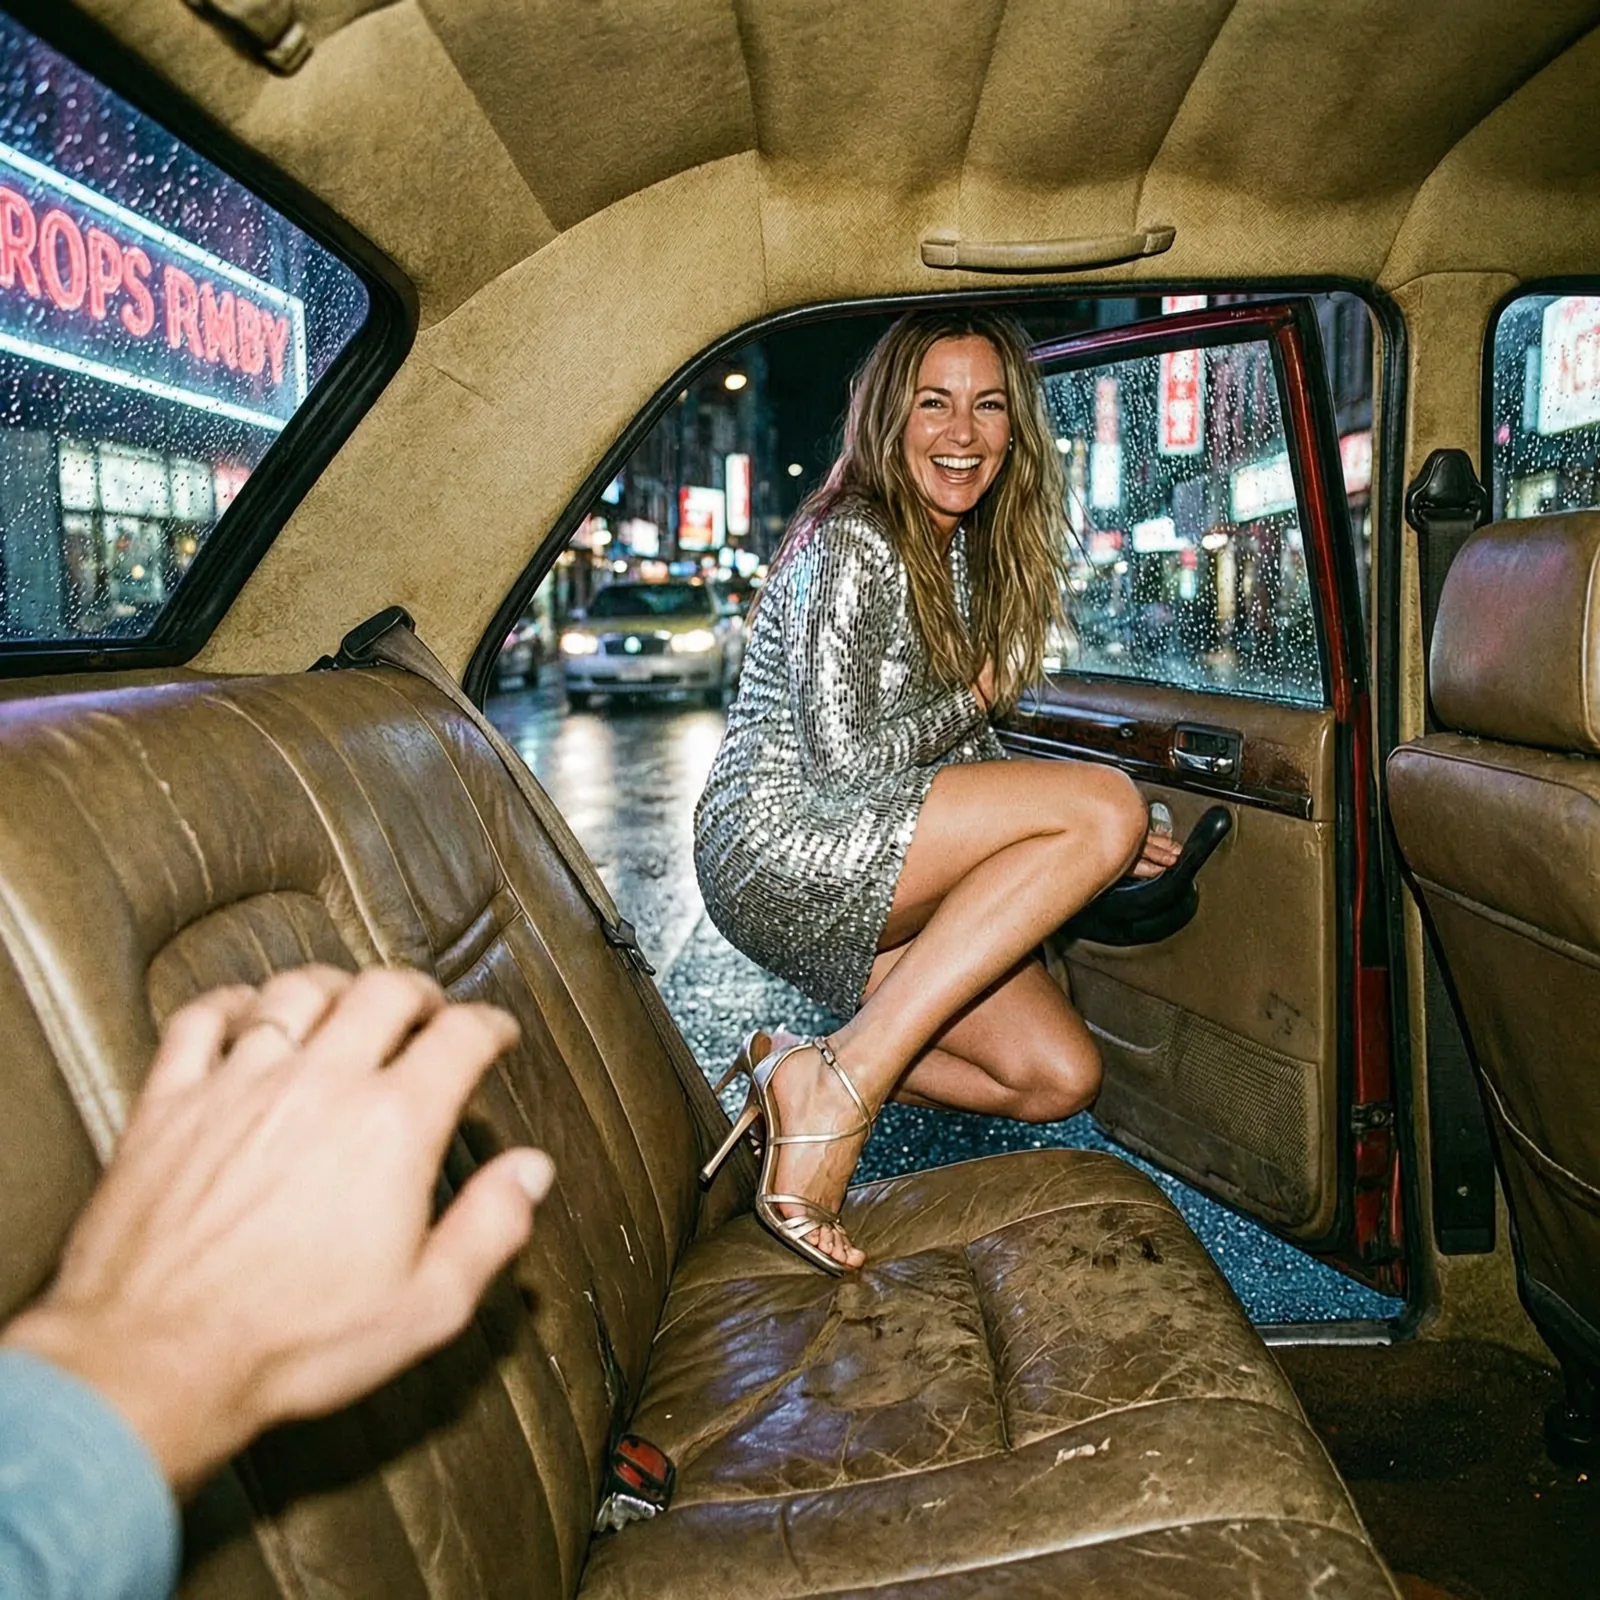
taxi-back-seat La segunda imagen de esta página. Proporción y seed omitidas por completo, así que corre en el 1:1 por defecto: el encuadre en primera persona y el grano de película los carga solo el prompt.
Este ejemplo parte de $0.03 por imagen. El Playground actualiza la estimación cada vez que cambias los ajustes.