Ir al contenido principal

Texto a imagen en Z-Image Base, el modelo Z-Image sin destilar de 6 mil millones de parámetros del equipo Tongyi-MAI de Alibaba, con hasta tres LoRA tuyos por solicitud. Prompts en oraciones, nueve relaciones de aspecto, JPEG, PNG o WebP, y ningún filtro sobre prompts, pesos ni resultados.

Desde $0.014/imagen

Playground

Entrada

Texto a imagen
406/5000
Funcionan mejor las oraciones completas: sujeto, ropa, lugar, luz y lente. Pon primero la frase activadora del LoRA. Hasta 5000 caracteres; no hay prompt negativo. mínimo 1 caracteres · máximo 5000 caracteres
Nueve formas de alrededor de un megapíxel, de 21:9 (1536 x 640) a 9:21; 1:1 por defecto. La relación cambia la forma, no el precio.
LoRA de estilo1/3

Mikkoani

Hasta tres entradas {path, scale} entrenadas sobre Z-Image Base; scale de 0 a 4, donde 1 es neutro. Los LoRA de Turbo no son compatibles. Usa un enlace público y directo al archivo .safetensors. máximo 3 elementos
Formato de salida
JPEGPNGWebP
JPEG por defecto, o PNG o WebP. El formato no cambia el precio.
Seed
Mantiene comparable un conjunto de imágenes mientras cambias un solo LoRA o una sola oración a la vez. No garantiza los mismos píxeles exactos en cada ejecución. no menor que 0 · no mayor que 2147483647
Filtro de seguridadDesactivado

SpicyAPI no ejecuta ningún filtro de seguridad en este modelo. Tu prompt y tus medios llegan al modelo tal como los escribes, y el propio modelo decide el resultado.

Comprobando tu cuenta antes de habilitar el envío y el cálculo de precios.

Salida

Listo para una nueva ejecución
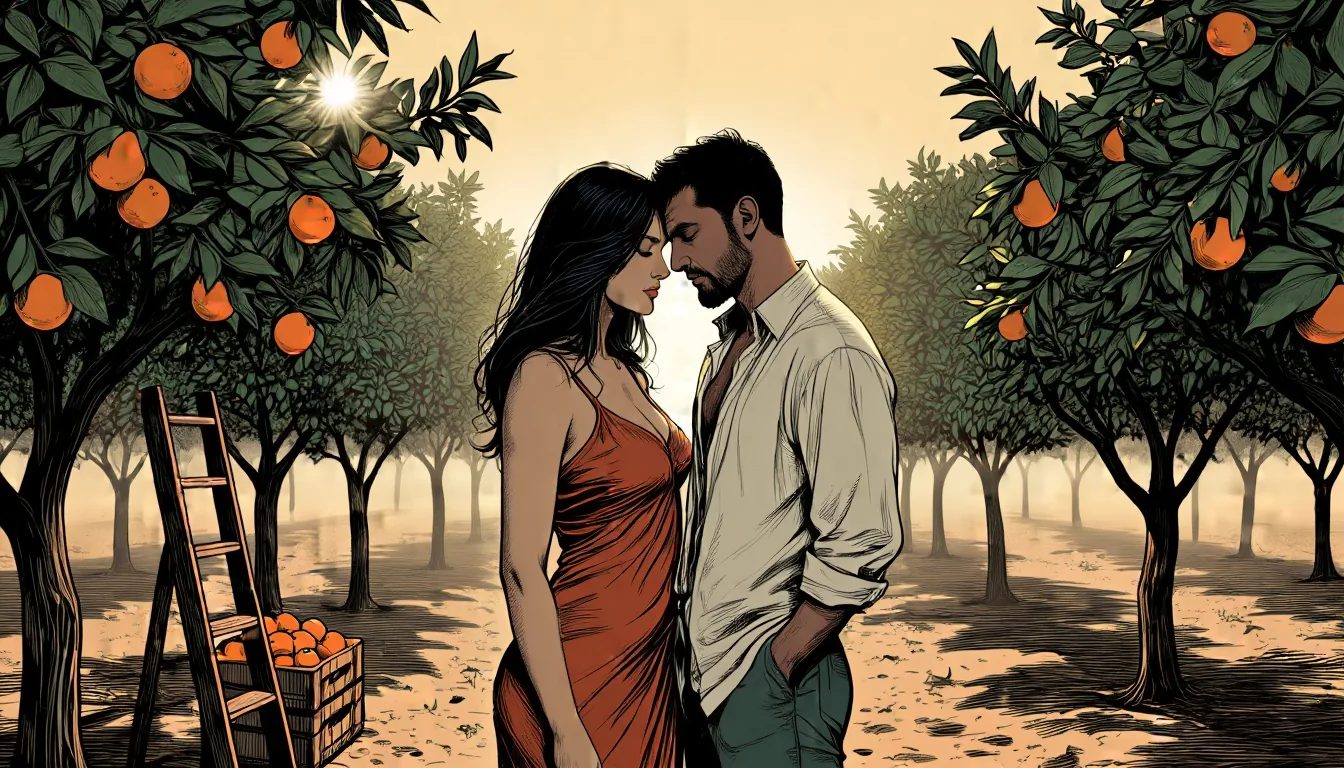
orange-grove-sunriseResultado de ejemplo

Modelos relacionados y tareas siguientes

¿No está el modelo que buscas?

Dinos cuál añadir y para qué lo usarías. Las solicitudes llegan directamente al equipo que decide los próximos modelos.

Usa LoRA hechos para Z-Image Base y reestiliza fotos con un control de strength

Z-Image Base LoRA ejecuta Z-Image Base, el modelo fundacional de 6 mil millones de parámetros de Tongyi-MAI en Alibaba, con hasta tres LoRA en texto a imagen y en imagen a imagen. Base es el modelo sin destilar sobre el que entrena la comunidad, así que es más lento que Turbo: texto a imagen tardó de 9.8 a 56.7 segundos, con una mediana de 32.8, y las ediciones de 4.9 a 41.7, con una mediana de 16.8. Nada filtra el prompt ni la imagen, aunque el modelo base por sí solo dibuja mal el nivel Muy fuerte de nuestra prueba de contenido, y para eso existen los LoRA.

Abrir el Playground
Usa LoRA hechos para Z-Image Base y reestiliza fotos con un control de strength
LoRA por solicitud
Hasta 3, cada uno {path, scale}; el archivo debe estar entrenado en Z-Image Base, no en Turbo
Strength de edición
De 0 a 1, 0.7 por defecto; con alrededor de 0.6 se reestilizó con un LoRA y con 0.75 se reorganizó la escena
Tamaños
9 relaciones de aspecto de hasta 1536 por lado; las ediciones aceptan 1k o 1.5k en el lado largo y conservan la relación del original
Velocidad
Texto a imagen: mediana de 32.8 segundos en 36 corridas; edición: mediana de 16.8 segundos en 28 corridas
Precio
Se cobra por imagen a una tarifa fija; el tamaño, la imagen de origen y el número de LoRA no la cambian
No disponible
Pasos, guidance y prompt negativo; el endpoint no tiene esos campos
El modelo base correcto
Un LoRA del modelo equivocado falla sin avisarUn LoRA entrenado en Z-Image Turbo, cargado en Base, convirtió la imagen en ruido y pseudotexto. Un LoRA de Pony y un archivo etiquetado como Z-Image pero guardado con otro formato de claves cargaron y no cambiaron nada. Usa archivos entrenados en Base y haz primero una pareja de corridas con y sin LoRA.
Límites de la edición
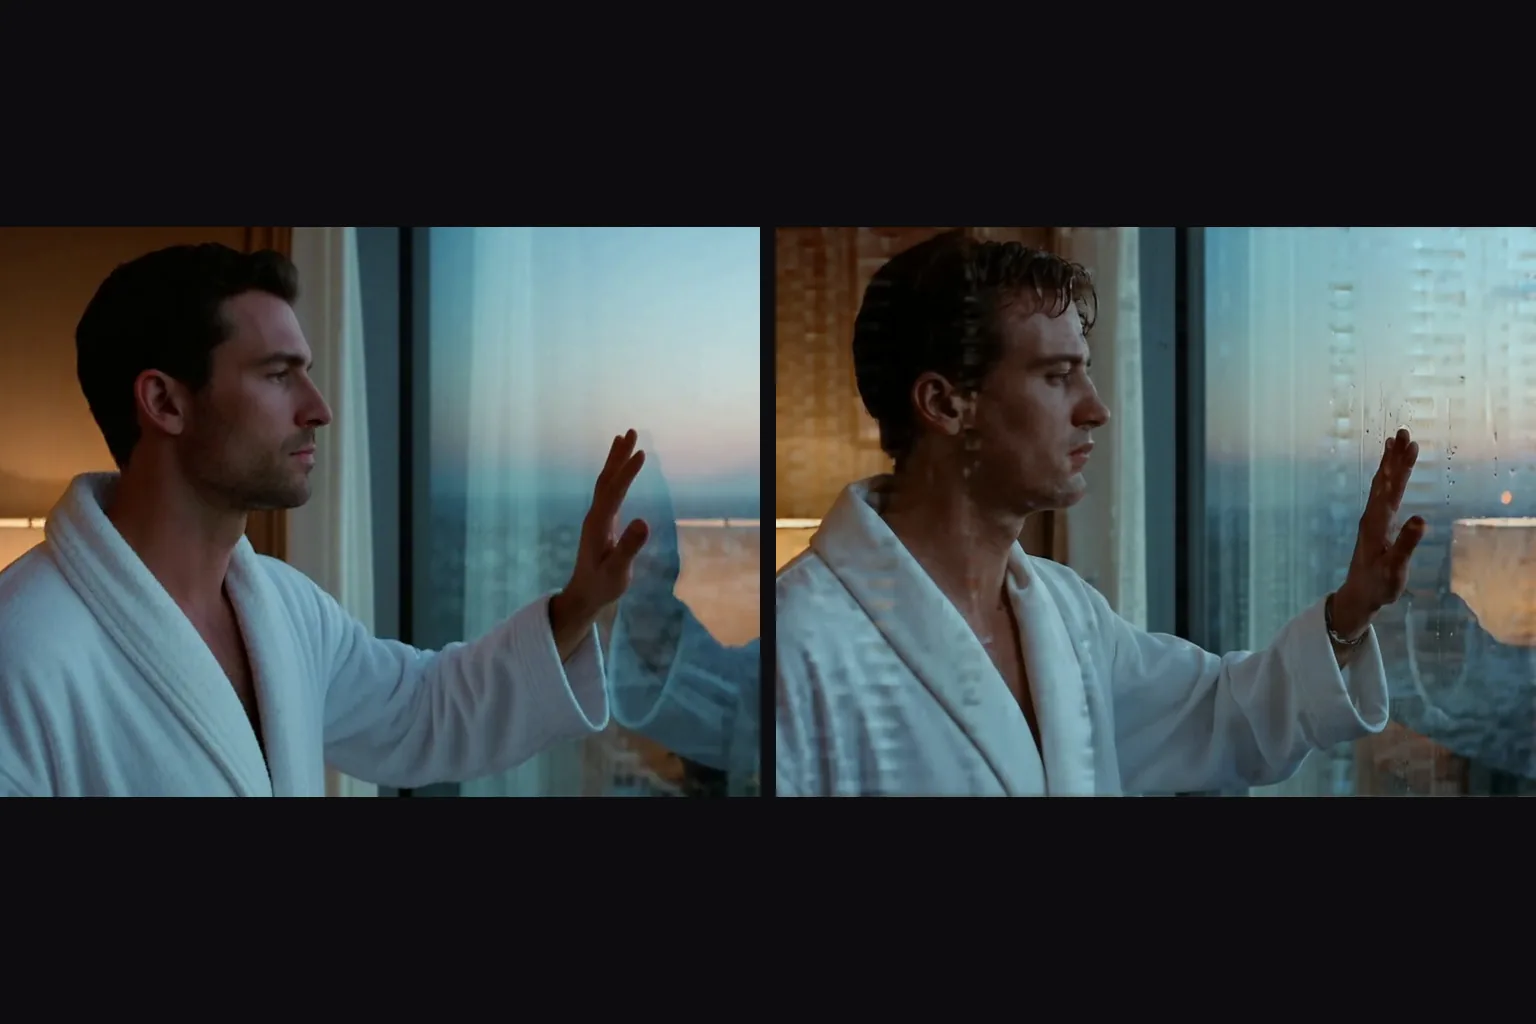
Las ediciones redibujan el cuadro y no siguen instruccionesSin LoRA, pedir blanco y negro con strength 0.65 y 0.8 se quedó en color, y pedir un esmoquin con 0.7 y 0.8 cambió poco. Describe la imagen completa que quieres y usa un LoRA de estilo cuando quieras que cambie el aspecto.
Límite honesto
Un solo nivel de contenido sale suavizadoNingún filtro de contenido se interpone ante el modelo, y en ambos endpoints, nuestra prueba de contenido de cinco niveles generó todos los niveles salvo Muy fuerte, incluido Máximo. Muy fuerte salió suavizado en tres intentos: el modelo base no lo dibuja de forma convincente por sí solo, y para eso sirven los LoRA entrenados para ello.

Cómo trabajar con Z-Image Base LoRA

Escribe los prompts de foto como frases normales

Escribe los prompts de foto como frases normales

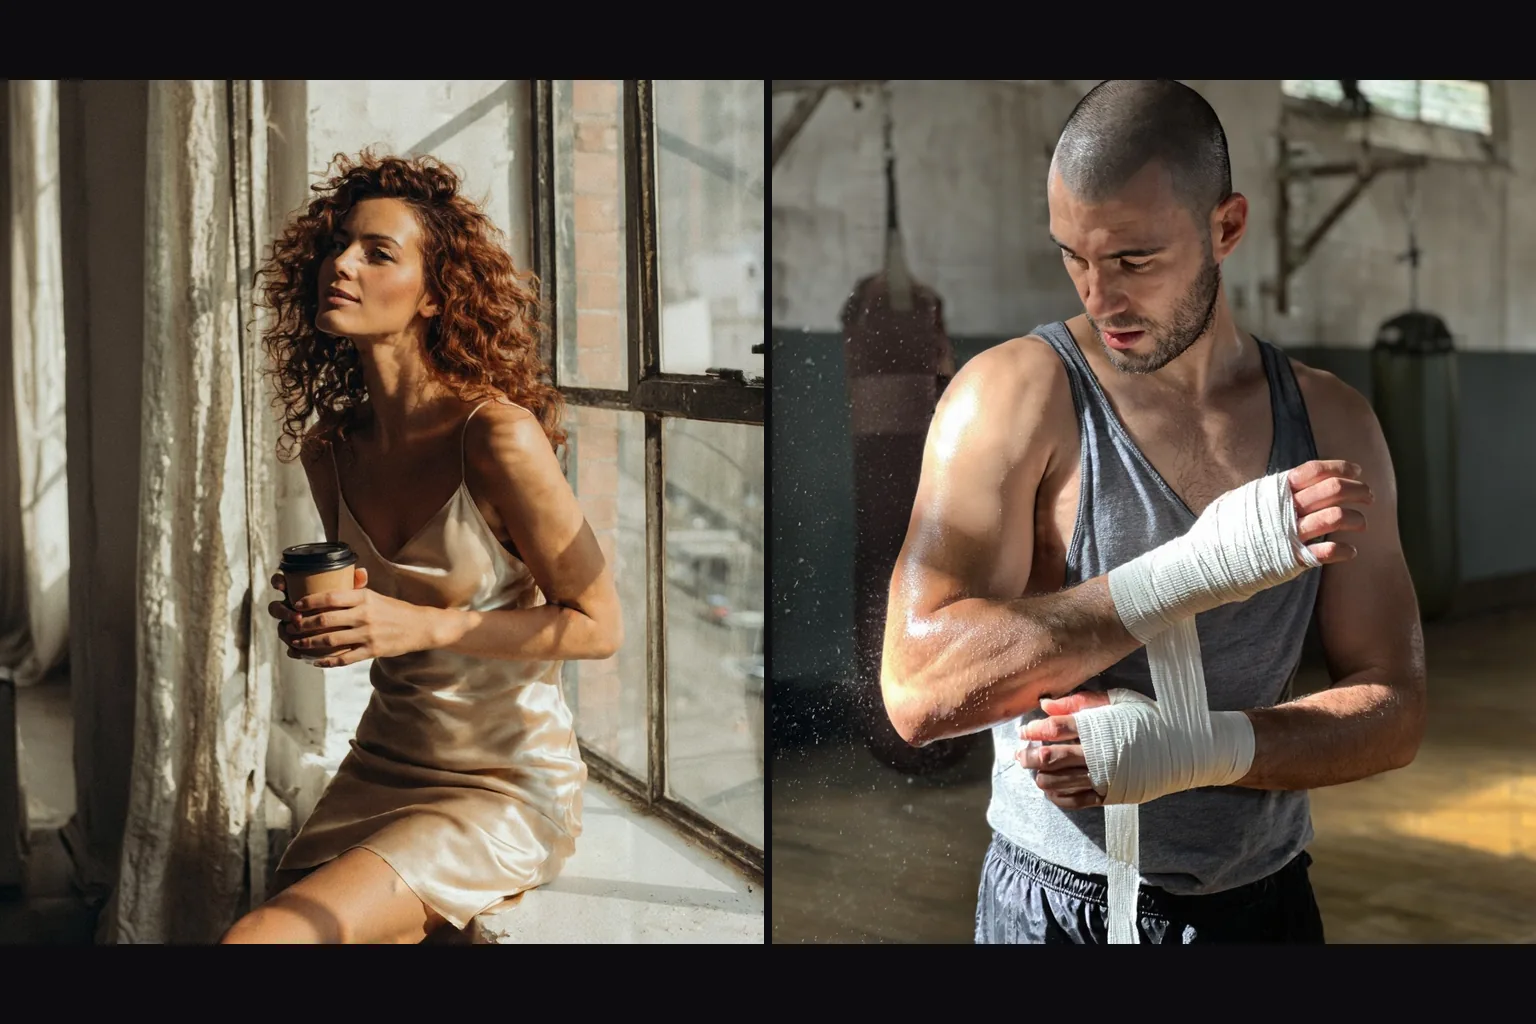
La fidelidad al prompt es alta, así que describe la fotografía como le darías las indicaciones a un fotógrafo: sujeto, ropa, lugar, luz, grano. Nuestros retratos del loft y del gimnasio salieron cada uno de una sola frase. La misma estructura de frase, cambiando solo el sujeto, sostiene toda una serie.

Usa LoRA entrenados en Base

Usa LoRA entrenados en Base

Un LoRA entrenado en Z-Image Base funcionó con 0.5 y con 1. El LoRA de ilustración mikkoani se activa con su frase "mature illustration with muted color and complex linework" al principio del prompt, y la frase sola, sin el archivo, ya empujó un prompt de foto hacia la ilustración.

  • Elige la strength antes de reescribir el prompt

    En edición, la strength decide cuánto del original sobrevive. En nuestra escala, 0.3 y 0.5 dejaron la imagen casi sin cambios y 0.6 la cambió un poco. Con 0.7 el contenido empezó a cambiar con la composición intacta, 0.75 cambió la pose y reorganizó la escena conservando luz y paleta, y 0.85 dio una imagen nueva. Con un LoRA de estilo, 0.6 reestilizó todo el cuadro y conservó la composición exactamente.

  • Espera un reestilizado, no instrucciones

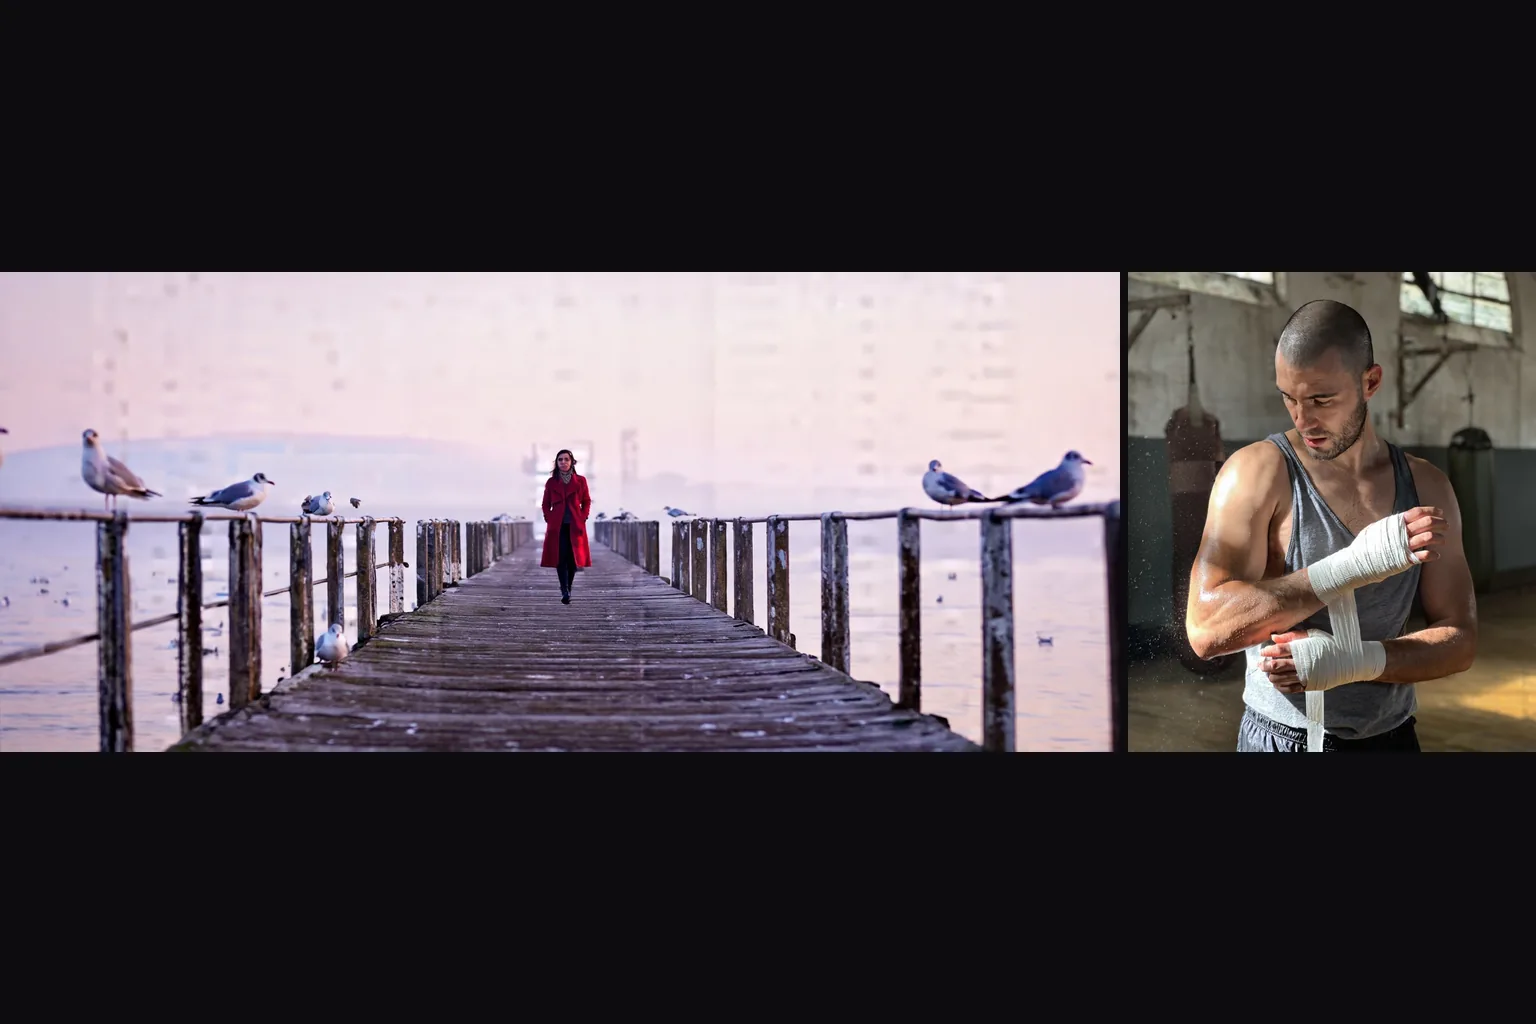
    El modelo de edición redibuja el cuadro a partir de tu descripción. "Make it black and white" se quedó en color con 0.65 y 0.8 en nuestra prueba, como muestra la imagen de la derecha. Para cambiar de medio, usa un LoRA de estilo; para una escena distinta, descríbela por completo.

  • Atiende a los tamaños

    Texto a imagen ofrece nueve relaciones, desde 1024×1024 para 1:1 hasta 1536×640 para 21:9, y cada una volvió exactamente en el tamaño pedido. En edición, 1k y 1.5k fijan el lado largo y se conserva la relación del original: una foto 2:3 en 1k volvió a 680×1024 y una foto 16:9 en 1.5k volvió a 1536×856.

Quién usa Z-Image Base LoRA

  • Ilustración de colores apagados y mucho trazo, a partir de texto

    Ilustradores y artistas conceptuales

    Ilustración de colores apagados y mucho trazo, a partir de texto

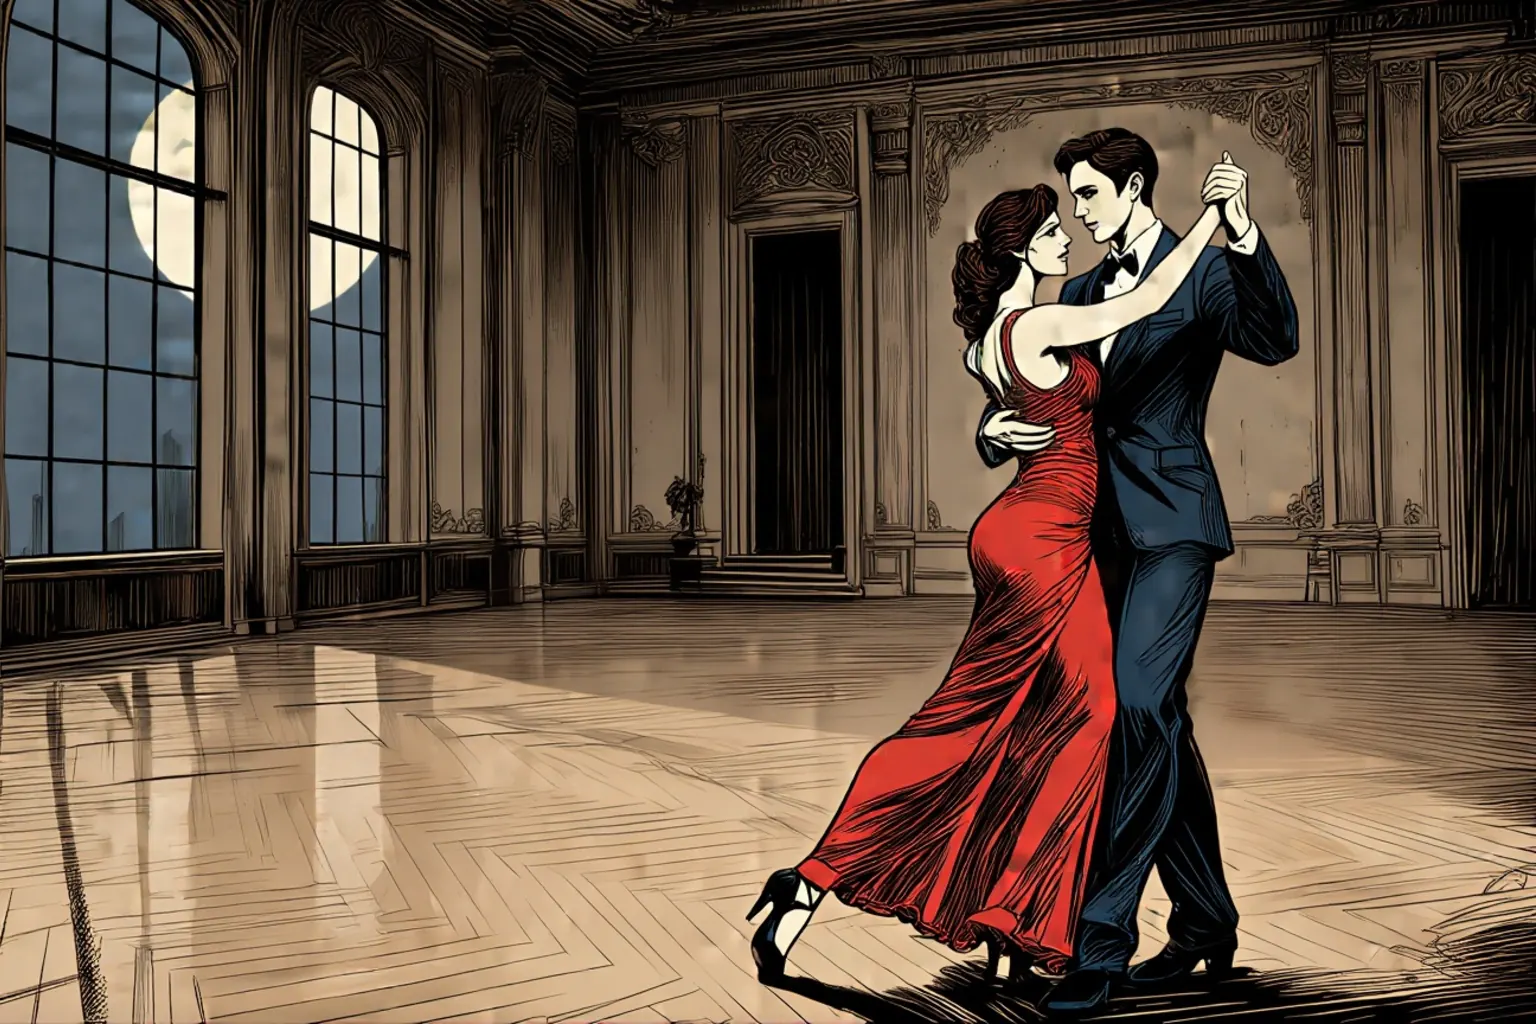
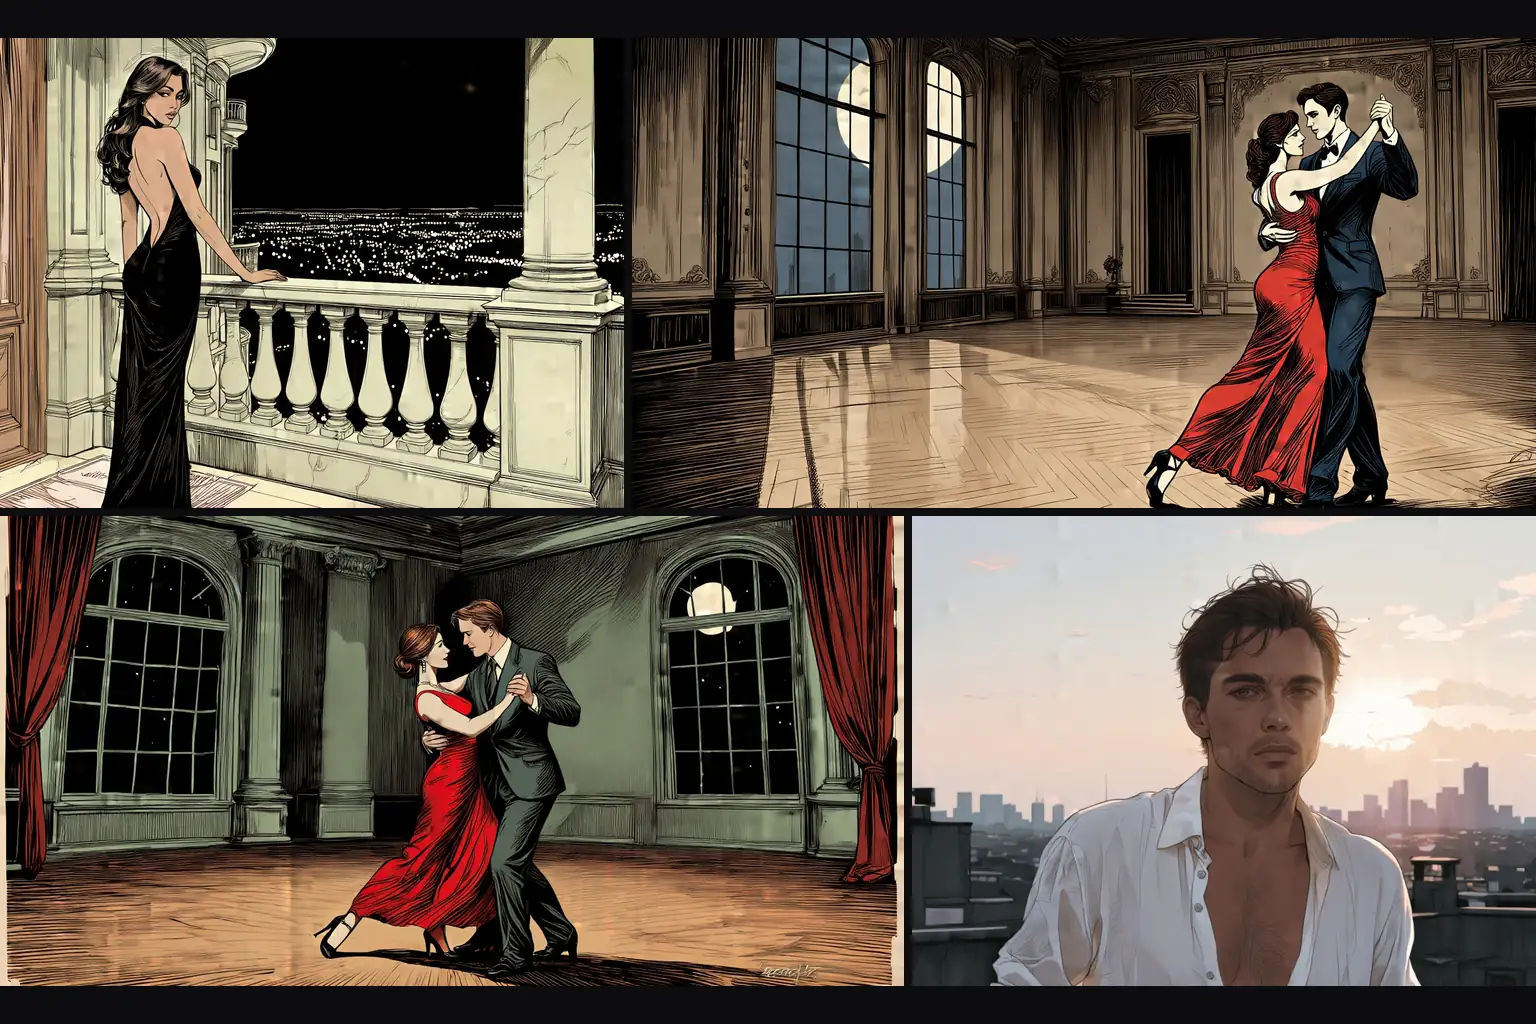
    Con el LoRA mikkoani con 1, nuestros prompts de un baile en un salón, un balcón de noche y una pareja en una sala a la luz de la luna salieron como ilustración entintada de colores apagados. Deja la frase primero y escribe la escena en oraciones.

  • Una foto convertida en ilustración

    Fotógrafos y retocadores

    Una foto convertida en ilustración

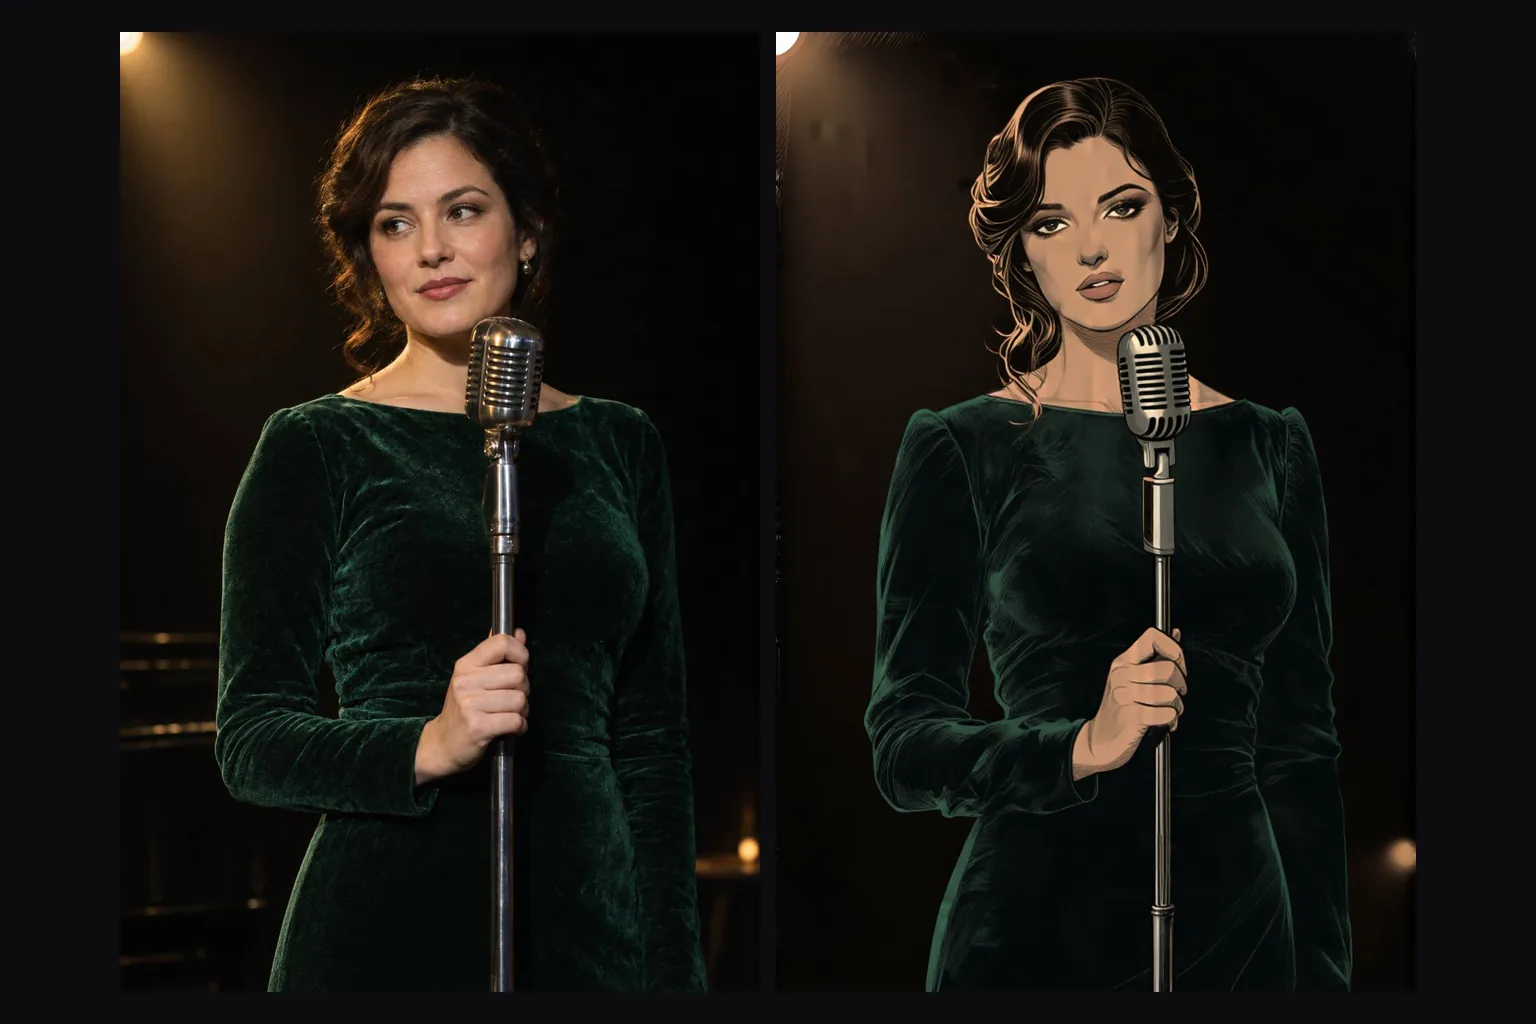
    A la izquierda, una foto original de una cantante con un vestido de terciopelo verde; a la derecha, la edición con el LoRA mikkoani y strength 0.6. La pose, el micrófono y el encuadre se quedaron en su lugar mientras el acabado pasaba a ser dibujado.

  • Decide hasta dónde llega una variación

    Equipos de redes sociales y campañas

    Decide hasta dónde llega una variación

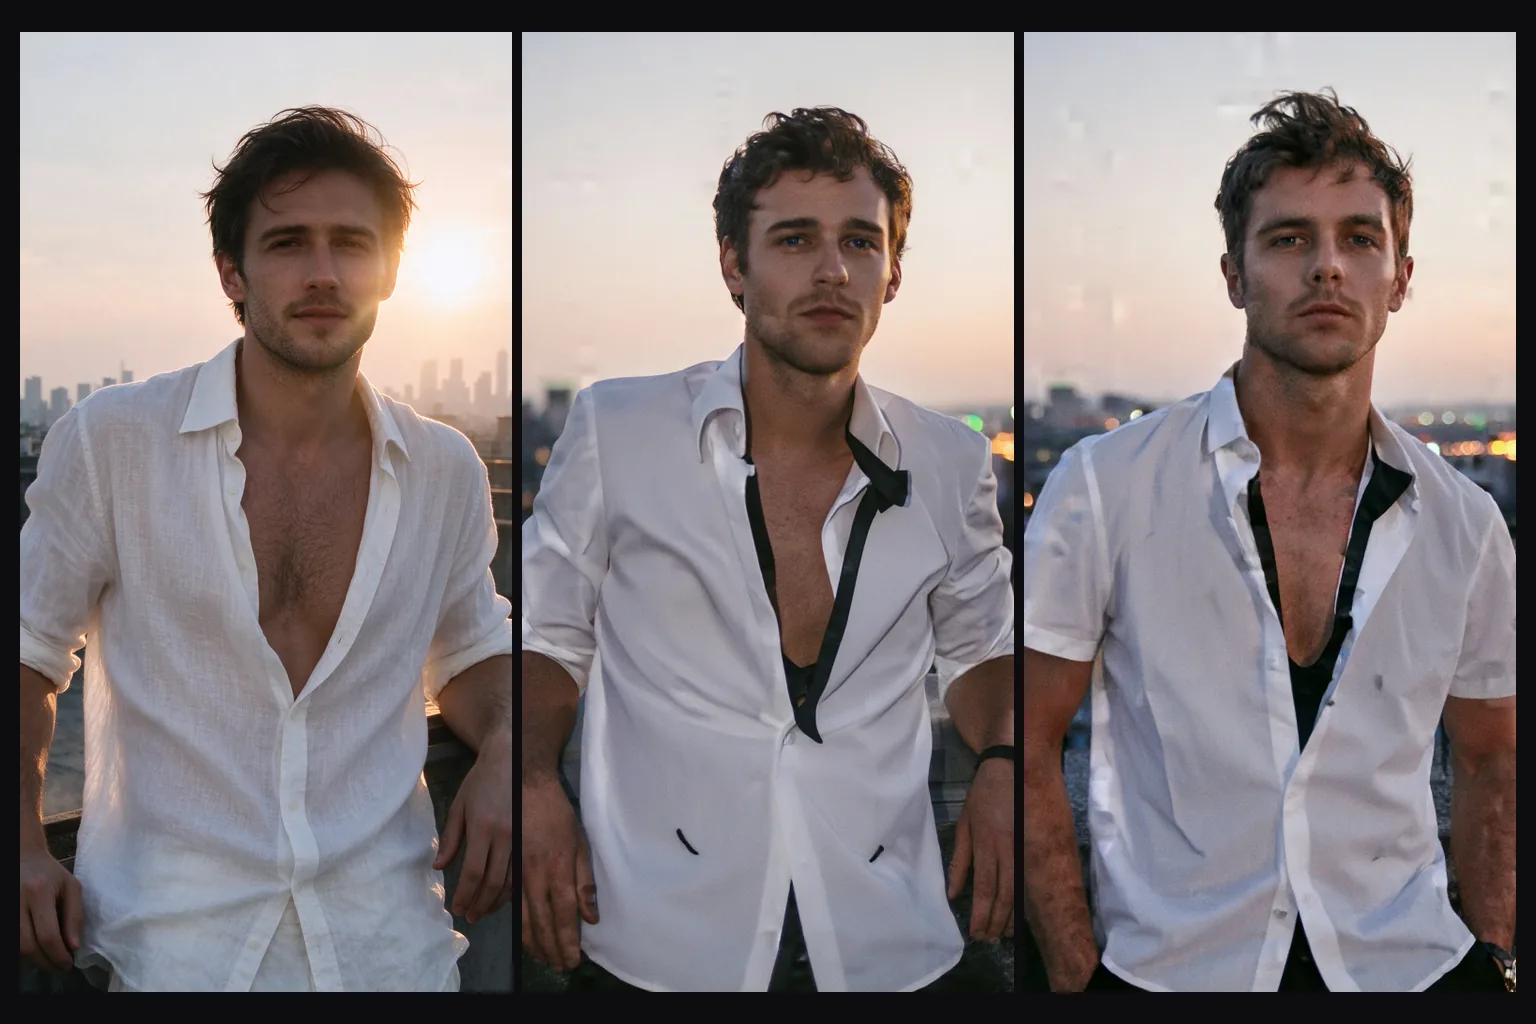
    Nuestro retrato en la azotea pasó por una edición sin LoRA pidiendo un esmoquin con 0.7 y 0.8. Cambió poco y la composición se mantuvo. Usa la strength como control de variación y reserva los valores altos para cuando quieras un cuadro distinto.

  • Escenas anchas 21:9 a 1536 píxeles

    Creadores de cine y fondos de pantalla

    Escenas anchas 21:9 a 1536 píxeles

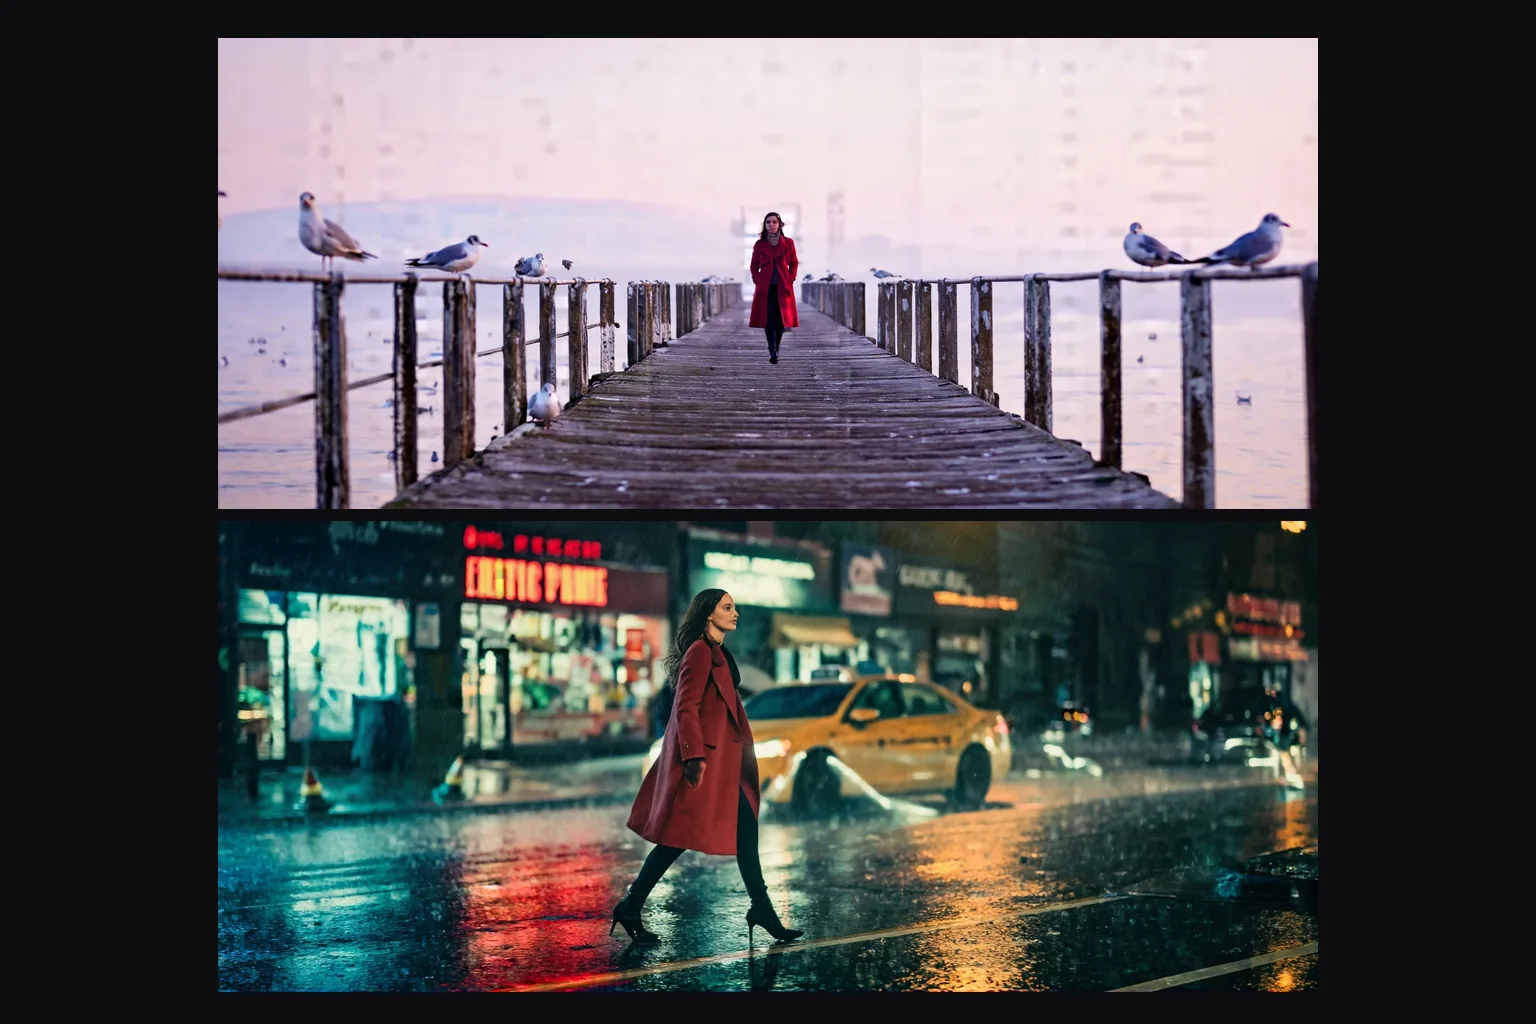
    Una mujer con abrigo rojo en un muelle con niebla al amanecer y en una calle de neón bajo la lluvia salieron ambas de frases normales en 21:9 (1536×640), sin LoRA. La relación ancha forma parte del prompt, no es un recorte posterior.

Del primer prompt a una edición terminada con Z-Image Base LoRA

  1. Parte de un prompt en frases normales

    Corre primero texto a imagen sin LoRA, en la relación que vas a publicar, para ver qué te da el modelo base.

  2. Agrega un LoRA entrenado en Base

    Copia el enlace de descarga directa al archivo .safetensors y córrelo con y sin el archivo con la misma seed.

  3. Revisa el scale

    Prueba 0.5 y 1 y quédate con el valor en el que el aspecto se nota sin apoderarse del sujeto.

  4. Edita con una escala de strength

    Envía una imagen de origen con el arreglo loras y empieza en 0.6; usa 0.7 y 0.75 cuando quieras reorganizar la escena.

  5. Describe todo el resultado

    El modelo redibuja el cuadro completo, así que escribe la imagen entera y no solo el cambio.

Prompts de Z-Image Base LoRA que vale la pena copiar

  • Una foto en frases normales

    Sin LoRA; relación vertical 2:3.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • Una ilustración de colores apagados

    Con el LoRA mikkoani con scale 1 y la relación 16:9; la frase va primero.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • De foto a trazo dibujado

    Para el endpoint de edición con el LoRA mikkoani con scale 1 y strength 0.6. Describe la imagen completa, no solo el cambio.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Más preguntas sobre Z-Image Base LoRA

Úsalo como tu laboratorio del modelo base

Empieza con un prompt en frases normales, agrega un LoRA entrenado en Base y compruébalo con una pareja de corridas con y sin él.

En edición, sube la strength desde 0.6 y describe todo el resultado. Si un archivo no cambia nada o rompe la imagen, se entrenó para otro modelo.