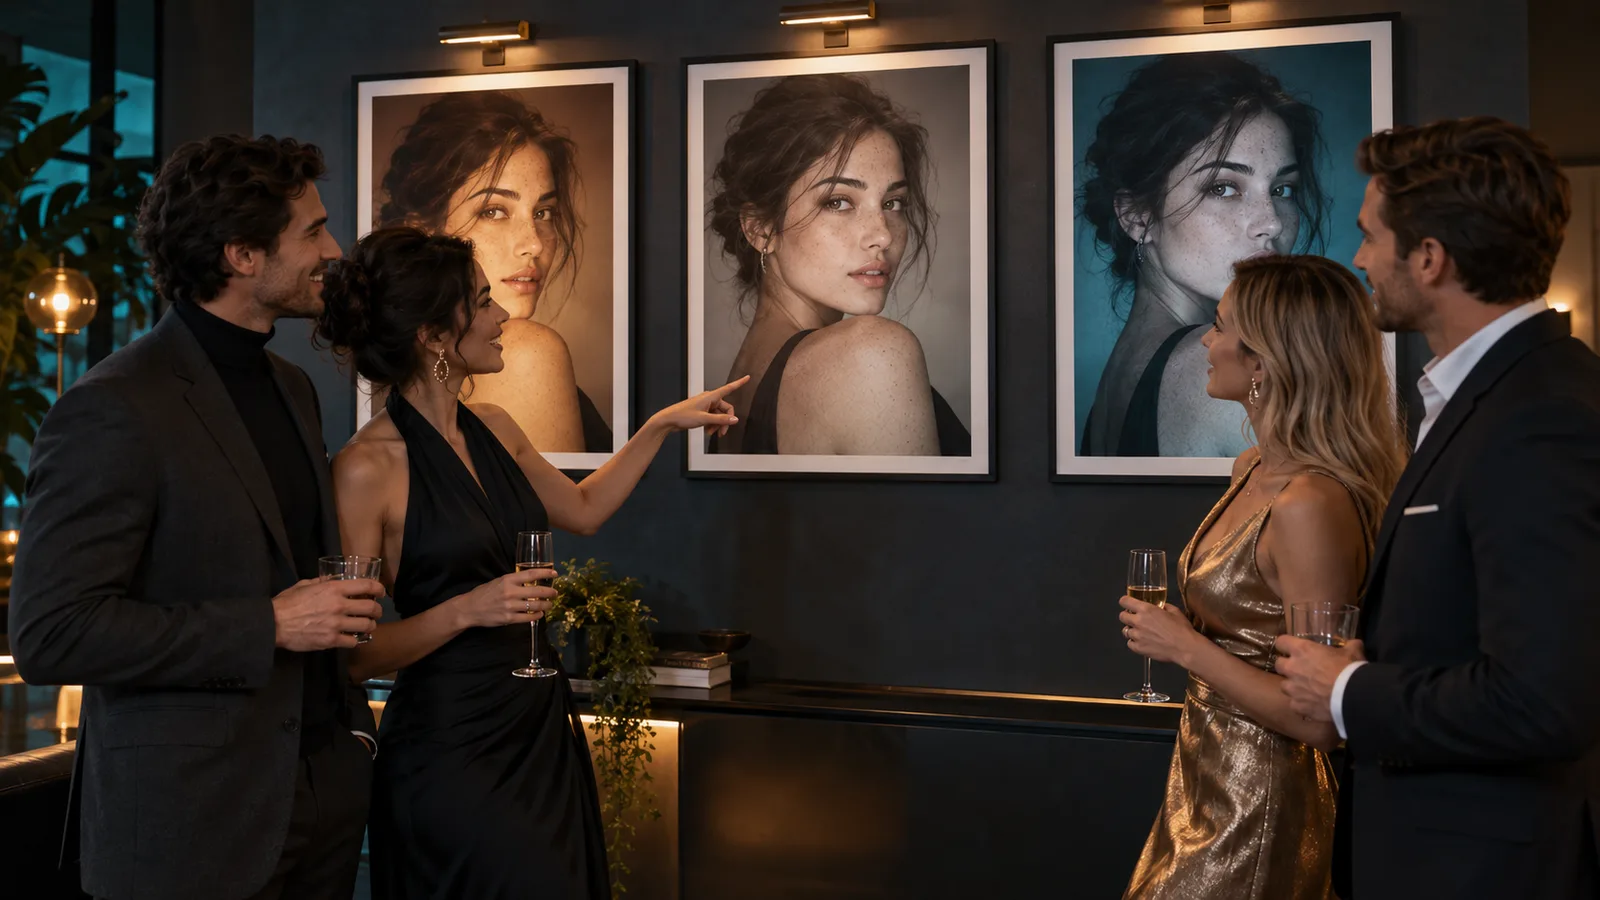
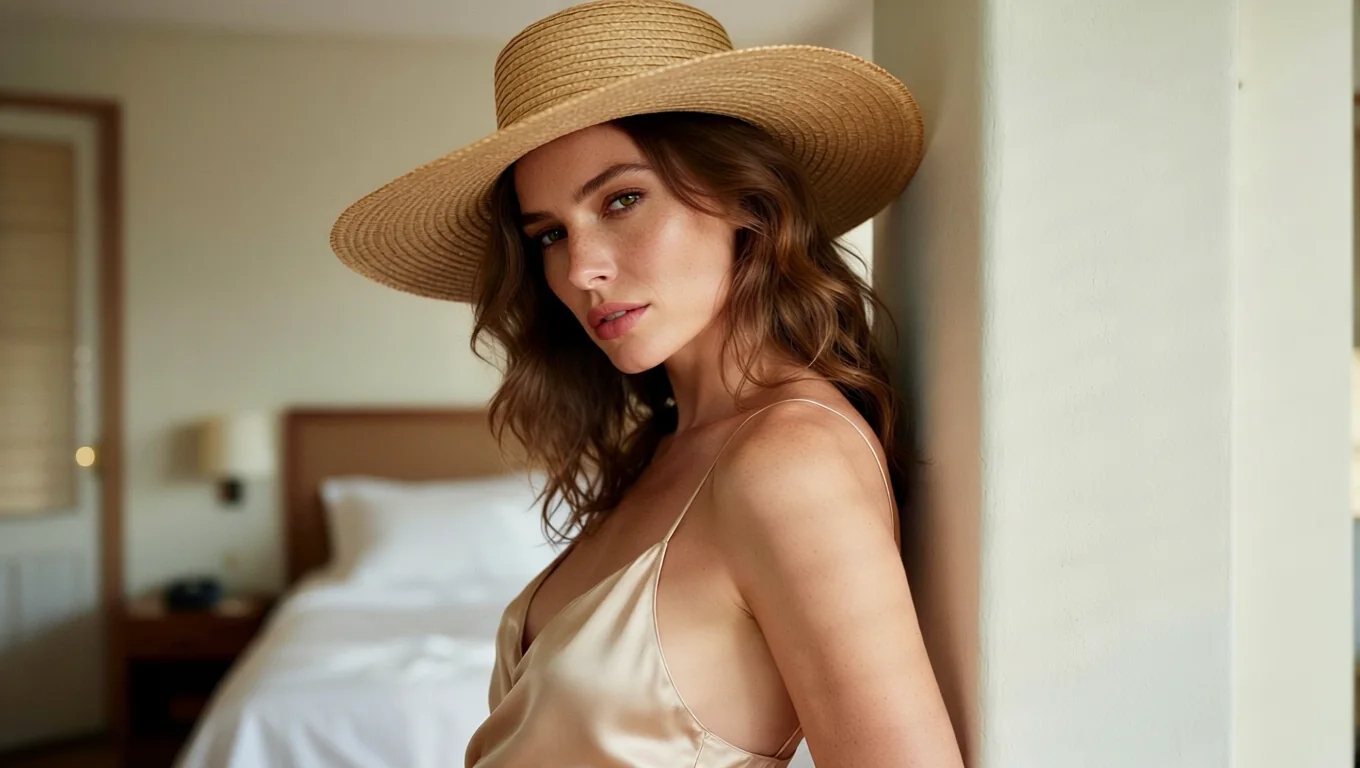
En Z-Image Base LoRA, usa LoRA entrenados sobre Z-Image Base: un LoRA entrenado para Z-Image Turbo rompió la imagen en ruido y pseudotexto cuando lo cargamos en Base el 5 de octubre de 2026. Base es el modelo más lento y sin destilar sobre el que entrena la comunidad, así que su mediana en texto a imagen fue de 32.8 segundos en nuestras 36 ejecuciones. En edición, la fuerza por defecto es 0.7, y alrededor de 0.6 con un LoRA de estilo redibujó todo el cuadro conservando exactamente la composición.
Z-Image Base LoRA ejecuta Z-Image Base, de Tongyi-MAI en Alibaba, un transformer de difusión de flujo único con 6 mil millones de parámetros, con hasta tres de tus propios LoRA tanto en texto a imagen como en imagen a imagen. La ficha del modelo describe a Base como el cimiento de la familia Z-Image, pensado para el desarrollo y un punto de partida ideal para la comunidad; admite entrenar LoRA porque no está destilado. Los endpoints no tienen censura: la plataforma no agrega ningún filtro de contenido. Primero, un límite honesto: el modelo base por sí solo dibuja mal las escenas más íntimas, que es justamente para lo que sirven los LoRA para adultos. Todos los prompts de esta guía son escenas cotidianas con adultos vestidos.
De un vistazo
| Pregunta | Respuesta (probado el 5 de octubre de 2026) |
|---|---|
| Modelo | Z-Image Base de Tongyi-MAI (Alibaba), 6 mil millones de parámetros |
| Nombres del modelo en la API | alibaba/z-image-base-lora/text-to-image y alibaba/z-image-base-lora/edit |
| Campo de LoRA | loras: hasta 3 entradas, cada una {path, scale}, escala de 0 a 4 |
| LoRA correctos | Archivos entrenados sobre Z-Image Base |
| LoRA incorrectos | Entrenados para Turbo: rompieron la imagen. De Pony o guardados con otro formato: sin error, sin cambio |
| Fuerza en edición | De 0 a 1, por defecto 0.7 |
| Tamaños en texto a imagen | Nueve relaciones de aspecto, hasta 1536 por lado |
| Tamaños en edición | resolution 1k o 1.5k fija el lado largo; se conserva la relación de aspecto de la fuente |
| Velocidad en nuestras pruebas | Texto a imagen de 9.8 a 56.7 s, mediana de 32.8 (36 ejecuciones); edición de 4.9 a 41.7 s, mediana de 16.8 (28 ejecuciones) |
| No expuestos | Pasos, guidance y prompt negativo |
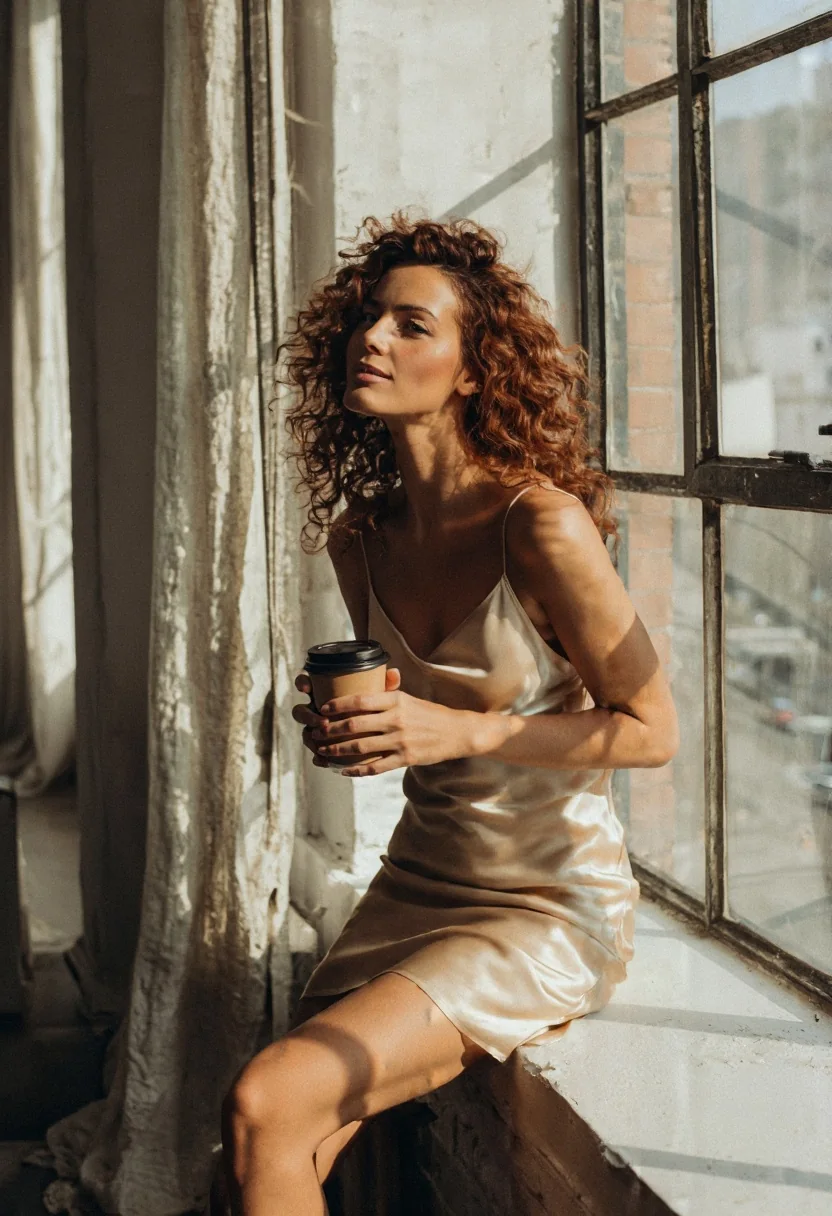
Z-Image Base LoRA, texto a imagen, 2:3 (832×1216), seed 41, sin LoRA. El prompt se muestra en la sección siguiente.
Prompts: frases sencillas, fuerte adherencia
La adherencia al prompt en Base fue fuerte en nuestras pruebas. Escribe como si le dieras instrucciones a un fotógrafo: sujeto, ropa, lugar, luz, grano. El retrato del loft de arriba salió de una sola frase:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.La misma estructura de frase, cambiando solo el sujeto, dio un boxeador en un gimnasio antiguo:
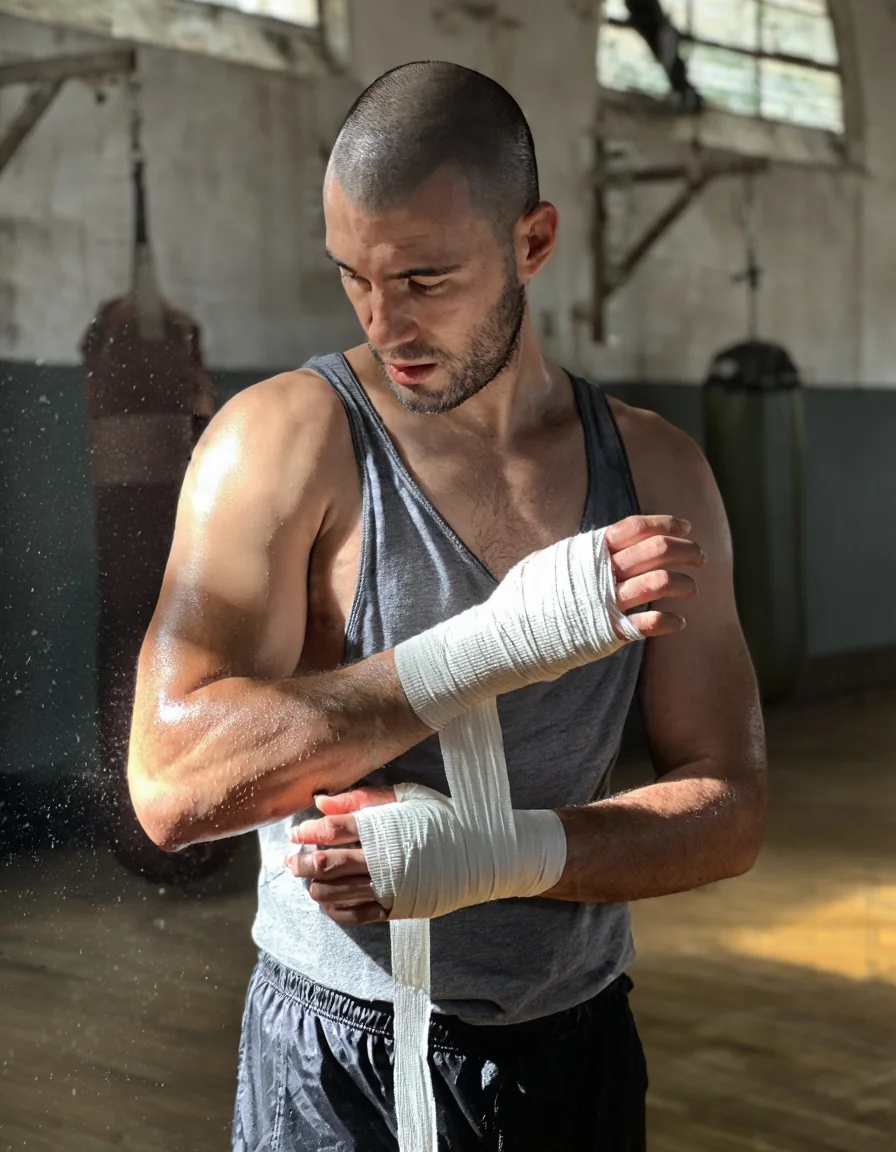
Z-Image Base LoRA, texto a imagen, 3:4 (896×1152), seed 42, sin LoRA.
No hay campo de prompt negativo, guidance ni pasos. El publicador recomienda un guidance de 3.0 a 5.0 y de 28 a 50 pasos para el modelo en sí, pero este endpoint no expone ninguno, así que el tono y el estilo vienen del prompt y del LoRA.
Qué LoRA funcionan en Base
Esta es la pregunta que la familia existe para responder, así que probamos cuatro tipos de archivo:
| LoRA | Entrenado para | Qué pasó |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Funcionó con 0.5 y con 1 |
| Un LoRA de Z-Image Turbo | Z-Image Turbo | Se cargó sin error y rompió la imagen (ruido y pseudotexto) |
furaidosu/flat-cartoon-zimage, etiquetado para Z-Image | Otro formato de claves | Se cargó sin error, resultado idéntico píxel por píxel: sin cambio |
| Un LoRA de Pony | Pony SDXL | Se cargó sin error, resultado idéntico píxel por píxel: sin cambio |
Dos fallos son silenciosos y uno parece escandaloso. Un archivo mal etiquetado o de otro modelo base no cambia nada, así que puedes pasar una hora culpando a tu prompt; un archivo de Turbo en Base hace un desastre, que al menos te avisa de que algo anda mal. Corre un par, uno con el archivo y otro sin él, con el mismo seed, antes de construir sobre un adaptador. Si coinciden, el archivo no hace nada aquí; si el resultado es ruido, se entrenó para Turbo.
Hugging Face lista adaptadores cuyo modelo base es Tongyi-MAI/Z-Image. Solo revisamos los 40 primeros por número de descargas: en su mayoría LoRA de parecido con personas reales, más algunos LoRA de estilo. No contamos la lista completa, así que no damos una cifra.
Lista de verificación antes de elegir un LoRA:
- Modelo base: la ficha dice Z-Image Base, o Tongyi-MAI/Z-Image, no Turbo, Pony ni FLUX.
- Un archivo enlazable: el repositorio contiene un archivo
.safetensorsy puedes armar su enlaceresolve/main/. - Acceso público: un archivo restringido falla con un mensaje HTTP 401.
- Frase activadora: cópiala exactamente de la ficha.
- Licencia: lee la que figura en la ficha del propio LoRA.
El LoRA mikkoani: una frase, otro aspecto
El LoRA mikkoani se activa con su frase, mature illustration with muted color and complex linework, al comienzo del prompt. Aquí hay una escena de salón de baile con el LoRA a escala 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}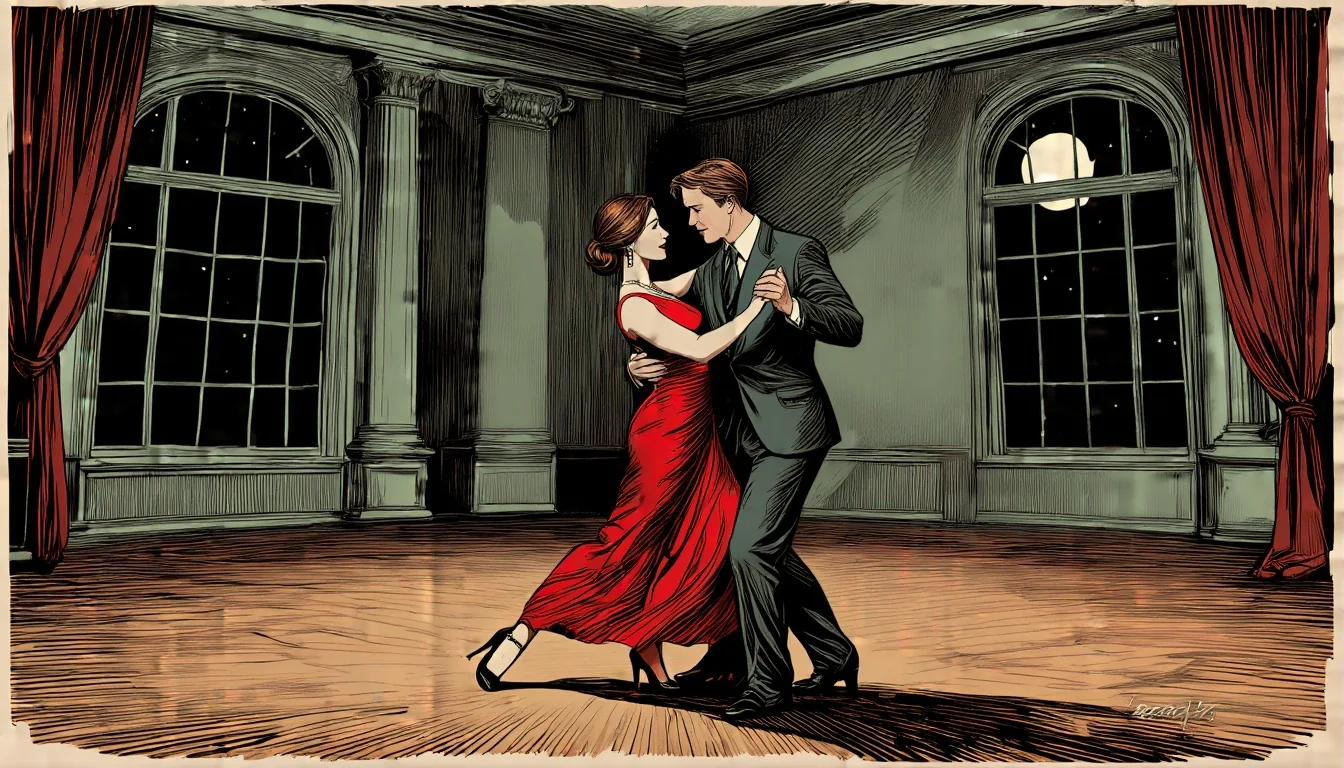
Z-Image Base LoRA, texto a imagen, 16:9 (1344×768), seed 43, LoRA mikkoani a escala 1.
Un hallazgo más que conviene conocer: la frase por sí sola, sin el LoRA, ya inclinó un prompt fotográfico hacia la ilustración. Base sigue con fuerza la redacción, así que una frase activadora puede aportar parte del estilo aunque el archivo no se cargue. Eso hace que el par con y sin LoRA sea un poco menos evidente: compara la calidad de las líneas y la paleta, no solo el género.
Fuerza en edición: la escalera
El endpoint de edición recibe una imagen de origen, una strength de 0 a 1 y el mismo campo loras. Nuestro valor público por defecto es 0.7; el del servicio de origen es 0.6. Corrimos una escalera sobre una foto sin LoRA:
| Fuerza | Qué vimos |
|---|---|
| 0.3 y 0.5 | Casi sin cambios |
| 0.6 | Un cambio leve |
| 0.7 | El contenido empieza a cambiar; se conserva la composición |
| 0.75 | La escena se reposiciona y se vuelve a montar; se conservan la luz y la paleta |
| 0.85 | Una imagen nueva |
Con un LoRA de estilo la imagen cambia: a 0.6 redibujó todo el cuadro y conservó exactamente la composición. Ese es el punto ideal para convertir una foto en una ilustración.
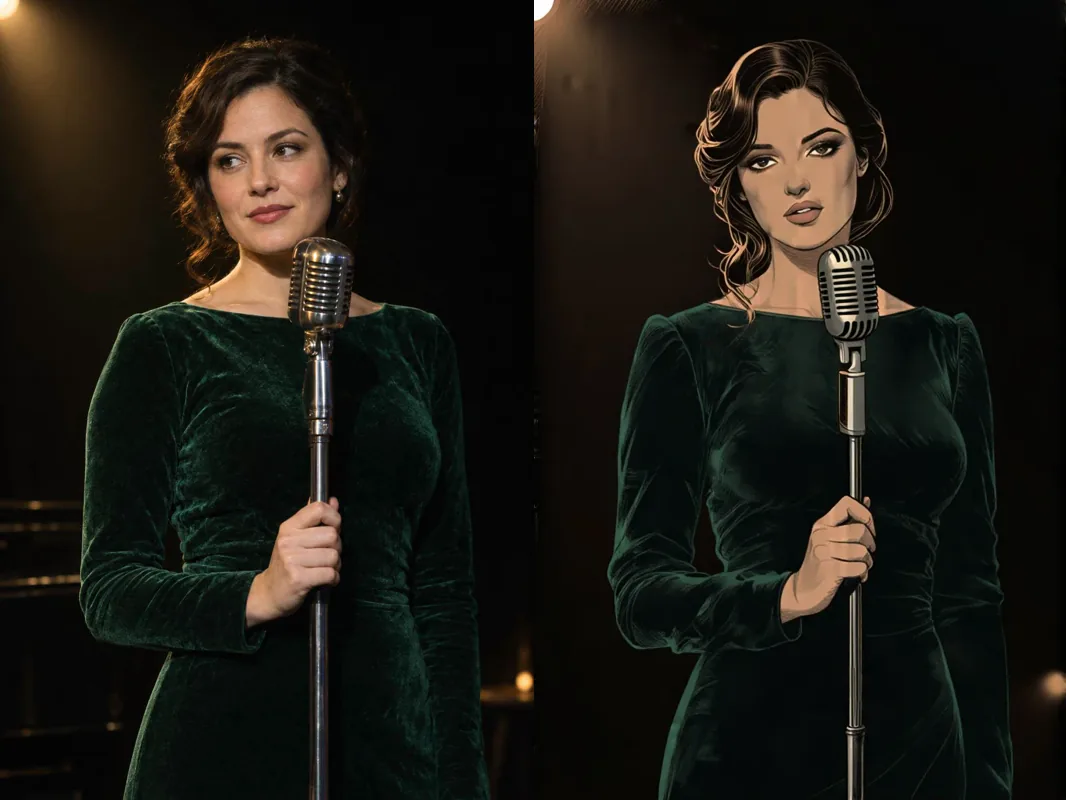
A la izquierda: nuestra foto de origen generada. A la derecha: Z-Image Base LoRA, imagen a imagen, 1k, seed 51, LoRA mikkoani a escala 1, fuerza 0.6.
El prompt de edición describe toda la imagen que quieres, no solo el cambio:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Una segunda fuente, un hombre en una azotea al atardecer con una camisa de lino blanca abierta, con la misma fuerza:
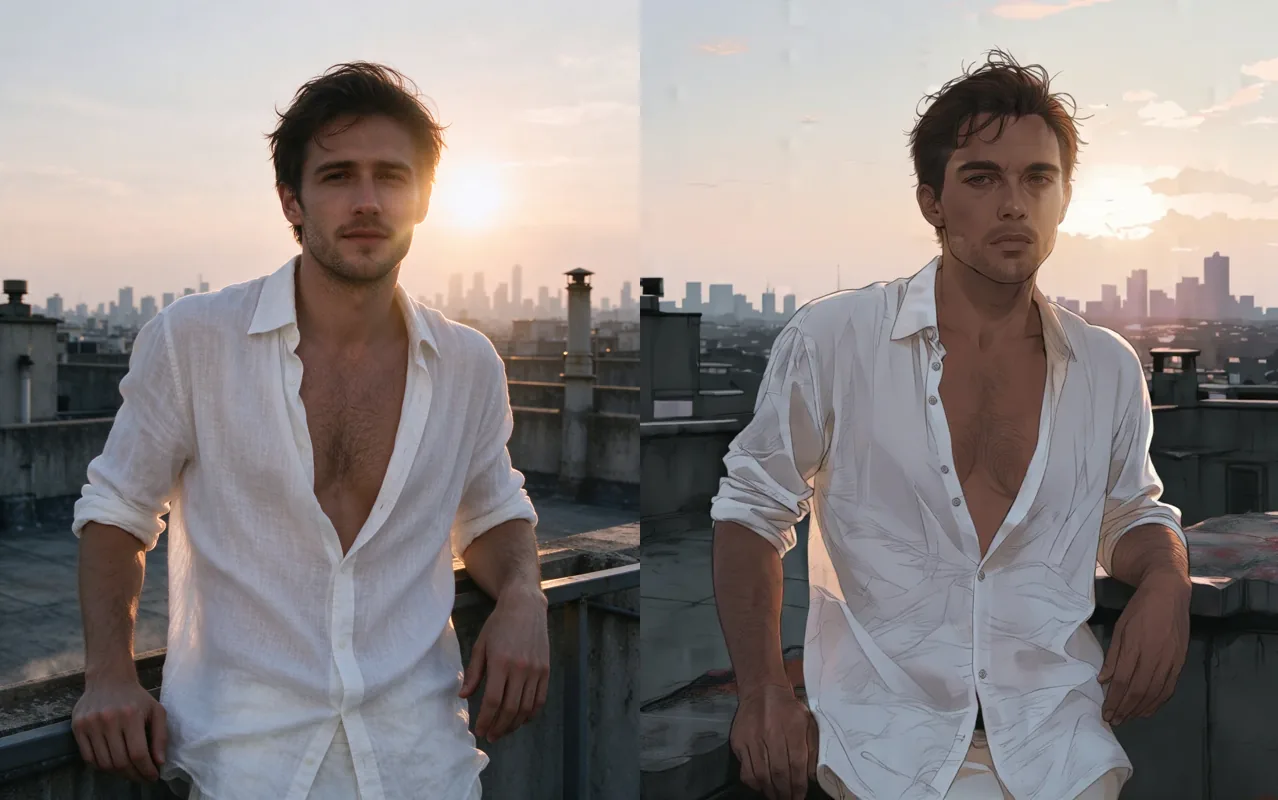
A la izquierda: nuestra foto de origen generada. A la derecha: Z-Image Base LoRA, imagen a imagen, 1k, seed 54, LoRA mikkoani a escala 1, fuerza 0.6.
Y una fuente panorámica a 1.5k y fuerza 0.65:
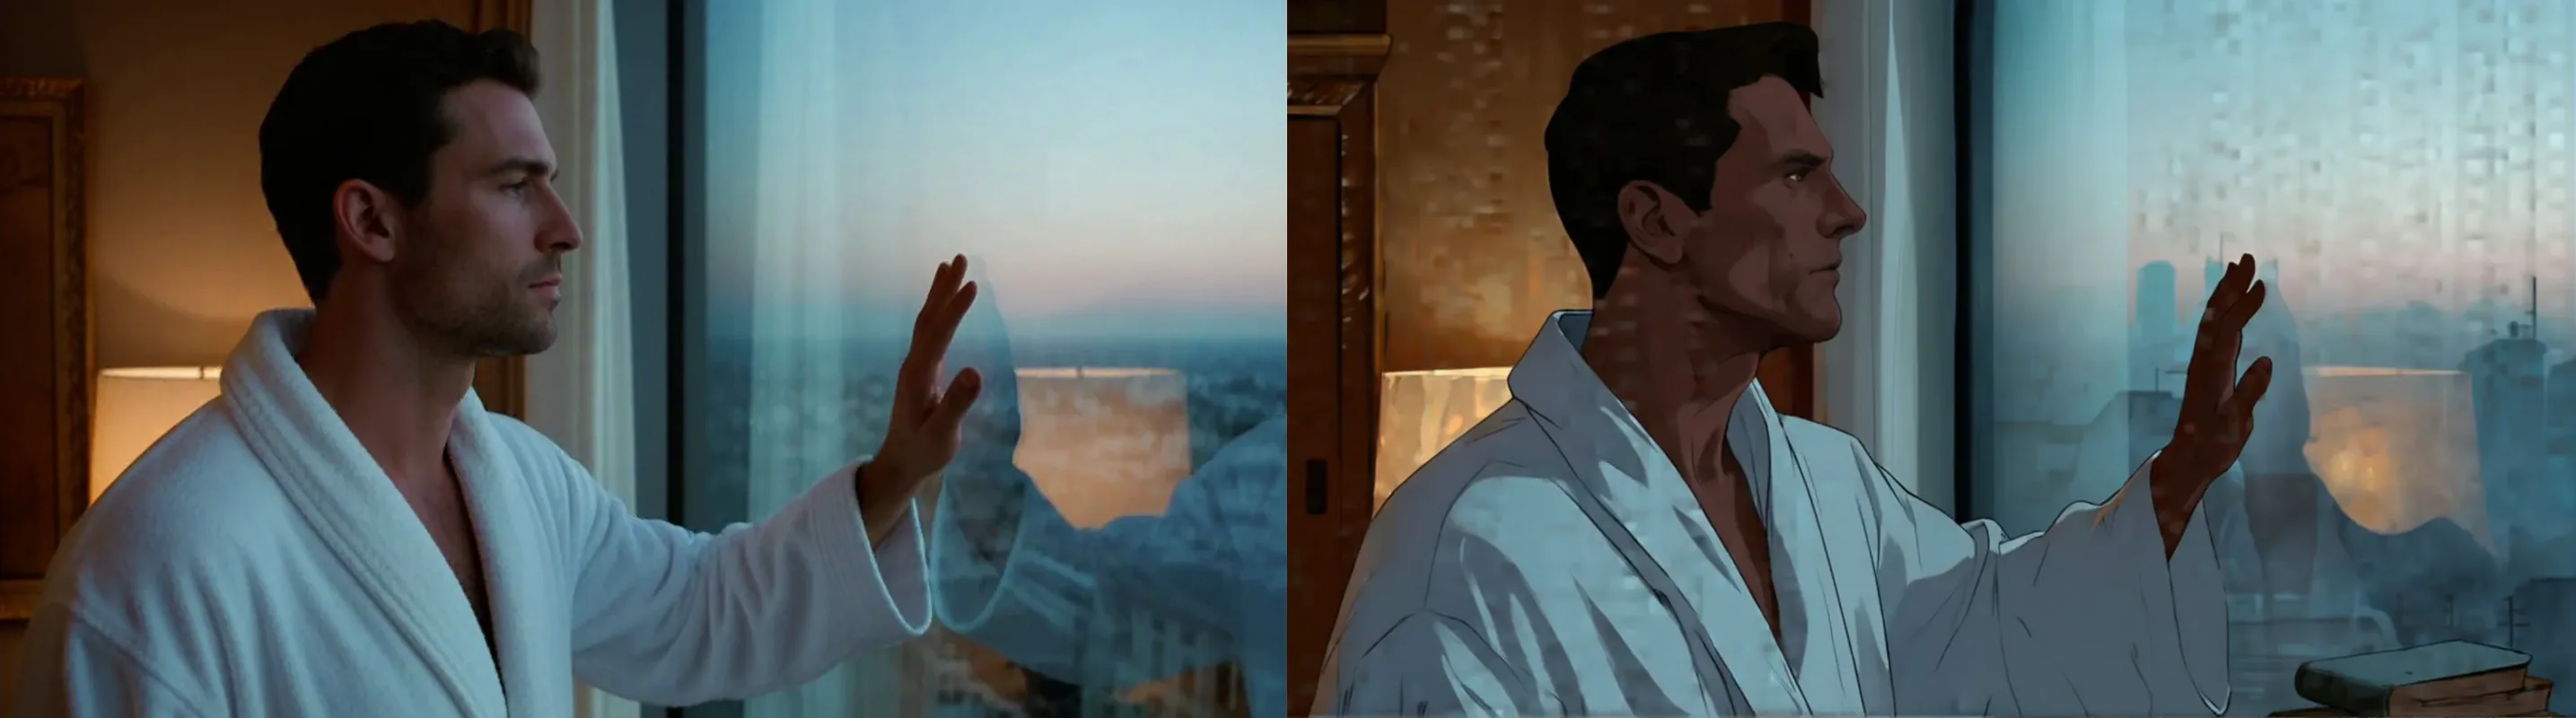
A la izquierda: nuestra foto de origen generada. A la derecha: Z-Image Base LoRA, imagen a imagen, 1.5k, seed 55, LoRA mikkoani a escala 1, fuerza 0.65.
Redibuja; no sigue instrucciones
Sin un LoRA, "make it black and white" se quedó a color con fuerzas de 0.65 y 0.8, y "put him in a tuxedo" cambió poco con 0.7 y 0.8. El modelo redibuja el cuadro a partir de tu descripción. Para cambiar de medio, trae un LoRA de estilo; para una escena distinta, descríbela por completo y sube la fuerza. Los detalles están en la página de edición.
Tamaños
Texto a imagen ofrece nueve relaciones de aspecto sobre tamaños nativos de SDXL, y las nueve se completaron exactamente en el tamaño pedido:
| Relación | Tamaño | Relación | Tamaño |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
El servicio de origen acepta de 256 a 1536 por lado: 1536×1536 y 256×256 se completaron, mientras que 1600×896, 2048×2048 y 200×200 fallaron con un error de restricción de tamaño. En edición, resolution fija solo el lado largo y se conserva la relación de la fuente: una foto 2:3 a 1k volvió de 680×1024, y una foto 16:9 a 1.5k volvió de 1536×856.
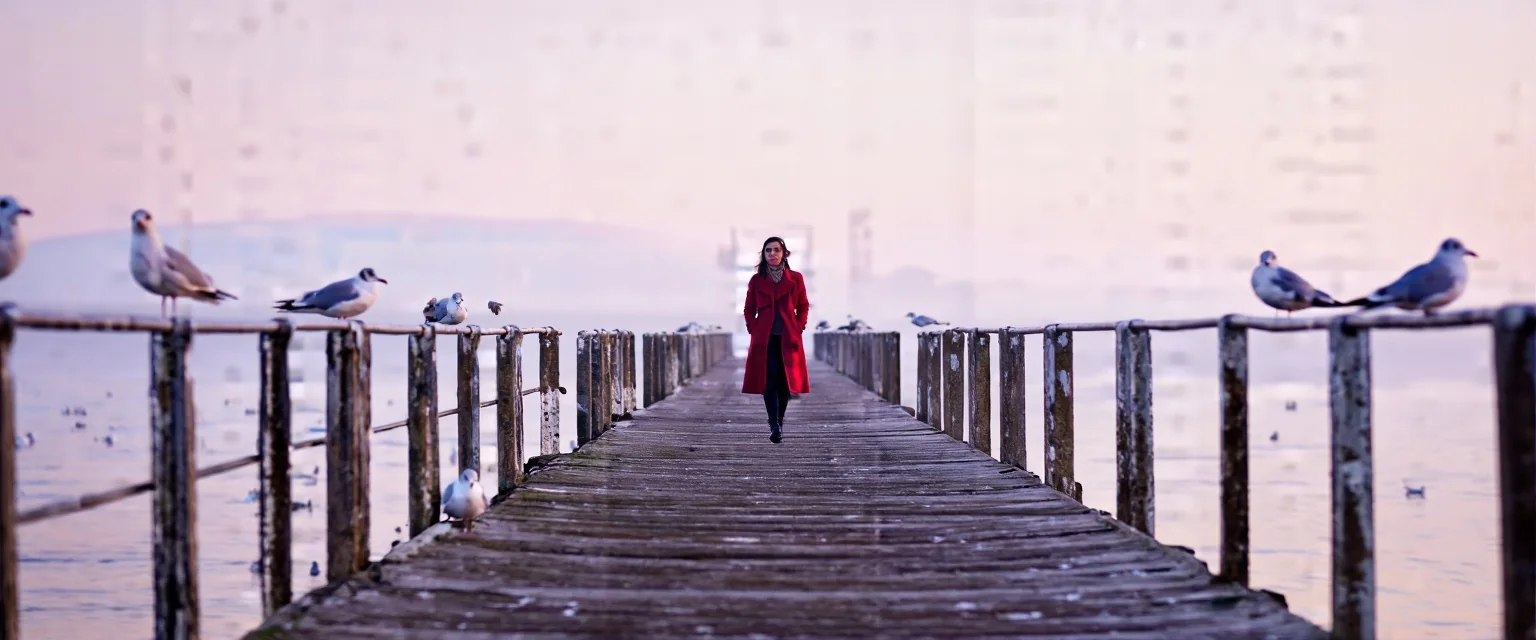
Z-Image Base LoRA, texto a imagen, 21:9 (1536×640), seed 45, sin LoRA.
La misma forma panorámica sirve para escenas urbanas:
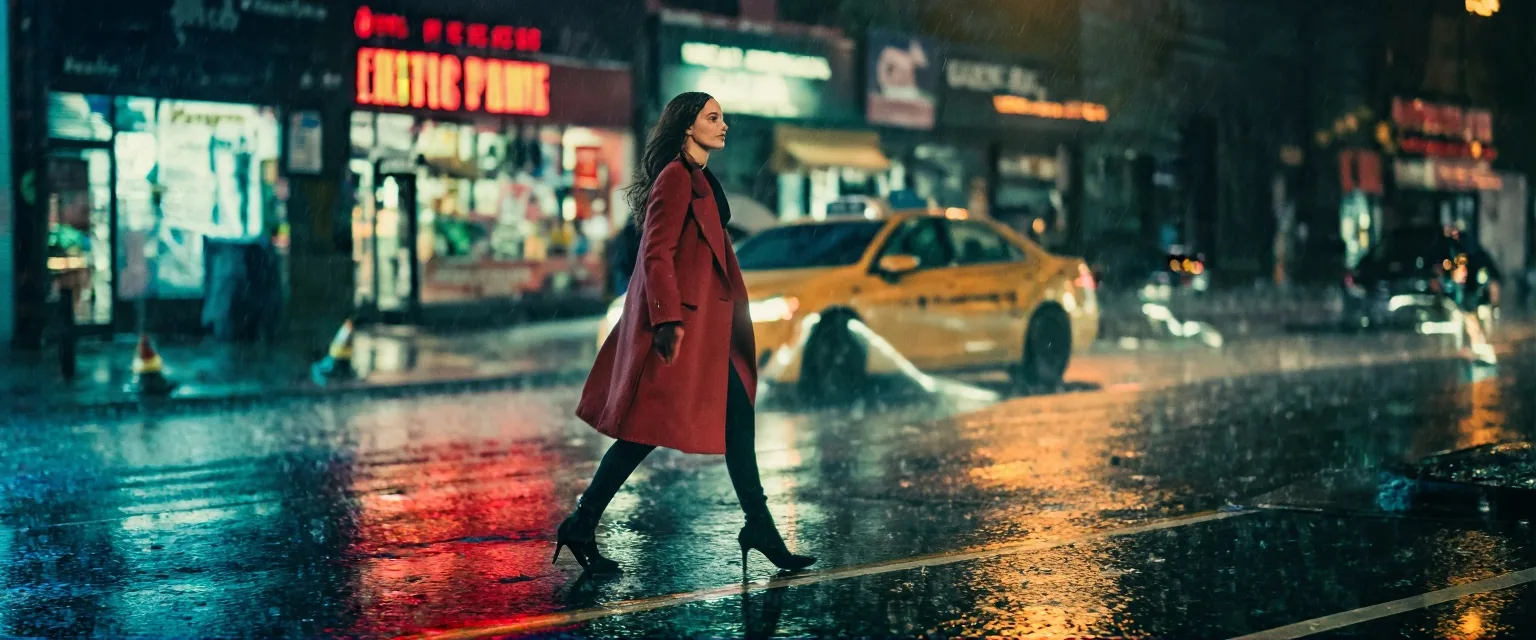
Z-Image Base LoRA, texto a imagen, 21:9, sin LoRA.
Qué se suaviza
Ningún filtro de contenido se interpone delante del modelo. En nuestra escalera, con adultos indicados en cada prompt, el texto a imagen entregó tal como se escribió L1 Sugerente (lencería, un tirante que se desliza), L2 Temas maduros, L3 Fuerte, L5 Extremo (ataduras consentidas entre adultos, o gore cinematográfico) y la versión masculina de L3. L4 Intenso (una escena íntima entre dos adultos) volvió suavizado en tres intentos: los seeds dieron figuras y algo de contacto, pero ninguna escena coherente. La imagen a imagen sobre una fuente vestida se comportó igual: los niveles inferiores se entregaron, L3 desde una fuerza de 0.8 (con 0.7 fue parcial) y L4 se suavizó.
Así que el resumen honesto es que Base por sí solo dibuja mal ese nivel superior. Los LoRA entrenados para ello son la vía prevista, con la misma regla de solo Base de más arriba. No probamos imagen a imagen con tres LoRA, ni LoRA desde enlaces de Civitai.
Z-Image Base LoRA o Z-Image Turbo LoRA
La comparación que hace el propio publicador de los dos modelos:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Pasos | De 28 a 50 | 8 |
| CFG | sí | no |
| Se puede ajustar | sí | no |
| Prompt negativo | sí (este endpoint no lo expone) | no |
| Diversidad | Alta | Baja |
| Calidad visual | Alta | Muy alta |
Z-Image Turbo LoRA es el modelo destilado de 8 pasos con hasta tres LoRA entrenados para Turbo, de alrededor de un megapíxel en nueve relaciones, y su fuerza por defecto en imagen a imagen es 0.8. Para ver cómo se comporta un adaptador de Turbo, consulta nuestra prueba de Turbo LoRA con el mismo seed. Las dos familias no comparten LoRA. Un archivo de Turbo en Base rompió la imagen en nuestra prueba; no probamos lo contrario, así que no supongas que un archivo de Base es seguro en Turbo.
| Lo que quieres | Elige |
|---|---|
| Un LoRA entrenado sobre Z-Image Base | Z-Image Base LoRA |
| Un LoRA entrenado sobre Z-Image Turbo | Z-Image Turbo LoRA |
| La respuesta más rápida, en segundos | Turbo; Base tardó una mediana de 32.8 s en texto a imagen |
| De foto a ilustración con un LoRA de estilo | Edición en Base con fuerza de alrededor de 0.6, con un LoRA de estilo entrenado sobre Base |
| Prompts sencillos con fuerte adherencia, sin LoRA | Cualquiera; Base siguió de cerca la redacción en nuestras pruebas |
| Control sobre pasos, guidance o prompt negativo | Ningún endpoint los expone |
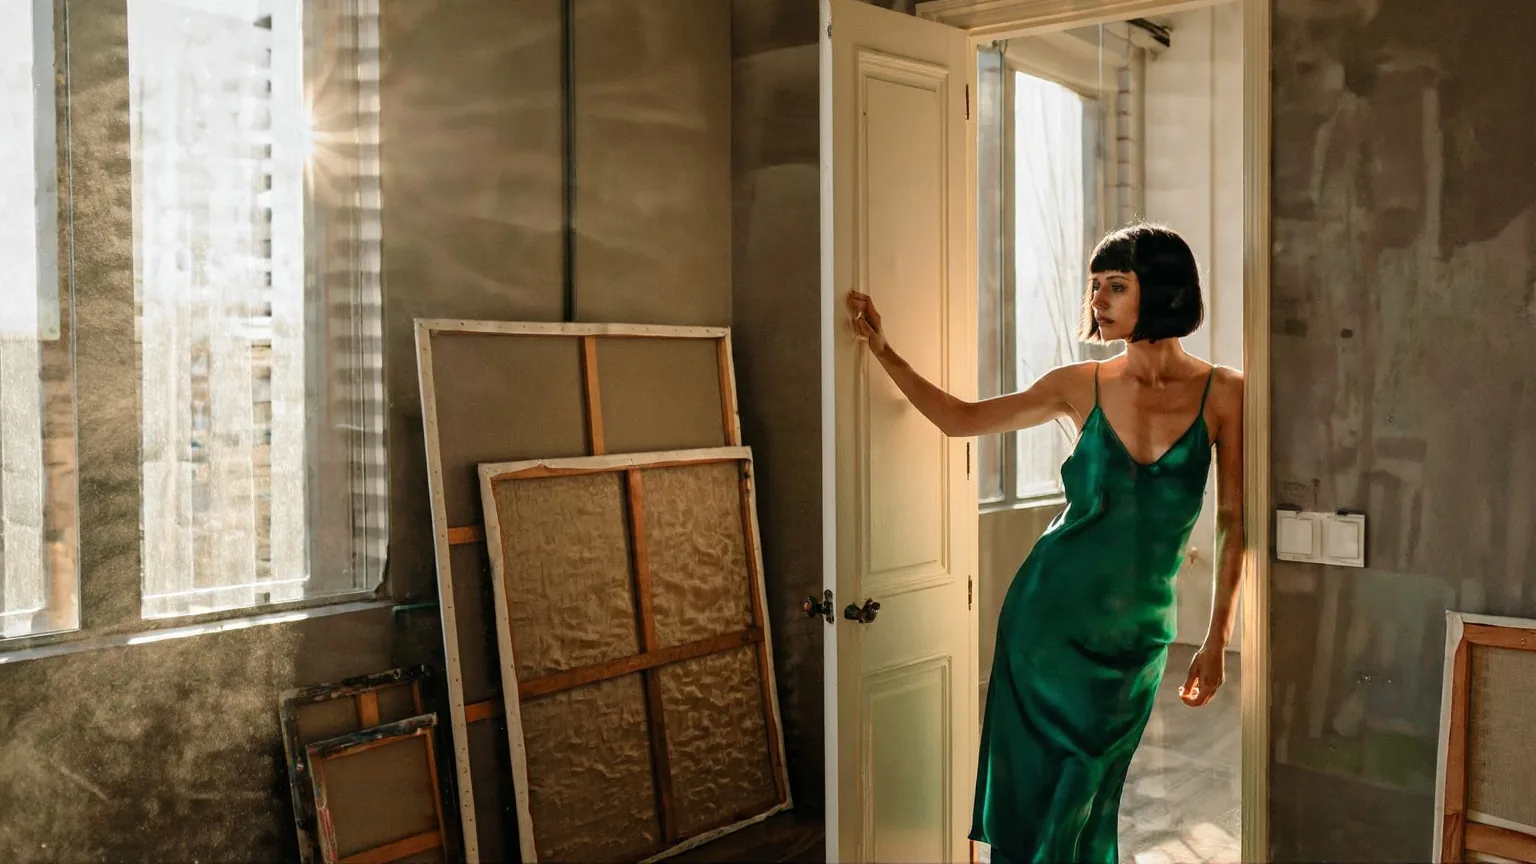
Z-Image Base LoRA, texto a imagen, sin LoRA, un prompt de retrato cinematográfico de nuestro conjunto de portadas.
Preguntas frecuentes
¿Puedo usar un LoRA de Z-Image Turbo en Base?
No. En nuestra prueba, un LoRA entrenado para Turbo se cargó en Base sin error y rompió la imagen en ruido y pseudotexto. Usa archivos entrenados sobre Z-Image Base.
¿Por qué mi LoRA de Z-Image no cambió nada?
Probablemente se guardó con otro formato de claves o se entrenó para otro modelo. Un archivo etiquetado para Z-Image pero guardado de otra manera, y un LoRA de Pony, se cargaron y dieron un resultado idéntico píxel por píxel. Corre un par con y sin él.
¿Qué fuerza debo usar en edición?
Empieza con el valor por defecto de 0.7, o alrededor de 0.6 con un LoRA de estilo para conservar la composición. En nuestra escalera, 0.3 y 0.5 apenas cambiaron la foto, 0.75 volvió a montar la escena y 0.85 dio una imagen nueva.
¿Puede seguir instrucciones como "make it black and white"?
No. Sin un LoRA, el blanco y negro se quedó a color con 0.65 y 0.8, y una petición de esmoquin cambió poco. Redibuja a partir de tu descripción, así que usa un LoRA de estilo para el aspecto.
¿Qué tamaños puedo usar?
Nueve relaciones de aspecto para texto a imagen, hasta 1536 por lado, y 1k o 1.5k para el lado largo en edición. Una solicitud de 200×200 o de 2048×2048 falló en nuestras pruebas.
¿Qué tan lento es Base?
El texto a imagen tardó de 9.8 a 56.7 segundos, con una mediana de 32.8 en 36 ejecuciones. Las ediciones tardaron de 4.9 a 41.7 segundos, con una mediana de 16.8 en 28 ejecuciones.
¿Base dibuja las escenas más íntimas?
No de forma convincente por sí solo. En tres intentos, ese nivel volvió suavizado, mientras que los niveles inferiores se generaron tal como se escribieron. Los LoRA entrenados para ello son la forma de llegar más lejos.
¿Puedo fijar los pasos, el guidance o un prompt negativo?
No. El endpoint no tiene esos campos, aunque el publicador recomienda de 28 a 50 pasos para el modelo.