Sur Z-Image Base LoRA, utilisez des LoRA entraînées sur Z-Image Base : une LoRA entraînée pour Z-Image Turbo a détruit l’image en bruit et en pseudo-texte quand nous l’avons chargée sur Base le 5 octobre 2026. Base est le modèle plus lent, non distillé, sur lequel la communauté entraîne ; sa médiane en texte vers image était donc de 32,8 secondes sur nos 36 exécutions. Pour les retouches, le strength par défaut est de 0,7, et autour de 0,6 avec une LoRA de style, tout le cadre a changé de style tout en conservant exactement la composition.
Z-Image Base LoRA fait tourner Z-Image Base de Tongyi-MAI chez Alibaba, un transformeur de diffusion à flux unique de 6 milliards de paramètres, avec jusqu’à trois de vos propres LoRA, en texte vers image comme en image vers image. La fiche du modèle présente Base comme le fondement de la famille Z-Image, conçu pour le développement et point de départ idéal pour la communauté ; il prend en charge l’entraînement de LoRA parce qu’il n’est pas distillé. Les points d’accès sont sans censure : la plateforme n’ajoute aucun filtre de contenu. Une limite honnête d’abord : le modèle de base seul dessine mal les scènes les plus intimes, ce qui est précisément à quoi servent les LoRA pour adultes. Chaque prompt de ce guide est une scène du quotidien avec des adultes habillés.
En un coup d’œil
| Question | Réponse (testé le 5 octobre 2026) |
|---|---|
| Modèle | Z-Image Base de Tongyi-MAI (Alibaba), 6 milliards de paramètres |
| Noms de modèle dans l’API | alibaba/z-image-base-lora/text-to-image et alibaba/z-image-base-lora/edit |
| Champ LoRA | loras : jusqu’à 3 entrées, chacune {path, scale}, scale de 0 à 4 |
| Bonnes LoRA | Fichiers entraînés sur Z-Image Base |
| Mauvaises LoRA | Entraînées pour Turbo : l’image est détruite. LoRA Pony ou fichiers enregistrés autrement : aucune erreur, aucun changement |
| Strength en édition | De 0 à 1, 0,7 par défaut |
| Formats en texte vers image | Neuf rapports d’aspect, chaque côté jusqu’à 1536 |
| Formats en édition | resolution 1k ou 1.5k fixe le grand côté ; le rapport d’aspect de la source est conservé |
| Vitesse dans nos tests | Texte vers image de 9,8 à 56,7 s, médiane 32,8 (36 exécutions) ; édition de 4,9 à 41,7 s, médiane 16,8 (28 exécutions) |
| Non exposés | Étapes, guidance et prompt négatif |
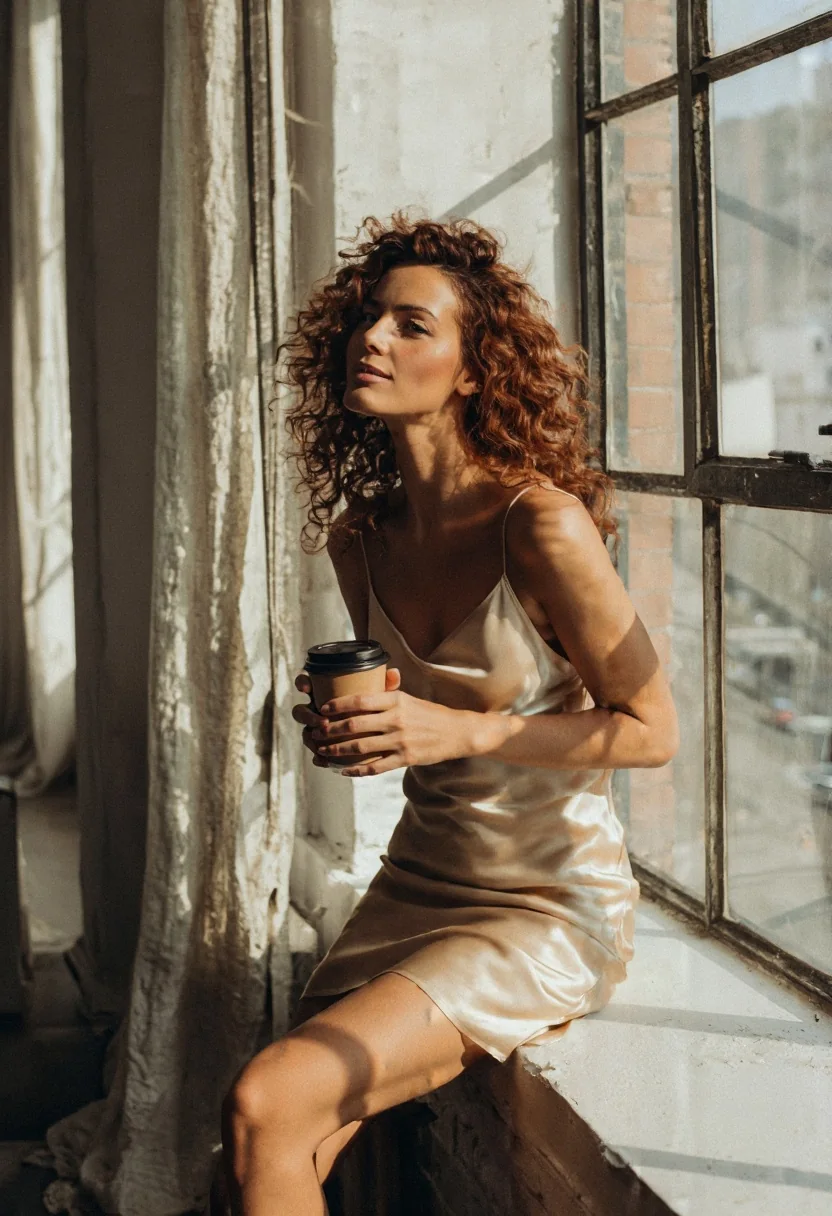
Z-Image Base LoRA, texte vers image, 2:3 (832×1216), seed 41, sans LoRA. Le prompt est reproduit dans la section suivante.
Prompts : des phrases simples, une forte fidélité
La fidélité au prompt de Base était forte dans nos tests. Écrivez comme si vous briefiez un photographe : sujet, vêtements, lieu, lumière, grain. Le portrait de loft ci-dessus vient d’une seule phrase :
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.La même forme de phrase, avec seulement le sujet changé, a donné un boxeur dans une vieille salle de sport :
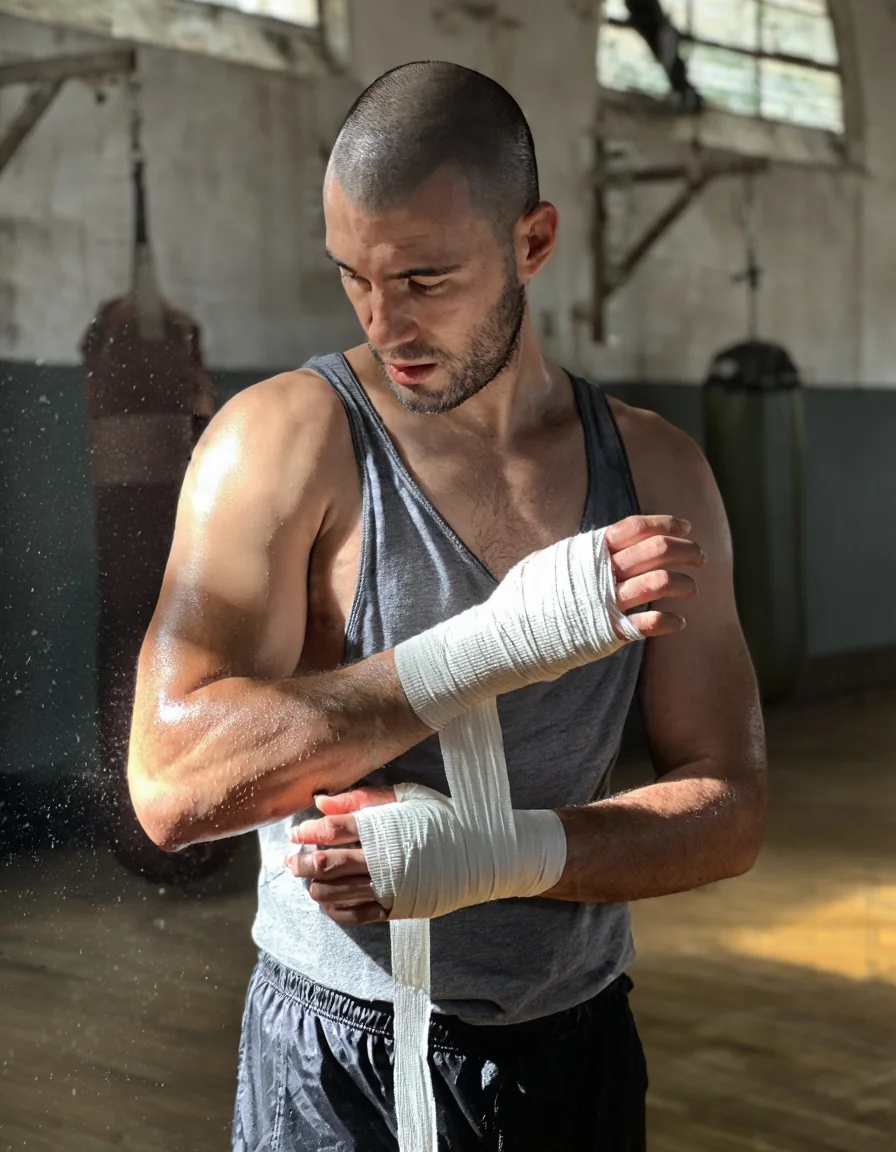
Z-Image Base LoRA, texte vers image, 3:4 (896×1152), seed 42, sans LoRA.
Il n’y a ni prompt négatif, ni guidance, ni champ d’étapes. L’éditeur recommande une guidance de 3,0 à 5,0 et 28 à 50 étapes pour le modèle lui-même, mais ce point d’accès n’expose rien de cela : le ton et le style viennent donc du prompt et de la LoRA.
Quelles LoRA fonctionnent sur Base
C’est la question à laquelle cette famille doit répondre, nous avons donc essayé quatre sortes de fichiers :
| LoRA | Entraînée pour | Ce qui s’est passé |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | A fonctionné à 0,5 et à 1 |
| Une LoRA Z-Image Turbo | Z-Image Turbo | Chargée sans erreur et a détruit l’image (bruit et pseudo-texte) |
furaidosu/flat-cartoon-zimage, étiquetée pour Z-Image | Un autre format de clés | Chargée sans erreur, sortie identique au pixel près : aucun changement |
| Une LoRA Pony | Pony SDXL | Chargée sans erreur, sortie identique au pixel près : aucun changement |
Deux échecs sont silencieux et un semble bruyant. Un fichier mal étiqueté, ou issu d’un autre modèle de base, ne change rien, et vous pouvez accuser votre prompt pendant une heure ; un fichier Turbo sur Base fait un gâchis, ce qui vous dit au moins que quelque chose cloche. Lancez une paire avec le fichier et une sans, même seed, avant de construire quoi que ce soit sur un adaptateur. Si elles sont identiques, le fichier ne fait rien ici ; si le résultat est du bruit, il a été entraîné pour Turbo.
Hugging Face répertorie des adaptateurs dont le modèle de base est Tongyi-MAI/Z-Image. Nous n’avons récupéré que les 40 premiers par nombre de téléchargements : surtout des LoRA de ressemblance avec des personnes réelles, plus quelques LoRA de style. Nous n’avons pas compté toute la liste, nous ne donnons donc aucun chiffre.
Liste de contrôle avant de choisir une LoRA :
- Modèle de base : la fiche indique Z-Image Base, ou Tongyi-MAI/Z-Image, pas Turbo, Pony ni FLUX.
- Un fichier que vous pouvez lier : le dépôt contient un fichier
.safetensorset vous pouvez construire son lienresolve/main/. - Accès public : un fichier verrouillé échoue avec un message HTTP 401.
- Phrase déclencheuse : copiez-la exactement depuis la fiche.
- Licence : lisez celle de la fiche de la LoRA elle-même.
La LoRA mikkoani : une phrase, un autre rendu
La LoRA mikkoani s’active avec sa phrase, mature illustration with muted color and complex linework, au début du prompt. Voici une scène de salle de bal avec la LoRA à l’échelle 1 :
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}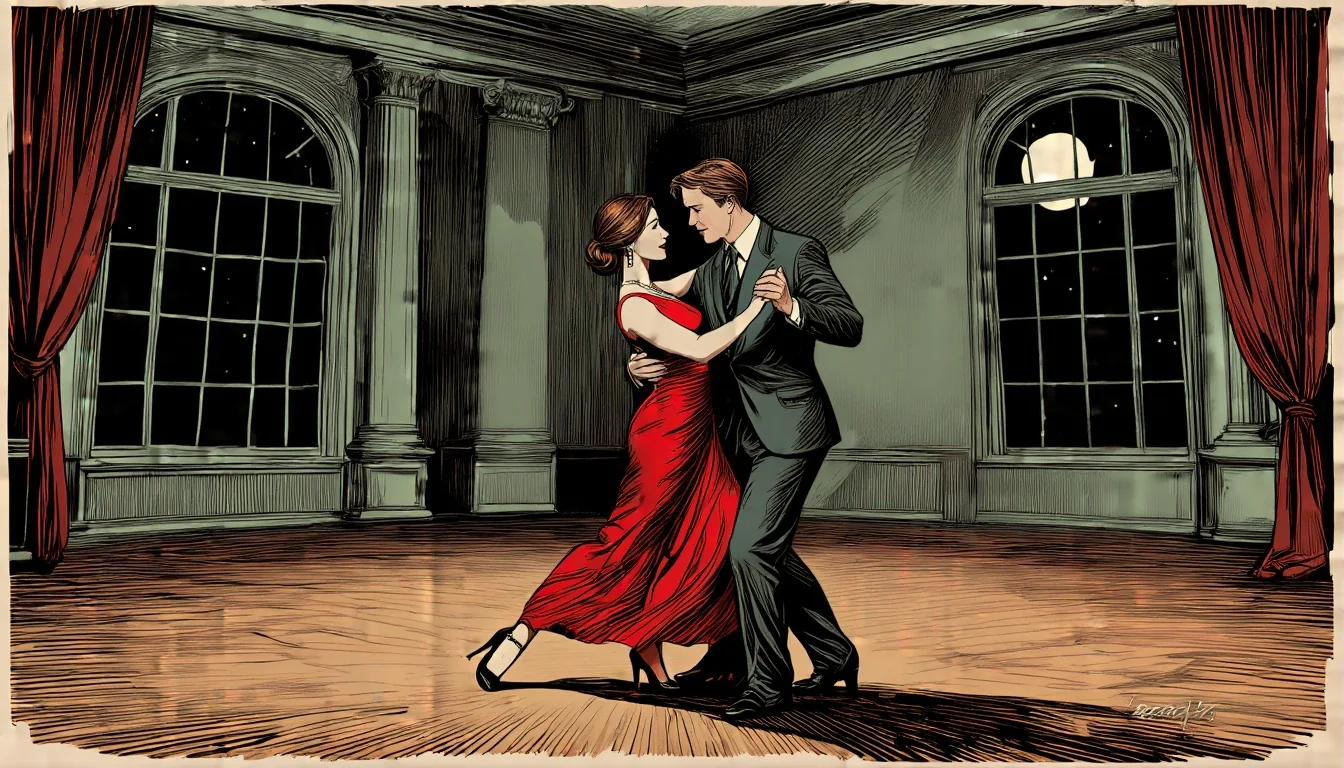
Z-Image Base LoRA, texte vers image, 16:9 (1344×768), seed 43, LoRA mikkoani à l’échelle 1.
Un autre constat à connaître : la phrase seule, sans la LoRA, suffisait déjà à orienter un prompt photo vers l’illustration. Base suit très fidèlement la formulation, donc une phrase déclencheuse peut porter une partie du style même si le fichier ne se charge pas. Cela rend la paire avec et sans un peu moins évidente : comparez la qualité du trait et la palette, pas seulement le genre.
Strength en édition : l’échelle
Le point d’accès d’édition prend une image source, un strength de 0 à 1 et le même champ loras. Notre valeur publique par défaut est 0,7 ; celle du service en amont est 0,6. Nous avons fait une échelle sur une photo sans LoRA :
| Strength | Ce que nous avons vu |
|---|---|
| 0,3 et 0,5 | Presque inchangé |
| 0,6 | Léger changement |
| 0,7 | Le contenu commence à changer ; composition conservée |
| 0,75 | La scène est repositionnée et remise en scène, lumière et palette conservées |
| 0,85 | Une nouvelle image |
Avec une LoRA de style, l’image change : à 0,6, elle a changé le style de tout le cadre en gardant exactement la composition. C’est le bon réglage pour transformer une photo en illustration.
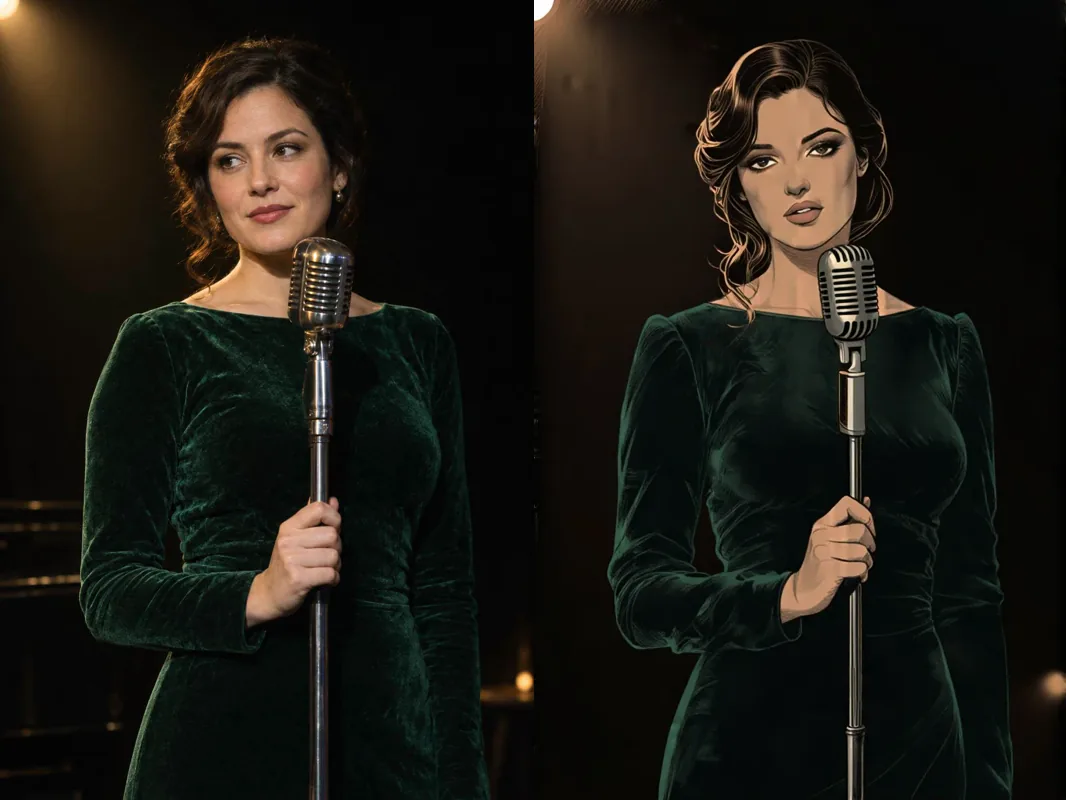
À gauche : notre photo source générée. À droite : Z-Image Base LoRA, image vers image, 1k, seed 51, LoRA mikkoani à l’échelle 1, strength 0,6.
Le prompt d’édition décrit toute l’image souhaitée, pas seulement le changement :
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Une deuxième source, un homme sur un toit au coucher du soleil, en chemise de lin blanche ouverte, au même strength :
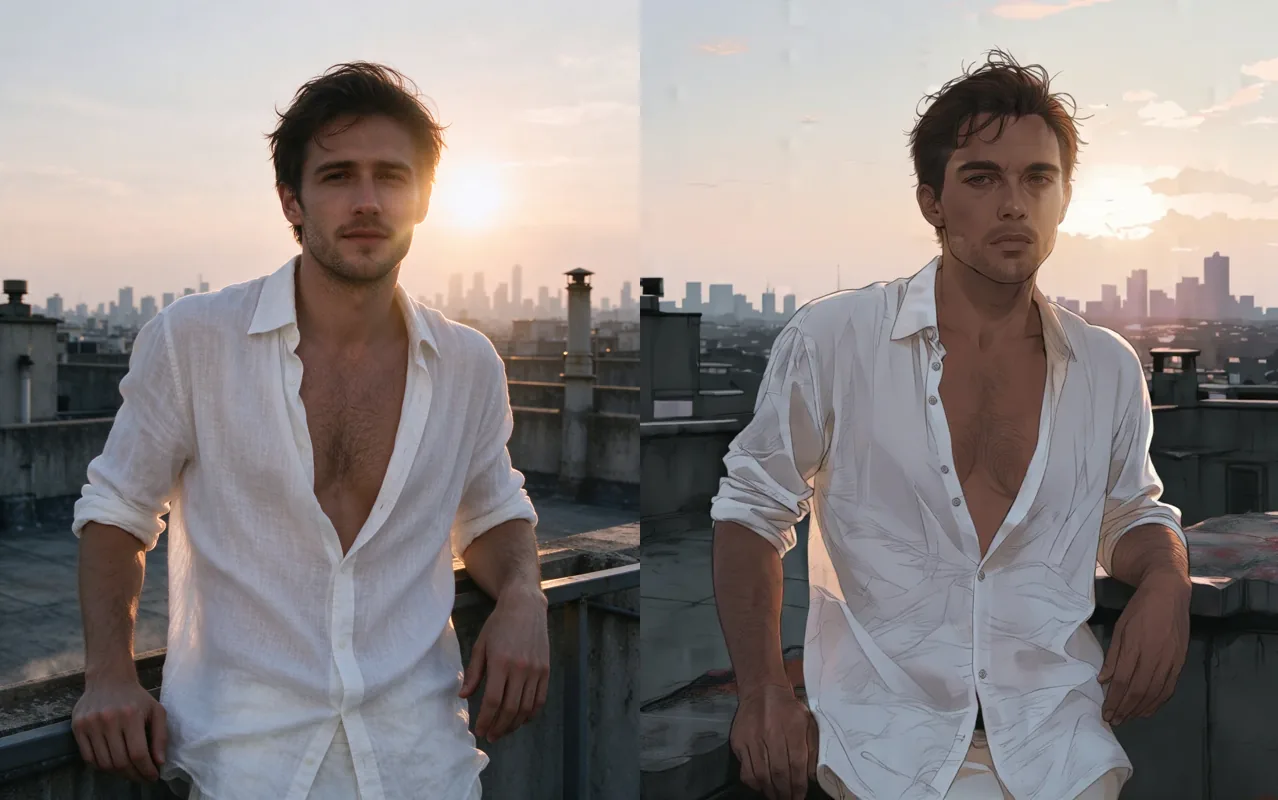
À gauche : notre photo source générée. À droite : Z-Image Base LoRA, image vers image, 1k, seed 54, LoRA mikkoani à l’échelle 1, strength 0,6.
Et une source large à 1.5k et un strength de 0,65 :
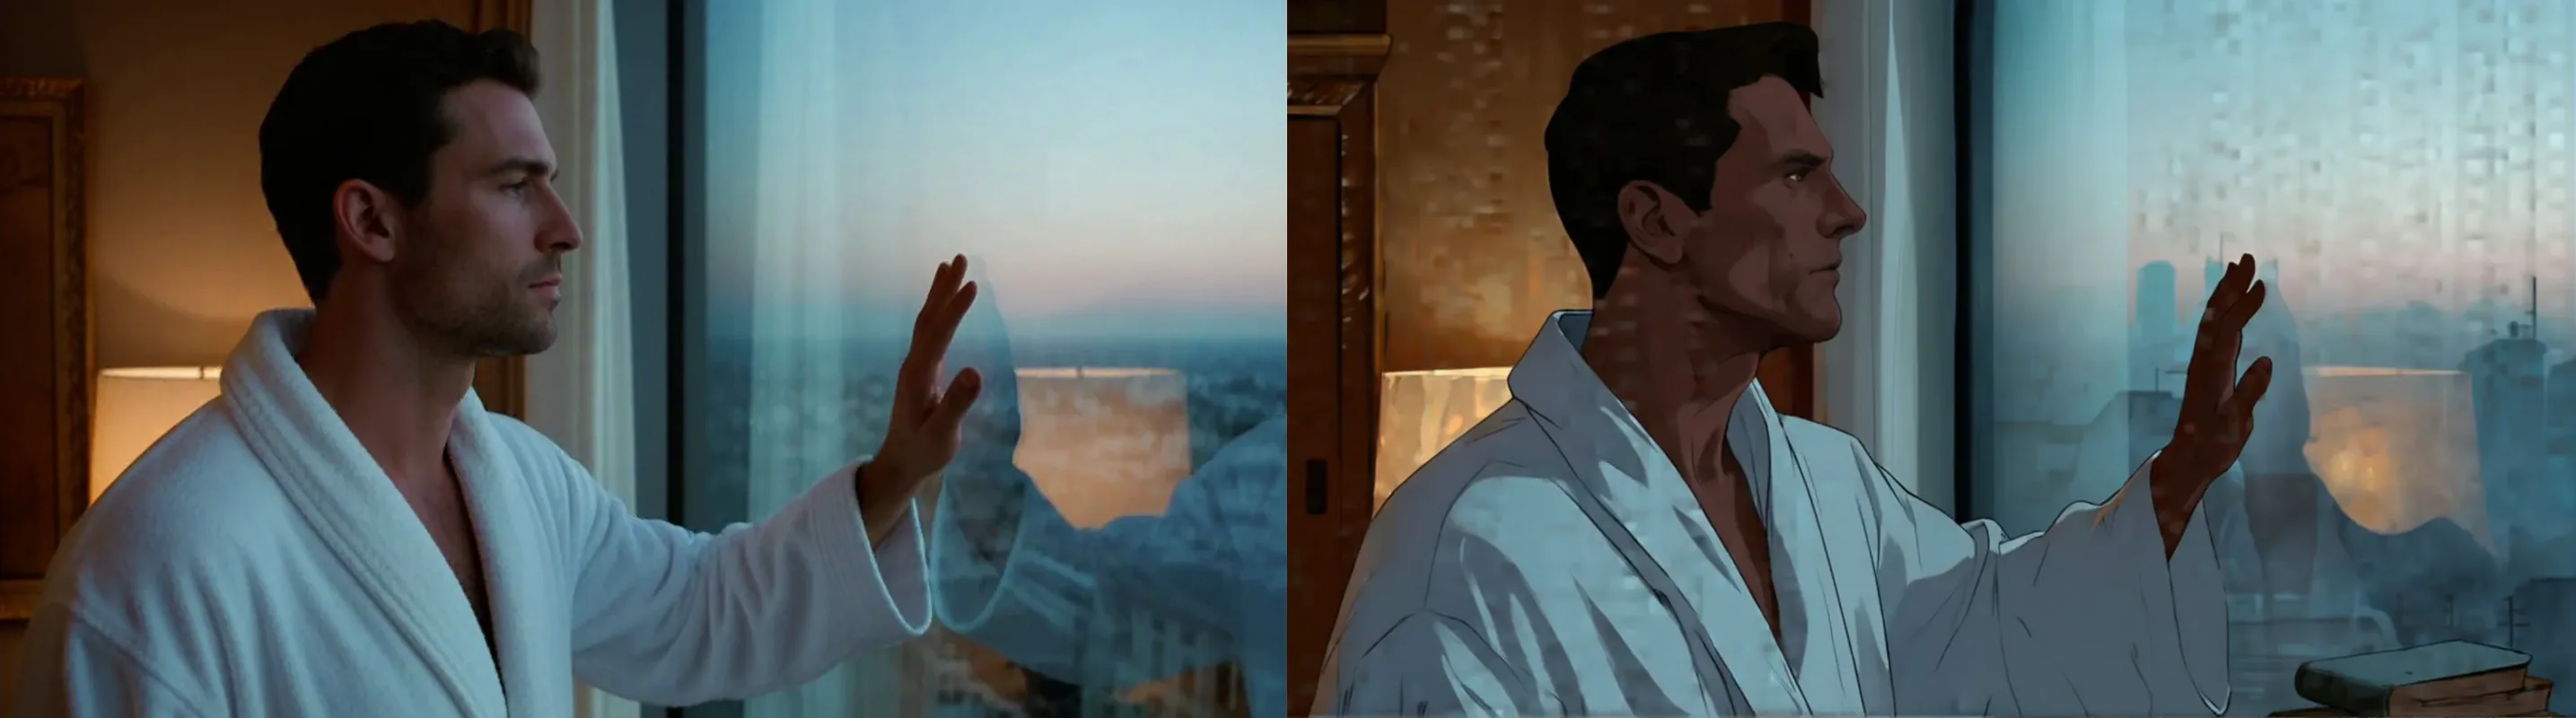
À gauche : notre photo source générée. À droite : Z-Image Base LoRA, image vers image, 1.5k, seed 55, LoRA mikkoani à l’échelle 1, strength 0,65.
Il change le style ; il ne suit pas les instructions
Sans LoRA, « make it black and white » est resté en couleur aux strengths 0,65 et 0,8, et « put him in a tuxedo » a peu changé à 0,7 et 0,8. Le modèle redessine le cadre à partir de votre description. Pour changer de médium, apportez une LoRA de style ; pour une scène différente, décrivez-la en entier et montez le strength. Les détails sont sur la page d’édition.
Formats
Le texte vers image propose neuf rapports d’aspect sur des tailles natives SDXL, et les neuf se sont terminés exactement à la taille demandée :
| Rapport | Taille | Rapport | Taille |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
Le service en amont accepte de 256 à 1536 par côté : 1536×1536 et 256×256 se sont terminés, tandis que 1600×896, 2048×2048 et 200×200 ont échoué avec une erreur de contrainte de taille. En édition, resolution ne fixe que le grand côté et le rapport de la source est conservé : une photo 2:3 en 1k est revenue en 680×1024, et une photo 16:9 en 1.5k en 1536×856.
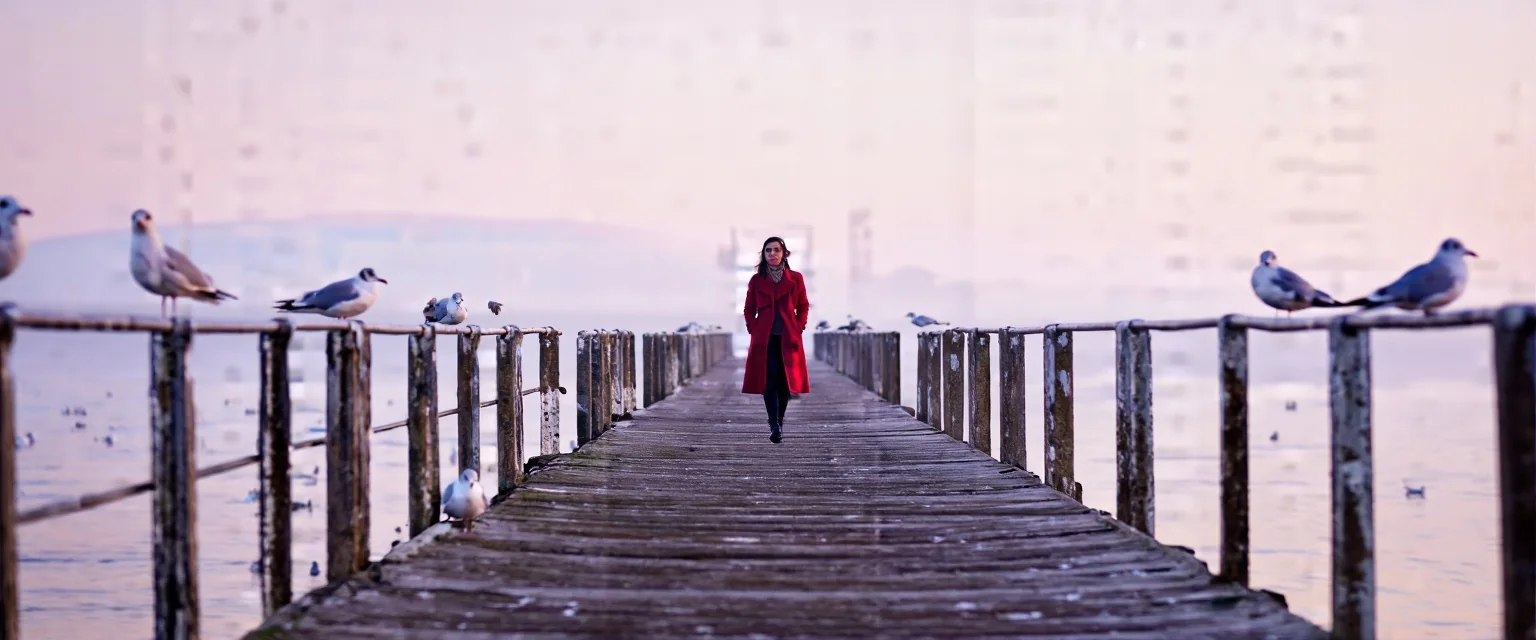
Z-Image Base LoRA, texte vers image, 21:9 (1536×640), seed 45, sans LoRA.
La même forme large convient aux scènes de rue :
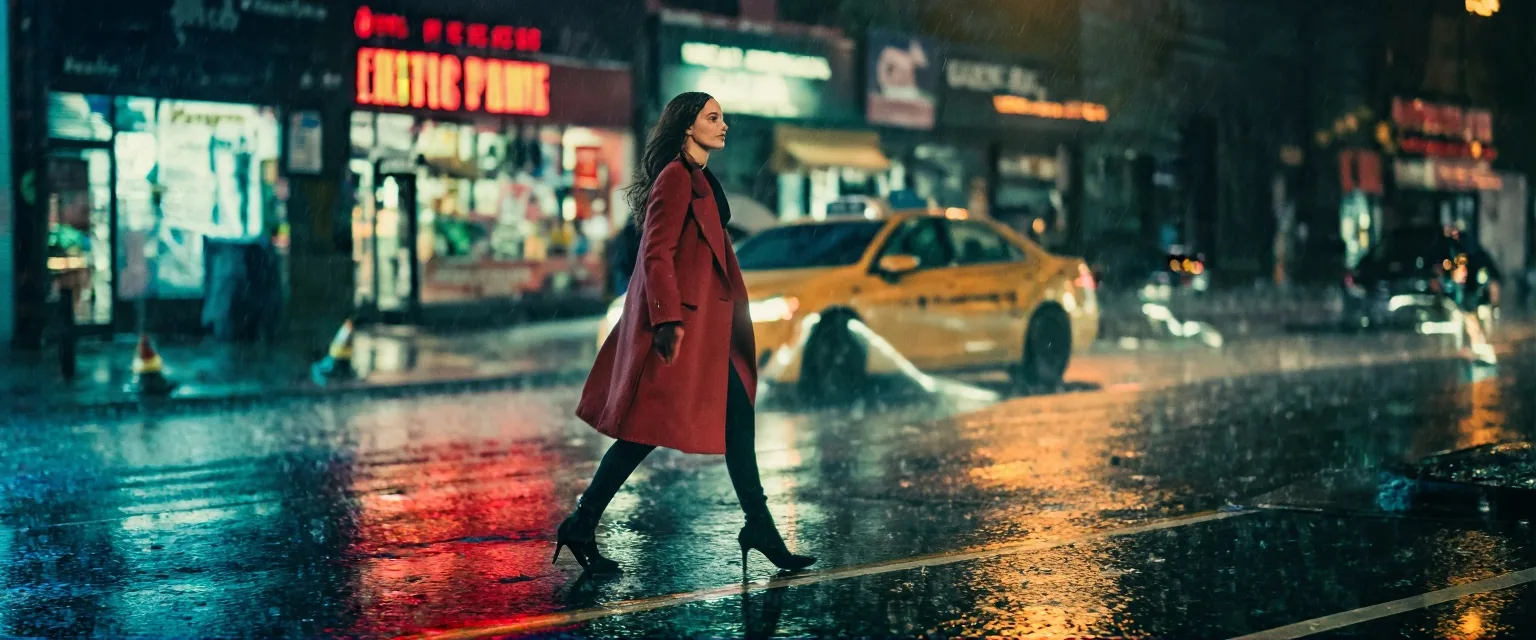
Z-Image Base LoRA, texte vers image, 21:9, sans LoRA.
Ce qui s’atténue
Aucun filtre de contenu ne se trouve devant le modèle. Dans notre échelle, avec des adultes précisés dans chaque prompt, le texte vers image a rendu comme écrit L1 Suggestif (lingerie, une bretelle qui glisse), L2 Thèmes matures, L3 Fort, L5 Extrême (contrainte consentie entre adultes, ou gore cinématographique), ainsi que la version masculine de L3. L4 Intense (une scène intime entre deux adultes) est revenu atténué en trois essais : les seeds ont donné des silhouettes et un peu de contact, mais aucune scène cohérente. L’image vers image sur une source habillée s’est comportée de la même façon : les paliers inférieurs sont passés, L3 à partir d’un strength de 0,8 (0,7 était partiel), et L4 s’est atténué.
Le résumé honnête est donc que Base lui-même dessine mal ce palier supérieur. Les LoRA entraînées pour cela sont la voie prévue, avec la même règle « Base uniquement » que plus haut. Nous n’avons pas testé l’image vers image avec trois LoRA, ni des LoRA issues de liens Civitai.
Z-Image Base LoRA ou Z-Image Turbo LoRA
La comparaison des deux modèles par l’éditeur lui-même :
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Étapes | 28 à 50 | 8 |
| CFG | oui | non |
| Affinable | oui | non |
| Prompt négatif | oui (non exposé par ce point d’accès) | non |
| Diversité | Élevée | Faible |
| Qualité visuelle | Élevée | Très élevée |
Z-Image Turbo LoRA est le modèle distillé en 8 étapes avec jusqu’à trois LoRA entraînées pour Turbo, environ un mégapixel en neuf rapports, et son strength par défaut en image vers image est de 0,8. Pour voir comment se comporte un adaptateur Turbo, consultez notre test à seed identique sur Turbo LoRA. Les deux familles ne partagent pas leurs LoRA. Un fichier Turbo sur Base a détruit l’image dans notre test ; nous n’avons pas testé l’inverse, ne supposez donc pas qu’un fichier Base soit sans risque sur Turbo.
| Vous voulez | Choisissez |
|---|---|
| Une LoRA entraînée sur Z-Image Base | Z-Image Base LoRA |
| Une LoRA entraînée sur Z-Image Turbo | Z-Image Turbo LoRA |
| La réponse la plus rapide, en quelques secondes | Turbo ; Base a pris une médiane de 32,8 s en texte vers image |
| Photo vers illustration avec une LoRA de style | Édition Base à un strength d’environ 0,6, avec une LoRA de style entraînée sur Base |
| Des prompts simples à forte fidélité, sans LoRA | L’un ou l’autre ; Base a suivi de près la formulation dans nos tests |
| Contrôle des étapes, de la guidance ou du prompt négatif | Aucun des deux points d’accès ne les expose |
Z-Image Base LoRA, texte vers image, sans LoRA, un prompt de portrait cinématographique de notre série de couvertures.
FAQ
Puis-je utiliser une LoRA Z-Image Turbo sur Base ?
Non. Dans notre test, une LoRA entraînée pour Turbo s’est chargée sur Base sans erreur et a détruit l’image en bruit et en pseudo-texte. Utilisez des fichiers entraînés sur Z-Image Base.
Pourquoi ma LoRA Z-Image n’a-t-elle rien changé ?
Elle était probablement enregistrée dans un autre format de clés ou entraînée pour un autre modèle. Un fichier étiqueté pour Z-Image mais enregistré autrement, et une LoRA Pony, se sont tous deux chargés et ont donné une sortie identique au pixel près. Lancez une paire avec et sans.
Quel strength utiliser en édition ?
Commencez à 0,7 par défaut, ou vers 0,6 avec une LoRA de style pour garder la composition. Dans notre échelle, 0,3 et 0,5 ont à peine changé la photo, 0,75 a remis la scène en scène et 0,85 a donné une nouvelle image.
Peut-il suivre des instructions comme « make it black and white » ?
Non. Sans LoRA, le noir et blanc est resté en couleur à 0,65 et 0,8, et une demande de smoking a peu changé. Il redessine à partir de votre description : utilisez une LoRA de style pour le rendu.
Quels formats puis-je utiliser ?
Neuf rapports d’aspect en texte vers image, jusqu’à 1536 par côté, et 1k ou 1.5k pour le grand côté en édition. Une requête en 200×200 ou 2048×2048 a échoué dans nos tests.
Base est-il lent ?
Le texte vers image a pris de 9,8 à 56,7 secondes, avec une médiane de 32,8 sur 36 exécutions. Les éditions ont pris de 4,9 à 41,7 secondes, avec une médiane de 16,8 sur 28 exécutions.
Base dessine-t-il les scènes les plus intimes ?
Pas de façon convaincante seul. En trois essais, ce palier est revenu atténué, alors que les paliers inférieurs se sont rendus comme écrit. Les LoRA entraînées pour cela sont le moyen d’aller plus loin.
Puis-je régler les étapes, la guidance ou un prompt négatif ?
Non. Le point d’accès n’a pas de tels champs, même si l’éditeur recommande 28 à 50 étapes pour le modèle.