Verwenden Sie bei Z-Image Base LoRA LoRAs, die auf Z-Image Base trainiert wurden: Eine für Z-Image Turbo trainierte LoRA zerlegte das Bild in Rauschen und Pseudotext, als wir sie am 5. Oktober 2026 auf Base luden. Base ist das langsamere, nicht destillierte Modell, auf dem die Community trainiert; der Median für Text-zu-Bild lag in unseren 36 Läufen deshalb bei 32,8 Sekunden. Beim Bearbeiten beträgt die Standardstärke 0,7, und mit einer Stil-LoRA ordnete etwa 0,6 das ganze Bild stilistisch neu, ohne die Komposition zu verändern.
Z-Image Base LoRA betreibt Z-Image Base von Tongyi-MAI bei Alibaba, einen Single-Stream-Diffusion-Transformer mit 6 Milliarden Parametern, mit bis zu drei eigenen LoRAs sowohl bei Text-zu-Bild als auch bei Bild-zu-Bild. Die Modellkarte nennt Base das Fundament der Z-Image-Familie, gedacht für die Entwicklung und einen idealen Ausgangspunkt für die Community; es unterstützt LoRA-Training, weil es nicht destilliert ist. Die Endpunkte sind unzensiert: Die Plattform fügt keinen Content-Filter hinzu. Eine ehrliche Grenze vorab: Das Basismodell allein zeichnet die intimsten Szenen schlecht, und genau dafür gibt es Adult-LoRAs. Jeder Prompt in diesem Guide ist eine Alltagsszene mit bekleideten Erwachsenen.
Auf einen Blick
| Frage | Antwort (getestet am 5. Oktober 2026) |
|---|---|
| Modell | Z-Image Base von Tongyi-MAI (Alibaba), 6 Milliarden Parameter |
| API-Modellnamen | alibaba/z-image-base-lora/text-to-image und alibaba/z-image-base-lora/edit |
| LoRA-Feld | loras: bis zu 3 Einträge, jeweils {path, scale}, scale 0 bis 4 |
| Passende LoRAs | Auf Z-Image Base trainierte Dateien |
| Unpassende LoRAs | Auf Turbo trainiert: zerstörte das Bild. Pony oder anders gespeicherte Dateien: kein Fehler, keine Änderung |
| Stärke beim Bearbeiten | 0 bis 1, Standardwert 0,7 |
| Größen bei Text-zu-Bild | Neun Seitenverhältnisse, jede Seite bis 1536 |
| Größen beim Bearbeiten | resolution 1k oder 1.5k legt die lange Seite fest; das Seitenverhältnis der Quelle bleibt erhalten |
| Tempo in unseren Tests | Text-zu-Bild 9,8 bis 56,7 s, Median 32,8 (36 Läufe); Bearbeiten 4,9 bis 41,7 s, Median 16,8 (28 Läufe) |
| Nicht verfügbar | Schritte, Guidance und negativer Prompt |
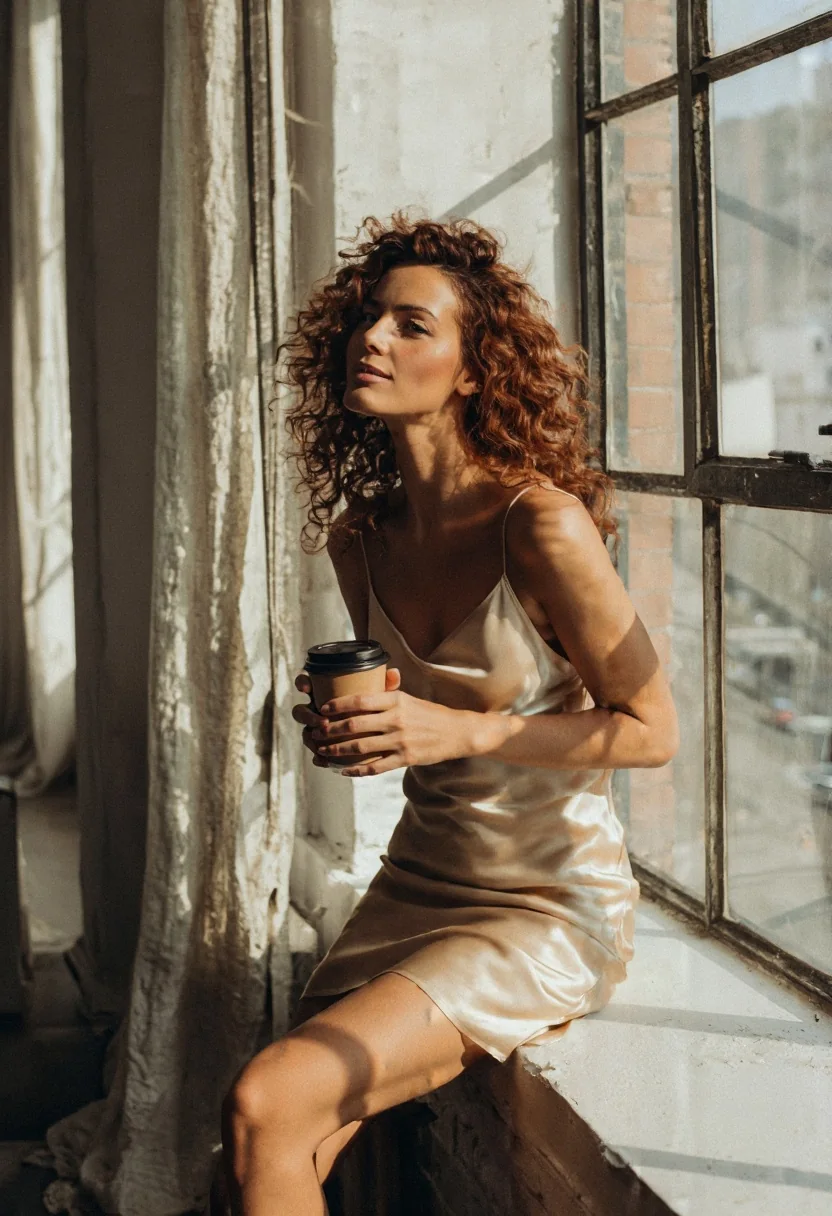
Z-Image Base LoRA, Text-zu-Bild, 2:3 (832×1216), Seed 41, keine LoRA. Der Prompt steht im nächsten Abschnitt.
Prompts: schlichte Sätze, starke Prompt-Treue
Die Prompt-Treue von Base war in unseren Tests stark. Schreiben Sie so, wie Sie einen Fotografen briefen würden: Motiv, Kleidung, Ort, Licht, Korn. Das Loft-Porträt oben entstand aus einem einzigen Satz:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.Dieselbe Satzform, bei der nur das Motiv getauscht wurde, trug einen Boxer in einer alten Halle:
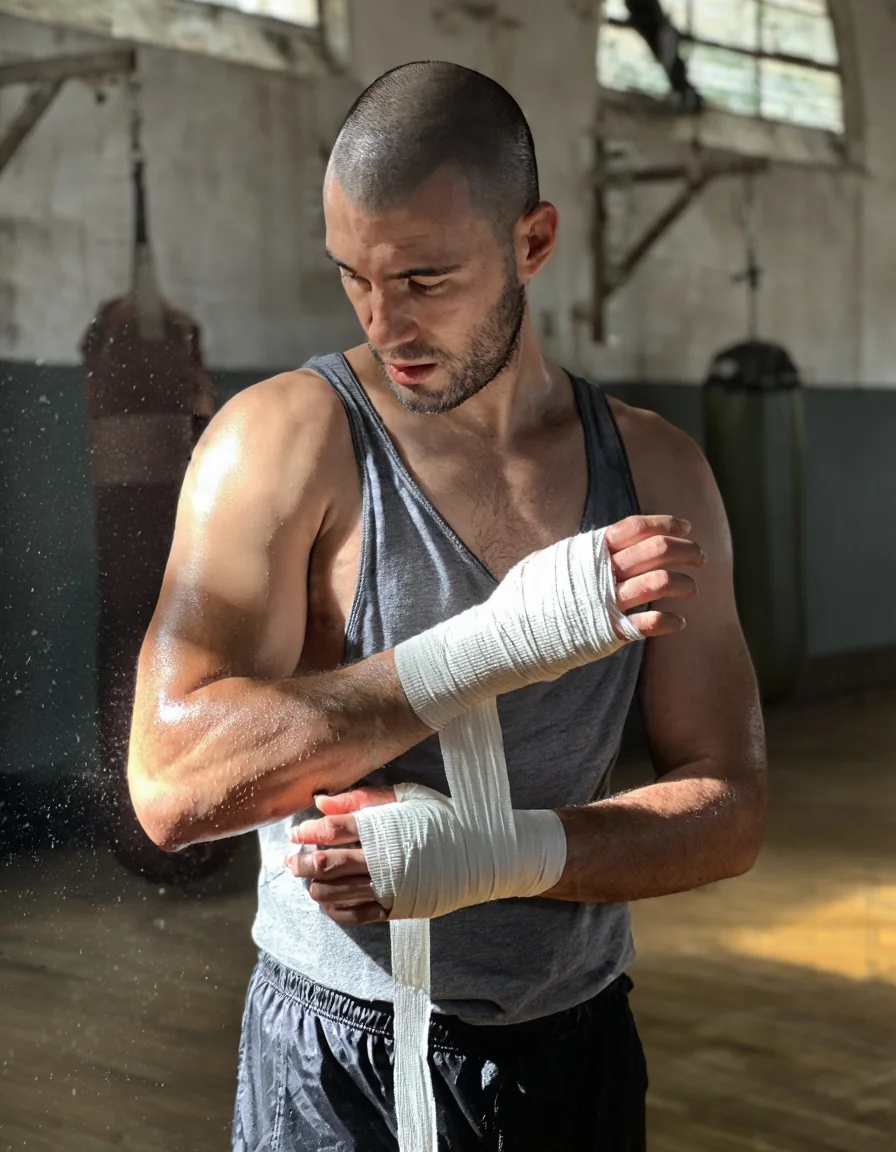
Z-Image Base LoRA, Text-zu-Bild, 3:4 (896×1152), Seed 42, keine LoRA.
Es gibt kein Feld für negativen Prompt, Guidance oder Schritte. Der Anbieter empfiehlt für das Modell selbst Guidance 3,0 bis 5,0 und 28 bis 50 Schritte, aber dieser Endpunkt stellt nichts davon bereit; Ton und Stil kommen also aus dem Prompt und der LoRA.
Welche LoRAs auf Base funktionieren
Auf diese Frage zielt die Familie, daher haben wir vier Arten von Dateien ausprobiert:
| LoRA | Trainiert für | Was geschah |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Funktionierte mit 0,5 und mit 1 |
| Eine Z-Image-Turbo-LoRA | Z-Image Turbo | Lud ohne Fehler und zerstörte das Bild (Rauschen und Pseudotext) |
furaidosu/flat-cartoon-zimage, für Z-Image ausgewiesen | Ein anderes Schlüsselformat | Lud ohne Fehler, pixelgleiche Ausgabe: keine Änderung |
| Eine Pony-LoRA | Pony SDXL | Lud ohne Fehler, pixelgleiche Ausgabe: keine Änderung |
Zwei Fehler sind still, einer sieht laut aus. Eine falsch ausgewiesene Datei oder eine von einem anderen Basismodell ändert nichts, sodass Sie womöglich eine Stunde lang Ihren Prompt verdächtigen; eine Turbo-Datei auf Base richtet ein Chaos an, was Ihnen wenigstens zeigt, dass etwas nicht stimmt. Fahren Sie ein Paar mit der Datei und eines ohne, gleicher Seed, bevor Sie auf einem Adapter aufbauen. Stimmen sie überein, bewirkt die Datei hier nichts; ist das Ergebnis Rauschen, wurde sie für Turbo trainiert.
Hugging Face listet Adapter, deren Basismodell Tongyi-MAI/Z-Image ist. Wir haben nur die obersten 40 nach Downloadzahl abgerufen: überwiegend LoRAs für die Ähnlichkeit mit realen Personen, dazu einige Stil-LoRAs. Die gesamte Liste haben wir nicht gezählt, daher nennen wir keine Zahl.
Checkliste, bevor Sie eine LoRA wählen:
- Basismodell: Auf der Karte steht Z-Image Base oder Tongyi-MAI/Z-Image, nicht Turbo, Pony oder FLUX.
- Eine verlinkbare Datei: Das Repository enthält eine
.safetensors-Datei, und Sie können ihrenresolve/main/-Link bilden. - Öffentlicher Zugriff: Eine gesperrte Datei schlägt mit einer HTTP-401-Meldung fehl.
- Auslösephrase: Übernehmen Sie sie exakt von der Karte.
- Lizenz: Lesen Sie die auf der Karte der LoRA selbst.
Die mikkoani-LoRA: eine Phrase, ein anderer Look
Die mikkoani-LoRA schaltet sich mit ihrer Phrase mature illustration with muted color and complex linework am Anfang des Prompts ein. Hier eine Ballsaal-Szene mit der LoRA bei Stärke 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}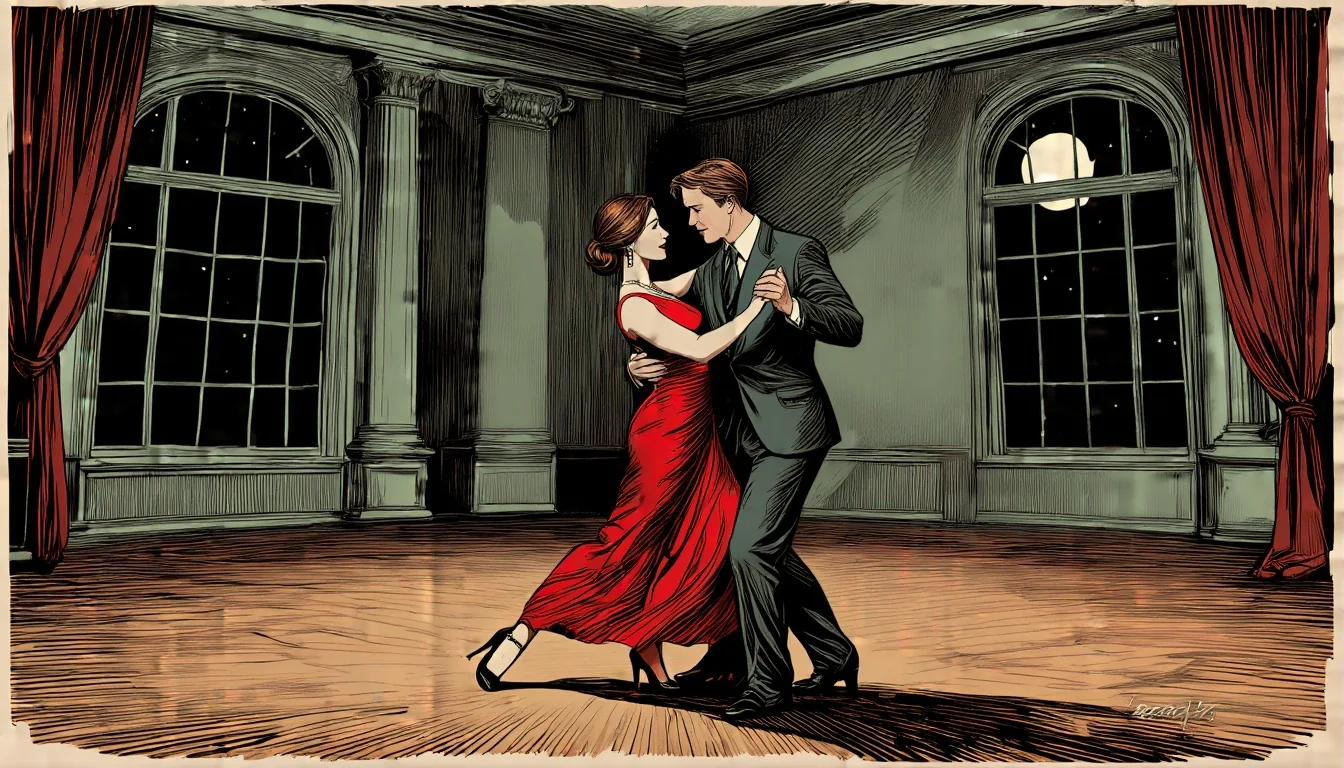
Z-Image Base LoRA, Text-zu-Bild, 16:9 (1344×768), Seed 43, mikkoani-LoRA mit Stärke 1.
Noch ein wissenswerter Befund: Die Phrase allein, ohne die LoRA, lenkte einen Foto-Prompt bereits in Richtung Illustration. Base folgt der Formulierung stark, sodass eine Auslösephrase einen Teil des Stils tragen kann, selbst wenn die Datei nicht lädt. Das macht das Paar mit und ohne etwas weniger eindeutig: Vergleichen Sie Linienqualität und Palette, nicht nur das Genre.
Stärke beim Bearbeiten: die Leiter
Der Bearbeiten-Endpunkt nimmt ein Quellbild, eine strength von 0 bis 1 und dasselbe Feld loras. Unser öffentlicher Standardwert ist 0,7; der Upstream-Standard ist 0,6. Wir haben auf einem Foto ohne LoRA eine Leiter gefahren:
| Stärke | Was wir sahen |
|---|---|
| 0,3 und 0,5 | Fast unverändert |
| 0,6 | Leichte Veränderung |
| 0,7 | Der Inhalt beginnt sich zu ändern; Komposition erhalten |
| 0,75 | Die Szene wird neu gestellt und inszeniert, Licht und Palette bleiben |
| 0,85 | Ein neues Bild |
Mit einer Stil-LoRA verändert sich das Bild: Bei 0,6 wurde das ganze Bild stilistisch neu gefasst und die Komposition exakt beibehalten. Das ist der Sweet Spot, um ein Foto in eine Illustration zu verwandeln.
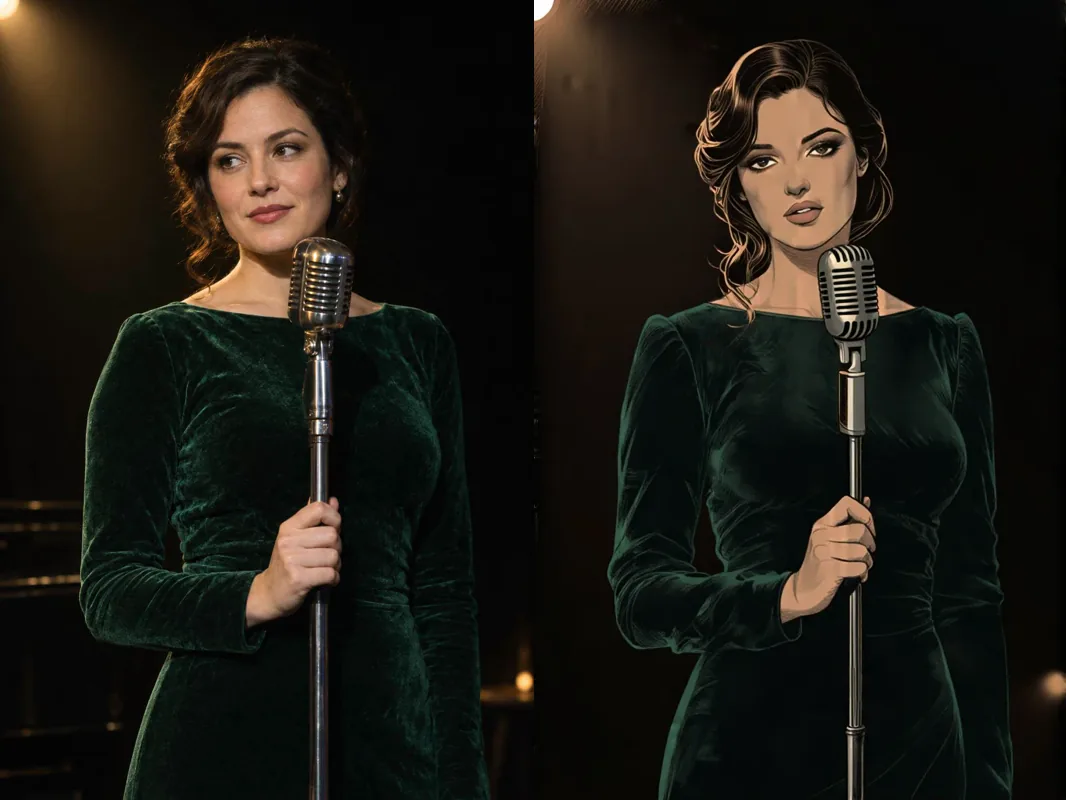
Links: unser generiertes Quellfoto. Rechts: Z-Image Base LoRA, Bild-zu-Bild, 1k, Seed 51, mikkoani-LoRA mit Stärke 1, strength 0,6.
Der Bearbeiten-Prompt beschreibt das ganze gewünschte Bild, nicht nur die Änderung:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Eine zweite Quelle, ein Mann in offenem weißem Leinenhemd auf einem Dach bei Sonnenuntergang, bei derselben Stärke:
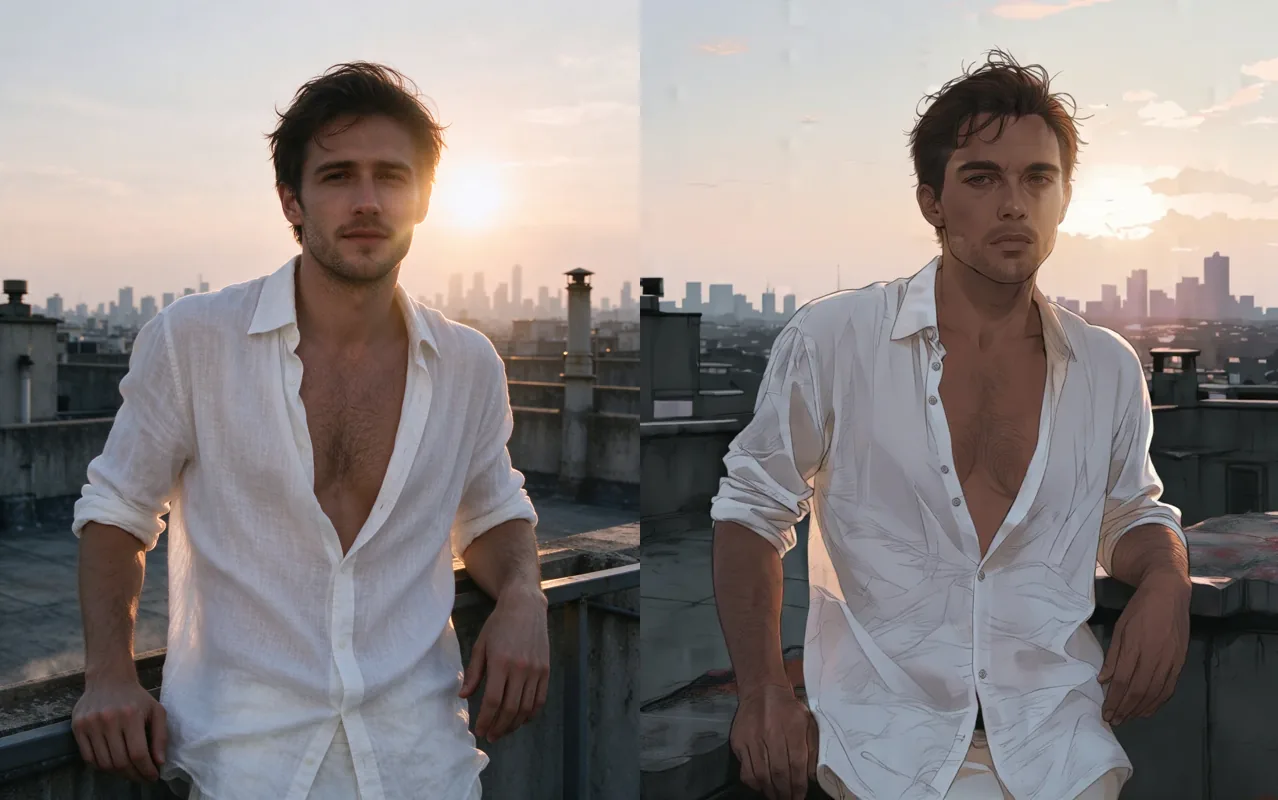
Links: unser generiertes Quellfoto. Rechts: Z-Image Base LoRA, Bild-zu-Bild, 1k, Seed 54, mikkoani-LoRA mit Stärke 1, strength 0,6.
Und eine breite Quelle bei 1.5k und strength 0,65:
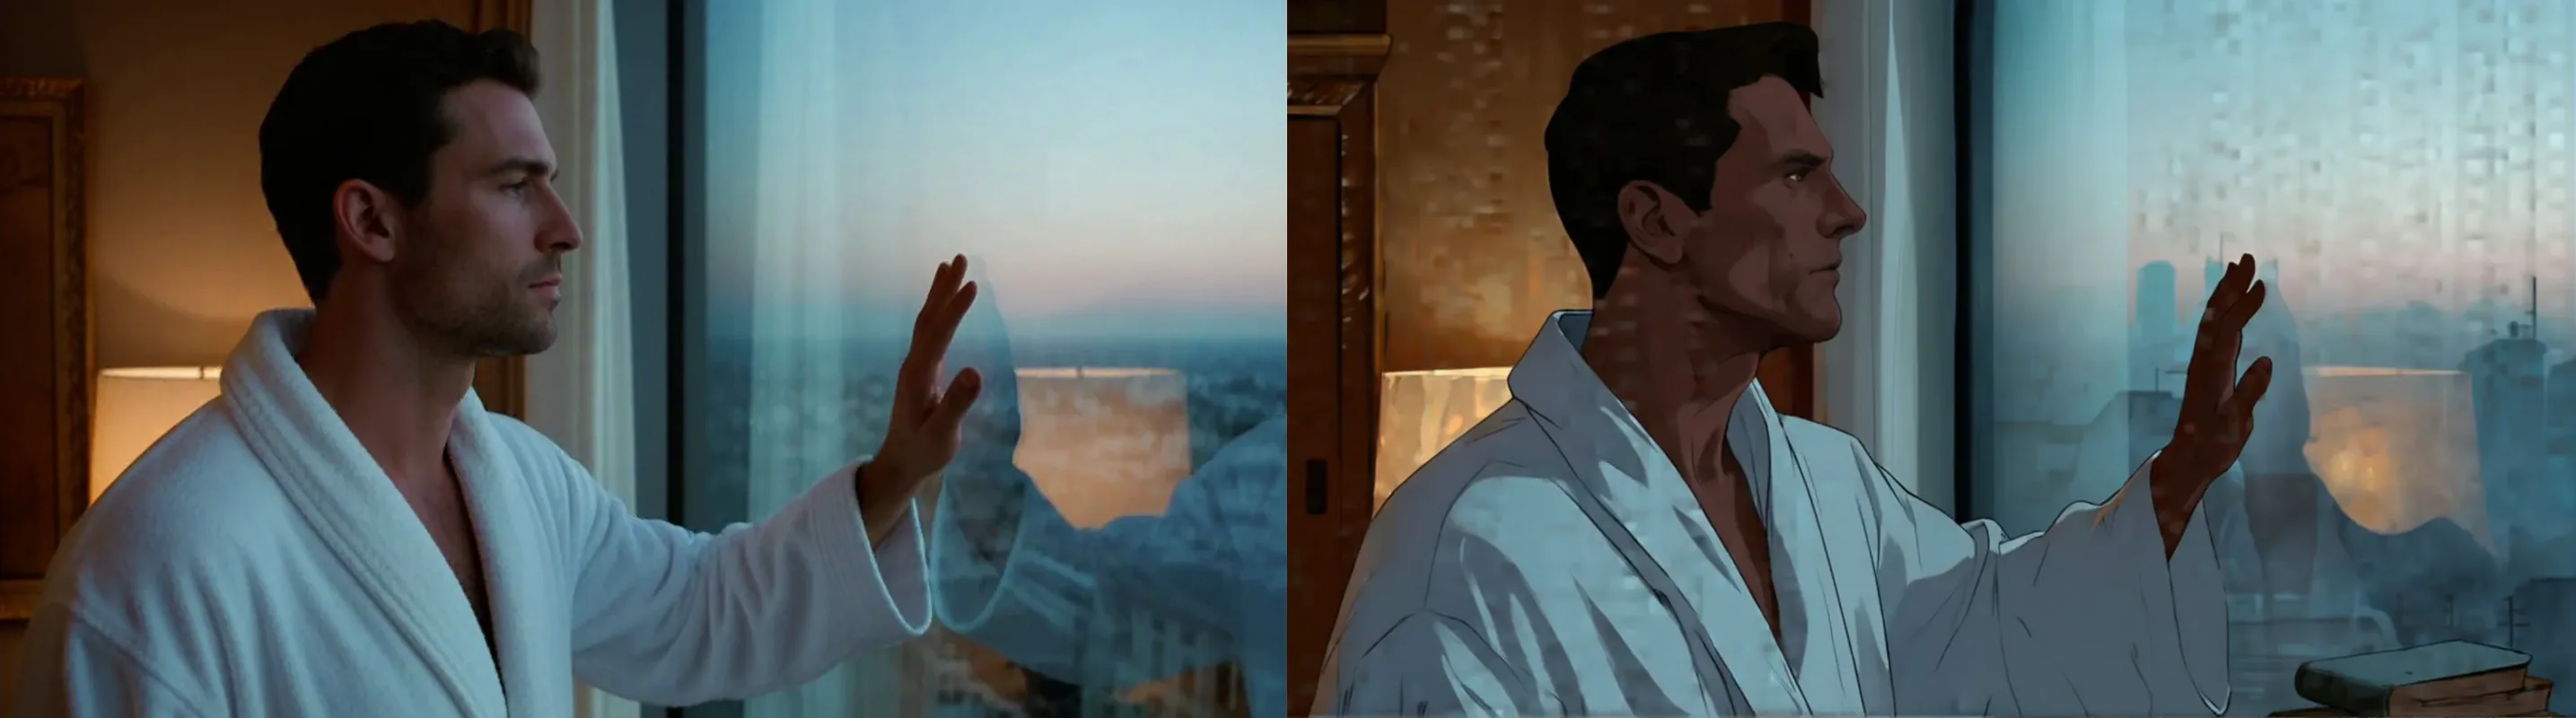
Links: unser generiertes Quellfoto. Rechts: Z-Image Base LoRA, Bild-zu-Bild, 1.5k, Seed 55, mikkoani-LoRA mit Stärke 1, strength 0,65.
Es ändert den Stil; es befolgt keine Anweisungen
Ohne LoRA blieb "make it black and white" bei den Stärken 0,65 und 0,8 farbig, und "put him in a tuxedo" änderte bei 0,7 und 0,8 wenig. Das Modell zeichnet das Bild aus Ihrer Beschreibung neu. Für einen Wechsel des Mediums nehmen Sie eine Stil-LoRA; für eine andere Szene beschreiben Sie sie vollständig und erhöhen die Stärke. Details stehen auf der Bearbeiten-Seite.
Größen
Text-zu-Bild bietet neun Seitenverhältnisse auf SDXL-nativen Größen, und alle neun wurden in exakt der angeforderten Größe abgeschlossen:
| Verhältnis | Größe | Verhältnis | Größe |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
Die Upstream-Seite akzeptiert 256 bis 1536 pro Seite: 1536×1536 und 256×256 wurden abgeschlossen, 1600×896, 2048×2048 und 200×200 scheiterten mit einem Größenbeschränkungsfehler. Beim Bearbeiten legt resolution nur die lange Seite fest, und das Verhältnis der Quelle bleibt erhalten: Ein 2:3-Foto bei 1k kam als 680×1024 zurück, ein 16:9-Foto bei 1.5k als 1536×856.
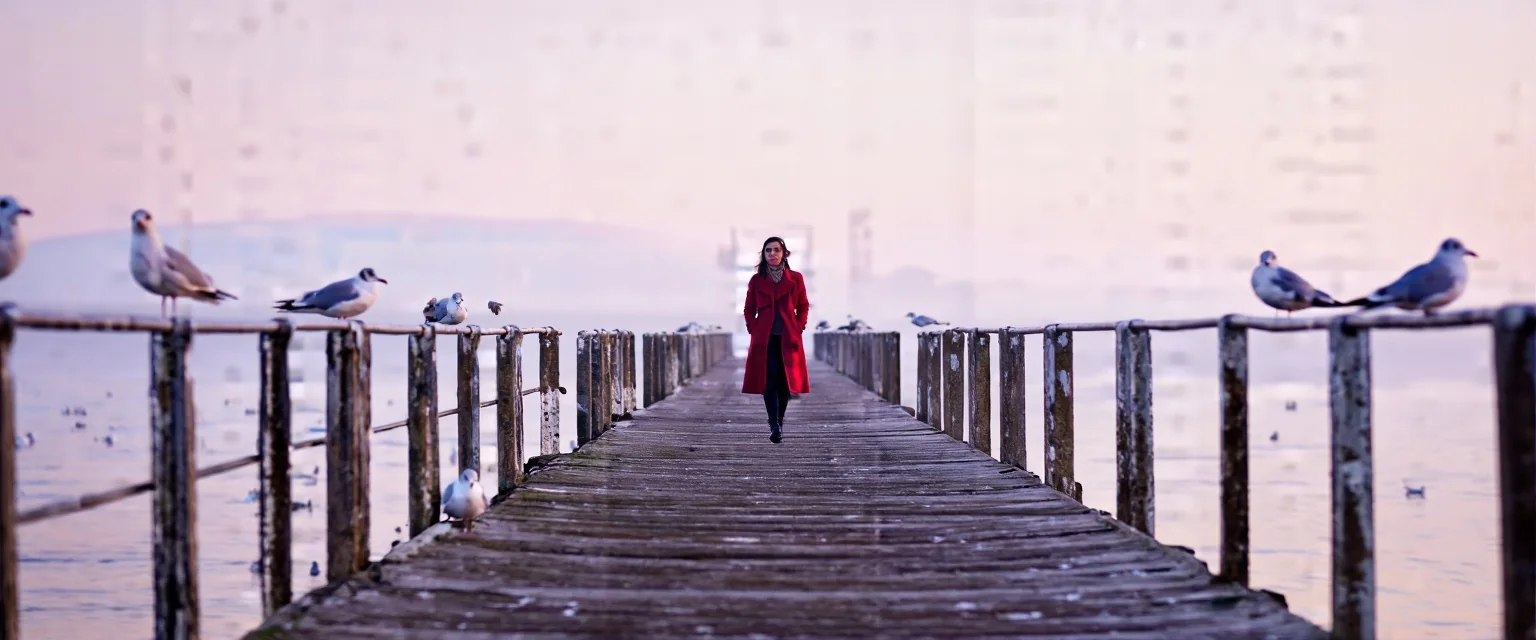
Z-Image Base LoRA, Text-zu-Bild, 21:9 (1536×640), Seed 45, keine LoRA.
Dasselbe breite Format eignet sich für Straßenszenen:
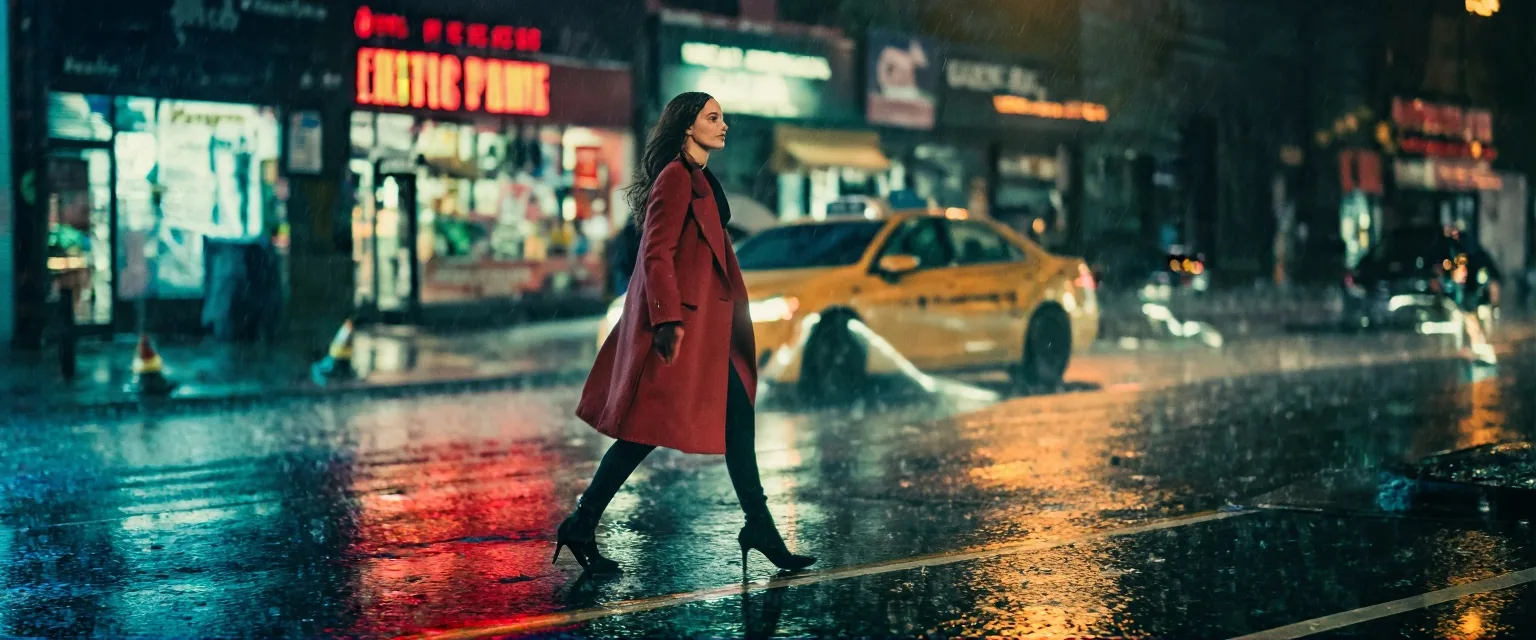
Z-Image Base LoRA, Text-zu-Bild, 21:9, keine LoRA.
Was abschwächt
Vor dem Modell sitzt kein Content-Filter. In unserer Leiter, mit ausdrücklich erwachsenen Personen in jedem Prompt, lieferte Text-zu-Bild L1 Andeutung (Dessous, ein rutschender Träger), L2 Reife Themen, L3 Stark, L5 Extrem (einvernehmliche Fesselung unter Erwachsenen oder filmisches Gore) und die männliche Version von L3 so wie geschrieben. L4 Intensiv (eine intime Szene zwischen zwei Erwachsenen) kam abgeschwächt zurück, in drei Versuchen: Die Seeds ergaben Figuren und etwas Kontakt, aber keine zusammenhängende Szene. Bild-zu-Bild auf einer bekleideten Quelle verhielt sich genauso: Die unteren Stufen wurden geliefert, L3 ab Stärke 0,8 (bei 0,7 war es teilweise), und L4 wurde abgeschwächt.
Die ehrliche Zusammenfassung lautet also, dass Base selbst diese oberste Stufe schlecht zeichnet. Dafür trainierte LoRAs sind der vorgesehene Weg, mit derselben Nur-Base-Regel wie oben. Bild-zu-Bild mit drei LoRAs oder LoRAs von Civitai-Links haben wir nicht getestet.
Z-Image Base LoRA oder Z-Image Turbo LoRA
Der eigene Vergleich der beiden Modelle durch den Anbieter:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Schritte | 28 bis 50 | 8 |
| CFG | ja | nein |
| Feinabstimmbar | ja | nein |
| Negativ-Prompt | ja (von diesem Endpunkt nicht bereitgestellt) | nein |
| Vielfalt | Hoch | Niedrig |
| Bildqualität | Hoch | Sehr hoch |
Z-Image Turbo LoRA ist das destillierte 8-Schritte-Modell mit bis zu drei für Turbo trainierten LoRAs, rund ein Megapixel in neun Verhältnissen, und seine Standardstärke bei Bild-zu-Bild beträgt 0,8. Wie sich ein Turbo-Adapter verhält, lesen Sie in unserem Same-Seed-Test zu Turbo LoRA. Die beiden Familien teilen sich keine LoRAs. Eine Turbo-Datei auf Base zerstörte in unserem Test das Bild; den umgekehrten Fall haben wir nicht getestet, nehmen Sie also nicht an, dass eine Base-Datei auf Turbo sicher ist.
| Sie möchten | Wählen Sie |
|---|---|
| Eine auf Z-Image Base trainierte LoRA | Z-Image Base LoRA |
| Eine auf Z-Image Turbo trainierte LoRA | Z-Image Turbo LoRA |
| Die schnellste Antwort, in Sekunden | Turbo; Base brauchte für Text-zu-Bild im Median 32,8 s |
| Foto zu Illustration mit einer Stil-LoRA | Base-Bearbeiten bei Stärke etwa 0,6, mit einer auf Base trainierten Stil-LoRA |
| Schlichte Prompts mit starker Prompt-Treue, keine LoRA | Beide; Base folgte der Formulierung in unseren Tests eng |
| Kontrolle über Schritte, Guidance oder negativen Prompt | Keiner der Endpunkte stellt sie bereit |
Z-Image Base LoRA, Text-zu-Bild, keine LoRA, ein filmischer Porträt-Prompt aus unserem Cover-Set.
FAQ
Kann ich eine Z-Image-Turbo-LoRA auf Base verwenden?
Nein. In unserem Test lud eine auf Turbo trainierte LoRA auf Base ohne Fehler und zerlegte das Bild in Rauschen und Pseudotext. Verwenden Sie auf Z-Image Base trainierte Dateien.
Warum hat meine Z-Image-LoRA nichts verändert?
Sie wurde wahrscheinlich in einem anderen Schlüsselformat gespeichert oder für ein anderes Modell trainiert. Eine für Z-Image ausgewiesene, aber anders gespeicherte Datei und eine Pony-LoRA wurden beide geladen und lieferten pixelgleiche Ausgabe. Fahren Sie ein Paar mit und ohne.
Welche Stärke soll ich beim Bearbeiten verwenden?
Beginnen Sie beim Standardwert 0,7, oder bei etwa 0,6 mit einer Stil-LoRA, um die Komposition zu erhalten. In unserer Leiter veränderten 0,3 und 0,5 das Foto kaum, 0,75 inszenierte die Szene neu, und 0,85 ergab ein neues Bild.
Kann es Anweisungen wie "make it black and white" befolgen?
Nein. Ohne LoRA blieb Schwarz-Weiß bei 0,65 und 0,8 farbig, und eine Smoking-Anfrage änderte wenig. Es zeichnet aus Ihrer Beschreibung neu, nutzen Sie also für den Look eine Stil-LoRA.
Welche Größen kann ich verwenden?
Neun Seitenverhältnisse für Text-zu-Bild, bis 1536 pro Seite, und 1k oder 1.5k für die lange Seite beim Bearbeiten. Eine Anfrage mit 200×200 oder 2048×2048 scheiterte in unseren Tests.
Wie langsam ist Base?
Text-zu-Bild dauerte 9,8 bis 56,7 Sekunden, im Median 32,8 über 36 Läufe. Bearbeitungen dauerten 4,9 bis 41,7 Sekunden, im Median 16,8 über 28 Läufe.
Zeichnet Base die intimsten Szenen?
Allein nicht überzeugend. In drei Versuchen kam diese Stufe abgeschwächt zurück, während die Stufen darunter so gerendert wurden, wie sie geschrieben waren. Dafür trainierte LoRAs sind der Weg, weiterzukommen.
Kann ich Schritte, Guidance oder einen negativen Prompt festlegen?
Nein. Der Endpunkt hat solche Felder nicht, obwohl der Anbieter für das Modell 28 bis 50 Schritte empfiehlt.