No Z-Image Base LoRA, use LoRAs treinadas no Z-Image Base: uma LoRA treinada para o Z-Image Turbo quebrou a imagem em ruído e pseudotexto quando a carregamos no Base em 5 de outubro de 2026. O Base é o modelo mais lento, sem destilação, em que a comunidade treina; por isso a mediana de texto para imagem foi de 32,8 segundos nas nossas 36 execuções. Nas edições, o strength padrão é 0.7, e por volta de 0.6 com uma LoRA de estilo o quadro inteiro foi redesenhado no novo estilo, mantendo a composição exatamente.
O Z-Image Base LoRA roda o Z-Image Base, da Tongyi-MAI, na Alibaba, um transformer de difusão de fluxo único com 6 bilhões de parâmetros, com até três das suas próprias LoRAs tanto em texto para imagem quanto em imagem para imagem. O cartão do modelo chama o Base de alicerce da família Z-Image, criado para desenvolvimento e um ponto de partida ideal para a comunidade; ele permite treinar LoRAs porque não é destilado. Os endpoints são sem censura: a plataforma não adiciona nenhum filtro de conteúdo. Um limite honesto vem primeiro: o modelo base sozinho desenha mal as cenas mais íntimas, que é exatamente para o que servem as LoRAs adultas. Todos os prompts deste guia são cenas do dia a dia com adultos vestidos.
Visão geral
| Pergunta | Resposta (testado em 5 de outubro de 2026) |
|---|---|
| Modelo | Z-Image Base, da Tongyi-MAI (Alibaba), 6 bilhões de parâmetros |
| Nomes de modelo na API | alibaba/z-image-base-lora/text-to-image e alibaba/z-image-base-lora/edit |
| Campo de LoRA | loras: até 3 entradas, cada uma {path, scale}, scale de 0 a 4 |
| LoRAs certas | Arquivos treinados no Z-Image Base |
| LoRAs erradas | Treinadas para o Turbo: quebraram a imagem. Pony ou arquivos salvos de outro jeito: sem erro, sem mudança |
| Strength na edição | De 0 a 1, padrão 0.7 |
| Tamanhos em texto para imagem | Nove proporções, cada lado até 1536 |
| Tamanhos na edição | resolution 1k ou 1.5k define o lado maior; a proporção da fonte é mantida |
| Velocidade nos nossos testes | Texto para imagem de 9,8 a 56,7 s, mediana de 32,8 (36 execuções); edição de 4,9 a 41,7 s, mediana de 16,8 (28 execuções) |
| Não expostos | Passos, guidance e prompt negativo |
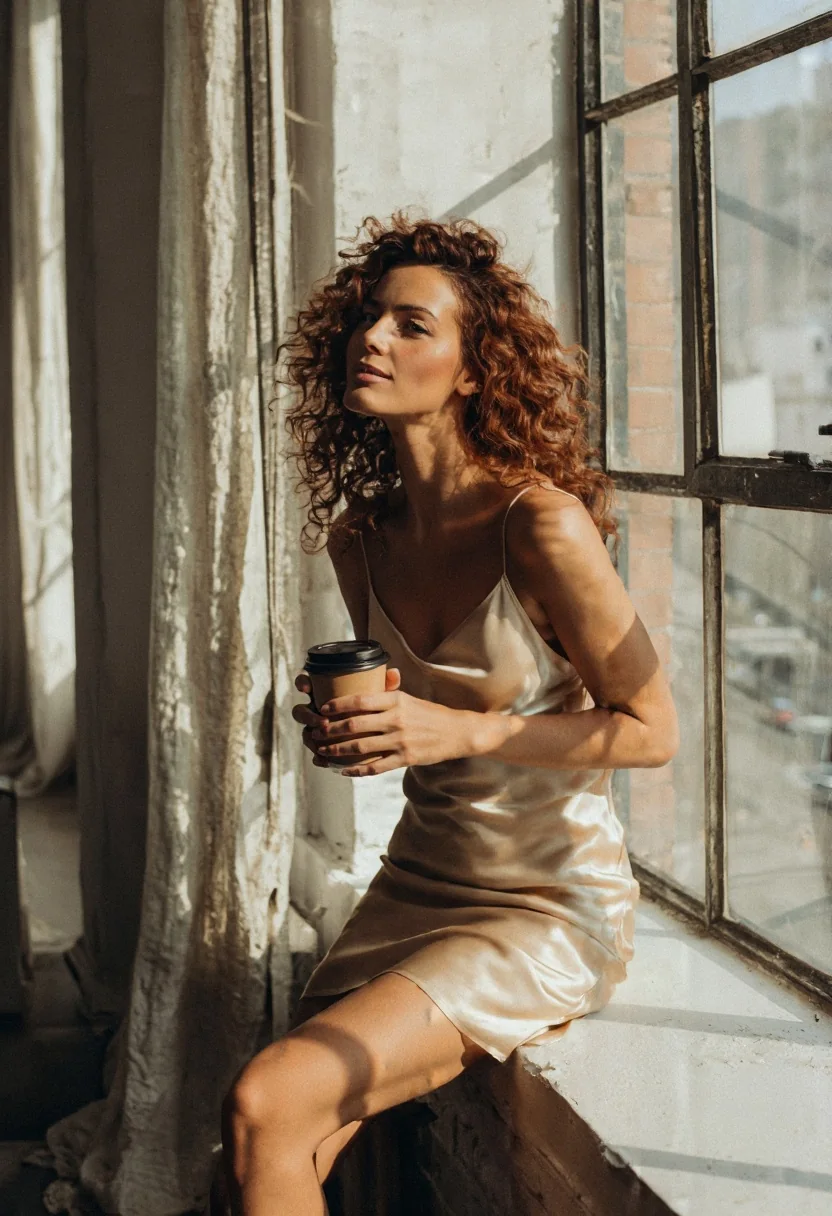
Z-Image Base LoRA, texto para imagem, 2:3 (832×1216), seed 41, sem LoRA. O prompt está impresso na próxima seção.
Prompts: frases simples, forte aderência
A aderência ao prompt no Base foi forte nos nossos testes. Escreva como se estivesse passando um briefing a um fotógrafo: sujeito, roupas, lugar, luz, grão. O retrato no loft acima veio de uma única frase:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.A mesma estrutura de frase, trocando só o sujeito, serviu para um boxeador em uma academia antiga:
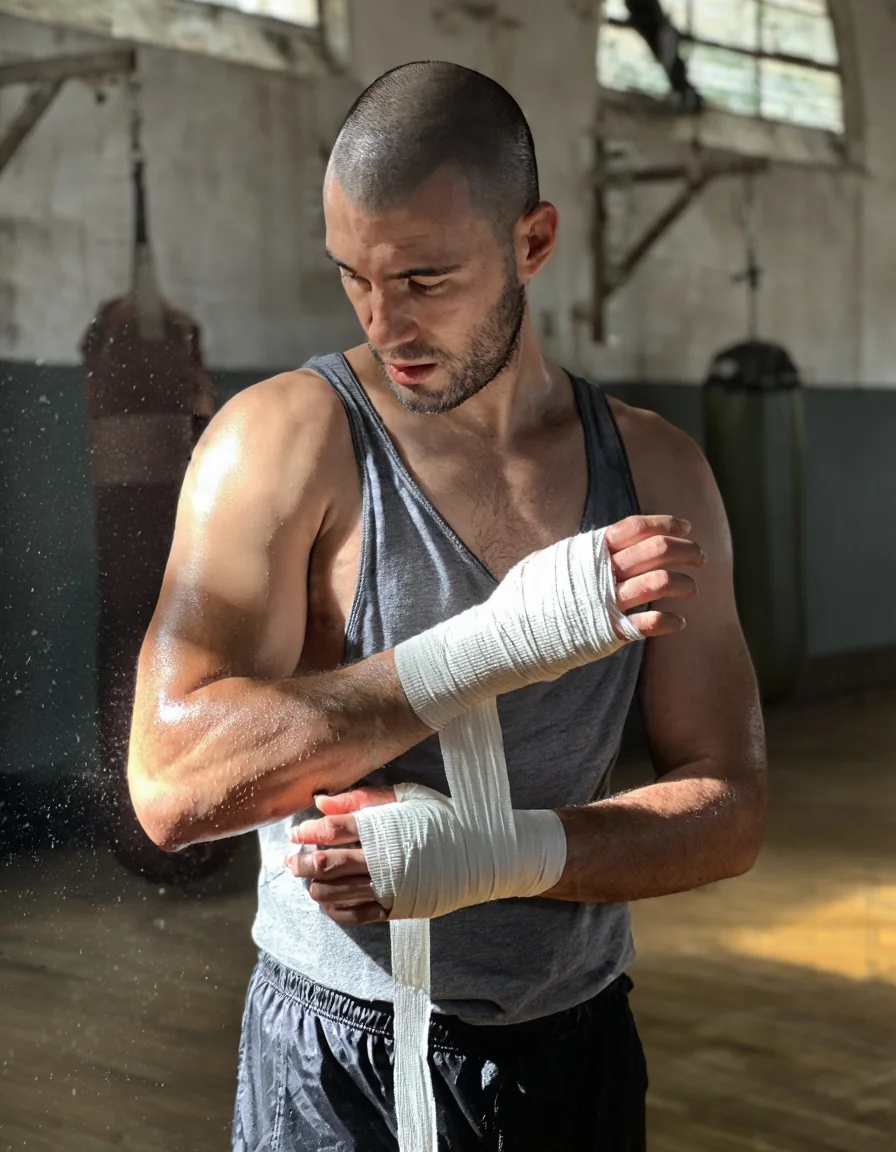
Z-Image Base LoRA, texto para imagem, 3:4 (896×1152), seed 42, sem LoRA.
Não há campo de prompt negativo, guidance nem passos. Quem publica recomenda guidance de 3.0 a 5.0 e de 28 a 50 passos para o modelo em si, mas este endpoint não expõe nenhum deles; portanto, o tom e o estilo vêm do prompt e da LoRA.
Quais LoRAs funcionam no Base
Esta é a pergunta que a família existe para responder, então testamos quatro tipos de arquivo:
| LoRA | Treinada para | O que aconteceu |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Funcionou com 0.5 e com 1 |
| Uma LoRA de Z-Image Turbo | Z-Image Turbo | Carregou sem erro e quebrou a imagem (ruído e pseudotexto) |
furaidosu/flat-cartoon-zimage, indicada para Z-Image | Um formato de chaves diferente | Carregou sem erro, saída idêntica pixel a pixel: nenhuma mudança |
| Uma LoRA Pony | Pony SDXL | Carregou sem erro, saída idêntica pixel a pixel: nenhuma mudança |
Duas falhas são silenciosas e uma tem cara de falha. Um arquivo com indicação errada ou de outro modelo base não muda nada, e você pode culpar o prompt por uma hora; um arquivo Turbo no Base faz uma bagunça, o que pelo menos avisa que algo está errado. Rode um par, um com o arquivo e outro sem, com o mesmo seed, antes de construir algo sobre um adaptador. Se os dois forem iguais, o arquivo não faz nada aqui; se o resultado for ruído, ele foi treinado para o Turbo.
O Hugging Face lista adaptadores cujo modelo base é Tongyi-MAI/Z-Image. Puxamos apenas os 40 primeiros por número de downloads: na maioria, LoRAs de semelhança com pessoas reais, mais algumas LoRAs de estilo. Não contamos a lista inteira, então não damos número.
Lista de verificação antes de escolher uma LoRA:
- Modelo base: o cartão diz Z-Image Base, ou Tongyi-MAI/Z-Image, e não Turbo, Pony nem FLUX.
- Um arquivo que você consiga linkar: o repositório tem um arquivo
.safetensorse você consegue montar o linkresolve/main/dele. - Acesso público: um arquivo restrito falha com uma mensagem de HTTP 401.
- Frase-gatilho: copie exatamente do cartão.
- Licença: leia a do cartão da própria LoRA.
A LoRA mikkoani: uma frase, outro visual
A LoRA mikkoani é ativada pela sua frase, mature illustration with muted color and complex linework, no começo do prompt. Aqui está uma cena de salão de baile com a LoRA em scale 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}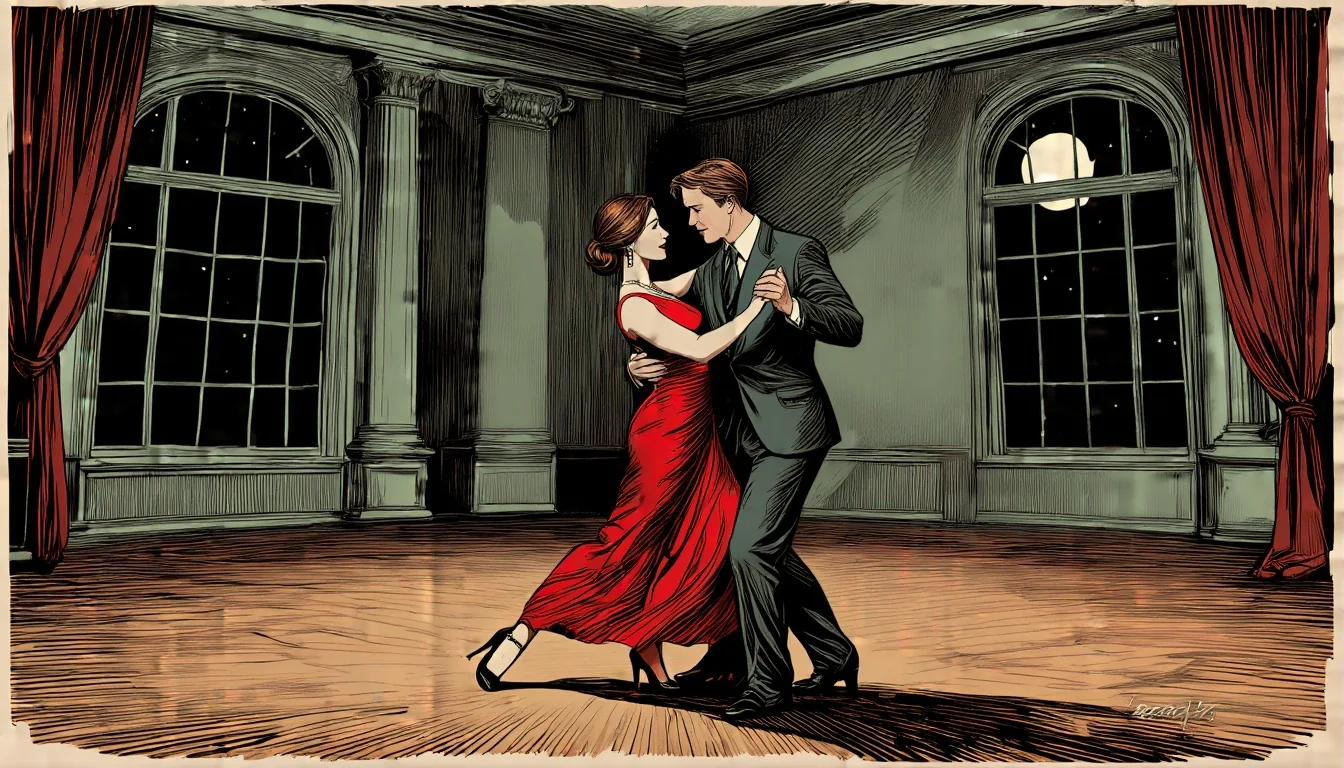
Z-Image Base LoRA, texto para imagem, 16:9 (1344×768), seed 43, LoRA mikkoani com scale 1.
Mais uma descoberta que vale conhecer: a frase sozinha, sem a LoRA, já inclinou um prompt de foto para uma ilustração. O Base segue a redação com muita força, então uma frase-gatilho pode carregar parte do estilo mesmo que o arquivo falhe ao carregar. Isso deixa o par com e sem LoRA um pouco menos óbvio: compare a qualidade do traço e a paleta, não só o gênero.
Strength na edição: a escada
O endpoint de edição recebe uma imagem de origem, um strength de 0 a 1 e o mesmo campo loras. O nosso padrão público é 0.7; o padrão do serviço de origem é 0.6. Rodamos uma escada em uma foto sem LoRA:
| Strength | O que vimos |
|---|---|
| 0.3 e 0.5 | Quase sem mudança |
| 0.6 | Mudança leve |
| 0.7 | O conteúdo começa a mudar; composição mantida |
| 0.75 | A cena é reposicionada e remontada, luz e paleta mantidas |
| 0.85 | Uma imagem nova |
Com uma LoRA de estilo a imagem muda: com 0.6 ela redesenhou o quadro inteiro no novo estilo e manteve a composição exatamente. É o ponto ideal para transformar uma foto em ilustração.
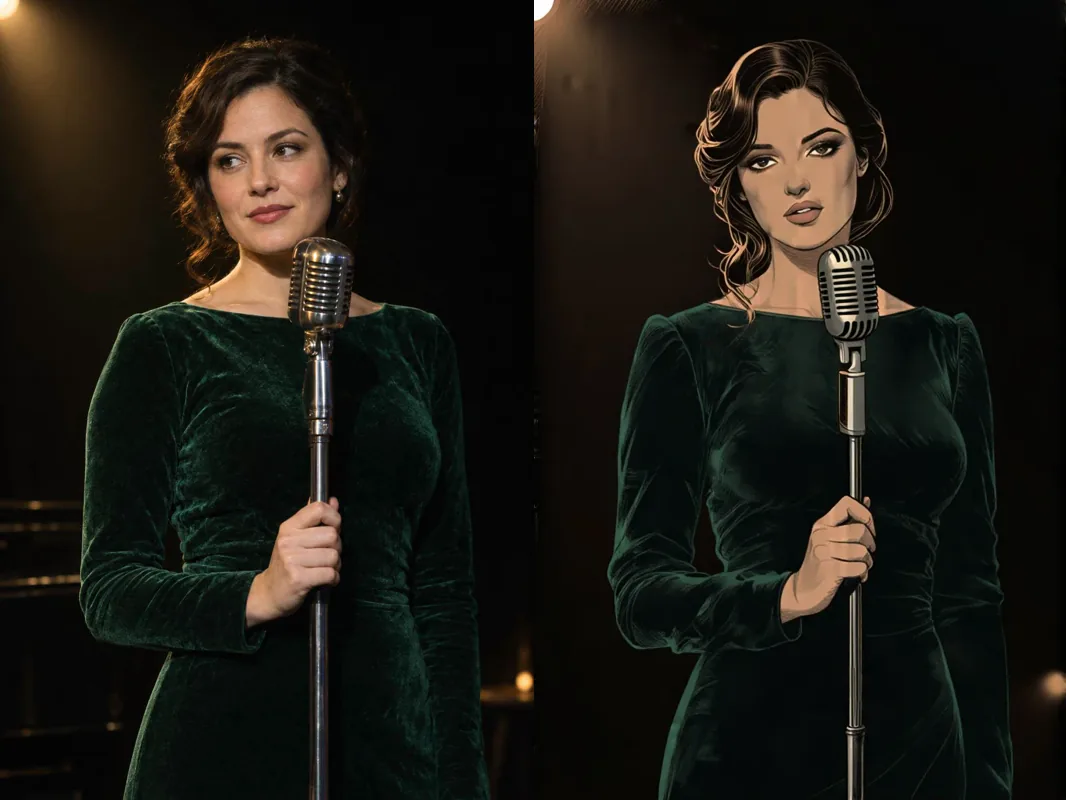
À esquerda: a nossa foto de origem gerada. À direita: Z-Image Base LoRA, imagem para imagem, 1k, seed 51, LoRA mikkoani com scale 1, strength 0.6.
O prompt de edição descreve a imagem inteira que você quer, e não só a mudança:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Uma segunda origem, um homem em um terraço ao pôr do sol, de camisa de linho branca aberta, com o mesmo strength:
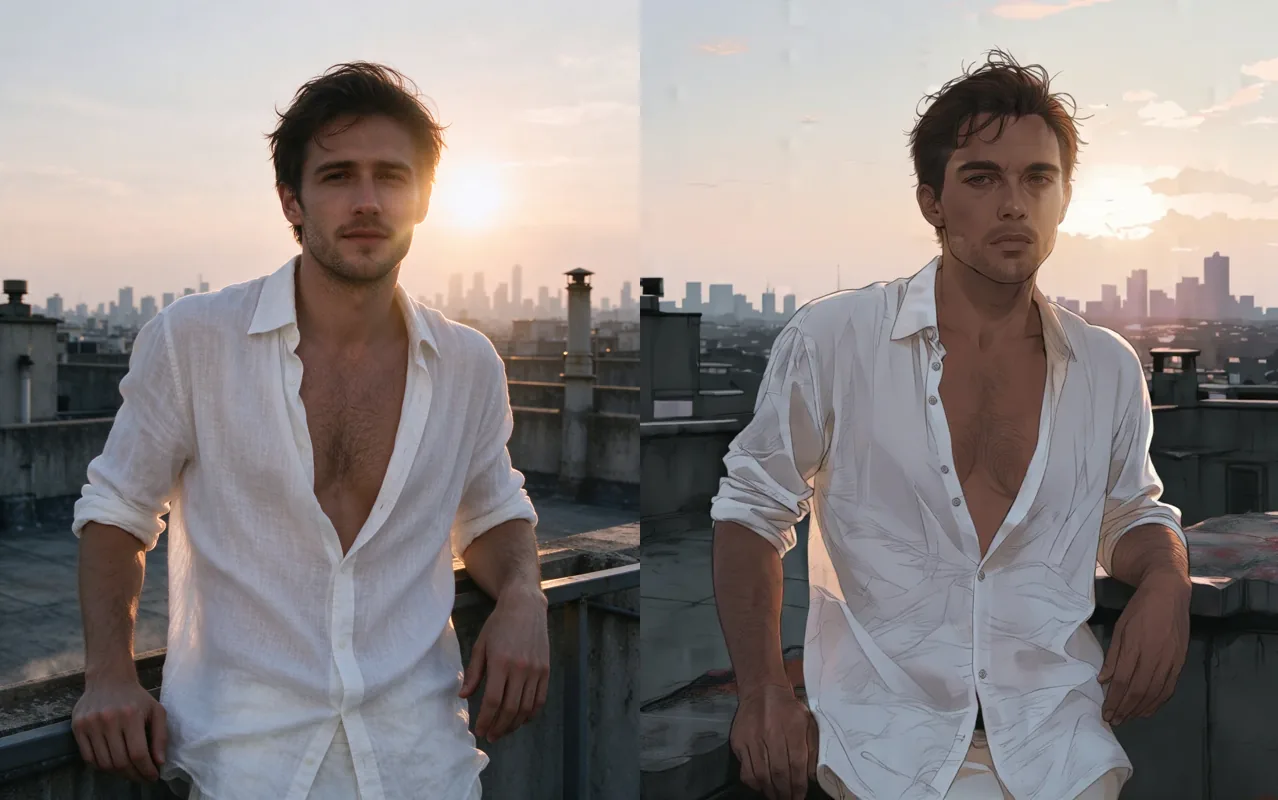
À esquerda: a nossa foto de origem gerada. À direita: Z-Image Base LoRA, imagem para imagem, 1k, seed 54, LoRA mikkoani com scale 1, strength 0.6.
E uma origem larga em 1.5k com strength 0.65:
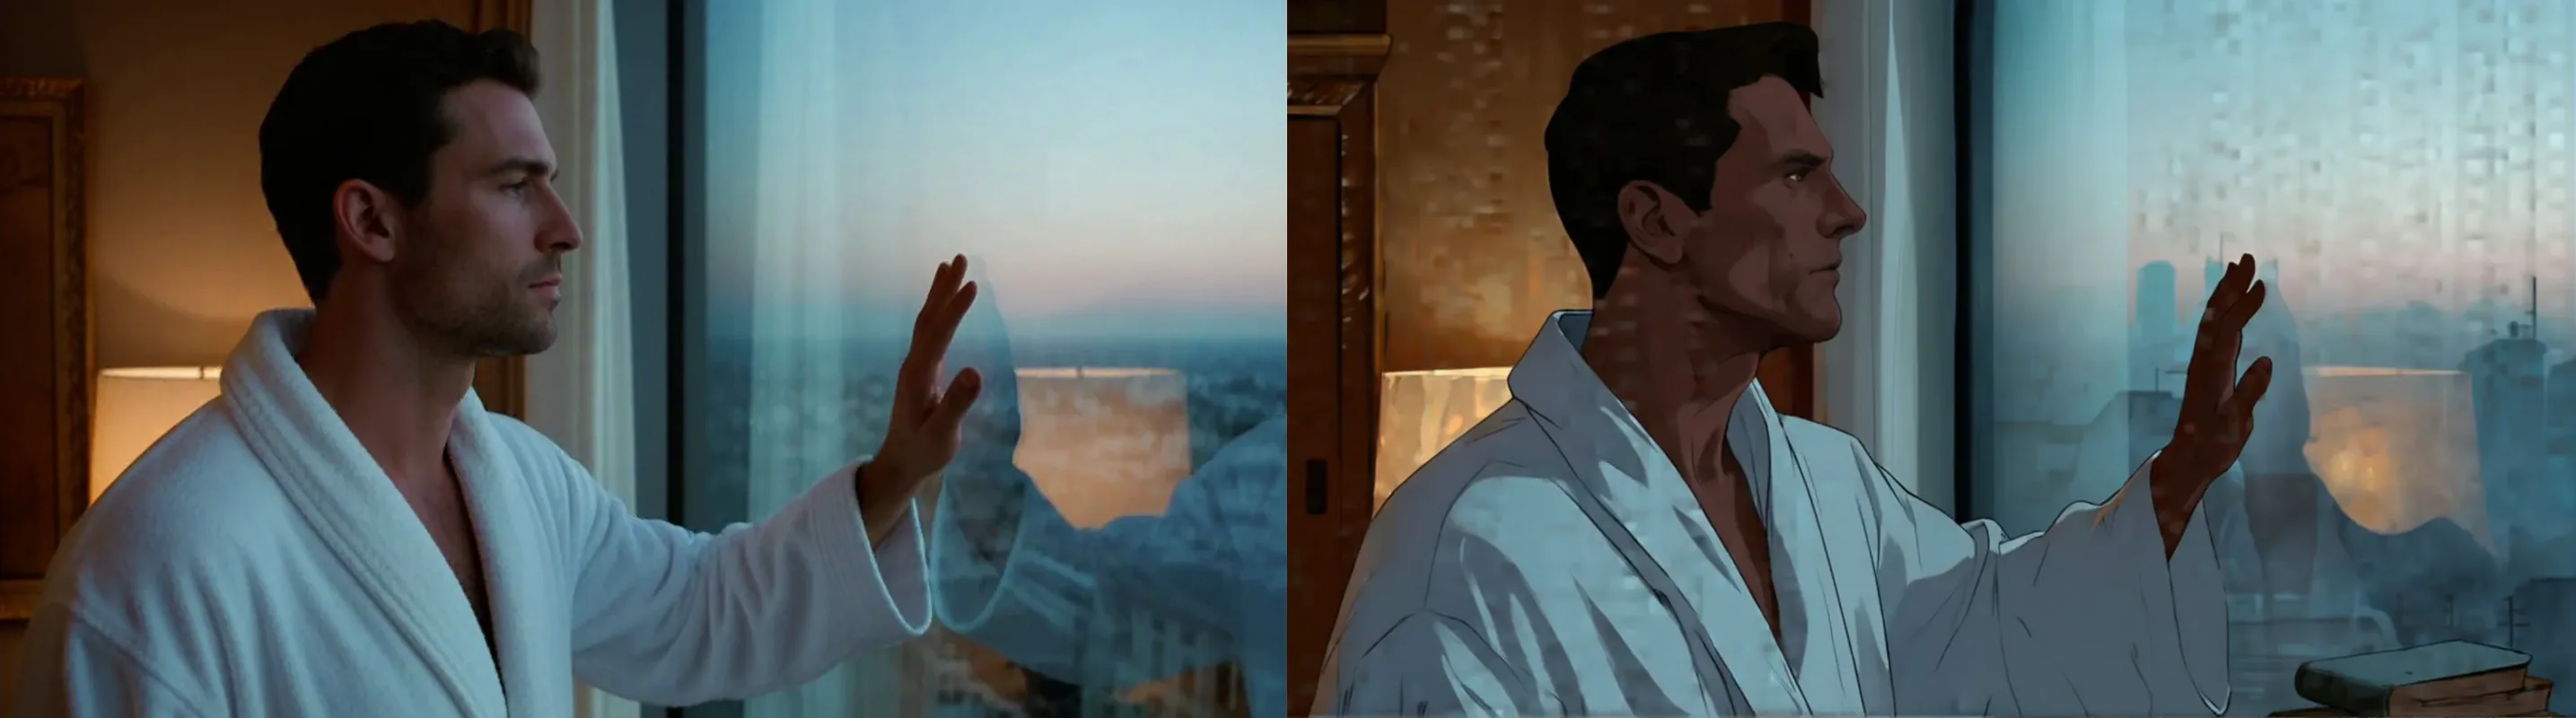
À esquerda: a nossa foto de origem gerada. À direita: Z-Image Base LoRA, imagem para imagem, 1.5k, seed 55, LoRA mikkoani com scale 1, strength 0.65.
Ele redesenha; não segue instruções
Sem LoRA, "deixe em preto e branco" continuou colorido com strength 0.65 e 0.8, e "coloque-o de smoking" mudou pouco com 0.7 e 0.8. O modelo redesenha o quadro a partir da sua descrição. Para mudar de meio artístico, traga uma LoRA de estilo; para uma cena diferente, descreva-a por completo e aumente o strength. Os detalhes estão na página de edição.
Tamanhos
O texto para imagem oferece nove proporções em tamanhos nativos do SDXL, e as nove foram concluídas exatamente no tamanho pedido:
| Proporção | Tamanho | Proporção | Tamanho |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
O serviço de origem aceita de 256 a 1536 em cada lado: 1536×1536 e 256×256 foram concluídos, enquanto 1600×896, 2048×2048 e 200×200 falharam com um erro de restrição de tamanho. Nas edições, resolution define apenas o lado maior e a proporção da fonte é mantida: uma foto 2:3 em 1k voltou com 680×1024, e uma foto 16:9 em 1.5k voltou com 1536×856.
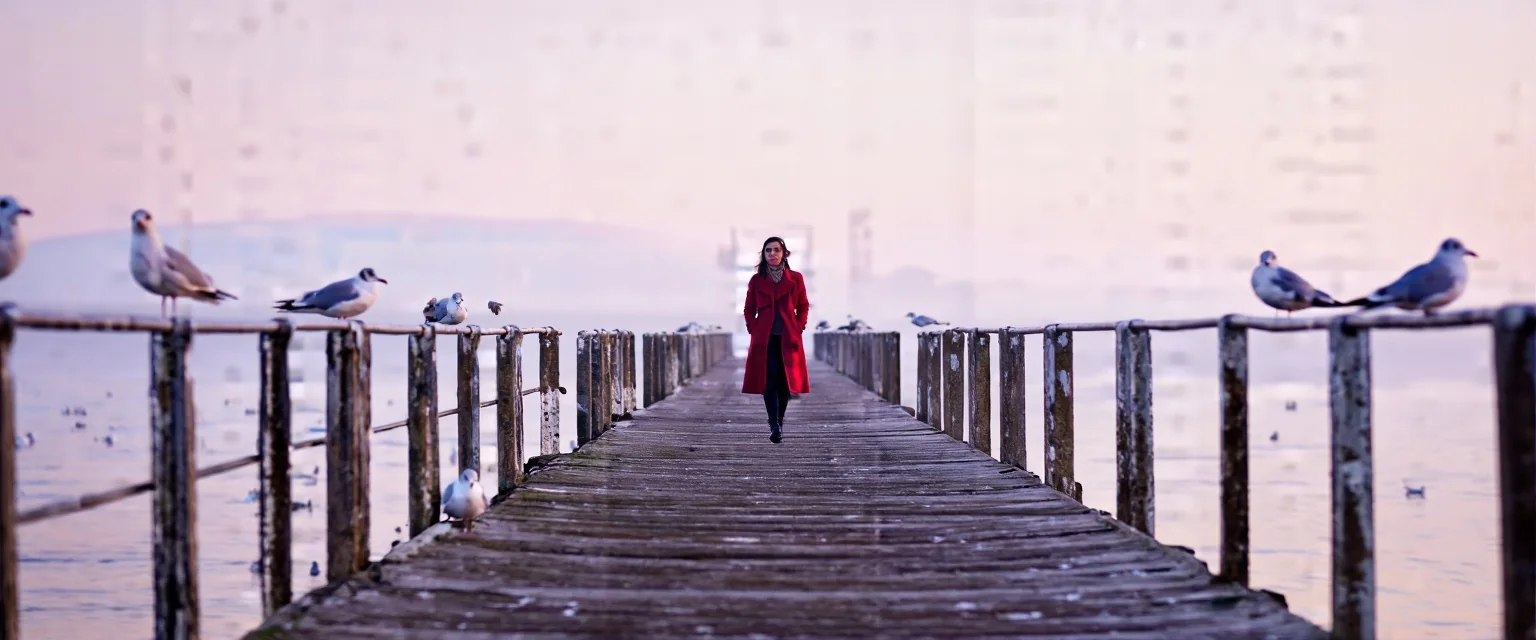
Z-Image Base LoRA, texto para imagem, 21:9 (1536×640), seed 45, sem LoRA.
O mesmo formato largo combina com cenas de rua:
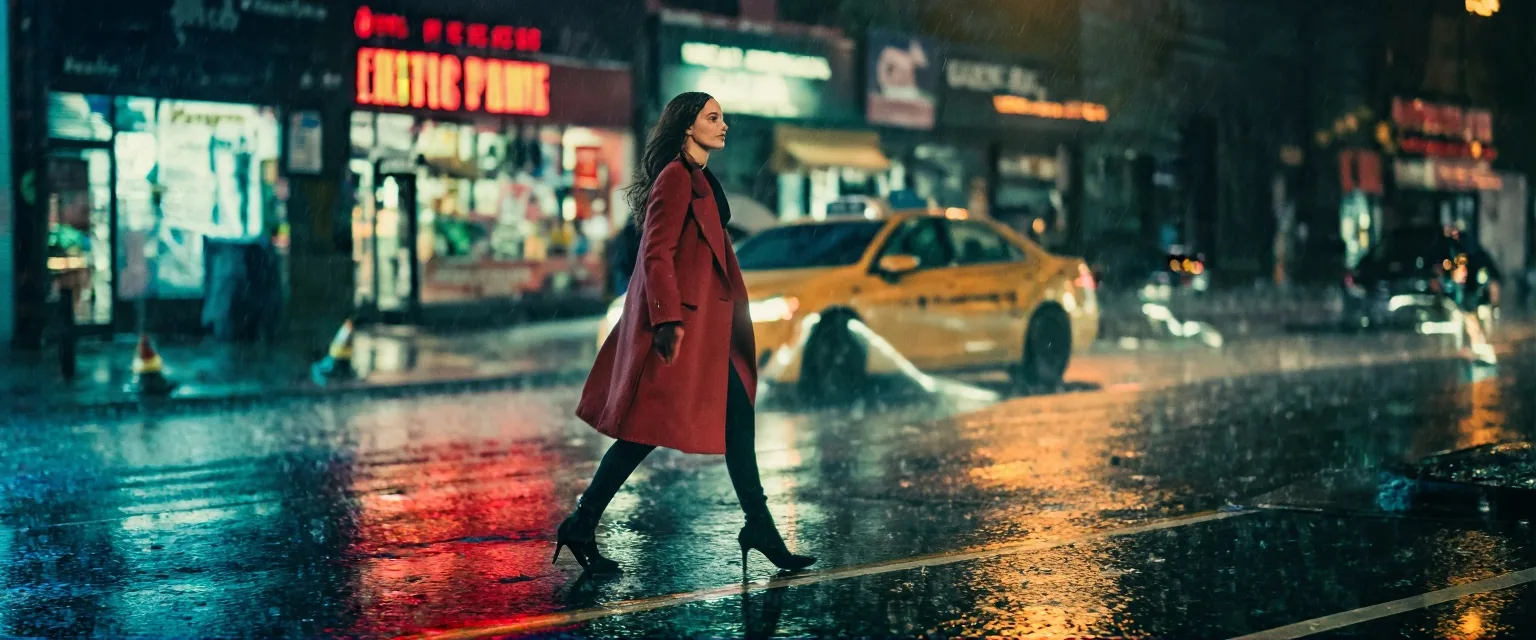
Z-Image Base LoRA, texto para imagem, 21:9, sem LoRA.
O que suaviza
Nenhum filtro de conteúdo fica na frente do modelo. Na nossa escada, com adultos declarados em todos os prompts, o texto para imagem entregou como escritos L1 Sugestivo (lingerie, uma alcinha escorregando), L2 Temas maduros, L3 Forte, L5 Extremo (contenção consensual entre adultos, ou gore cinematográfico) e a versão masculina do L3. O L4 Intenso (uma cena íntima entre dois adultos) voltou suavizado em três tentativas: os seeds deram figuras e algum contato, mas nenhuma cena coerente. A imagem para imagem a partir de uma fonte vestida se comportou do mesmo jeito: os níveis mais baixos foram entregues, o L3 a partir de strength 0.8 (com 0.7 foi parcial) e o L4 suavizou.
Então o resumo honesto é que o próprio Base desenha mal esse nível mais alto. As LoRAs treinadas para ele são o caminho pretendido, com a mesma regra de usar só LoRAs do Base citada acima. Não testamos imagem para imagem com três LoRAs, nem LoRAs de links do Civitai.
Z-Image Base LoRA ou Z-Image Turbo LoRA
A comparação que quem publica faz entre os dois modelos:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Passos | 28 a 50 | 8 |
| CFG | sim | não |
| Ajustável (fine-tuning) | sim | não |
| Prompt negativo | sim (não exposto por este endpoint) | não |
| Diversidade | Alta | Baixa |
| Qualidade visual | Alta | Muito alta |
O Z-Image Turbo LoRA é o modelo destilado de 8 passos, com até três LoRAs treinadas para o Turbo, cerca de um megapixel em nove proporções, e o strength padrão na imagem para imagem dele é 0.8. Para ver como um adaptador Turbo se comporta, veja o nosso teste de LoRA Turbo com o mesmo seed. As duas famílias não compartilham LoRAs. Um arquivo Turbo no Base quebrou a imagem no nosso teste; não testamos o contrário, então não presuma que um arquivo do Base seja seguro no Turbo.
| Você quer | Escolha |
|---|---|
| Uma LoRA treinada no Z-Image Base | Z-Image Base LoRA |
| Uma LoRA treinada no Z-Image Turbo | Z-Image Turbo LoRA |
| A resposta mais rápida, em segundos | Turbo; o Base levou uma mediana de 32,8 s em texto para imagem |
| Foto para ilustração com uma LoRA de estilo | Edição no Base com strength perto de 0.6, com uma LoRA de estilo treinada no Base |
| Prompts simples com forte aderência, sem LoRA | Qualquer um; o Base seguiu a redação de perto nos nossos testes |
| Controle de passos, guidance ou prompt negativo | Nenhum dos dois endpoints os expõe |
Z-Image Base LoRA, texto para imagem, sem LoRA, um prompt de retrato cinematográfico do nosso conjunto de capas.
FAQ
Posso usar uma LoRA do Z-Image Turbo no Base?
Não. No nosso teste, uma LoRA treinada para o Turbo carregou no Base sem erro e quebrou a imagem em ruído e pseudotexto. Use arquivos treinados no Z-Image Base.
Por que a minha LoRA de Z-Image não mudou nada?
Provavelmente foi salva em outro formato de chaves ou treinada para outro modelo. Um arquivo indicado para Z-Image mas salvo de outro jeito e uma LoRA Pony carregaram e deram saída idêntica pixel a pixel. Rode um par com e sem o arquivo.
Que strength devo usar na edição?
Comece pelo padrão 0.7, ou por volta de 0.6 com uma LoRA de estilo para manter a composição. Na nossa escada, 0.3 e 0.5 mal mudaram a foto, 0.75 remontou a cena e 0.85 deu uma imagem nova.
Ele segue instruções como "deixe em preto e branco"?
Não. Sem LoRA, o preto e branco continuou colorido com 0.65 e 0.8, e o pedido de smoking mudou pouco. Ele redesenha a partir da sua descrição, então use uma LoRA de estilo para o visual.
Que tamanhos posso usar?
Nove proporções em texto para imagem, até 1536 em cada lado, e 1k ou 1.5k para o lado maior nas edições. Uma requisição de 200×200 ou 2048×2048 falhou nos nossos testes.
Quão lento é o Base?
O texto para imagem levou de 9,8 a 56,7 segundos, com mediana de 32,8 em 36 execuções. As edições levaram de 4,9 a 41,7 segundos, com mediana de 16,8 em 28 execuções.
O Base desenha as cenas mais íntimas?
Não de forma convincente por conta própria. Em três tentativas esse nível voltou suavizado, enquanto os níveis abaixo foram renderizados como escritos. LoRAs treinadas para ele são o caminho para ir além.
Posso definir passos, guidance ou prompt negativo?
Não. O endpoint não tem esses campos, embora quem publica recomende de 28 a 50 passos para o modelo.