Su Z-Image Base LoRA usa LoRA addestrate su Z-Image Base: una LoRA addestrata per Z-Image Turbo ha ridotto l'immagine a rumore e pseudo-testo quando l'abbiamo caricata su Base il 5 ottobre 2026. Base è il modello più lento e non distillato su cui si addestra la community, quindi la sua mediana nel testo in immagine è stata di 32,8 secondi su 36 esecuzioni. Per le modifiche, la strength predefinita è 0.7, e intorno a 0.6 con una LoRA di stile ha ridisegnato l'intera inquadratura mantenendo esattamente la composizione.
Z-Image Base LoRA usa Z-Image Base di Tongyi-MAI presso Alibaba, un diffusion transformer a flusso singolo da 6 miliardi di parametri, con fino a tre tue LoRA sia nel testo in immagine sia nell'immagine in immagine. La scheda del modello definisce Base il fondamento della famiglia Z-Image, pensato per lo sviluppo e un punto di partenza ideale per la community; supporta l'addestramento di LoRA perché non è distillato. Gli endpoint sono senza censura: la piattaforma non aggiunge alcun filtro sui contenuti. Prima di tutto un limite onesto: il modello base da solo disegna male le scene più intime, ed è proprio per questo che esistono le LoRA per adulti. Ogni prompt in questa guida è una scena quotidiana con adulti vestiti.
In breve
| Domanda | Risposta (testato il 5 ottobre 2026) |
|---|---|
| Modello | Z-Image Base di Tongyi-MAI (Alibaba), 6 miliardi di parametri |
| Nomi dei modelli API | alibaba/z-image-base-lora/text-to-image e alibaba/z-image-base-lora/edit |
| Campo LoRA | loras: fino a 3 voci, ciascuna {path, scale}, scale da 0 a 4 |
| LoRA giuste | File addestrati su Z-Image Base |
| LoRA sbagliate | Addestrate per Turbo: hanno rovinato l'immagine. Pony o file salvati in modo diverso: nessun errore, nessuna modifica |
| Strength in modifica | Da 0 a 1, predefinito 0.7 |
| Dimensioni nel testo in immagine | Nove proporzioni, ogni lato fino a 1536 |
| Dimensioni in modifica | resolution 1k o 1.5k imposta il lato lungo; la proporzione della sorgente viene mantenuta |
| Velocità nei nostri test | Testo in immagine da 9,8 a 56,7 s, mediana 32,8 (36 esecuzioni); modifica da 4,9 a 41,7 s, mediana 16,8 (28 esecuzioni) |
| Non esposti | Passi, guidance e prompt negativo |
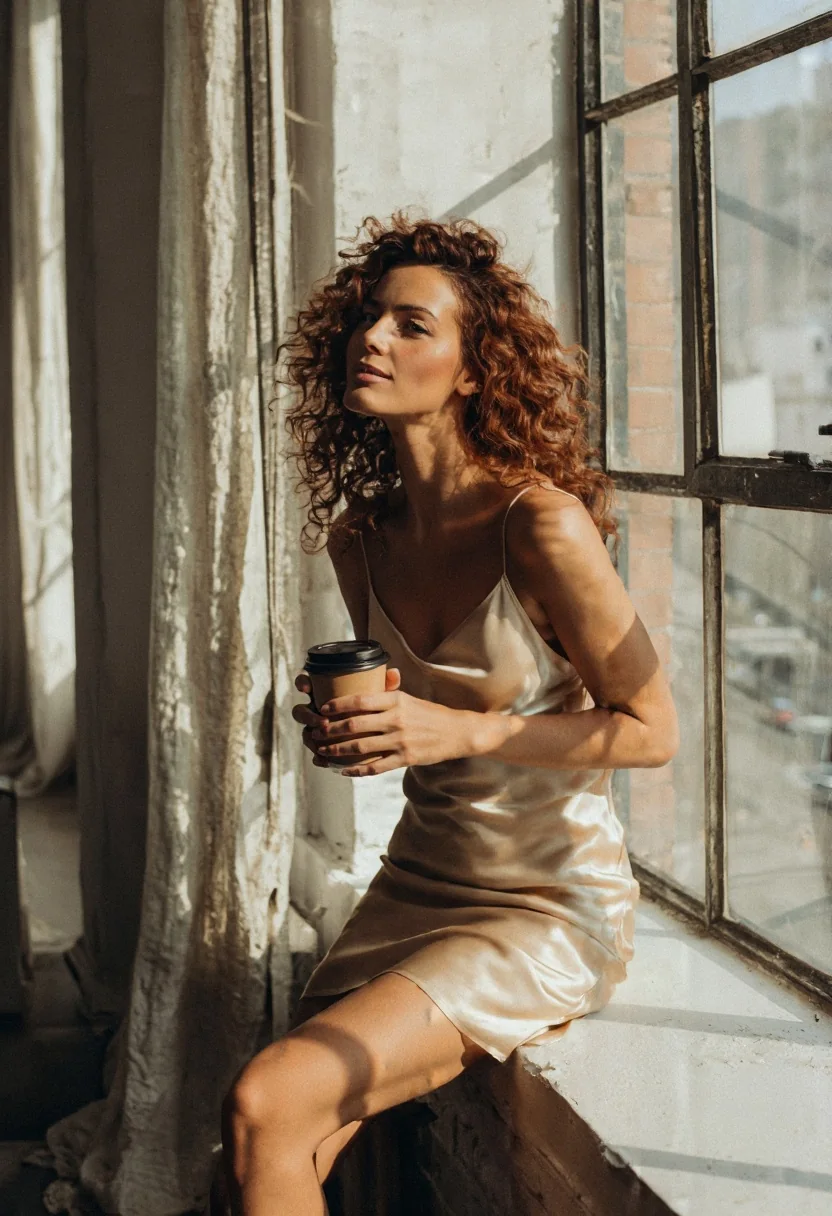
Z-Image Base LoRA, testo in immagine, 2:3 (832×1216), seed 41, nessuna LoRA. Il prompt è riportato nella sezione successiva.
Prompt: frasi semplici, forte aderenza
Su Base l'aderenza al prompt è stata forte nei nostri test. Scrivi come faresti il briefing a un fotografo: soggetto, abiti, luogo, luce, grana. Il ritratto nel loft qui sopra è nato da una sola frase:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.La stessa struttura di frase, cambiando solo il soggetto, ha dato un pugile in una vecchia palestra:
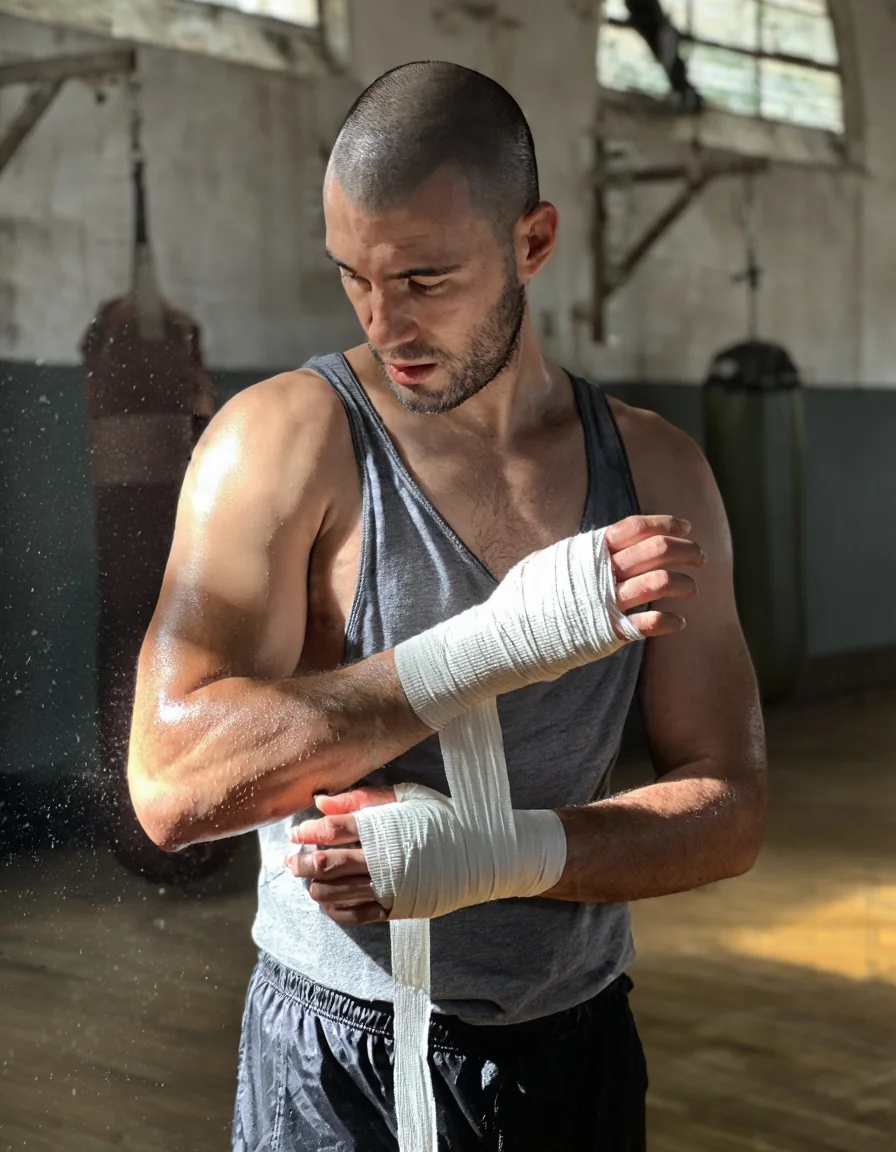
Z-Image Base LoRA, testo in immagine, 3:4 (896×1152), seed 42, nessuna LoRA.
Non c'è un campo per prompt negativo, guidance o passi. L'editore consiglia per il modello una guidance da 3.0 a 5.0 e da 28 a 50 passi, ma questo endpoint non ne espone nessuno, quindi tono e stile vengono dal prompt e dalla LoRA.
Quali LoRA funzionano su Base
È la domanda a cui risponde questa famiglia, quindi abbiamo provato quattro tipi di file:
| LoRA | Addestrata per | Che cosa è successo |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Ha funzionato a 0.5 e a 1 |
| Una LoRA Z-Image Turbo | Z-Image Turbo | Si è caricata senza errori e ha rovinato l'immagine (rumore e pseudo-testo) |
furaidosu/flat-cartoon-zimage, etichettata per Z-Image | Un formato di chiavi diverso | Si è caricata senza errori, output identico al pixel: nessuna modifica |
| Una LoRA Pony | Pony SDXL | Si è caricata senza errori, output identico al pixel: nessuna modifica |
Due errori sono silenziosi e uno ha un aspetto rumoroso. Un file etichettato male o di un altro modello base non cambia nulla, e potresti dare la colpa al prompt per un'ora; un file Turbo su Base fa un pasticcio, che almeno ti dice che qualcosa non va. Esegui una coppia con il file e una senza, stesso seed, prima di costruire su un adattatore. Se coincidono, il file qui non fa nulla; se il risultato è rumore, è stato addestrato per Turbo.
Hugging Face elenca gli adattatori il cui modello base è Tongyi-MAI/Z-Image. Ne abbiamo scaricati solo i primi 40 per numero di download: in gran parte LoRA di somiglianza con persone reali, più qualche LoRA di stile. Non abbiamo contato l'intero elenco, quindi non diamo alcun numero.
Lista di controllo prima di scegliere una LoRA:
- Modello base: la scheda dice Z-Image Base, o Tongyi-MAI/Z-Image, non Turbo, Pony o FLUX.
- Un file collegabile: il repository contiene un file
.safetensorse puoi costruire il suo linkresolve/main/. - Accesso pubblico: un file protetto fallisce con un messaggio HTTP 401.
- Frase trigger: copiala esattamente dalla scheda.
- Licenza: leggi quella sulla scheda della LoRA stessa.
La LoRA mikkoani: una frase, un look diverso
La LoRA mikkoani si attiva con la sua frase, mature illustration with muted color and complex linework, all'inizio del prompt. Ecco una scena in sala da ballo con la LoRA a scale 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}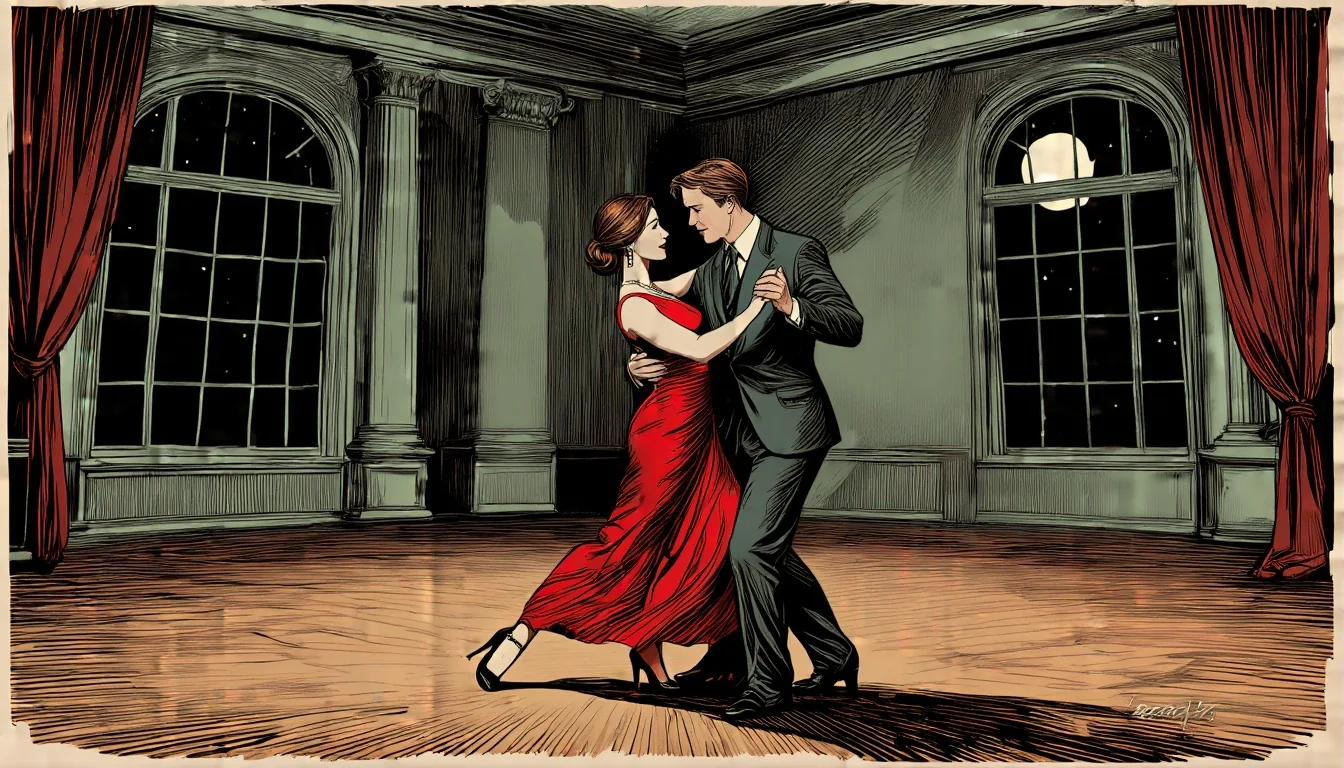
Z-Image Base LoRA, testo in immagine, 16:9 (1344×768), seed 43, LoRA mikkoani con scale 1.
Un'altra osservazione utile: la frase da sola, senza la LoRA, ha già spostato un prompt fotografico verso l'illustrazione. Base segue con forza la formulazione, quindi una frase trigger può portare con sé parte dello stile anche se il file non si carica. Questo rende la coppia con e senza un po' meno evidente: confronta la qualità del tratto e la palette, non solo il genere.
Strength in modifica: la scala
L'endpoint di modifica accetta un'immagine sorgente, uno strength da 0 a 1 e lo stesso campo loras. Il nostro valore pubblico predefinito è 0.7; quello dell'upstream è 0.6. Abbiamo eseguito una scala su una foto senza LoRA:
| Strength | Che cosa abbiamo visto |
|---|---|
| 0.3 e 0.5 | Quasi invariata |
| 0.6 | Lieve cambiamento |
| 0.7 | Il contenuto comincia a cambiare; composizione mantenuta |
| 0.75 | La scena viene reimpostata nella posa e nella messa in scena, luce e palette restano |
| 0.85 | Un'immagine nuova |
Con una LoRA di stile l'immagine cambia: a 0.6 ha ridisegnato l'intera inquadratura mantenendo esattamente la composizione. È il punto ottimale per trasformare una foto in un'illustrazione.
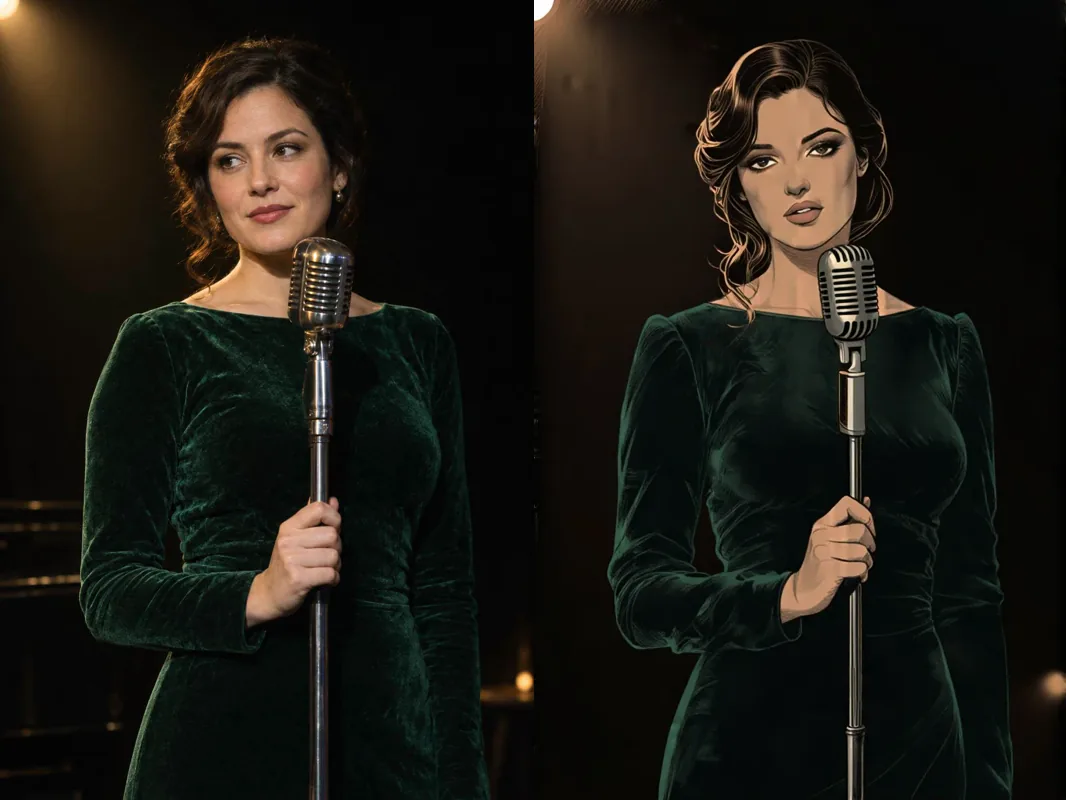
A sinistra: la nostra foto sorgente generata. A destra: Z-Image Base LoRA, immagine in immagine, 1k, seed 51, LoRA mikkoani con scale 1, strength 0.6.
Il prompt di modifica descrive l'intera immagine che vuoi, non solo il cambiamento:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Una seconda sorgente, un uomo su un tetto al tramonto con una camicia di lino bianca aperta, con la stessa strength:
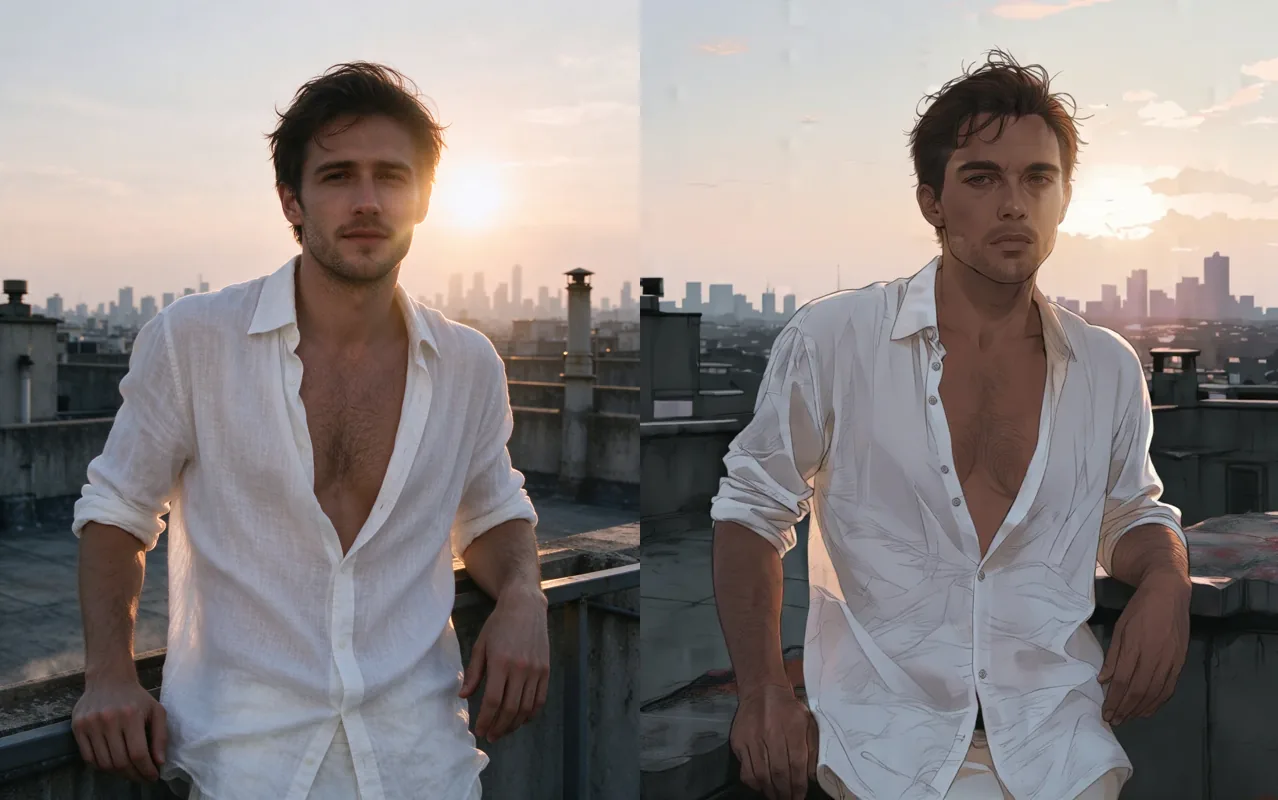
A sinistra: la nostra foto sorgente generata. A destra: Z-Image Base LoRA, immagine in immagine, 1k, seed 54, LoRA mikkoani con scale 1, strength 0.6.
E una sorgente larga a 1.5k e strength 0.65:
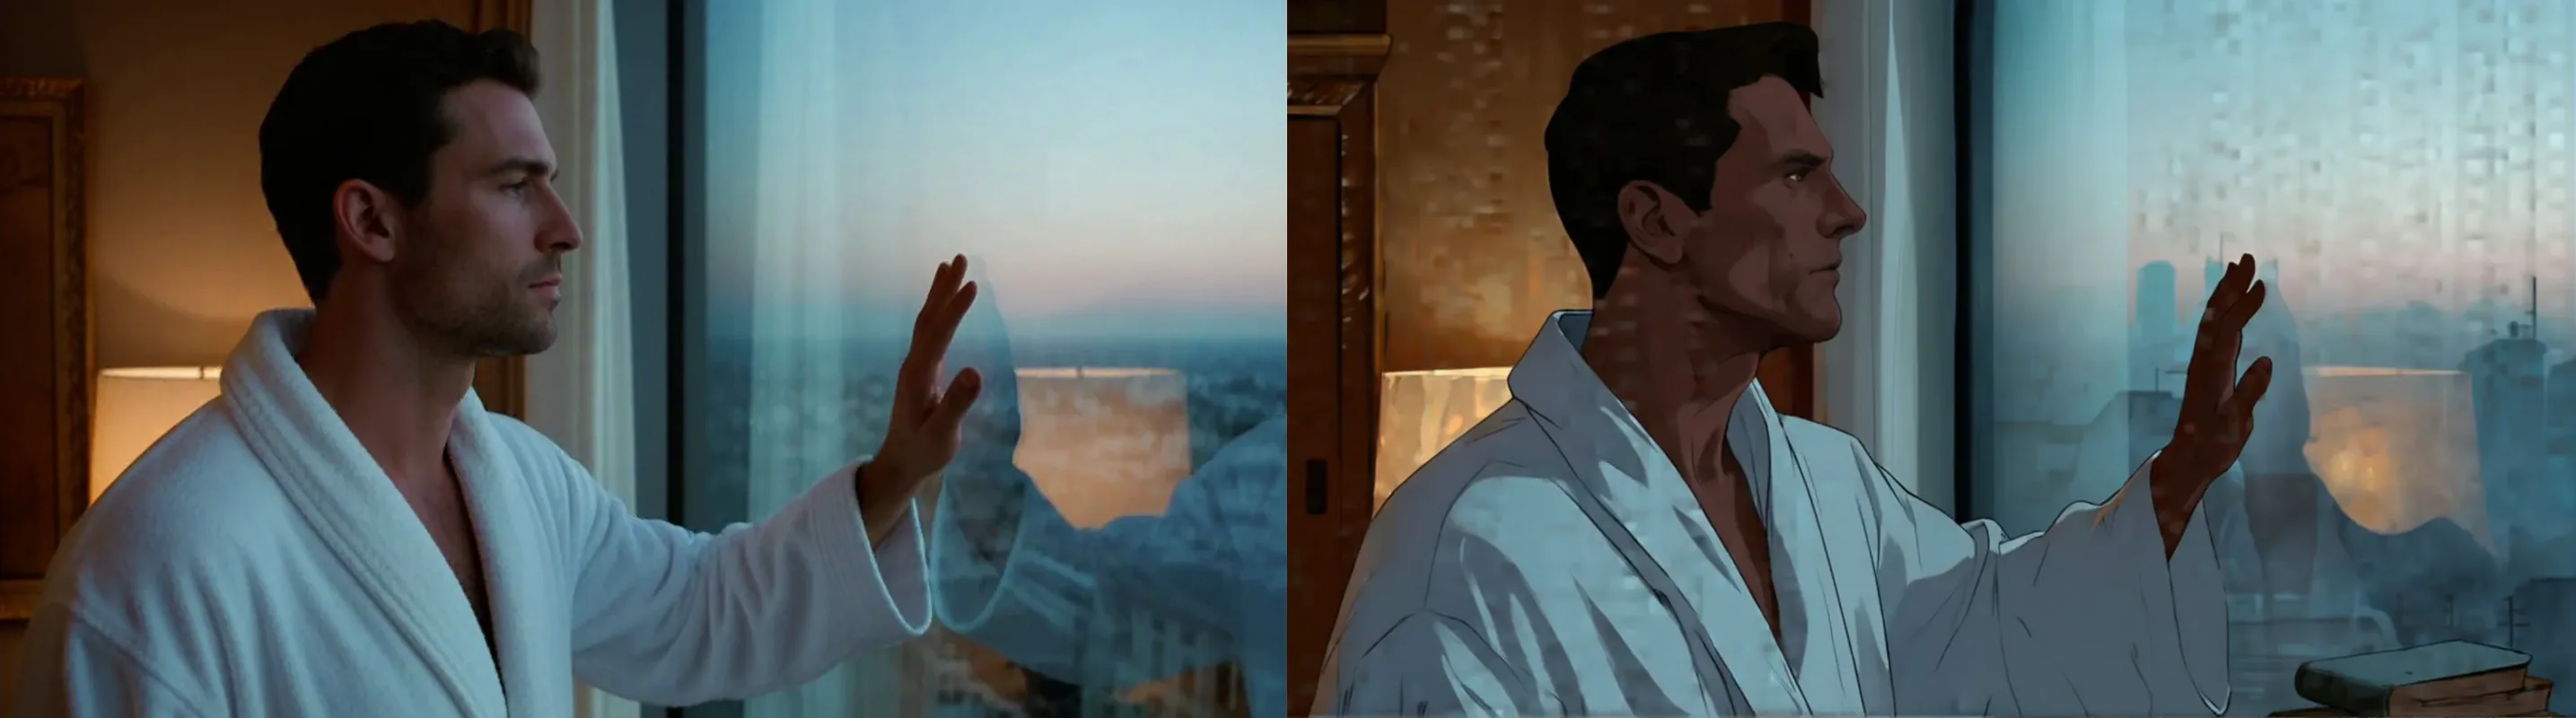
A sinistra: la nostra foto sorgente generata. A destra: Z-Image Base LoRA, immagine in immagine, 1.5k, seed 55, LoRA mikkoani con scale 1, strength 0.65.
Ridisegna nello stile; non segue istruzioni
Senza una LoRA, "make it black and white" è rimasto a colori con strength 0.65 e 0.8, e "put him in a tuxedo" ha cambiato poco con 0.7 e 0.8. Il modello ridisegna l'inquadratura a partire dalla tua descrizione. Per cambiare medium, porta una LoRA di stile; per una scena diversa, descrivila per intero e alza la strength. I dettagli sono nella pagina della modifica.
Dimensioni
Il testo in immagine offre nove proporzioni su dimensioni native SDXL, e tutte e nove sono state completate esattamente alla dimensione richiesta:
| Proporzione | Dimensione | Proporzione | Dimensione |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
L'upstream accetta da 256 a 1536 per lato: 1536×1536 e 256×256 sono stati completati, mentre 1600×896, 2048×2048 e 200×200 sono falliti con un errore sul vincolo di dimensione. Nelle modifiche, resolution imposta solo il lato lungo e la proporzione della sorgente viene mantenuta: una foto 2:3 a 1k è tornata a 680×1024, e una foto 16:9 a 1.5k è tornata a 1536×856.
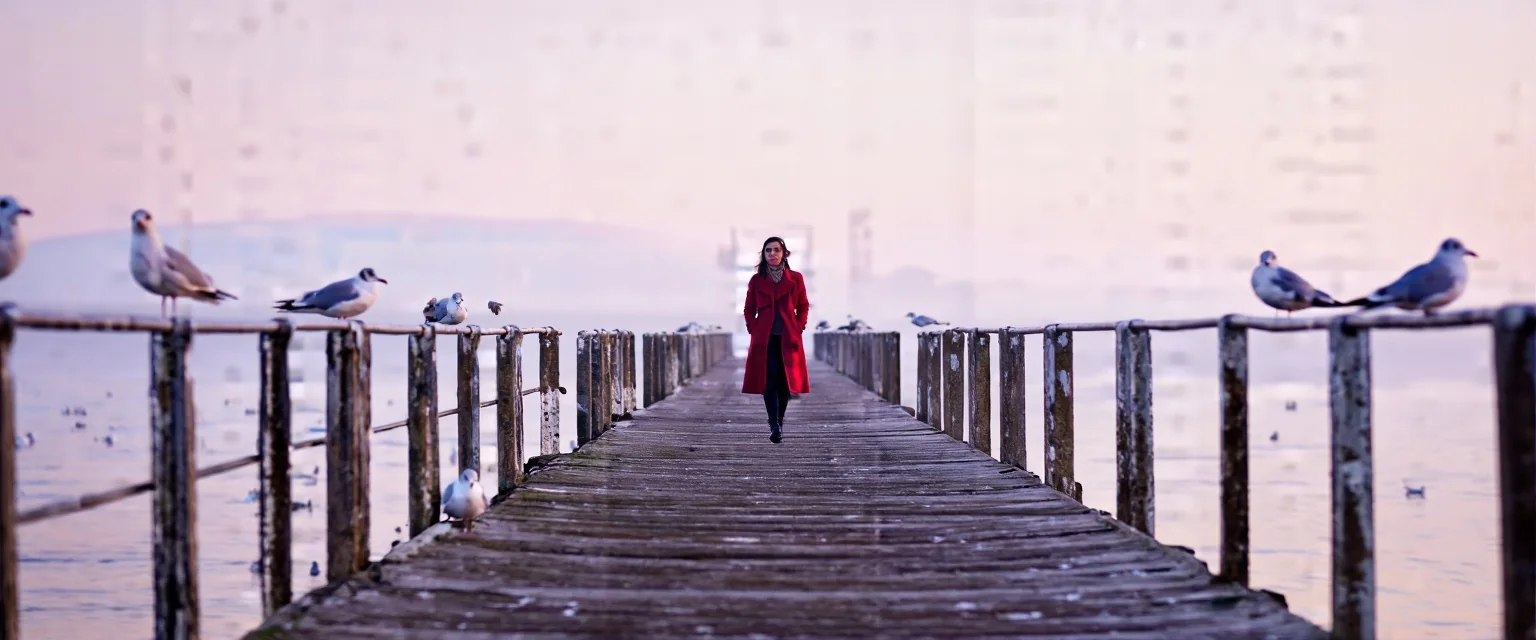
Z-Image Base LoRA, testo in immagine, 21:9 (1536×640), seed 45, nessuna LoRA.
La stessa forma larga si adatta alle scene di strada:
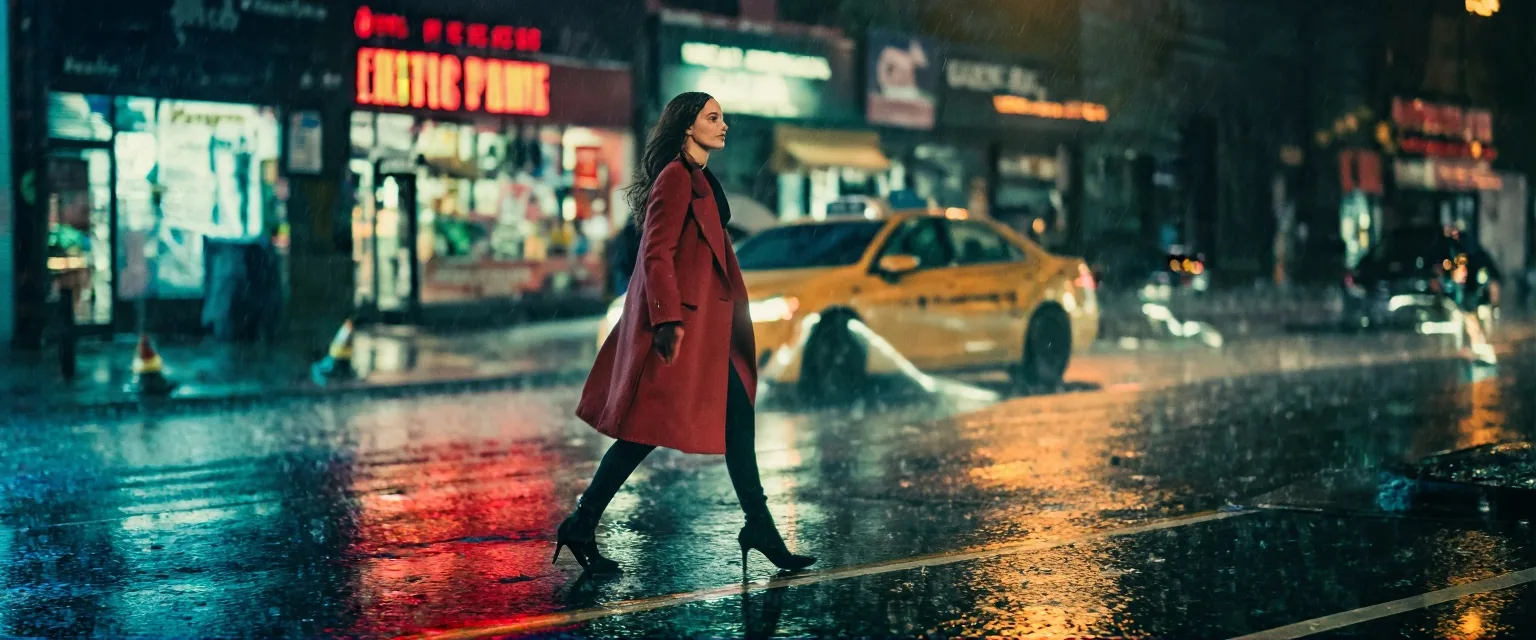
Z-Image Base LoRA, testo in immagine, 21:9, nessuna LoRA.
Che cosa si attenua
Davanti al modello non c'è alcun filtro sui contenuti. Nella nostra scala, con gli adulti dichiarati in ogni prompt, il testo in immagine ha dato come scritti L1 Allusivo (lingerie, uno spallino che scivola), L2 Temi maturi, L3 Forte, L5 Estremo (bondage consensuale tra adulti, o gore cinematografico) e la versione maschile di L3. L4 Intenso (una scena intima tra due adulti) è tornato attenuato in tre tentativi: i seed hanno dato figure e un po' di contatto, ma nessuna scena coerente. L'immagine in immagine su una sorgente vestita si è comportata allo stesso modo: i gradini più bassi sono stati resi, L3 da strength 0.8 in su (0.7 era parziale) e L4 attenuato.
Il riassunto onesto è quindi che Base da solo disegna male quel gradino più alto. Le LoRA addestrate per questo sono la via prevista, con la stessa regola «solo Base» di cui sopra. Non abbiamo testato l'immagine in immagine con tre LoRA, né LoRA da link di Civitai.
Z-Image Base LoRA o Z-Image Turbo LoRA
Il confronto dell'editore stesso tra i due modelli:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Passi | Da 28 a 50 | 8 |
| CFG | sì | no |
| Fine-tuning possibile | sì | no |
| Prompt negativo | sì (non esposto da questo endpoint) | no |
| Diversità | Alta | Bassa |
| Qualità visiva | Alta | Molto alta |
Z-Image Turbo LoRA è il modello distillato a 8 passi con fino a tre LoRA addestrate per Turbo, circa un megapixel in nove proporzioni, e la sua strength predefinita nell'immagine in immagine è 0.8. Per come si comporta un adattatore Turbo, vedi il nostro test a parità di seed su Turbo LoRA. Le due famiglie non condividono le LoRA. Un file Turbo su Base ha rovinato l'immagine nel nostro test; non abbiamo testato il contrario, quindi non dare per scontato che un file Base sia sicuro su Turbo.
| Che cosa vuoi | Scegli |
|---|---|
| Una LoRA addestrata su Z-Image Base | Z-Image Base LoRA |
| Una LoRA addestrata su Z-Image Turbo | Z-Image Turbo LoRA |
| La risposta più veloce, in pochi secondi | Turbo; Base ha impiegato una mediana di 32,8 s per il testo in immagine |
| Da foto a illustrazione con una LoRA di stile | Modifica con Base a strength circa 0.6, con una LoRA di stile addestrata su Base |
| Prompt semplici con forte aderenza, senza LoRA | Entrambi; Base ha seguito da vicino la formulazione nei nostri test |
| Controllo su passi, guidance o prompt negativo | Nessuno dei due endpoint li espone |
Z-Image Base LoRA, testo in immagine, nessuna LoRA, un prompt da ritratto cinematografico dal nostro set di copertine.
FAQ
Posso usare una LoRA Z-Image Turbo su Base?
No. Nel nostro test una LoRA addestrata per Turbo si è caricata su Base senza errori e ha ridotto l'immagine a rumore e pseudo-testo. Usa file addestrati su Z-Image Base.
Perché la mia LoRA Z-Image non ha cambiato nulla?
Probabilmente è stata salvata in un formato di chiavi diverso o addestrata per un altro modello. Un file etichettato per Z-Image ma salvato in modo diverso, e una LoRA Pony, si sono caricati entrambi e hanno dato un output identico al pixel. Esegui una coppia con e senza.
Che strength di modifica devo usare?
Parti dal valore predefinito 0.7, oppure da circa 0.6 con una LoRA di stile per mantenere la composizione. Nella nostra scala 0.3 e 0.5 hanno cambiato appena la foto, 0.75 ha rimesso in scena la composizione e 0.85 ha dato un'immagine nuova.
Può seguire istruzioni come "make it black and white"?
No. Senza una LoRA, il bianco e nero è rimasto a colori a 0.65 e 0.8, e una richiesta di smoking ha cambiato poco. Ridisegna a partire dalla tua descrizione, quindi usa una LoRA di stile per il look.
Quali dimensioni posso usare?
Nove proporzioni per il testo in immagine, fino a 1536 per lato, e 1k o 1.5k per il lato lungo nelle modifiche. Una richiesta da 200×200 o 2048×2048 è fallita nei nostri test.
Quanto è lento Base?
Il testo in immagine ha richiesto da 9,8 a 56,7 secondi con una mediana di 32,8 su 36 esecuzioni. Le modifiche hanno richiesto da 4,9 a 41,7 secondi con una mediana di 16,8 su 28 esecuzioni.
Base disegna le scene più intime?
Non in modo convincente da solo. In tre tentativi quel gradino è tornato attenuato, mentre i gradini sotto sono stati resi come scritti. Le LoRA addestrate per questo sono il modo di andare oltre.
Posso impostare passi, guidance o un prompt negativo?
No. L'endpoint non ha questi campi, anche se l'editore consiglia da 28 a 50 passi per il modello.