Wan 2.2 LoRA ora accetta una scena scritta da sola: un prompt restituisce una clip di 5 o 8 secondi a 480p o 720p, in orizzontale o in verticale, con fino a tre LoRA in ciascuno dei tre slot. Nei nostri test del 5 ottobre 2026 ognuna delle quattro combinazioni di dimensioni che abbiamo eseguito è tornata esattamente alla dimensione in pixel richiesta, l'istruzione di camera in fondo al prompt è stata seguita in ogni clip, e l'endpoint è rimasto senza censura: nessun rifiuto e nessuna clip sostituita. Anche i suoi limiti sono chiari: nessun audio, nessun formato quadrato, niente sopra i 720p, e il gradino più spinto della nostra scala di contenuti è stato attenuato.
Fino a oggi la famiglia Wan 2.2 LoRA aveva un solo endpoint, da immagine a video, che anima un'immagine che fornisci tu. Il nuovo endpoint da testo a video non richiede alcuna immagine. Questo articolo racconta che cosa abbiamo misurato, come si comportano i tre slot LoRA, i prompt che hanno funzionato e quando sceglierlo al posto del suo gemello. Ogni prompt che riportiamo è una scena quotidiana o glamour con adulti vestiti; basta per imparare i controlli.
In breve
| Domanda | Risposta (testato il 5 ottobre 2026) |
|---|---|
| Modello | Wan2.2-T2V-A14B del team Tongyi Wan di Alibaba, rilasciato come pesi aperti il 28 luglio 2025 |
| Nome del modello API | alibaba/wan-2.2-lora/text-to-video |
| Input obbligatorio | Solo prompt |
| Formati | aspect_ratio 16:9 (predefinito) o 9:16 |
| Risoluzione | 480p (predefinita) o 720p |
| Durata | 5 s (predefinita) o 8 s; qualsiasi altro valore viene rifiutato, mai arrotondato |
| Slot LoRA | loras (entrambi gli expert), high_noise_loras, low_noise_loras: fino a 3 voci ciascuno, scale da 0 a 4 |
| Disponibili anche | negative_prompt, seed (stesso seed e stessi input hanno dato un file identico byte per byte) |
| Che cosa torna | MP4, H.264, 30 fps, nessuna traccia audio, una clip per richiesta |
| Velocità nei nostri test | 480p, 5 s: circa 65–75 s; 480p, 8 s: circa 80 s; 720p, 5 s: circa 110–150 s; una LoRA aggiunge da 5 a 15 s |
| Non disponibili | Audio, formati quadrati o 4:3, 1080p, frame rate, passi, guidance, espansione del prompt |
| Fatturazione | Al secondo di video alla risoluzione scelta; la proporzione non la cambia; caricare LoRA non aggiunge alcun addebito separato; le richieste fallite non vengono addebitate |
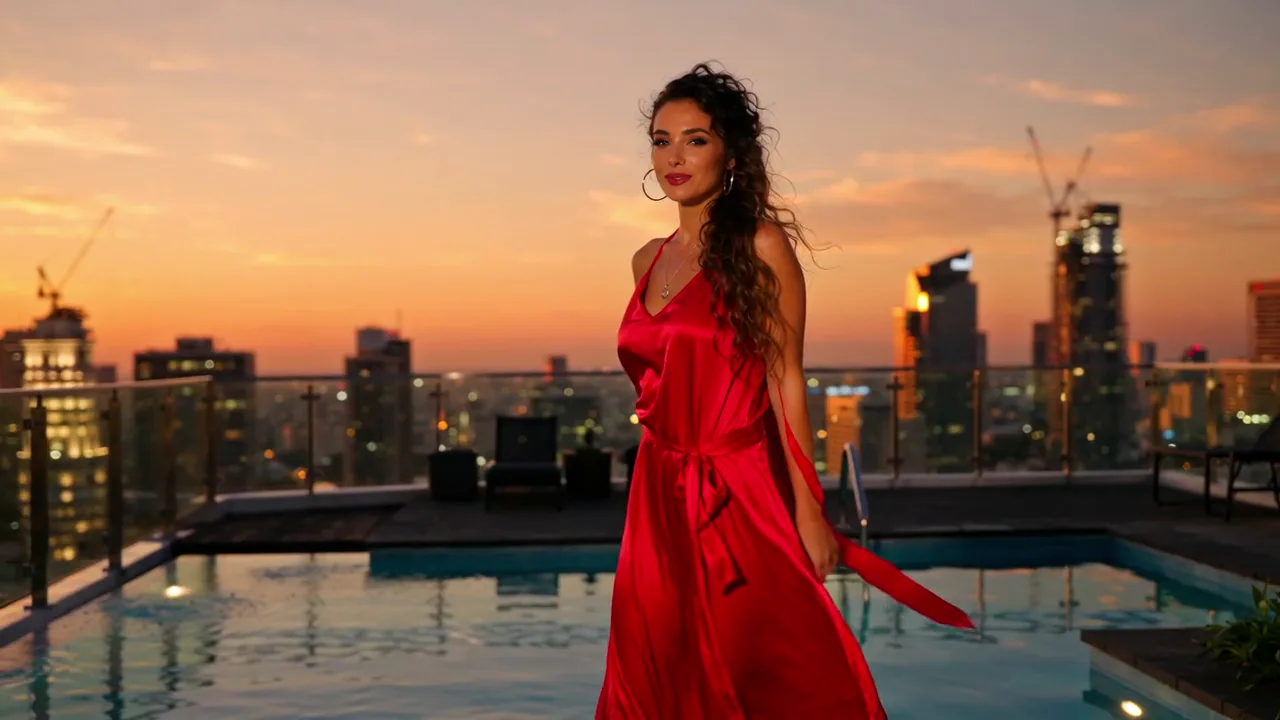
Wan 2.2 LoRA da testo a video, 720p, 16:9, 5 s, seed 20261005, nessuna LoRA, con un prompt negativo. Primo fotogramma della clip; il prompt è riportato più sotto.
Che cos'è il modello
Wan 2.2 è un modello di diffusione video del team Tongyi Wan di Alibaba. La build da testo a video ha un'architettura Mixture-of-Experts con due expert da circa 14 miliardi di parametri ciascuno. Ne gira uno solo alla volta: l'expert ad alto rumore gestisce i primi passi di denoising e stabilisce la disposizione e il movimento, mentre l'expert a basso rumore subentra nei passi successivi e rifinisce i dettagli. Questa divisione è il motivo per cui questo endpoint ha tre slot LoRA invece di uno.
L'editore dice di averlo addestrato su dati curati, etichettati per illuminazione, composizione, contrasto e tono di colore, con molto più materiale rispetto a Wan 2.1 (il 65,6% in più di immagini e l'83,2% in più di video), e che supporta 480P e 720P. Nelle nostre esecuzioni questo si è visto in persone e pelle fotorealistiche, interni caldi con poca luce, ora dorata, neon e pioggia, e movimenti di camera lenti di dolly, avvicinamento e orbita. Le semplici frasi in inglese hanno funzionato bene. Non ci è mai servita una zuppa di tag.
Che cosa cambia rispetto a da immagine a video
Entrambi gli endpoint condividono gli stessi campi LoRA e le stesse durate di 5 o 8 secondi. Le differenze decidono quale scegliere:
| Da immagine a video (esistente) | Da testo a video (nuovo) | |
|---|---|---|
| Pagina dell'endpoint | Da immagine a video | Da testo a video |
| Input obbligatorio | prompt e image_url | prompt |
| Chi stabilisce il look | Il tuo fotogramma iniziale: soggetto, abito, scena e formato | Il prompt, più il seed |
| Formato | Segue il fotogramma iniziale | 16:9 o 9:16 |
| Prompt negativo | No | Sì |
| Prezzo al secondo | Più basso | Più alto; i due sono prezzati separatamente, quindi controlla il prezzo aggiornato su ciascuna pagina |
La regola pratica: se un volto, un abito o un prodotto deve corrispondere a qualcosa che hai già, usa da immagine a video. Se stai esplorando una scena, un'atmosfera o un movimento di camera e non ti importa quale adulto compaia, usa da testo a video. Un buon flusso di lavoro è esplorare con da testo a video, scegliere il fotogramma migliore e poi continuare da quel fotogramma sull'endpoint gemello.
Dimensioni, durate e che cosa torna davvero
Abbiamo eseguito tutte e quattro le combinazioni di dimensioni e entrambe le durate. Ogni richiesta ha restituito esattamente la dimensione in pixel richiesta:
aspect_ratio e resolution | Dimensione dell'output | Richiesta da 5 s | Richiesta da 8 s |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161 fotogrammi, 5,37 s | 247 fotogrammi, 8,23 s |
| 9:16, 480p | 480 x 832 | 5,37 s | non eseguita |
| 16:9, 720p | 1280 x 720 | 5,37 s | non eseguita |
| 9:16, 720p | 720 x 1280 | 5,37 s | non eseguita |
Due dettagli da conoscere. Le clip durano leggermente più del richiesto a causa dell'interpolazione dei fotogrammi: una richiesta da 5 secondi ha dato 5,37 secondi e una da 8 secondi ha dato 8,23 secondi. E l'output è muto. Se alla clip serve il suono, aggiungilo dopo.
Illustrazione dalla grafica della pagina del modello, non una clip di prova: le due durate, 5 secondi a sinistra e 8 a destra.
La nostra regola pratica per la risoluzione: fai la bozza a 480p, perché è il valore predefinito, si completa in circa un minuto, e la composizione che vedi è quella che otterrai a 720p. Passa a 720p per il rendering finale. Per la durata: 5 secondi bastano per un'azione e un movimento di camera; scegli 8 solo quando l'azione ha un inizio, uno svolgimento e una fine.
Prompt che hanno funzionato
La struttura che non ci ha mai deluso ha quattro parti in un solo paragrafo: chi, che cosa fa, la luce e, per ultimo, il movimento di camera. Tutto ciò che segue usava adulti e ambientazioni quotidiane o glamour.
Tetto al crepuscolo (16:9, 720p, 5 s, seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
La seta, i riflessi dello skyline e la luce calda sono arrivati tutti, e la donna ha mantenuto lo stesso volto e lo stesso abito per tutta la clip. La striscia qui sotto mostra quattro fotogrammi nell'arco dei cinque secondi:
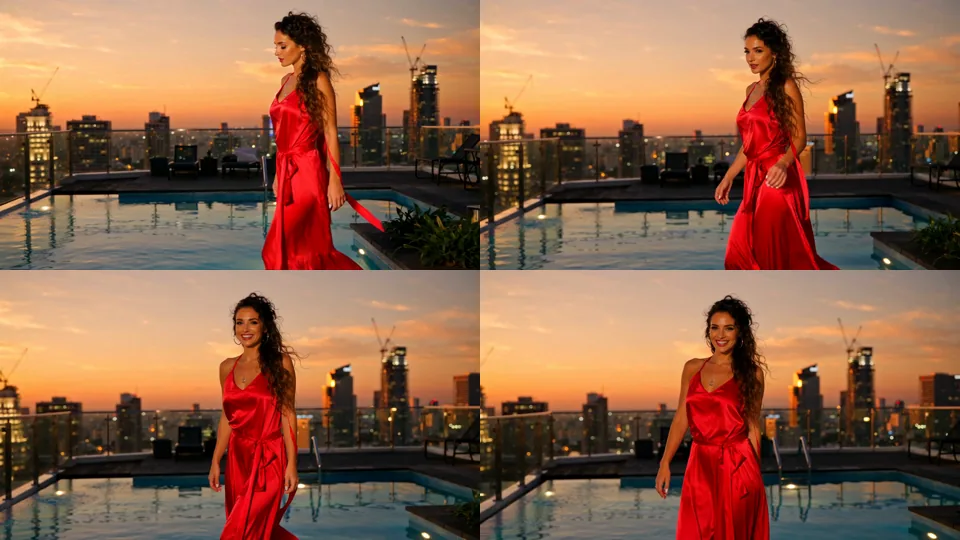
Fotogrammi a circa 0,1, 1,8, 3,6 e 5,2 secondi della clip sul tetto. La camminata, la rotazione e il movimento di carrellata avvengono come scritto.
Ritratto al neon sotto la pioggia (9:16, 720p, 5 s, seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}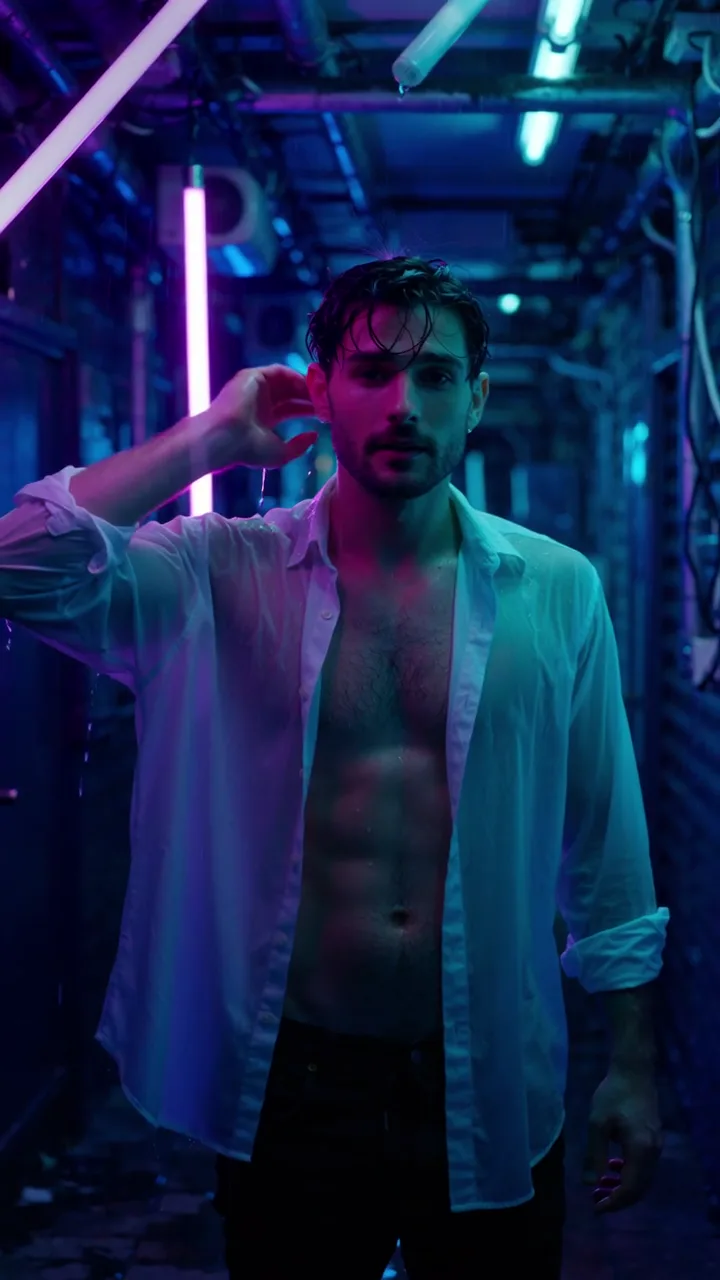
Verticale 720p, 5 s, seed 32. Fotogramma di copertina; sia il gesto di spingere indietro i capelli sia il lento avvicinamento avvengono sullo schermo.
Nota la frase "no signs or lettering anywhere". La nostra prima versione di questo prompt aveva un'insegna al neon sullo sfondo, e il modello ci ha disegnato sopra lettere illeggibili. Abbiamo riscritto la scena attorno a tubi di luce nudi e il problema è scomparso. Wan 2.2 non scrive in modo affidabile, quindi dagli una scena in cui non ci sia nulla da scrivere.
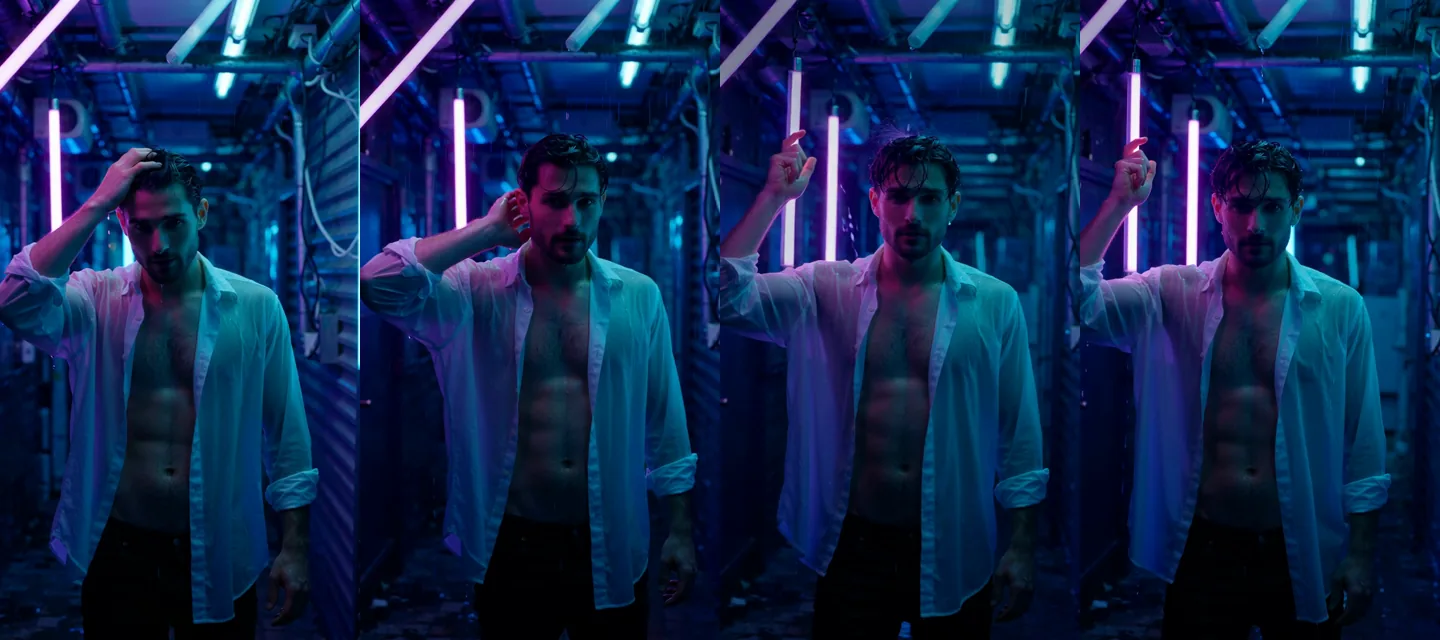
Fotogrammi a circa 0,1, 1,8, 3,6 e 5,2 secondi della clip verticale. Il volto e la camicia restano coerenti dal primo all'ultimo fotogramma.
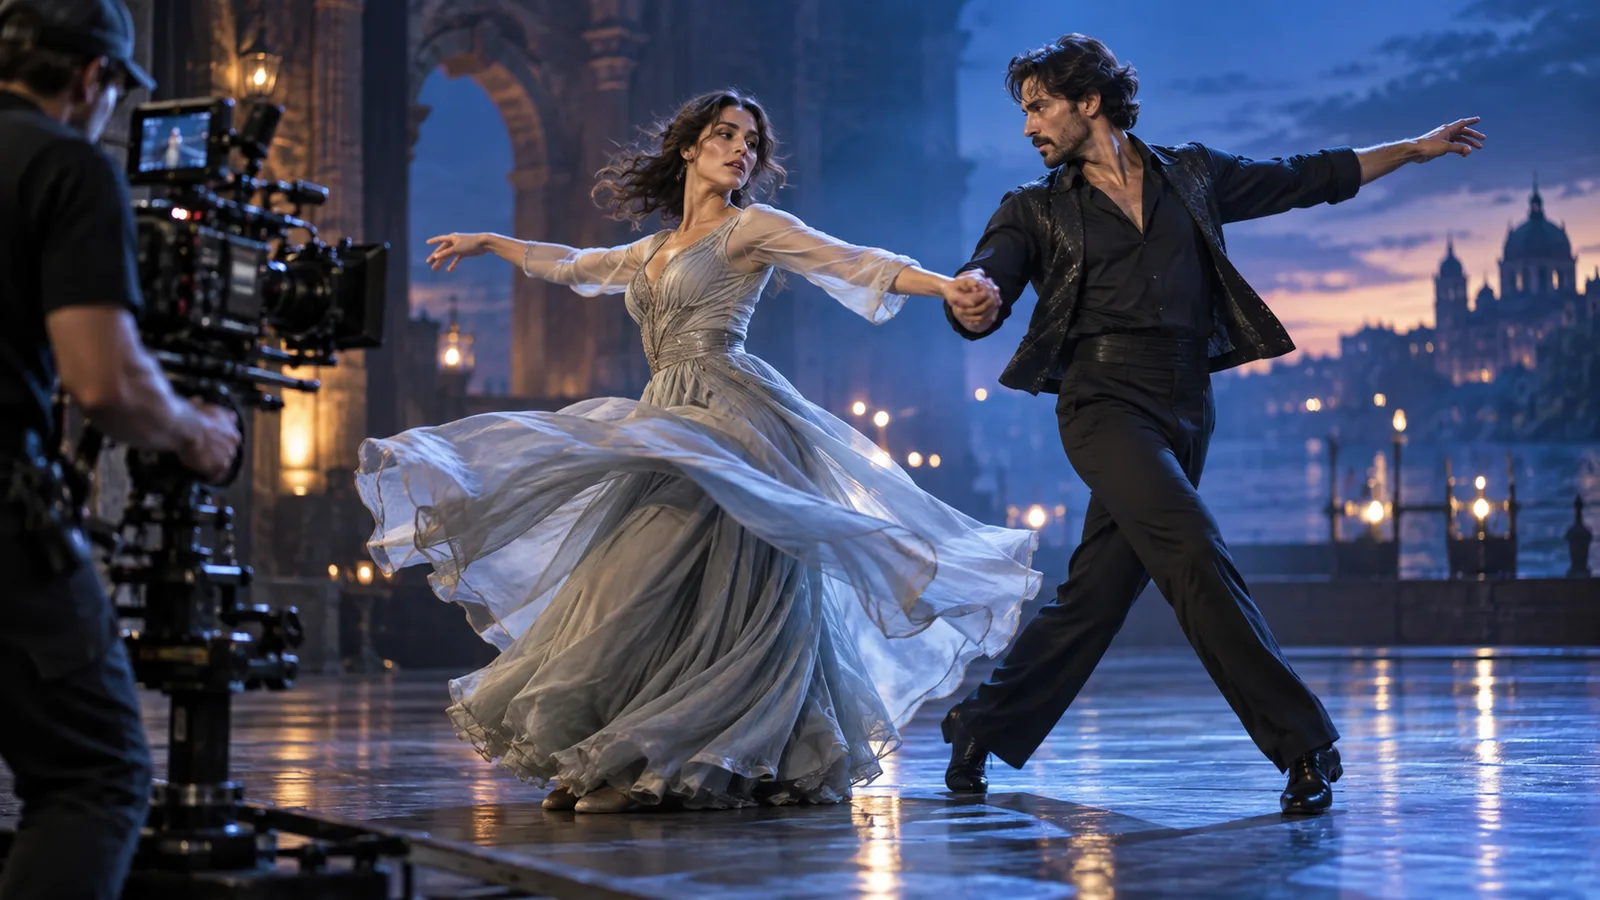
Tango a lume di candela (16:9, 720p, 5 s, seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
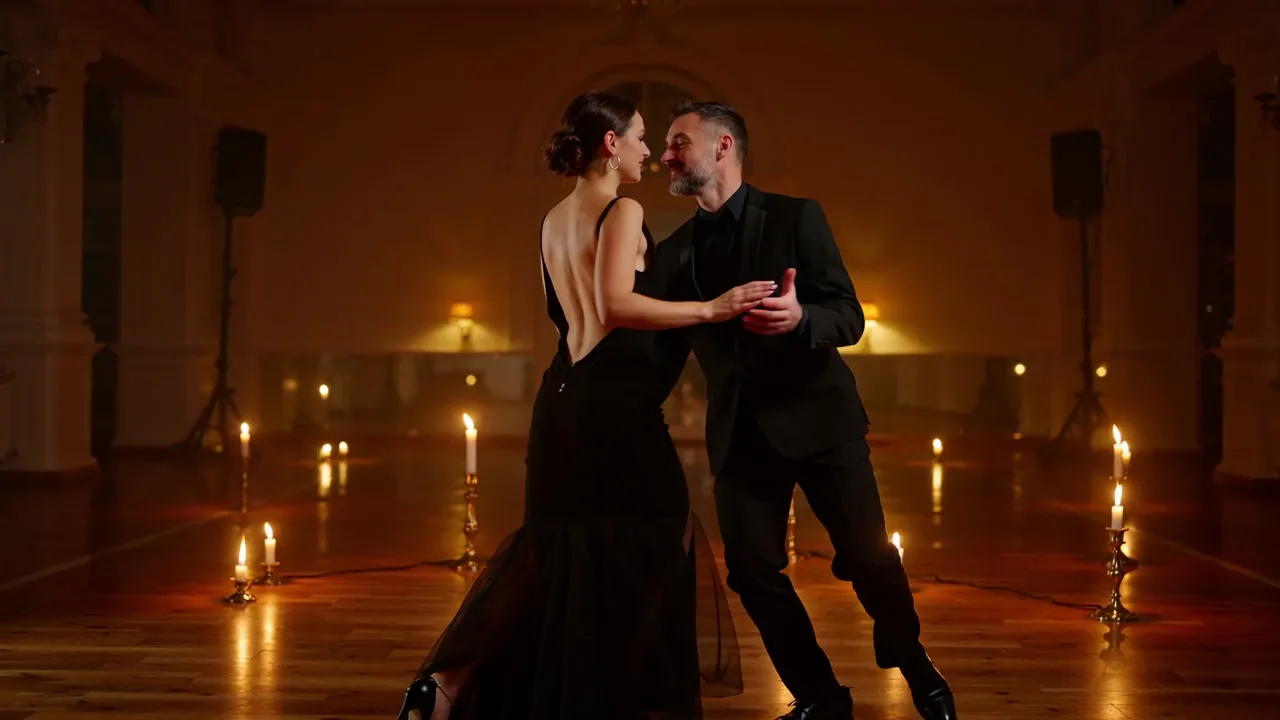
Clip del tango, 16:9, 720p, 5 s, seed 47. Fotogramma di copertina dall'esempio pubblicato.
La messa in scena a due persone è dove i modelli video di solito si sfaldano, e questo ha tenuto meglio di quanto ci aspettassimo. I fotogrammi qui sotto mostrano la coppia che si avvicina sempre di più e finisce nella caduta. I riflessi delle candele sul pavimento restano al loro posto mentre la camera orbita.
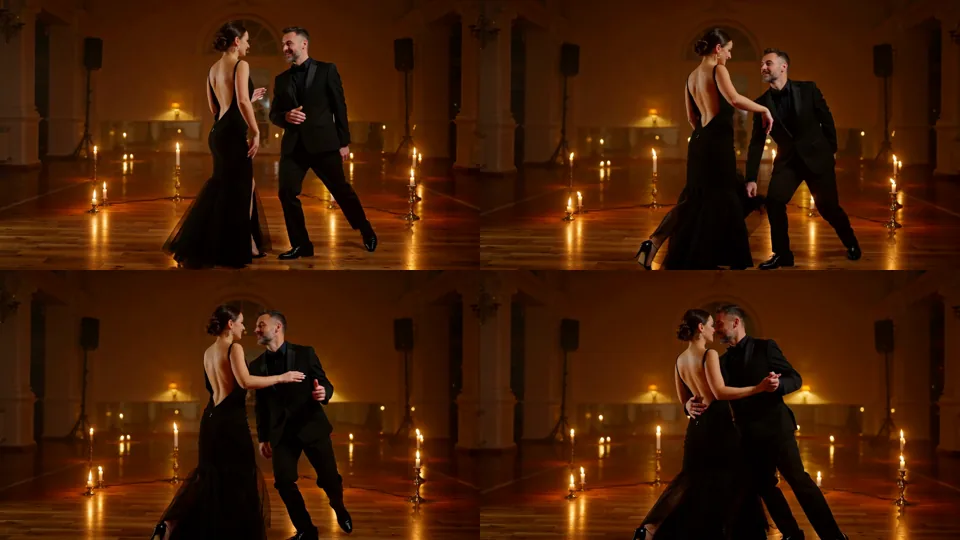
Fotogrammi a circa 0,1, 1,8, 3,6 e 5,2 secondi della clip del tango.
Abitudini che hanno dato frutto in tutte le nostre esecuzioni:
- Scrivi "adult" e indica una fascia d'età. Mantiene sensato il casting ed è la regola della casa per tutto ciò che pubblichiamo.
- Metti per ultima l'istruzione di camera. "Slow dolly tracking shot", "slow push-in" e "slow orbiting camera" sono state tutte seguite nella clip in cui comparivano.
- Chiedi un'azione per clip. Una camminata e una rotazione stanno in cinque secondi; una storia no.
- Usa il prompt negativo per gli artefatti, non per i gusti. "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo" è un'impostazione predefinita sensata; la clip al neon è stata eseguita senza.
- Fissa il seed mentre iteri. Lo stesso seed e gli stessi input hanno dato un file identico byte per byte, quindi un cambiamento nel risultato è un cambiamento che hai fatto tu.
I tre slot LoRA, e quando usare quale
Qui l'endpoint si distingue da una chiamata Wan 2.2 semplice. Ogni slot accetta fino a tre voci nella forma {path, scale}, dove path è un link HTTPS diretto a un file .safetensors e scale va da 0 a 4 (predefinito 1).
Illustrazione dalla grafica della pagina del modello, non una clip di prova: tre chiavi, tre aperture, una per ogni slot.
| Slot | Raggiunge | Usalo per |
|---|---|---|
high_noise_loras | Solo l'expert ad alto rumore | Disposizione e movimento: un movimento di camera, un tipo di azione, la composizione generale |
low_noise_loras | Solo l'expert a basso rumore | Dettaglio e texture: pelle, tessuto, grana della pellicola, stile di rendering |
loras | Entrambi gli expert | Una LoRA a file singolo, o quando vuoi che un file agisca su entrambe le fasi |
La maggior parte delle LoRA Wan 2.2 su Hugging Face e Civitai è pubblicata come coppia: un file high_noise e un file low_noise. Metti ciascuno nel proprio slot. Una LoRA rilasciata come file unico va in loras. Se una scheda non dice nulla su quale fase un file riguardi, parti con loras e poi prova il file da solo in ciascuno slot specializzato. Per il ragionamento dietro questa scelta e per una routine di prova più lunga costruita sull'endpoint da immagine a video, leggi la nostra guida agli slot ad alto e basso rumore; questo articolo riporta soltanto ciò che ha fatto da testo a video.
Che cosa abbiamo visto con una LoRA addestrata per questa esatta base (Wan2.2-T2V-A14B), caricata in entrambi gli slot specializzati con il seed fisso:
| Esecuzione (stesso prompt, stesso seed 7, 480p, 16:9, 5 s) | Risultato rispetto alla clip senza LoRA |
|---|---|
| Nessuna LoRA | Riferimento |
| Coppia corrispondente, scale 0.5 | Stessa composizione, piccolo cambiamento nella forma del viso e nell'acconciatura |
| Coppia corrispondente, scale 1 | Cambiamento più grande: capelli più corti, un viso diverso |
Solo il file a basso rumore, in loras (entrambi gli expert), scale 1 | Ha cambiato anch'esso la persona |
| Una LoRA addestrata per un altro modello base | Identica byte per byte alla clip senza LoRA |
L'ultima riga è quella da ricordare. Una LoRA costruita per un altro modello base ha prodotto esattamente lo stesso file di nessuna LoRA: nessun errore, nessun avviso, nessun effetto. Lo slot l'ha accettata e semplicemente non è successo nulla. Quindi confronta sempre con un'esecuzione senza LoRA allo stesso seed prima di concludere che una LoRA funziona, o che il tuo scale è troppo basso. La LoRA di aspetto che abbiamo usato ha cambiato la persona più dello stile, ed è per questo che mostriamo l'effetto in una tabella e non in una galleria: ha dimostrato che il caricamento è reale e che l'effetto cresce con lo scale, ma non è un file da vetrina.
Il caricamento non aggiunge alcun addebito separato, e nelle nostre esecuzioni ha aggiunto da 5 a 15 secondi di tempo del modello.
Quando il link di una LoRA fallisce
Due errori ci sono costati un'esecuzione ciascuno, ed entrambi si evitano facilmente:
- Un link che richiede un login. Un repository protetto fallisce con un messaggio che dice che il server ha restituito HTTP 401 e che chiede di verificare che l'URL sia accessibile pubblicamente. Usa un file pubblico o un link firmato.
- Una pagina del repository invece del file. Incollare la pagina del modello invece del link
resolve/main/...safetensorsha dato un generico messaggio "the job failed unexpectedly". Non è molto descrittivo, quindi se lo vedi con una LoRA allegata, controlla prima il link.
Le richieste che violano i limiti non avviano alcun lavoro: una quarta voce in uno slot, uno scale sopra 4, una durata diversa da 5 o 8, o un prompt vuoto vengono rifiutati subito.
Fin dove arriva
La piattaforma non aggiunge alcun filtro sui contenuti, e ciò che un modello disegna dipende dal modello. Abbiamo eseguito una clip a ogni gradino della nostra scala di contenuti, il 5 ottobre 2026, un'esecuzione per gradino, e abbiamo guardato ogni foglio di fotogrammi. I livelli usano gli stessi nomi delle nostre altre recensioni:
| Livello | Che cosa abbiamo chiesto | Risultato |
|---|---|---|
| L1 Allusivo | Lingerie, uno spallino che scivola | Reso |
| L2 Temi maturi | Seno scoperto | Reso |
| L3 Forte | Livello completo, una donna e un uomo | Reso |
| L4 Intenso | Una scena intima tra due adulti | Attenuato: la scena viene disegnata, ma non per intero |
| L5 Estremo | Bondage consensuale tra adulti; gore cinematografico | Bondage reso; gore attenuato a qualche taglio e segno |
Nessuna esecuzione è stata rifiutata e nessuna clip è stata sostituita con un'altra. Leggi con onestà le righe L4 e gore: il modello arriva lontano, e poi si calma. Se il tuo caso d'uso vive in cima alla scala, metti in conto che resti corto. È un'esecuzione per gradino, quindi considera la tabella una prima lettura, non una garanzia. La nostra recensione di Wan 2.2 LoRA ha il resoconto più lungo su date precedenti.
Dove è carente
- Video muto. Non c'è traccia audio né un'opzione audio.
- Solo due formati. 16:9 e 9:16. Per un post quadrato, ritaglia dopo.
- 720p è il tetto. Non c'è un livello 1080p.
- Durate fisse. Esattamente 5 o 8 secondi. Abbiamo chiesto 6 e abbiamo ricevuto un rifiuto, meglio di un arrotondamento silenzioso.
- Pochi controlli. Niente frame rate, passi, guidance o espansione del prompt. Guidi con le parole, il seed, il prompt negativo e le LoRA.
- Il testo nell'inquadratura non è affidabile. Vedi l'esempio al neon qui sopra.
- Più lento di un'immagine statica. Una clip a 720p di 5 secondi ha richiesto circa due minuti di tempo del modello nelle nostre esecuzioni, quindi pianifica i lotti tenendone conto.
- Una base di test sottile. Abbiamo eseguito una clip per gradino della scala e una manciata di confronti tra LoRA. Non abbiamo testato gli estremi dell'intervallo del seed, che cosa fa un prompt negativo ai contenuti, né un'esecuzione con tutte e nove le voci LoRA caricate.
Quale endpoint usare
| Vuoi... | Usa | Perché |
|---|---|---|
| Esplorare una scena, un'atmosfera o un movimento di camera | Da testo a video | Una frase in ingresso, nessuna immagine sorgente necessaria |
| Un volto, un abito o un prodotto preciso da mantenere | Da immagine a video | Il fotogramma iniziale fissa il look |
| Una clip verticale per il telefono | Da testo a video, 9:16 | Il formato è impostato da un parametro, non da un ritaglio |
| Una prima bozza più economica | Da testo a video, 480p, 5 s | Fai la bozza al livello più basso, poi rilancia la clip buona a 720p |
| Una composizione fissa che puoi riprodurre | Uno qualsiasi, con un seed fisso | Nei nostri test lo stesso seed e gli stessi input hanno dato un file identico byte per byte |
| Un effetto da una LoRA della community | Uno qualsiasi, con lo slot giusto | I file in coppia vanno negli slot ad alto e basso rumore, i file singoli in loras |
FAQ
Wan 2.2 LoRA da testo a video genera audio?
No. L'output è un MP4 con solo la traccia video, a 30 fps e senza suono. Aggiungi musica o parlato in un editor dopo aver creato la clip.
Qual è la differenza tra gli slot LoRA ad alto e basso rumore?
Lo slot ad alto rumore raggiunge l'expert che stabilisce disposizione e movimento, e lo slot a basso rumore raggiunge l'expert che rifinisce dettaglio e texture. Usa loras per applicare un file a entrambi. La maggior parte delle LoRA Wan 2.2 è pubblicata come coppia ad alto e basso rumore, quindi ogni file va nel proprio slot.
Perché la mia LoRA non ha cambiato nulla?
Con ogni probabilità è stata addestrata per un altro modello base. Nel nostro test, una LoRA costruita per un'altra base ha prodotto un file identico byte per byte all'esecuzione senza, senza alcun errore. Verifica che la scheda indichi Wan 2.2 da testo a video, poi confronta con un'esecuzione senza LoRA allo stesso seed.
Quali proporzioni, risoluzioni e durate supporta?
16:9 o 9:16, 480p o 720p, ed esattamente 5 o 8 secondi. Quadrato, 4:3, 1080p e altre durate non sono disponibili, e un valore fuori elenco viene rifiutato, non arrotondato.
Posso ottenere due volte la stessa clip?
Nei nostri test sì. Con lo stesso prompt, lo stesso seed e gli stessi input abbiamo ottenuto un file identico byte per byte. Se ometti il seed, ogni richiesta è casuale.
Una LoRA costa di più?
No. La fatturazione è al secondo di video alla risoluzione scelta, e caricare LoRA non aggiunge alcun addebito separato. La proporzione non cambia il prezzo, e le richieste fallite non vengono addebitate. Il prezzo aggiornato è sulla pagina del modello.
È senza censura?
La piattaforma non aggiunge alcun filtro sui contenuti. Nella nostra scala, i livelli da L1 a L3 e il bondage consensuale tra adulti sono stati resi, e i livelli più intensi sono stati attenuati. I dettagli sono nella tabella qui sopra.
Devo usare da testo a video o da immagine a video?
Usa da testo a video quando stai esplorando e va bene qualsiasi adulto adatto, e da immagine a video quando volto, abito o ambientazione devono corrispondere a un'immagine che hai già. Una routine comune è esplorare con da testo a video e portare il fotogramma migliore su da immagine a video.