Wan 2.2 LoRA accepte désormais une scène écrite seule : un prompt renvoie un clip de 5 ou 8 secondes en 480p ou 720p, en paysage ou en portrait, avec jusqu’à trois LoRA dans chacun des trois emplacements. Dans nos tests du 5 octobre 2026, chacune des quatre combinaisons de taille essayées est revenue exactement à la taille en pixels demandée, l’instruction de caméra en fin de prompt a été suivie dans chaque clip, et le point d’accès est resté sans censure : aucun refus et aucun clip substitué. Ses limites sont tout aussi claires : pas d’audio, pas de format carré, rien au-delà du 720p, et le palier le plus intense de notre échelle de contenu a été atténué.
Jusqu’à aujourd’hui, la famille Wan 2.2 LoRA n’avait qu’un point d’accès, image vers vidéo, qui anime une image que vous fournissez. Le nouveau point d’accès texte vers vidéo n’a besoin d’aucune image. Cet article couvre ce que nous avons mesuré, le comportement des trois emplacements LoRA, les prompts qui ont fonctionné et quand le choisir plutôt que son frère. Chaque prompt reproduit est une scène du quotidien ou glamour avec des adultes habillés ; cela suffit pour apprendre les réglages.
En un coup d’œil
| Question | Réponse (testé le 5 octobre 2026) |
|---|---|
| Modèle | Wan2.2-T2V-A14B de l’équipe Tongyi Wan d’Alibaba, publié en poids ouverts le 28 juillet 2025 |
| Nom du modèle dans l’API | alibaba/wan-2.2-lora/text-to-video |
| Entrée obligatoire | prompt uniquement |
| Formats | aspect_ratio 16:9 (par défaut) ou 9:16 |
| Résolution | 480p (par défaut) ou 720p |
| Durée | 5 s (par défaut) ou 8 s ; toute autre valeur est rejetée, jamais arrondie |
| Emplacements LoRA | loras (les deux experts), high_noise_loras, low_noise_loras : jusqu’à 3 entrées chacun, scale de 0 à 4 |
| Aussi disponibles | negative_prompt, seed (même seed et mêmes entrées ont donné un fichier identique à l’octet près) |
| Ce qui revient | MP4, H.264, 30 i/s, sans piste audio, un clip par requête |
| Vitesse dans nos tests | 480p, 5 s : environ 65 à 75 s ; 480p, 8 s : environ 80 s ; 720p, 5 s : environ 110 à 150 s ; une LoRA ajoute 5 à 15 s |
| Indisponibles | Audio, formats carré ou 4:3, 1080p, fréquence d’images, étapes, guidance, extension de prompt |
| Facturation | Par seconde de vidéo à la résolution choisie ; le rapport d’aspect ne la change pas ; le chargement de LoRA n’ajoute aucun frais distinct ; les requêtes échouées ne sont pas facturées |
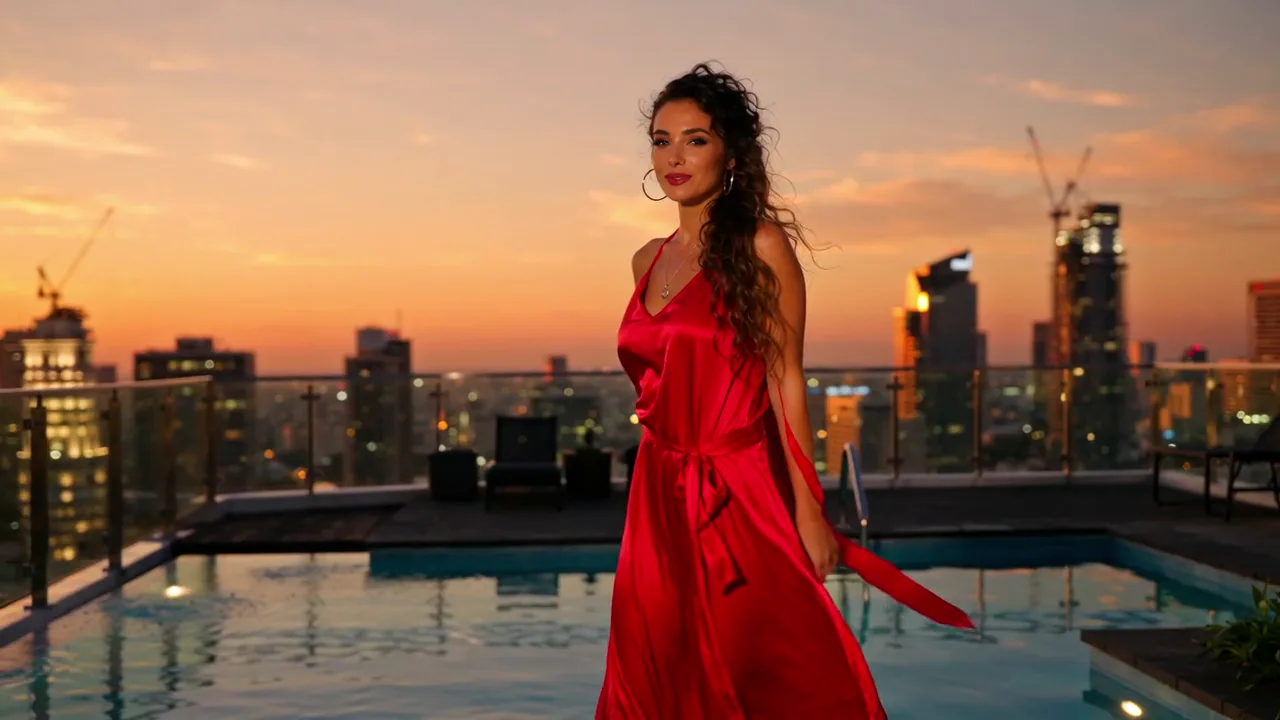
Wan 2.2 LoRA texte vers vidéo, 720p, 16:9, 5 s, seed 20261005, sans LoRA, avec un prompt négatif. Première image du clip ; le prompt est reproduit plus bas.
Ce qu’est le modèle
Wan 2.2 est un modèle de diffusion vidéo de l’équipe Tongyi Wan d’Alibaba. La version texte vers vidéo est une architecture Mixture-of-Experts avec deux experts d’environ 14 milliards de paramètres chacun. Un seul tourne à la fois : l’expert haut bruit gère les premières étapes de débruitage et fixe la mise en page et le mouvement, et l’expert bas bruit prend le relais pour les dernières étapes et affine le détail. Cette séparation explique pourquoi ce point d’accès a trois emplacements LoRA au lieu d’un.
L’éditeur indique l’avoir entraîné sur des données organisées, étiquetées pour l’éclairage, la composition, le contraste et la tonalité des couleurs, avec beaucoup plus de matériau que Wan 2.1 (65,6 % d’images et 83,2 % de vidéos en plus), et qu’il prend en charge le 480P et le 720P. Dans nos exécutions, cela s’est traduit par des personnes et une peau photoréalistes, des intérieurs chauds et peu éclairés, l’heure dorée, le néon et la pluie, et des mouvements de caméra lents de type travelling, avance et orbite. De simples phrases en anglais ont bien fonctionné. Nous n’avons jamais eu besoin d’une soupe de tags.
Ce qui change par rapport à image vers vidéo
Les deux points d’accès partagent les mêmes champs LoRA et les mêmes durées de 5 ou 8 secondes. Les différences décident de celui que vous choisirez :
| Image vers vidéo (existant) | Texte vers vidéo (nouveau) | |
|---|---|---|
| Page du point d’accès | Image vers vidéo | Texte vers vidéo |
| Entrée obligatoire | prompt et image_url | prompt |
| Qui fixe le rendu | Votre image d’ouverture : sujet, tenue, décor et format | Le prompt, plus la seed |
| Format | Suit l’image d’ouverture | 16:9 ou 9:16 |
| Prompt négatif | Non | Oui |
| Prix par seconde | Plus bas | Plus élevé ; les deux sont tarifés séparément, vérifiez donc le prix en vigueur sur chaque page |
La règle pratique : si un visage, une tenue ou un produit doit correspondre à quelque chose que vous avez déjà, utilisez l’image vers vidéo. Si vous explorez une scène, une ambiance ou un mouvement de caméra et que peu importe quel adulte apparaît, utilisez le texte vers vidéo. Un bon flux de travail consiste à explorer avec le texte vers vidéo, choisir la meilleure image, puis continuer à partir de cette image sur le point d’accès frère.
Formats, durées et ce qui revient réellement
Nous avons lancé les quatre combinaisons de taille et les deux durées. Chaque requête est revenue exactement à la taille en pixels demandée :
aspect_ratio et resolution | Taille de sortie | Requête de 5 s | Requête de 8 s |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161 images, 5,37 s | 247 images, 8,23 s |
| 9:16, 480p | 480 x 832 | 5,37 s | non lancée |
| 16:9, 720p | 1280 x 720 | 5,37 s | non lancée |
| 9:16, 720p | 720 x 1280 | 5,37 s | non lancée |
Deux détails à connaître. Les clips durent un peu plus que demandé à cause de l’interpolation d’images : une requête de 5 secondes a donné 5,37 secondes et une requête de 8 secondes a donné 8,23 secondes. Et la sortie est muette. Si le clip a besoin de son, ajoutez-le ensuite.
Illustration issue de l’habillage graphique du modèle, pas un clip de test : les deux durées, 5 secondes à gauche et 8 à droite.
Notre règle empirique pour la résolution : faites un brouillon en 480p, car c’est la valeur par défaut, il se termine en environ une minute, et la composition que vous voyez est celle que vous obtiendrez en 720p. Passez en 720p pour le rendu final. Pour la durée : 5 secondes suffisent pour une action et un mouvement de caméra ; choisissez 8 seulement quand l’action a un début, un milieu et une fin.
Prompts qui ont fonctionné
La structure qui ne nous a jamais fait défaut tient en quatre parties dans un seul paragraphe : qui, ce qu’il fait, la lumière, et le mouvement de caméra en dernier. Tout ce qui suit utilisait des adultes et des décors du quotidien ou glamour.
Toit au crépuscule (16:9, 720p, 5 s, seed 20261005) :
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
La soie, les reflets de la ligne d’horizon et la lumière chaude sont tous arrivés, et la femme a gardé le même visage et la même robe pendant tout le clip. La bande ci-dessous montre quatre images sur les cinq secondes :
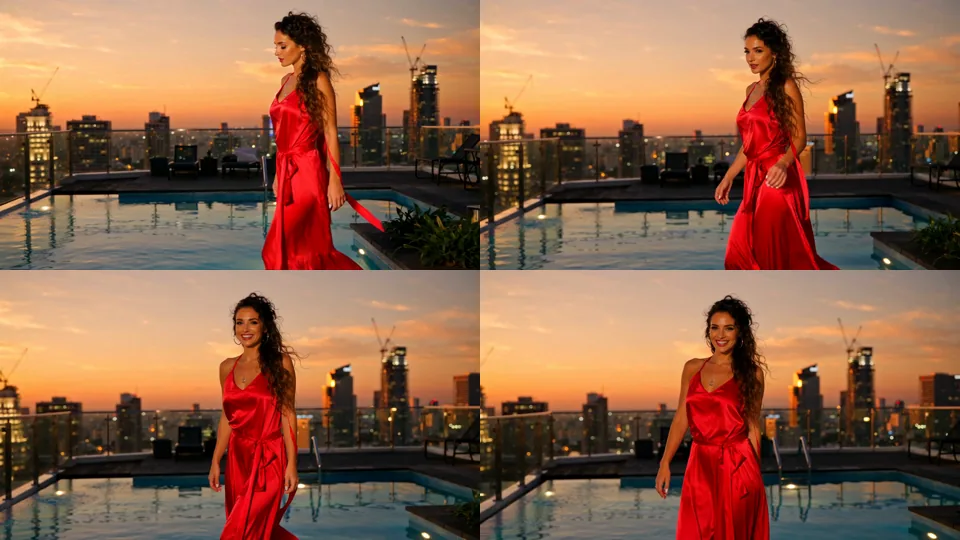
Images à environ 0,1, 1,8, 3,6 et 5,2 secondes du clip du toit. La marche, le retournement et le travelling se produisent comme écrit.
Portrait sous la pluie néon (9:16, 720p, 5 s, seed 32) :
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}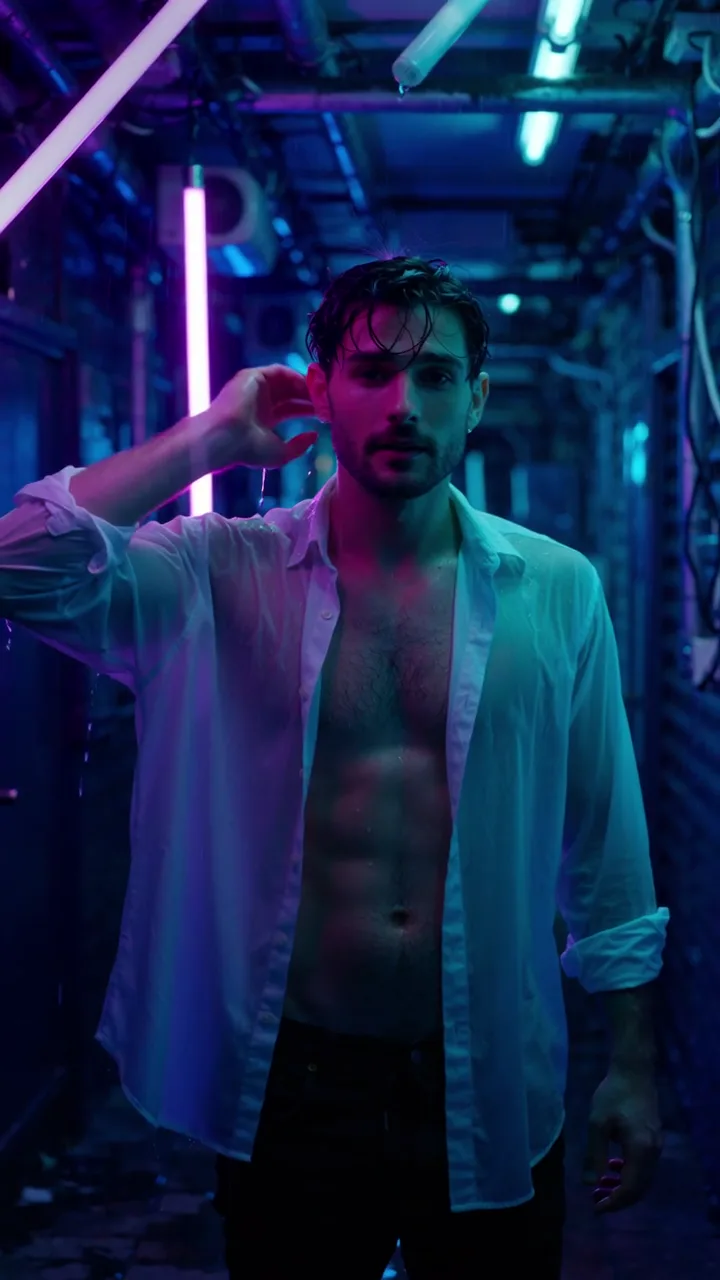
Portrait 720p, 5 s, seed 32. Image d’affiche ; le geste des cheveux repoussés et le lent travelling avant se produisent à l’écran.
Remarquez l’expression « no signs or lettering anywhere ». Notre première version de ce prompt avait une enseigne néon à l’arrière-plan, et le modèle y a dessiné des lettres brouillées. Nous avons réécrit la scène autour de tubes lumineux nus et le problème a disparu. Wan 2.2 n’épelle pas de façon fiable : donnez-lui donc une scène sans rien à épeler.
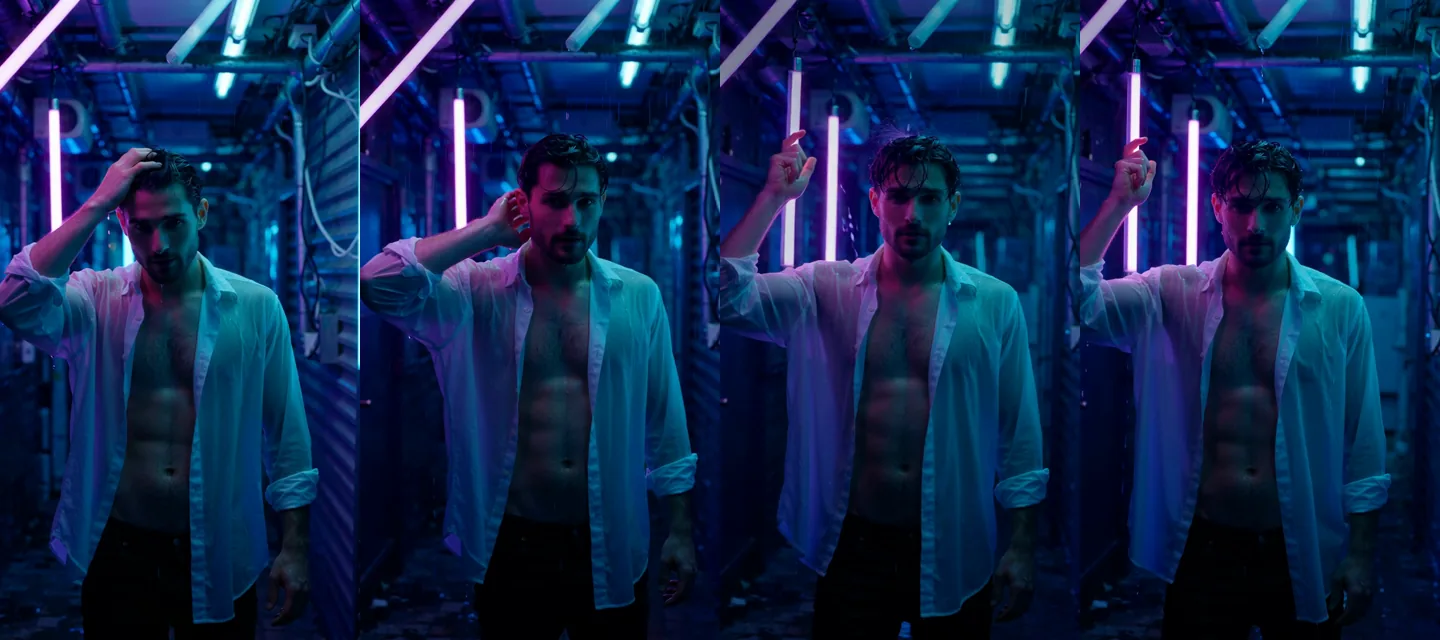
Images à environ 0,1, 1,8, 3,6 et 5,2 secondes du clip en portrait. Le visage et la chemise restent cohérents de la première à la dernière image.
Tango aux chandelles (16:9, 720p, 5 s, seed 47) : "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
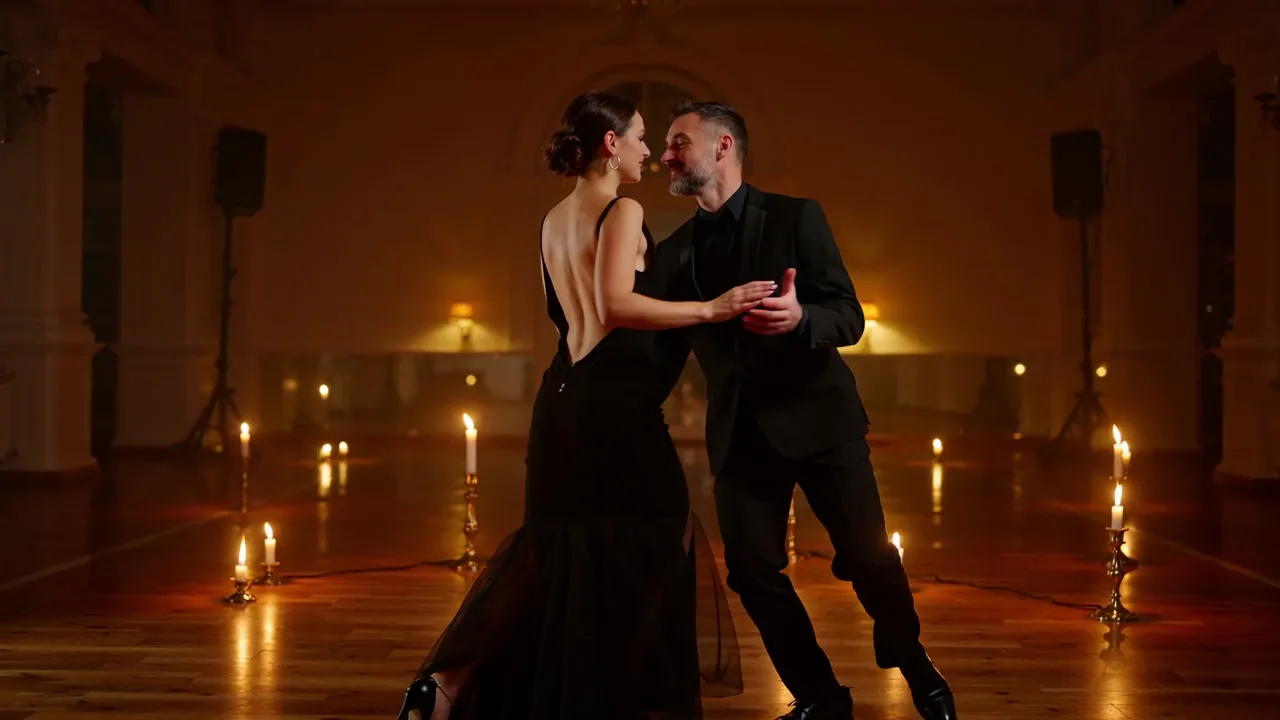
Clip de tango, 16:9, 720p, 5 s, seed 47. Image d’affiche de l’exemple publié.
La mise en scène à deux personnes est l’endroit où les modèles vidéo se défont d’ordinaire, et celui-ci a mieux tenu que prévu. Les images ci-dessous montrent le couple se rapprochant et finissant dans le penché. Les reflets des bougies sur le sol restent en place pendant que la caméra tourne.
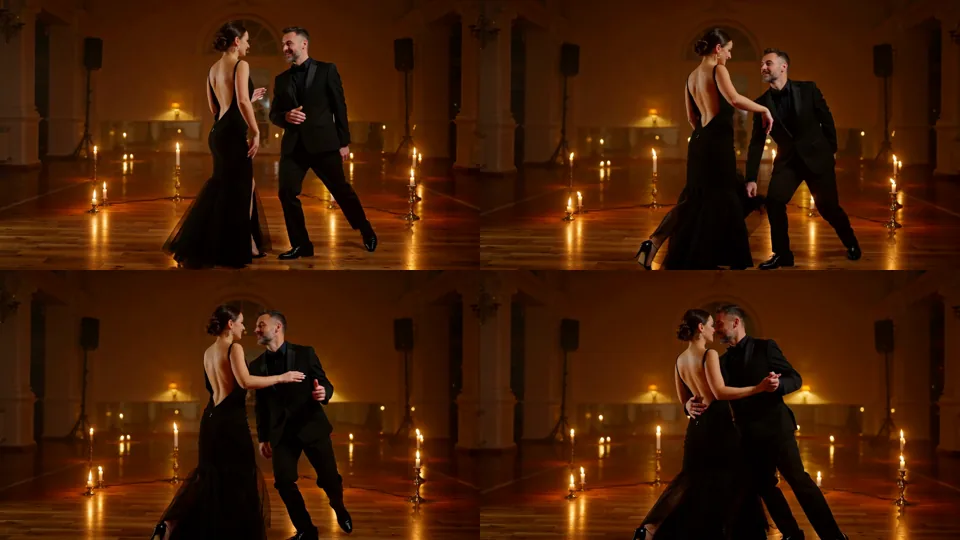
Images à environ 0,1, 1,8, 3,6 et 5,2 secondes du clip de tango.
Les habitudes qui ont payé dans toutes nos exécutions :
- Écrivez « adult » et donnez une tranche d’âge. Cela garde un casting cohérent et c’est la règle de la maison pour tout ce que nous publions.
- Mettez l’instruction de caméra en dernier. « Slow dolly tracking shot », « slow push-in » et « slow orbiting camera » ont chacune été suivies dans le clip où elles figuraient.
- Demandez une seule action par clip. Une marche et un retournement tiennent en cinq secondes ; une histoire, non.
- Utilisez le prompt négatif pour les artefacts, pas pour le goût. « Blurry, low quality, distorted hands, extra fingers, text, watermark, logo » est une valeur par défaut raisonnable ; le clip néon a tourné sans.
- Fixez la seed pendant que vous itérez. La même seed et les mêmes entrées ont donné un fichier identique à l’octet près : un changement dans le résultat est donc un changement que vous avez fait.
Les trois emplacements LoRA, et lequel utiliser quand
C’est ici que le point d’accès se distingue d’un appel Wan 2.2 ordinaire. Chaque emplacement prend jusqu’à trois entrées de la forme {path, scale}, où path est un lien HTTPS direct vers un fichier .safetensors et scale va de 0 à 4 (1 par défaut).
Illustration issue de l’habillage graphique du modèle, pas un clip de test : trois clés, trois ouvertures, une pour chaque emplacement.
| Emplacement | Atteint | À utiliser pour |
|---|---|---|
high_noise_loras | L’expert haut bruit seulement | Mise en page et mouvement : un mouvement de caméra, un type d’action, la composition d’ensemble |
low_noise_loras | L’expert bas bruit seulement | Détail et texture : peau, tissu, grain de pellicule, style de rendu |
loras | Les deux experts | Une LoRA à fichier unique, ou quand vous voulez qu’un fichier agisse sur les deux étapes |
La plupart des LoRA Wan 2.2 sur Hugging Face et Civitai sont publiées sous forme de paire : un fichier high_noise et un fichier low_noise. Placez chacun dans son propre emplacement. Une LoRA publiée en un seul fichier va dans loras. Si une fiche ne dit rien de l’étape visée par un fichier, commencez par loras, puis testez le fichier seul dans chaque emplacement spécialisé. Pour le raisonnement derrière ce choix, et une routine de test plus longue construite sur le point d’accès image vers vidéo, lisez notre guide des emplacements haut bruit et bas bruit ; cet article ne rapporte que ce qu’a fait le texte vers vidéo.
Ce que nous avons vu avec une LoRA entraînée pour cette base exacte (Wan2.2-T2V-A14B), chargée dans les deux emplacements spécialisés avec la seed fixe :
| Essai (même prompt, même seed 7, 480p, 16:9, 5 s) | Résultat par rapport au clip sans LoRA |
|---|---|
| Sans LoRA | Référence |
| Paire assortie, scale 0,5 | Même composition, léger changement de forme du visage et de coiffure |
| Paire assortie, scale 1 | Changement plus marqué : cheveux plus courts, un autre visage |
Fichier bas bruit seul, dans loras (les deux experts), scale 1 | A aussi changé la personne |
| Une LoRA entraînée pour un autre modèle de base | Identique à l’octet près au clip sans LoRA |
La dernière ligne est celle à retenir. Une LoRA conçue pour un autre modèle de base a produit exactement le même fichier que sans LoRA : aucune erreur, aucun avertissement, aucun effet. L’emplacement l’a acceptée et simplement rien ne s’est passé. Comparez donc toujours avec une exécution sans LoRA à la même seed avant de conclure qu’une LoRA fonctionne, ou que votre scale est trop bas. La LoRA d’apparence que nous avons utilisée a plus changé la personne que le style, c’est pourquoi nous montrons l’effet dans un tableau et non dans une galerie : elle a prouvé que le chargement est réel et que l’effet croît avec le scale, mais ce n’est pas un fichier de démonstration.
Le chargement n’ajoute aucun frais distinct, et dans nos exécutions il a ajouté 5 à 15 secondes de temps de modèle.
Quand un lien LoRA échoue
Deux erreurs nous ont coûté chacune une exécution, et elles sont faciles à éviter :
- Un lien qui exige une connexion. Un dépôt verrouillé échoue avec un message disant que le serveur a renvoyé HTTP 401 et demandant de vérifier que l’URL est accessible publiquement. Utilisez un fichier public ou un lien signé.
- Une page de dépôt au lieu du fichier. Coller la page du modèle au lieu du lien
resolve/main/...safetensorsa donné un message générique « the job failed unexpectedly ». Il n’est pas très descriptif : si vous le voyez avec une LoRA jointe, vérifiez d’abord le lien.
Les requêtes qui dépassent les limites ne démarrent aucun travail : une quatrième entrée dans un emplacement, un scale supérieur à 4, une durée autre que 5 ou 8, ou un prompt vide sont rejetés d’emblée.
Jusqu’où ça va
La plateforme n’ajoute aucun filtre de contenu, et ce que dessine un modèle dépend du modèle. Nous avons lancé un clip à chaque palier de notre échelle de contenu, le 5 octobre 2026, une exécution par palier, et regardé chaque planche d’images. Les paliers portent les mêmes noms que dans nos autres tests :
| Palier | Ce que nous avons demandé | Résultat |
|---|---|---|
| L1 Suggestif | Lingerie, une bretelle qui glisse | Rendu |
| L2 Thèmes matures | Osé, partiel | Rendu |
| L3 Fort | Niveau complet, une femme et un homme | Rendu |
| L4 Intense | Une scène intime entre deux adultes | Atténué : la scène est dessinée, mais pas en entier |
| L5 Extrême | Contrainte consentie entre adultes ; gore cinématographique | Contrainte rendue ; gore atténué en quelques coupures et marques |
Aucune exécution n’a été refusée et aucun clip n’a été remplacé par un autre. Lisez honnêtement les lignes L4 et gore : le modèle va très loin, puis il se calme. Si votre usage se situe en haut de l’échelle, prévoyez qu’il restera en deçà. Il s’agit d’une exécution par palier : considérez donc le tableau comme une première lecture, pas comme une garantie. Notre test de Wan 2.2 LoRA contient un historique plus long sur des dates antérieures.
Où il est limité
- Vidéo muette. Il n’y a ni piste audio ni option audio.
- Deux formats seulement. 16:9 et 9:16. Pour une publication carrée, recadrez ensuite.
- Le 720p est le plafond. Il n’y a pas de palier 1080p.
- Durées fixes. Exactement 5 ou 8 secondes. Nous en avons demandé 6 et obtenu un rejet, ce qui vaut mieux qu’un arrondi silencieux.
- Peu de réglages. Pas de fréquence d’images, d’étapes, de guidance ni d’extension de prompt. Vous dirigez avec des mots, la seed, le prompt négatif et les LoRA.
- Le texte dans le cadre n’est pas fiable. Voir l’exemple néon ci-dessus.
- Plus lent qu’une image fixe. Un clip 720p de 5 secondes a pris environ deux minutes de temps de modèle dans nos exécutions : prévoyez donc vos lots en conséquence.
- Une base de test mince. Nous avons lancé un clip par palier de l’échelle et une poignée de comparaisons de LoRA. Nous n’avons pas testé les extrêmes de la plage de seeds, ce que fait un prompt négatif sur le contenu, ni une exécution avec les neuf entrées LoRA chargées.
Quel point d’accès utiliser
| Vous voulez... | Utilisez | Pourquoi |
|---|---|---|
| Explorer une scène, une ambiance ou un mouvement de caméra | Texte vers vidéo | Une phrase en entrée, aucune image source nécessaire |
| Un visage, une tenue ou un produit précis à conserver | Image vers vidéo | L’image d’ouverture fixe le rendu |
| Un clip en portrait pour un téléphone | Texte vers vidéo, 9:16 | Le format est défini par un paramètre, pas par un recadrage |
| Un premier brouillon moins cher | Texte vers vidéo, 480p, 5 s | Brouillon au palier le plus bas, puis relance du bon en 720p |
| Une composition fixe reproductible | L’un ou l’autre, avec une seed fixe | La même seed et les mêmes entrées ont donné un fichier identique à l’octet près |
| Un effet issu d’une LoRA communautaire | L’un ou l’autre, avec le bon emplacement | Les fichiers en paire vont dans les emplacements haut bruit et bas bruit, les fichiers uniques dans loras |
FAQ
Wan 2.2 LoRA texte vers vidéo génère-t-il de l’audio ?
Non. La sortie est un MP4 avec une piste vidéo seulement, à 30 i/s et sans son. Ajoutez de la musique ou de la parole dans un éditeur une fois le clip fait.
Quelle est la différence entre les emplacements LoRA haut bruit et bas bruit ?
L’emplacement haut bruit atteint l’expert qui fixe la mise en page et le mouvement, et l’emplacement bas bruit atteint l’expert qui affine le détail et la texture. Utilisez loras pour appliquer un fichier aux deux. La plupart des LoRA Wan 2.2 sont publiées en paire haut bruit et bas bruit : chaque fichier va donc dans son propre emplacement.
Pourquoi ma LoRA n’a-t-elle rien changé ?
Elle a très probablement été entraînée pour un autre modèle de base. Dans notre test, une LoRA conçue pour une autre base a produit un fichier identique à l’octet près à l’exécution sans elle, sans erreur. Vérifiez que la fiche nomme Wan 2.2 texte vers vidéo, puis comparez avec une exécution sans LoRA à la même seed.
Quels rapports d’aspect, résolutions et durées prend-il en charge ?
16:9 ou 9:16, 480p ou 720p, et exactement 5 ou 8 secondes. Le carré, le 4:3, le 1080p et les autres durées ne sont pas disponibles, et une valeur hors de la liste est rejetée, pas arrondie.
Puis-je obtenir deux fois le même clip ?
Oui. Avec le même prompt, la même seed et les mêmes entrées, nous avons obtenu un fichier identique à l’octet près. Sans seed, chaque requête est aléatoire.
Une LoRA coûte-t-elle en plus ?
Non. La facturation se fait par seconde de vidéo à la résolution choisie, et le chargement de LoRA n’ajoute aucun frais distinct. Le rapport d’aspect ne change pas le prix, et les requêtes échouées ne sont pas facturées. Le prix en vigueur est sur la page du modèle.
Est-il sans censure ?
La plateforme n’ajoute aucun filtre de contenu. Dans notre échelle, les paliers L1 à L3 et la contrainte consentie entre adultes ont été rendus, et les paliers les plus intenses ont été atténués. Les détails figurent dans le tableau ci-dessus.
Dois-je utiliser le texte vers vidéo ou l’image vers vidéo ?
Utilisez le texte vers vidéo quand vous explorez et que n’importe quel adulte convenable fera l’affaire, et l’image vers vidéo quand le visage, la tenue ou le décor doit correspondre à une image que vous avez déjà. Une routine courante consiste à explorer avec le texte vers vidéo et à reporter la meilleure image sur l’image vers vidéo.