Wan 2.2 LoRA が、書いたシーンだけで動かせるようになりました。1つのプロンプトで、480p か 720p、横長か縦長の5秒または8秒のクリップが返り、3つのスロットそれぞれに最大3つの LoRA を指定できます。 2026年10月5日の当社テストでは、試した4つのサイズの組み合わせすべてが要求どおりのピクセルサイズで返り、プロンプト末尾のカメラ指示はすべてのクリップで守られ、エンドポイントは規制なしのままでした。拒否もクリップの差し替えもありませんでした。限界もはっきりしています。音声なし、正方形なし、720p が上限で、当社の段階表で最も強い段階は和らげられました。
これまで Wan 2.2 LoRA ファミリーのエンドポイントは、用意した画像を動かす画像から動画の1つだけでした。新しいテキストから動画のエンドポイントは、画像をまったく必要としません。この記事では、測定した内容、3つの LoRA スロットの挙動、効いたプロンプト、そして兄弟エンドポイントよりこちらを選ぶ場面を扱います。掲載するプロンプトはすべて、服を着た大人の日常的またはグラマラスなシーンです。操作を学ぶにはそれで十分です。
ひと目でわかる要点
| 質問 | 答え(2026年10月5日テスト) |
|---|---|
| モデル | Alibaba の Tongyi Wan チームによる Wan2.2-T2V-A14B。2025年7月28日にオープンウェイトとして公開 |
| API モデル名 | alibaba/wan-2.2-lora/text-to-video |
| 必須の入力 | prompt のみ |
| 形 | aspect_ratio は 16:9(既定)または 9:16 |
| 解像度 | 480p(既定)または 720p |
| 長さ | 5秒(既定)または8秒。それ以外の値は丸められず、拒否される |
| LoRA スロット | loras(両方のエキスパート)、high_noise_loras、low_noise_loras:各スロット最大3件、scale は 0〜4 |
| ほかに使えるもの | negative_prompt、seed(同じ seed と入力でバイト単位で同一のファイルが得られた) |
| 返ってくるもの | MP4、H.264、30 fps、音声トラックなし、1リクエストにつき1クリップ |
| テストでの速度 | 480p・5秒:約 65〜75 秒。480p・8秒:約 80 秒。720p・5秒:約 110〜150 秒。LoRA を使うと 5〜15 秒増える |
| 非対応 | 音声、正方形や 4:3、1080p、フレームレート、ステップ数、guidance、プロンプト拡張 |
| 課金 | 選んだ解像度での動画1秒あたり。アスペクト比では変わらず、LoRA の読み込みに別料金はなく、失敗したリクエストは課金されない |
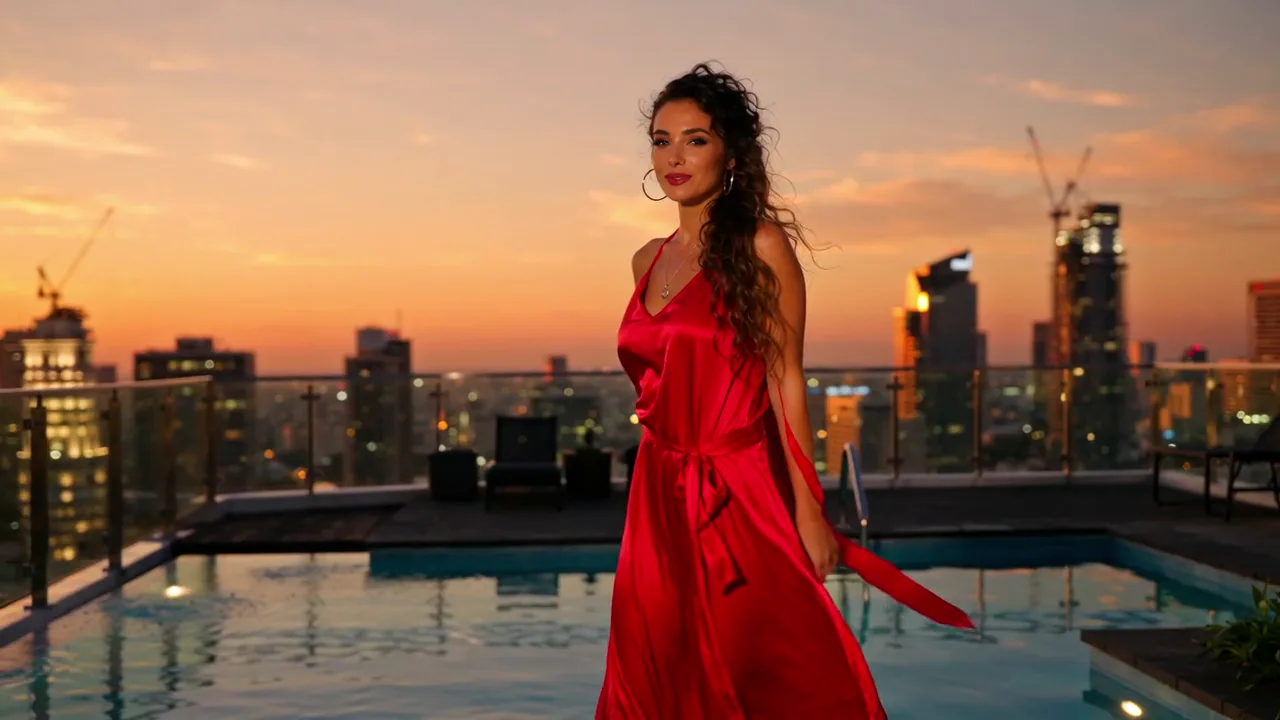
Wan 2.2 LoRA テキストから動画、720p、16:9、5秒、seed 20261005、LoRA なし、ネガティブプロンプトあり。クリップの最初のフレーム。プロンプトは下に掲載しています。
このモデルについて
Wan 2.2 は、Alibaba の Tongyi Wan チームによる動画拡散モデルです。テキストから動画のビルドは Mixture-of-Experts 設計で、約140億パラメータのエキスパートが2つあります。同時に動くのは1つだけで、high-noise エキスパートがノイズ除去の序盤を担当してレイアウトと動きを決め、low-noise エキスパートが後半を引き継いでディテールを仕上げます。この分担が、このエンドポイントに LoRA スロットが1つではなく3つある理由です。
提供元によると、照明、構図、コントラスト、色調のラベルを付けた厳選データで学習しており、Wan 2.1 よりはるかに多い素材(画像が65.6%増、動画が83.2%増)を使い、480P と 720P に対応しています。当社の実行では、フォトリアルな人物と肌、温かい暗めの室内、夕暮れの黄金色の光、ネオンと雨、ゆっくりしたドリー、押し込み、周回のカメラワークとして現れました。普通の英語の文章でうまくいき、タグの羅列は一度も必要ありませんでした。
画像から動画との違い
両エンドポイントは、同じ LoRA フィールドと、同じ5秒または8秒の長さを共有しています。違いが、どちらを使うかを決めます。
| 画像から動画(既存) | テキストから動画(新規) | |
|---|---|---|
| エンドポイントのページ | 画像から動画 | テキストから動画 |
| 必須の入力 | prompt と image_url | prompt |
| 見た目を決めるもの | 最初のフレーム:被写体、服装、セット、形 | プロンプトと seed |
| 形 | 最初のフレームに従う | 16:9 または 9:16 |
| ネガティブプロンプト | なし | あり |
| 1秒あたりの料金 | 低い | 高い。2つは別々に価格設定されているので、各ページで最新の料金を確認 |
実用上のルール:顔、服装、商品がすでに持っているものと一致しなければならないなら、画像から動画を使います。シーン、雰囲気、カメラワークを探っていて、どの大人が登場するかは気にしないなら、テキストから動画を使います。よい流れは、テキストから動画で探り、最良のフレームを選んで、そのフレームから兄弟エンドポイントで続けることです。
サイズ、長さ、実際に返ってくるもの
4つのサイズの組み合わせと、両方の長さを実行しました。どのリクエストも、要求どおりのピクセルサイズで返ってきました。
aspect_ratio と resolution | 出力サイズ | 5秒のリクエスト | 8秒のリクエスト |
|---|---|---|---|
| 16:9、480p | 832 x 480 | 161 フレーム、5.37 秒 | 247 フレーム、8.23 秒 |
| 9:16、480p | 480 x 832 | 5.37 秒 | 未実行 |
| 16:9、720p | 1280 x 720 | 5.37 秒 | 未実行 |
| 9:16、720p | 720 x 1280 | 5.37 秒 | 未実行 |
知っておくとよい点が2つあります。フレーム補間の影響で、クリップは要求よりわずかに長くなります。5秒のリクエストで 5.37 秒、8秒のリクエストで 8.23 秒でした。そして出力は無音です。クリップに音が必要なら、後から足してください。
モデルのランディングアートからのイラストで、テスト用のクリップではありません:2つの長さ、左が5秒、右が8秒。
解像度の目安:下書きは 480p で行ってください。既定であり、約1分で終わり、見えている構図は 720p でも同じ構図になるからです。最終レンダリングで 720p に移ります。長さについては、5秒は動作1つとカメラワーク1つに十分です。8秒は、動作に始まり、中盤、終わりがあるときだけ選んでください。
効いたプロンプト
一度も失敗しなかった構造は、1つの段落に4つの要素を入れるものです。誰が、何をするか、光、そして最後にカメラの動き。以下はすべて、大人と日常的またはグラマラスな場面を使っています。
夕暮れの屋上(16:9、720p、5秒、seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
シルク、スカイラインの映り込み、温かい光がすべて現れ、女性はクリップ全体で同じ顔と同じドレスを保ちました。下の帯は、5秒間の4つのフレームです。
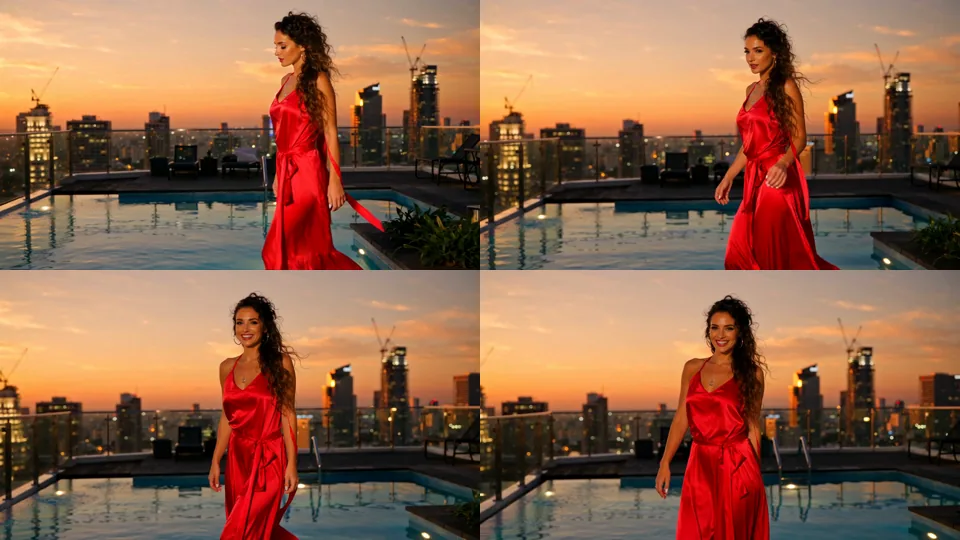
屋上クリップの約 0.1、1.8、3.6、5.2 秒のフレーム。歩く、振り向く、追うカメラが、書いたとおりに起きている。
ネオンの雨のポートレート(9:16、720p、5秒、seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}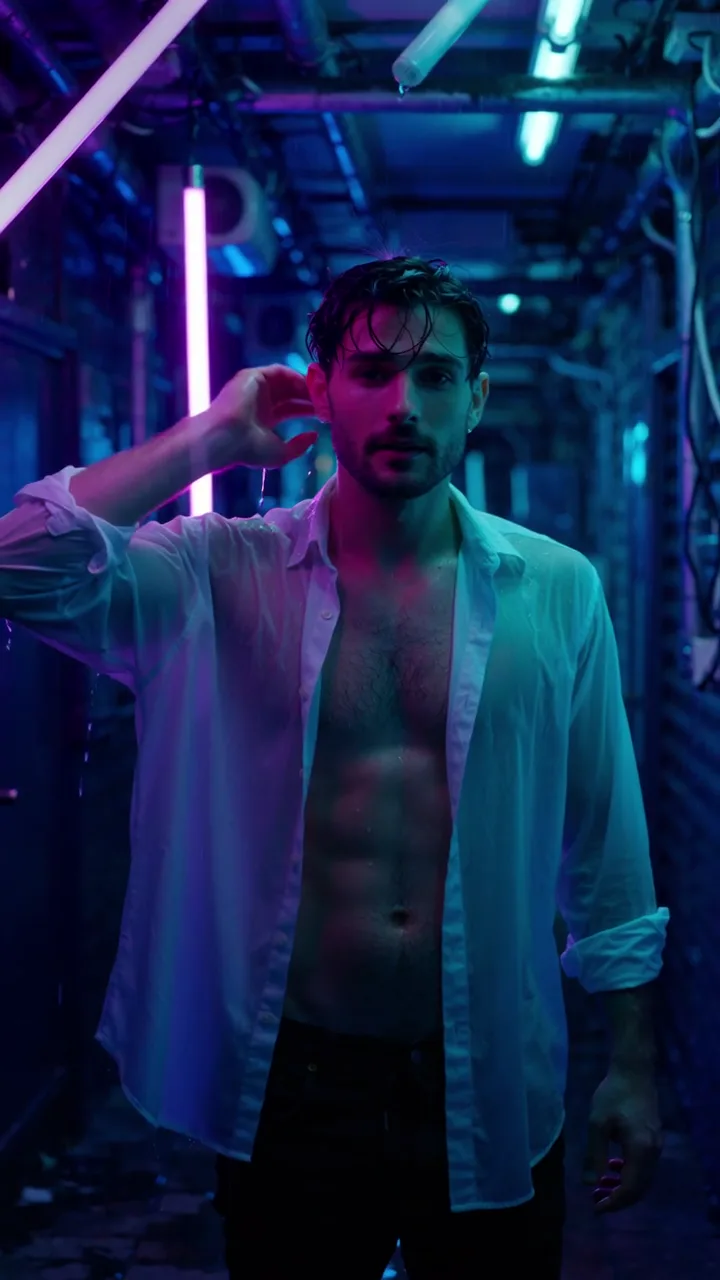
縦長 720p、5秒、seed 32。ポスターフレーム。髪をかき上げる動きとゆっくりした押し込みが、どちらも画面上で起きている。
"no signs or lettering anywhere" というフレーズに注目してください。このプロンプトの最初の版では背景にネオンサインがあり、モデルはそこに崩れた文字を描きました。シーンを、むき出しの光る管を中心に書き直したところ、問題は消えました。Wan 2.2 は綴りを確実には書けないので、綴るものが何もないシーンを与えてください。
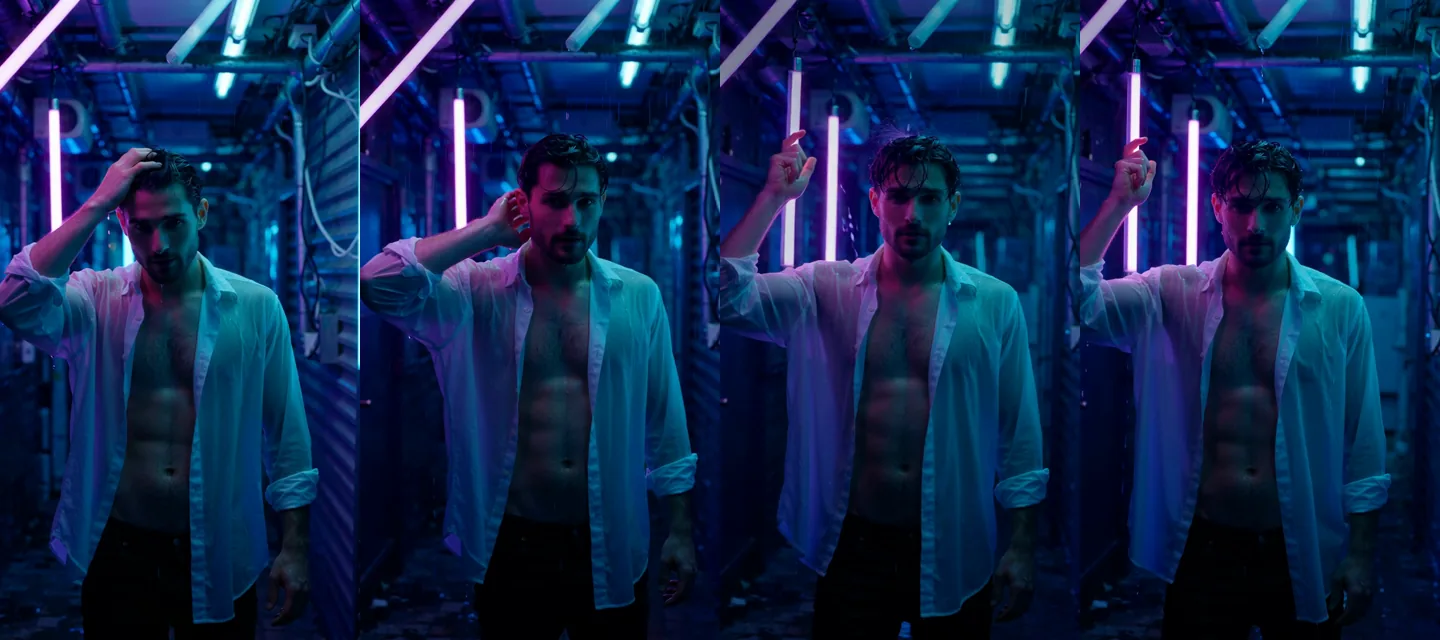
ポートレートクリップの約 0.1、1.8、3.6、5.2 秒のフレーム。顔とシャツは、最初のフレームから最後まで一貫している。
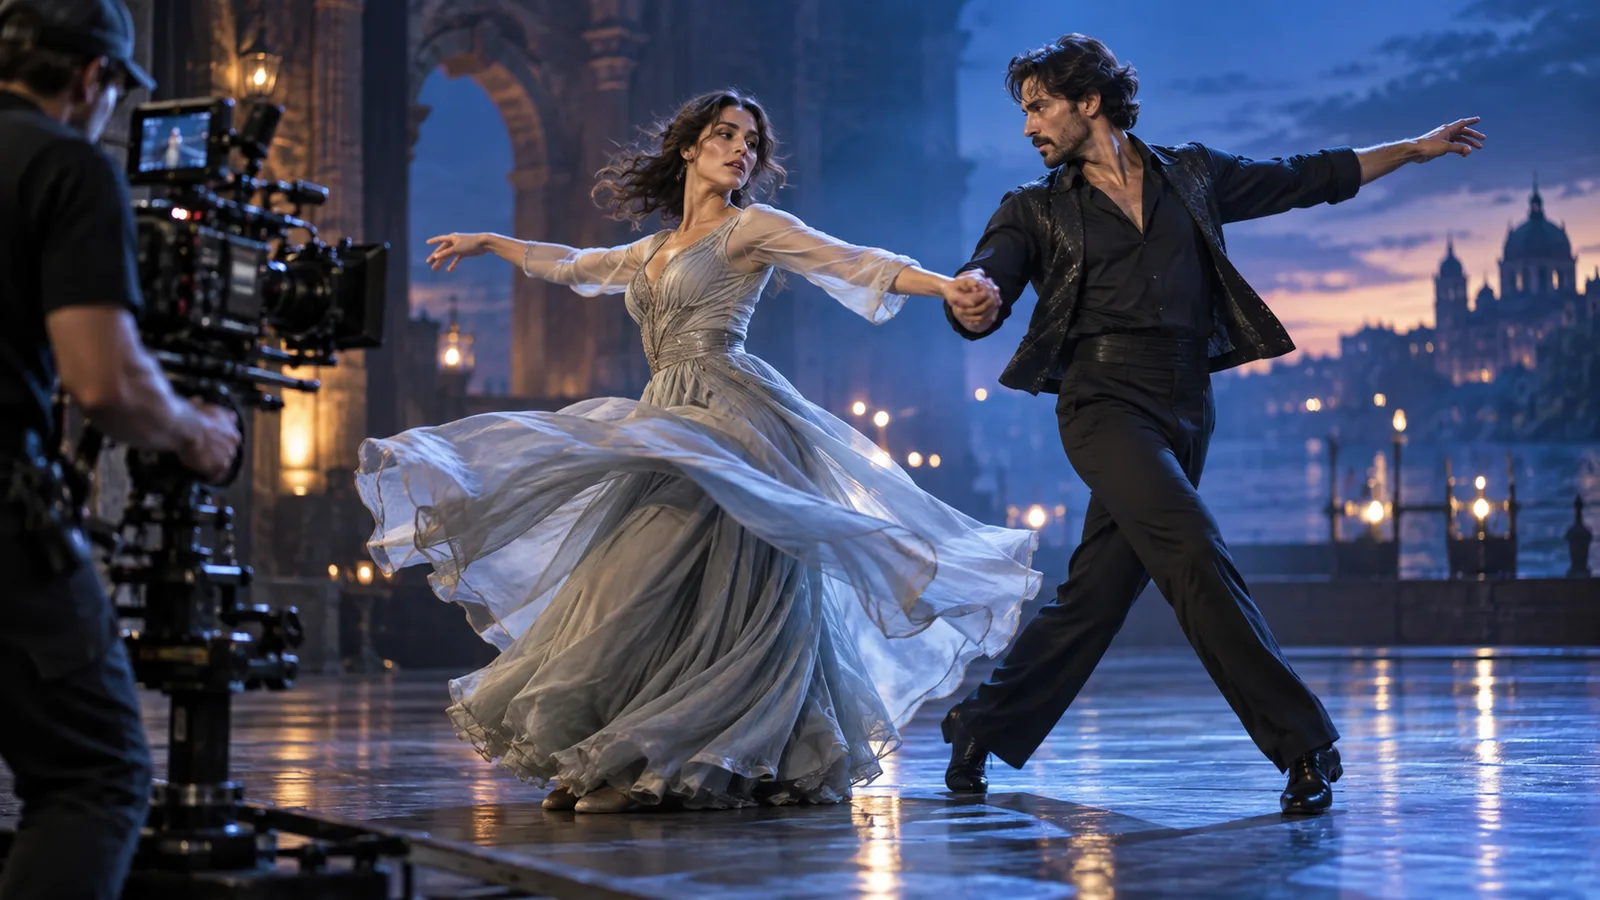
キャンドルの灯るタンゴ(16:9、720p、5秒、seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
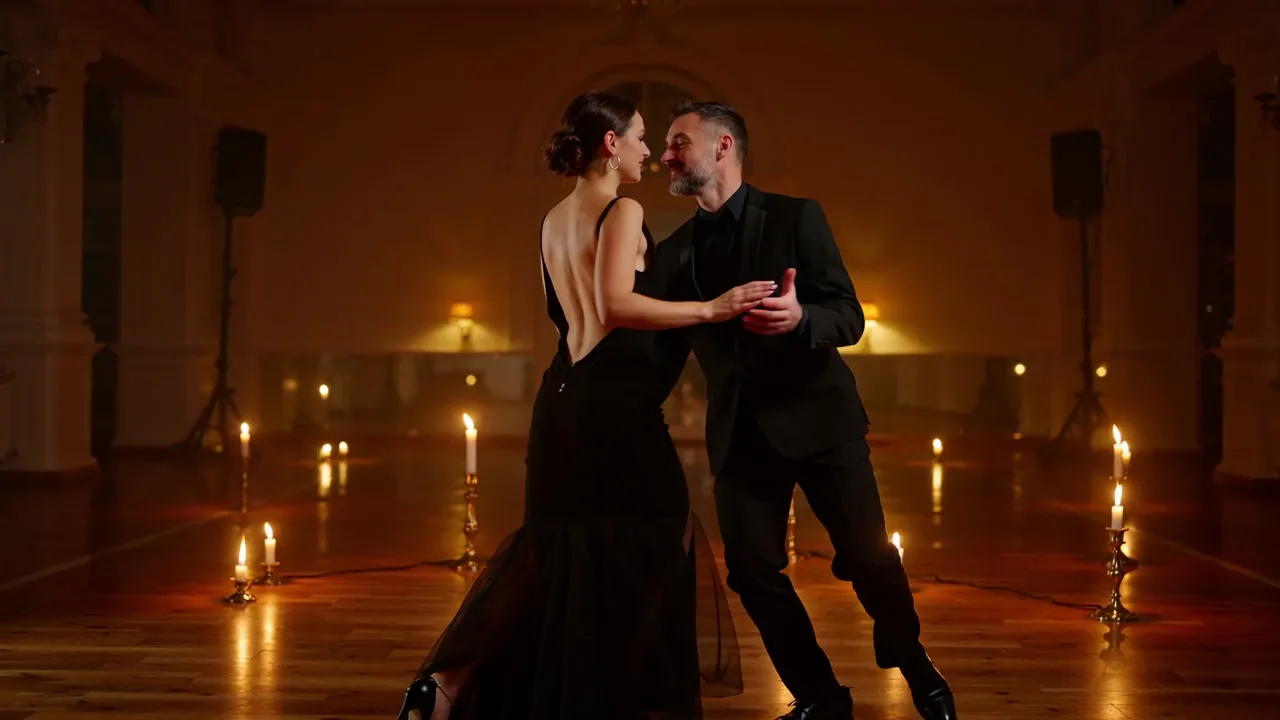
タンゴのクリップ、16:9、720p、5秒、seed 47。掲載例からのポスターフレーム。
二人の構図は、動画モデルが崩れやすいところですが、このモデルは想像以上にまとまっていました。下のフレームは、二人が近づき、ディップで終わる様子です。カメラが周回しても、床のキャンドルの映り込みは動きません。
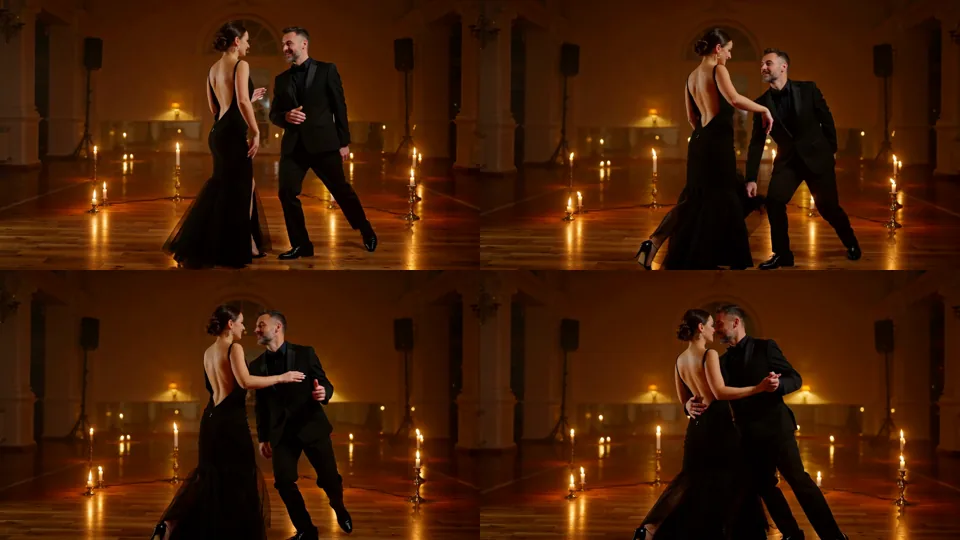
タンゴのクリップの約 0.1、1.8、3.6、5.2 秒のフレーム。
すべての実行で効果があった工夫:
- 「adult」と書き、年齢層を添える。 キャスティングが妥当になり、当社が公開するすべてのものの原則でもあります。
- カメラ指示は最後に置く。 "Slow dolly tracking shot"、"slow push-in"、"slow orbiting camera" は、それぞれ使ったクリップで守られました。
- 1クリップにつき動作は1つ。 歩くと振り向くは5秒に収まりますが、物語は収まりません。
- ネガティブプロンプトはアーティファクト用で、好みには使わない。 "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo" は妥当な既定です。ネオンのクリップは使わずに実行しました。
- 試行錯誤の間は seed を固定する。 同じ seed と同じ入力で、バイト単位で同一のファイルが得られたので、結果が変わるなら、それはあなたが変えたものによる変化です。
3つの LoRA スロットと、その使い分け
ここが、素の Wan 2.2 の呼び出しとの違いです。各スロットは {path, scale} の形で最大3件を受け取り、path は .safetensors ファイルへの直接の HTTPS リンク、scale は 0〜4(既定 1)です。
モデルのランディングアートからのイラストで、テスト用のクリップではありません:3つの鍵、3つの開口部、スロット1つにつき1つ。
| スロット | 作用する先 | 使いどころ |
|---|---|---|
high_noise_loras | high-noise エキスパートのみ | レイアウトと動き:カメラワーク、動作の種類、全体の構図 |
low_noise_loras | low-noise エキスパートのみ | ディテールと質感:肌、布、フィルムの粒状感、描画スタイル |
loras | 両方のエキスパート | 単一ファイルの LoRA、または1つのファイルを両方の段階に効かせたいとき |
Hugging Face や Civitai にある Wan 2.2 の LoRA の多くは、high_noise ファイルと low_noise ファイルのペアとして公開されています。それぞれを専用のスロットに入れてください。1つのファイルとして公開された LoRA は loras に入れます。カードにファイルがどの段階を対象とするかが書かれていなければ、まず loras で始め、次に専用の各スロットでそのファイルを単独でテストしてください。この選び方の理屈と、画像から動画のエンドポイントで行うより長いテスト手順は、high-noise と low-noise スロットのガイドをお読みください。この記事は、テキストから動画で起きたことだけを報告します。
まさにこのベース(Wan2.2-T2V-A14B)用に学習された LoRA を、seed を固定したまま2つの専用スロットに読み込んで見えたものです。
| 実行(同じプロンプト、同じ seed 7、480p、16:9、5秒) | LoRA なしのクリップとの比較結果 |
|---|---|
| LoRA なし | 基準 |
| 対応するペア、強度 0.5 | 構図は同じで、顔の形と髪型がわずかに変化 |
| 対応するペア、強度 1 | より大きな変化:髪が短くなり、顔が別人に |
low-noise ファイルのみ、loras(両エキスパート)に入れ、強度 1 | これも人物が変わった |
| 別のベースモデル用に学習された LoRA | LoRA なしのクリップとバイト単位で同一 |
最後の行を覚えておいてください。別のベースモデル用に作られた LoRA は、LoRA なしとまったく同じファイルを生み出しました。エラーも警告も効果もありません。スロットはそれを受け付け、ただ何も起きませんでした。ですから、LoRA が効いていると結論づけたり、強度が低すぎると判断したりする前に、必ず同じ seed で LoRA なしの実行と比べてください。 使った外見系 LoRA はスタイルより人物を大きく変えたため、効果はギャラリーではなく表で示しています。読み込みが本物であることと、効果が強度とともに大きくなることは示せましたが、お披露目向けのファイルではありません。
読み込みに別料金はなく、当社の実行ではモデル処理時間が 5〜15 秒増えました。
LoRA のリンクが失敗するとき
ミスが2つ、それぞれ1回の実行を無駄にしました。どちらも簡単に避けられます。
- ログインが必要なリンク。 ゲート付きのリポジトリは、サーバーが HTTP 401 を返したことと、URL が公開アクセス可能か確認するよう求めるメッセージで失敗します。公開されたファイルか、署名付きリンクを使ってください。
- ファイルではなくリポジトリのページ。
resolve/main/...safetensorsのリンクではなくモデルのページを貼ると、汎用的な "the job failed unexpectedly" メッセージが返りました。あまり説明的ではないので、LoRA を付けてこれが出たら、まずリンクを確認してください。
制限を破るリクエストは、処理が始まる前に拒否されます。1つのスロットの4件目、4を超える scale、5秒と8秒以外の長さ、空のプロンプトがそうです。
どこまで対応するか
プラットフォームはコンテンツフィルターをかけず、モデルが何を描くかはモデル次第です。2026年10月5日に、段階表の各段で1本ずつクリップを、1段階につき1回実行し、すべてのフレームシートを確認しました。段階の名前は、ほかのレビューと同じです。
| 段階 | 依頼した内容 | 結果 |
|---|---|---|
| L1 ほのめかし | 下着、ずり落ちる肩紐 | 返った |
| L2 成熟したテーマ | 際どい、部分的 | 返った |
| L3 強め | 全面的、女性と男性 | 返った |
| L4 高強度 | 成人同士の親密なシーン | 和らげられた:シーンは描かれるが、完全ではない |
| L5 極限 | 成人同士の同意に基づく拘束、映画的なゴア表現 | 拘束は返った。ゴア表現は、いくつかの切り傷と跡に和らげられた |
拒否された実行はなく、別のクリップに差し替えられたものもありませんでした。L4 とゴア表現の行は、率直に読んでください。モデルは長い距離を進み、そのあと落ち着きます。用途が段階表の最上位にあるなら、そこまで届かないことを前提に計画してください。1段階につき1回の実行なので、この表は最初の読み取りとして扱い、保証とは考えないでください。より長い記録は、Wan 2.2 LoRA のレビューに、以前の日付にわたって載っています。
弱い点
- 無音の動画。 音声トラックも音声のオプションもありません。
- 形は2つだけ。 16:9 と 9:16。正方形の投稿なら、後からトリミングしてください。
- 720p が上限。 1080p の階層はありません。
- 固定の長さ。 ちょうど5秒か8秒です。6秒を依頼して拒否されました。黙って丸められるよりずっとよいことです。
- 操作項目が少ない。 フレームレート、ステップ数、guidance、プロンプト拡張はありません。言葉、seed、ネガティブプロンプト、LoRA で操作します。
- フレーム内の文字は信頼できない。 上のネオンの例を参照してください。
- 静止画より遅い。 720p・5秒のクリップは、当社の実行でモデル処理時間が約2分かかったので、バッチはそれを見込んで計画してください。
- テストの土台が薄い。 段階ごとに1クリップと、いくつかの LoRA 比較を実行しました。seed の範囲の両端、ネガティブプロンプトが内容に及ぼす影響、9つの LoRA エントリをすべて読み込んだ実行は、テストしていません。
どのエンドポイントを使うか
| やりたいこと | 使うもの | 理由 |
|---|---|---|
| シーン、雰囲気、カメラワークを探る | テキストから動画 | 1文を入れるだけで、元画像は不要 |
| 特定の顔、服装、商品を貫く | 画像から動画 | 最初のフレームが見た目を固定する |
| スマホ向けの縦長クリップ | テキストから動画、9:16 | 形がトリミングではなくパラメータで決まる |
| 安い最初の下書き | テキストから動画、480p、5秒 | 最低の階層で下書きし、採用するものを 720p で再実行 |
| 再現できる固定の構図 | どちらでも、seed を固定して | 同じ seed と入力でバイト単位で同一のファイルが得られた |
| コミュニティ LoRA のエフェクト | どちらでも、正しいスロットで | ペアのファイルは high-noise と low-noise のスロットに、単一ファイルは loras に |
FAQ
Wan 2.2 LoRA のテキストから動画は音声を生成しますか?
いいえ。出力は動画トラックだけの MP4 で、30 fps、音なしです。クリップができた後で、エディターで音楽や音声を足してください。
high-noise と low-noise の LoRA スロットの違いは何ですか?
high-noise スロットはレイアウトと動きを決めるエキスパートに、low-noise スロットはディテールと質感を仕上げるエキスパートに作用します。1つのファイルを両方に適用するには loras を使います。Wan 2.2 の LoRA の多くは high-noise と low-noise のペアで公開されているので、各ファイルをそれぞれのスロットに入れてください。
LoRA を読み込んでも何も変わらなかったのはなぜですか?
おそらく別のベースモデル用に学習されたものです。当社のテストでは、別のベース用に作られた LoRA は、エラーなしで、使わない実行とバイト単位で同一のファイルを生み出しました。カードに Wan 2.2 のテキストから動画と書かれているか確認し、同じ seed で LoRA なしの実行と比べてください。
どのアスペクト比、解像度、長さに対応していますか?
16:9 または 9:16、480p または 720p、ちょうど5秒または8秒です。正方形、4:3、1080p、ほかの長さは使えず、リスト外の値は丸められず拒否されます。
同じクリップをもう一度得られますか?
当社のテストでは、同じプロンプト、同じ seed、同じ入力で、バイト単位で同一のファイルが得られました。seed を省くと、リクエストごとにランダムになります。
LoRA には追加料金がかかりますか?
いいえ。課金は選んだ解像度での動画1秒あたりで、LoRA の読み込みに別料金はありません。アスペクト比で価格は変わらず、失敗したリクエストは課金されません。最新の料金はモデルページにあります。
規制なしですか?
プラットフォームはコンテンツフィルターをかけません。当社の段階テストでは、L1〜L3 と成人同士の同意に基づく拘束は返り、最も強い段階は和らげられました。詳細は上の表にあります。
テキストから動画と画像から動画のどちらを使うべきですか?
探索中で、適した大人なら誰でもよいときはテキストから動画、顔、服装、場面を手元の画像に合わせなければならないときは画像から動画を使ってください。よくある流れは、テキストから動画で探り、最良のフレームを画像から動画へ引き継ぐことです。